登录社区云,与社区用户共同成长
邀请您加入社区
选型没有银弹。我们踩过的坑——时区、内存参数、子表数量——都是文档里写得清楚但容易被忽略的细节。建议任何团队在迁移前,先用真实数据量做 PoC,重点测写入吞吐、聚合 P99 和压缩比,再决定是否切换。
随着城市化进程加快,房屋租赁市场日益壮大,传统人工管理模式效率低、信息不对称问题突出。基于Java与Spring Boot技术,采用MySQL 5.7数据库,开发一套高效、智能的房屋租赁管理系统,实现房源管理、在线签约、租金提醒、信用评估等功能,提升租赁流程透明度与便捷性。系统具备良好的扩展性,可集成物联网、区块链等技术,推动住房租赁市场规范化发展,助力智慧城市建设与社会治理现代化,具有重要的现实
本文针对新能源汽车销售体系痛点,提出构建基于Spring Boot与MySQL的智能销售系统。系统融合大数据、物联网与区块链技术,实现售前推荐、库存管理、售后服务一体化,提升用户体验与企业运营效率。通过全生命周期数据整合与个性化服务,助力绿色出行与“双碳”目标达成,具有显著社会价值与应用前景。
随着新能源汽车快速发展,退役动力电池规模激增,构建高效可持续的回收体系成为保障资源安全与绿色低碳发展的关键。当前回收渠道不畅、技术参差、标准缺失等问题制约产业规范化发展。本研究基于Spring Boot与MySQL技术,开发集智能识别、梯次利用与再生利用于一体的电池回收系统,通过物联网与大数据实现全生命周期管理,提升资源利用率,降低碳排放,推动循环经济与双碳目标落地,兼具显著经济、环境与社会价值。
在数据分析、自动化运维、Web开发、人工智能等众多领域,Python凭借语法简洁、生态丰富的特性,成为零基础入门和跨领域提效的首选编程语言。
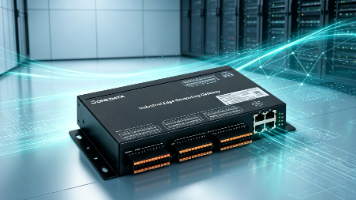
工信部2026年发布的《工业互联网和人工智能融合赋能行动方案》已经提出推动工业网络向“控网算一体化”演进,并支持5G/5G-A、工业光网、TSN、SPE、边缘计算、云化控制等技术协同发展。工信部今年发布的相关行动方案也提出,鼓励工业企业部署边缘一体机、智能网关,并推动生产设备、传感器、AGV等端侧设备部署轻量化算力,以提升数据实时处理能力。三旺通信近年来围绕工业现场的网络连接与边缘计算能力持续进行
如果只是偶尔让 AI 生成 Boolean 搜索语句,完成单点工具使用,依靠网上提示词、碎片化教程就可以做到,不一定需要专门系统学习和考取认证。但如果想要把上面整套寻访流程跑通,搭建稳定、可复用的 AI 工作流,掌握 Prompt 设计、AI 工作流搭建、工具组合应用,把 AI 真正融入 HR 日常业务,系统学习 AI 应用能力就很有价值。这也是 CAIE 人工智能工程师认证面向职场人群的定位。
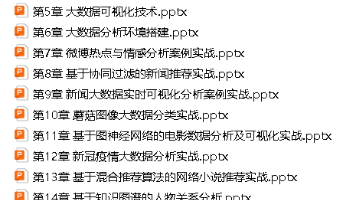
获取 《大数据分析基础与应用》全套PPT课件2026::https://download.csdn.net/download/m0_54748666/93366380。第13章基于混合推荐算法的网络小说推荐实战.ppt。第15章基于深度学习的评论情感分析系统实战.ppx。第9章新闻大数据实时可视化分析案例实战.ppt。第8章基于协同过滤的新闻推荐实战.pptx。第2章主流大数据处理框架.pptx。
这是我最看重的一点,也是宏智树AI区别于通用AI的地方。很多老师反对学生用AI,是因为怕产生抄袭或内容不实。宏智树AI内置了查重和“降AI率”功能。它不仅仅是查个重,而是通过深度语义重构来帮你降重,而不是简单的同义词替换,这能保证你论文的学术深度不受损。同时,它严格监控AIGC(人工智能生成内容)的比例,确保论文的原创性。这就好比一个严格的导师,不仅帮你改论文,还时刻提醒你:“这里不能偷懒,必须自
很多技术团队在选型时容易陷入“模型越深越复杂就越准”的思维定势,盲目采购昂贵的 GPU 服务器搭建深度学习训练集群。然而在真实的零售连锁多门店、多 SKU 预测场景下(如 3,000 家门店 × 20,000 款商品 = 6000 万个预测序列),不仅要考虑,还要严密考核。今天我们用一组包含 1,000 个不同特征商品序列的真实零售数据集,对 Prophet、DeepAR 和 LightGBM 进
数据分析:系统利用Python中的数据分析和统计库(如Pandas、Numpy等),对一手房房源数据进行分析和建模。这包括对不同地区、楼盘类型、户型、价格范围等因素进行统计和分析。这些信息包括楼盘名称、开发商、楼盘地址、户型、价格、面积、朝向、装修情况、楼盘特点等。在采集数据时,可以设置关键词、地区筛选、价格范围、楼盘类型等参数,以获取感兴趣的房源信息。基于Flask的一手房链家数据采集分析预测系
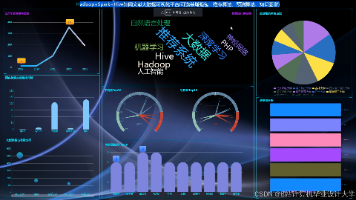
本文介绍了一个基于Hadoop+Spark+Hive的酒店推荐系统开发项目。该系统通过大数据技术处理用户行为、酒店属性和评论等多维数据,实现个性化推荐功能。项目采用Hadoop存储数据、Spark进行数据处理和模型训练、Hive优化查询性能的技术架构,支持离线批量推荐和实时推荐两种模式。任务书详细规划了10周的项目实施计划,包括需求分析、数据采集、模型开发等阶段,预期实现准确率提升15%以上、实时
大数据采集和处理能力是指一个地区、组织或系统在既定制度与技术条件下,对多源、高频、大规模数据进行获取、传输、存储、清洗、分析与应用的综合能力。本文参考《中国工业经济》王林辉等(2025)一文中关于地级市大数据采集和处理能力指标的衡量和测算方法,采用信息传输、计算机服务和软件业从业人员数占所属地级市总从业人员数的比重表征和测算。在区域或城市层面,大数据采集和处理能力通常被视为衡量数字化基础、智能化水
摘要:本文介绍了基于Hadoop+Spark+Hive技术的租房推荐系统研究,分析了分布式技术栈在解决租房市场信息过载问题中的应用。研究从技术架构、推荐算法、数据预处理及系统优化四个维度展开,详细阐述了HDFS存储、Spark计算、Hive查询等技术特点,以及协同过滤、内容推荐等算法的改进与创新。文章还探讨了系统面临的实时性、隐私保护等挑战,并指出未来发展方向包括图计算、强化学习等技术应用。最后提
本文介绍了CSDN平台提供的毕业设计辅导服务,涵盖SpringBoot、Vue、大数据、人工智能等多个技术领域。服务内容包括免费功能设计、开题报告、代码实现、论文降重及答辩辅导等。博主为中科院硕士,拥有丰富开发经验,承诺所有项目均为原创开发。提供上万套Java、Python等高级选题案例,适合新手学习。文末附联系方式,可获取完整源码及一对一专业辅导。
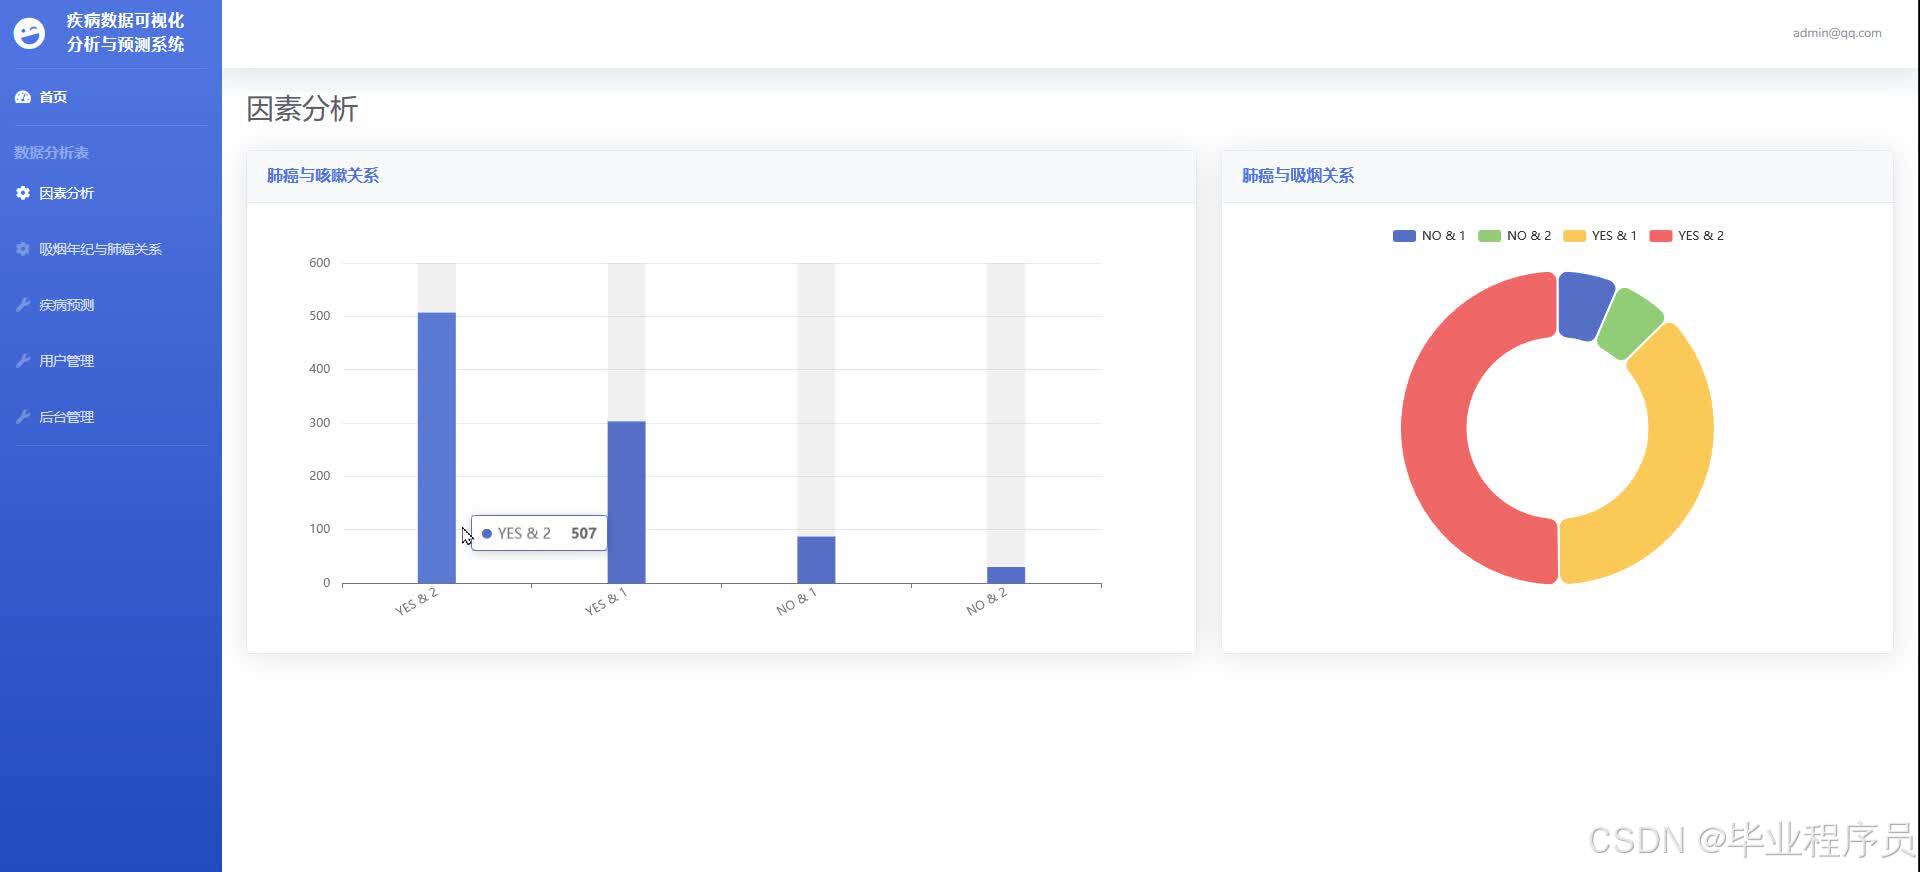
本文介绍了一个基于Python和机器学习的肺癌数据分析系统,该系统整合了数据采集、预处理、特征工程、模型构建与评估等完整流程。系统功能包括:1)多源数据采集与清洗;2)特征提取与选择;3)多种机器学习模型训练与优化;4)多维度评估指标分析;5)可视化展示统计分析结果;6)临床预测与决策支持。通过该系统,可为肺癌诊断、预后评估及个性化治疗提供数据支持,最终实现辅助医疗决策的目标。系统采用主流Pyth
本研究基于Python开发了一套电影数据分析与可视化系统,采用Django+Vue的B/S架构实现前后端分离。系统通过爬取豆瓣Top250电影数据,运用Pyecharts等工具实现了评分统计、国家分布、导演作品等多维度可视化分析。核心功能包括数据爬取、存储(MySQL/MongoDB)及8种可视化图表展示。测试表明系统功能完整且性能稳定,但在推荐算法处理稀疏数据时存在局限。未来可引入深度学习优化推
计算机毕业设计hadoop+spark+hive旅游推荐系统 旅游可视化系统 地方旅游网站 旅游爬虫 旅游管理系统 大数据毕业设计 机器学习 深度学习 知识图谱
本文综述了Hadoop+Spark在股票行情预测领域的应用研究。通过分布式存储与内存计算能力,该技术框架有效解决了PB级股票数据处理问题。研究重点包括:1)实时计算与流处理技术,如Spark Streaming实现秒级延迟分析;2)模型优化,从传统ARIMA到LSTM-Attention和Transformer等深度学习模型;3)多模态数据融合,整合行情、舆情和宏观数据提升预测准确率。实践案例显示
本文介绍了一个基于Python+Hadoop+Spark的知网文献推荐系统项目。系统采用分布式架构,使用Hadoop存储海量文献数据,Spark进行并行计算处理,Python实现数据清洗、特征提取和推荐算法。项目分为需求分析、数据采集、特征工程、系统开发和部署五个阶段,最终将实现基于用户行为和文献内容的个性化推荐功能,并提供Web界面展示推荐结果。文章详细说明了技术架构、任务分解、风险评估及交付成
本文是一份Spark编程实战指南,从零开始详细介绍了如何搭建本地Spark环境,并逐步深入核心编程实践。内容涵盖从基础的文件读取、行数统计,到编写独立Spark应用、实现数据去重与合并,再到使用RDD和DataFrame API进行分组聚合与平均值计算。最后提供了避坑指南与性能调优初探,帮助开发者高效掌握Spark数据分析的核心技能。
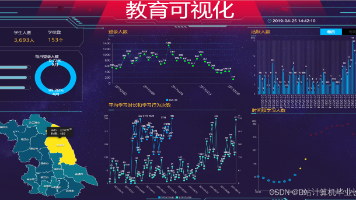
摘要:本文介绍了一个基于Hadoop+Spark+HBase的在线教育大数据分析可视化系统项目。项目利用分布式存储和实时计算技术,构建用户画像、教学质量评估、实时可视化看板等功能模块。技术栈涵盖Hadoop、Spark、HBase等大数据组件,以及ECharts等可视化工具。实施计划分为需求分析、数据采集、分析开发、系统集成五个阶段,预期实现10万级数据的实时处理,用户画像准确率达85%以上。项目
摘要:美食数据爬虫分析可视化系统是基于Python+Django开发的爬虫分析工具,采用selenium爬取携程网美食数据(店铺、评分、评论等),支持按城市/关键词筛选。系统具备数据库存储、数据查询分析和Echarts可视化功能,通过HTML前端和Django后端实现。提供6大功能界面:数据大屏、分析图表、美食数据展示、后台管理、个人信息和爬取模块,帮助用户高效获取并分析美食数据,辅助决策。
采用SpringBoot作为后端框架,搭配MyBatis-Plus实现数据持久化。前端使用Vue.js或React构建可视化大屏,通过ECharts实现动态图表渲染。对于本系统,我们提供全方位的支持,包括修改时间和标题,以及完整的安装、部署、运行和调试服务,确保系统能在你的电脑上顺利运行。系统联调测试,性能优化,安全加固,撰写技术文档和用户手册。完成需求分析与技术选型,搭建基础框架,部署数据采集设
采用分层架构设计,分为数据采集层、数据处理层、数据存储层和应用层。数据处理层对采集的数据进行清洗、分析和挖掘。采用XPath和正则表达式进行数据提取,数据清洗后存入数据库。基于Echarts开发数据可视化大屏,展示实时订单数据、热门菜品排行、用户评价分布等信息。使用Pandas进行数据预处理,包括缺失值处理、异常值检测和数据标准化。定期备份数据库,设置操作日志审计,确保系统可追溯性。对于本系统,我
摘要:本项目基于Django框架与大语言模型技术,开发中华古诗词知识图谱可视化系统。系统通过大模型自动提取诗词中的实体(作者、朝代、意象等)及关系,构建结构化知识图谱,并利用Neo4j图数据库和D3.js/ECharts实现可视化展示。主要功能包括知识图谱构建、智能检索推荐、多维度筛选等,支持自然语言查询和相似诗词推荐。技术栈涵盖Django、Neo4j、Vue.js、HuggingFace Tr
摘要:本文提出基于Hadoop+Django+Spark的智能租房推荐系统,通过分布式架构整合多源租房数据,采用混合推荐算法(协同过滤+内容推荐)实现精准匹配。系统利用Hadoop存储处理TB级数据,Spark进行实时计算与机器学习建模,Django提供Web服务,结合ECharts实现多维度可视化分析。实验表明,系统推荐准确率(点击率28.5%,预约转化率12.3%)和数据处理效率(较单机提升6
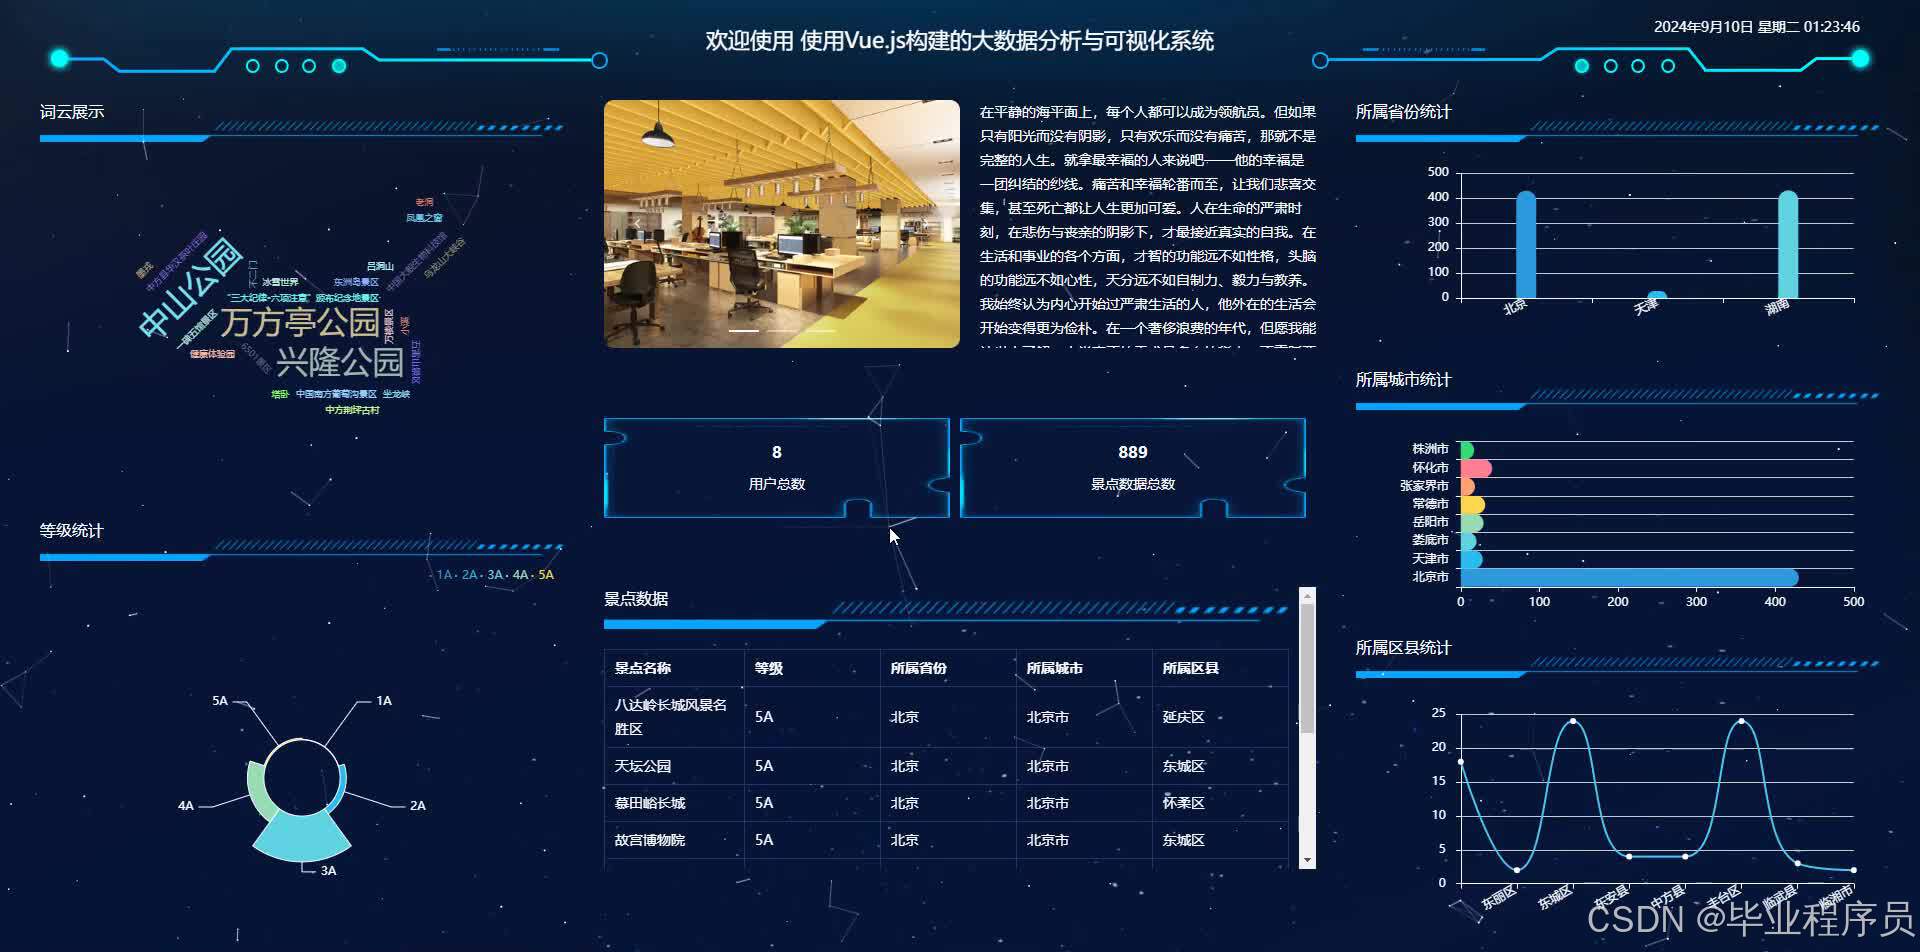
摘要:本文介绍了一个基于SpringBoot和Vue.js的大数据分析与可视化系统。系统采用Java+SpringBoot后端框架和Vue.js前端框架,使用MySQL数据库存储数据。主要功能包括数据采集清洗、分析挖掘、可视化展示和用户权限管理。系统优势体现在高效性、可扩展性、用户体验和数据安全性方面。文章还提供了核心代码片段和效果图预览,并附有源码获取方式。该系统整合了现代Web技术和大数据处理
提供多维动态图表展示,包括折线图(价格走势)、热力图(区域差异)、散点图(相关性分析)。用户可自定义时间范围、农产品品类(如粮食、蔬菜、水果)及地区维度,实时生成可视化报告。系统通过爬虫技术或API接口获取多源数据,包括历史价格、气象数据、市场供需信息、政策文件等。对于本系统,我们提供全方位的支持,包括修改时间和标题,以及完整的安装、部署、运行和调试服务,确保系统能在你的电脑上顺利运行。提供API
所有项目都经过了严格的测试和完善。对于本系统,我们提供全方位的支持,包括修改时间和标题,以及完整的安装、部署、运行和调试服务,确保系统能在你的电脑上顺利运行。该设计需特别注意数据隐私合规性,所有个人轨迹数据必须经过k-anonymity处理(k≥50)后方可进入分析流程。需要成品或者定制,如果本展示有不满意之处。数据库工具:Navicat/SQLyog/ MySQL Workbench等都可以。查