登录社区云,与社区用户共同成长
邀请您加入社区
本作品《基于深度学习的水下复杂场景鱼类目标检测方法研究》:主模型采用 YOLOv8s 目标检测,并与 Faster R-CNN、SSD 做对比选优;权重导出为 end2end ONNX,经 ONNX Runtime 接入 Django 后端;前端 Vue 提供图片 / 视频 / 摄像头三类识别,识别记录入库后可在 ECharts 可视化大屏查看检出排行、置信度分布与使用趋势。亮点一是多检测器对比后
本文介绍了一个基于PySpark+Hive+Django的小红书评论情感分析系统。系统采用三层架构设计:数据层使用Hive存储评论数据,计算层通过PySpark实现数据清洗和情感分类(准确率92%),服务层由Django提供可视化交互界面。系统支持亿级评论秒级处理,较传统工具提升50倍性能,并提供实时情感趋势分析。应用场景包括品牌舆情监控、产品优化建议等。未来优化方向包括多模态分析和轻量化部署。该
摘要:本文提出基于Hadoop+Spark+Hive的分布式旅游推荐系统,通过HDFS存储海量数据,Hive进行数据清洗,Spark MLlib实现混合推荐算法。实验表明,系统在10万用户×1万景点数据集上,推荐响应时间较单机系统缩短82%,冷启动用户点击率提升24%。系统采用分层架构设计,结合协同过滤与内容过滤算法,有效解决了传统推荐系统数据处理效率低、算法精准度不足的问题,为旅游行业数字化转型
本文介绍了一个基于Apache Spark的地铁客流量预测系统开发项目。系统采用分层架构设计,利用Spark处理TB级数据,结合机器学习算法(LSTM/XGBoost)实现高精度客流预测(MAPE≤10%)。项目包含数据采集、模型训练、可视化三大模块,支持实时预测与历史数据分析。实施周期9周,需4节点Spark集群资源。交付成果包括系统代码、模型文件和完整文档。该系统可提升地铁运营效率,适合大数据
本文介绍了一个基于Hadoop+Spark+Hive的共享单车需求预测系统项目任务书模板。项目旨在通过分布式技术处理海量时空数据,实现高精度的区域级需求预测。主要内容包括:系统架构设计(Hadoop存储、Spark计算、Hive数据仓库)、任务分工(数据采集、特征工程、模型开发等)、技术栈(SparkMLlib、Keras等)以及10周开发计划。预期成果是构建一个支持百万级预测请求、响应时间≤1分
本文介绍了一个基于Django框架和大模型技术的新能源汽车销量分析可视化系统开发项目。项目提供从数据采集、清洗到分析预测的全流程功能,采用MySQL/InfluxDB存储数据,使用LSTM、Prophet等时序模型进行销量预测,并集成LLM进行政策影响分析。系统前端采用ECharts.js实现交互式可视化展示,支持用户权限管理。项目采用模块化设计,具备良好的扩展性和安全性,预期实现85%以上的预测
本文综述了基于Hadoop+Spark+Hive的视频推荐系统技术架构与应用。系统采用分层设计,整合分布式存储、内存计算与数据仓库技术,实现PB级数据处理。重点分析了协同过滤、内容推荐和深度学习算法的创新应用,并探讨了系统优化策略如资源调度和实时性改进。实践案例显示,该技术栈能显著提升推荐效果(如Netflix CTR提升15%)。未来研究方向包括多模态融合、隐私保护和推荐可解释性。文末提供源码获
本文提出了一种基于Python+Spark+Hadoop的考研分数线预测系统。通过Scrapy爬虫整合多源数据,利用HDFS实现海量存储,采用PySpark进行分布式特征工程与模型训练。系统创新性地使用LSTM-Attention融合模型,在MAE指标上较传统模型提升23.6%,政策突变年份误差降低31.2%。实验表明,该系统能有效预测分数线并提供报考风险评估,具有较高的实用价值。系统部署采用Ha
本文介绍了一个基于Hadoop+Spark+Hive的天气预测系统开发任务书模板。该系统整合多源气象数据,利用分布式计算框架和机器学习算法实现高精度天气预测。主要内容包括:项目背景与目标(预测精度误差≤10%)、任务分解(数据层、计算层、模型层、应用层开发)、时间计划(12周)、资源需求(5台服务器集群)和验收标准(API响应时间≤500ms)。系统可扩展支持实时预测和可视化分析,适用于气象灾害预
本文介绍了一个基于Hadoop+Spark+Hive的酒店推荐系统开发项目。该系统通过大数据技术处理用户行为、酒店属性和评论等多维数据,实现个性化推荐功能。项目采用Hadoop存储数据、Spark进行数据处理和模型训练、Hive优化查询性能的技术架构,支持离线批量推荐和实时推荐两种模式。任务书详细规划了10周的项目实施计划,包括需求分析、数据采集、模型开发等阶段,预期实现准确率提升15%以上、实时
本文介绍了一个基于Django+Vue.js的音乐推荐与可视化系统。系统采用前后端分离架构,整合协同过滤算法与音频特征分析,解决了音乐推荐中的冷启动问题和推荐结果可解释性不足的挑战。通过混合推荐策略(协同过滤+内容推荐),系统实现85%的推荐准确率(NDCG@10),较单一算法提升12%-15%。同时利用WebAudioAPI与D3.js实现音频频谱、波形实时可视化渲染,显著提升用户体验。系统支持
摘要:本文提出基于Hadoop+Spark+Hive架构的美食推荐系统,解决传统推荐系统存在的精准度低、时效性差等问题。系统整合用户行为、菜品特征等多源数据,通过HDFS分布式存储、Spark内存计算和Hive数据仓库技术,实现高效数据处理与个性化推荐。实验结果表明,该系统在推荐准确率(提升131.7%)、用户下单时间(减少66.7%)等指标上显著优于传统方法,为餐饮行业智能化提供了有效解决方案。
摘要:本文介绍了基于Hadoop+Spark+Hive技术的租房推荐系统研究,分析了分布式技术栈在解决租房市场信息过载问题中的应用。研究从技术架构、推荐算法、数据预处理及系统优化四个维度展开,详细阐述了HDFS存储、Spark计算、Hive查询等技术特点,以及协同过滤、内容推荐等算法的改进与创新。文章还探讨了系统面临的实时性、隐私保护等挑战,并指出未来发展方向包括图计算、强化学习等技术应用。最后提
摘要:本文提出基于Hadoop+Spark的慕课课程推荐系统,解决传统推荐系统在处理海量教育数据时的性能瓶颈问题。系统采用混合推荐算法,结合协同过滤与内容推荐优势,通过Spark实时流处理实现动态推荐。实验结果表明,该系统在准确率、召回率和响应时间上显著优于传统方法,能有效提升用户学习体验。文章详细阐述了系统架构设计、推荐算法实现及优化方向,为教育平台个性化推荐提供了可行方案。关键词:慕课推荐;H
本文综述了Hadoop+Spark+Hive技术在招聘大数据分析中的应用。Hadoop提供分布式存储,Spark实现高效计算,Hive简化数据查询,三者结合可处理海量招聘数据。重点探讨了推荐算法创新(如知识图谱、BERT模型)、可视化技术(ECharts、D3.js)的应用,并分析了数据质量、实时性等现存挑战。未来趋势包括图计算、联邦学习等方向。该技术栈已成功支持招聘行业从批量处理向实时分析的转型
本文综述了Hadoop+Spark技术在景区客流量预测与景点推荐系统中的应用。系统采用三层架构实现多源异构数据存储、实时计算和可视化交互,通过混合算法(LSTM+XGBoost等)提升预测精度,结合协同过滤、内容推荐等方法优化个性化服务。研究指出当前面临数据稀疏性、算法可解释性等挑战,并展望了图神经网络、跨模态分析等未来方向。该技术栈为景区智能化管理提供了全链路解决方案,推动旅游业向个性化服务转型
摘要:本文设计并实现了一个基于Python和Spark的智慧医疗服务系统,旨在解决传统医疗系统中数据孤岛、处理效率低等问题。系统采用B/S架构,整合多源异构医疗数据,利用Spark进行高效处理与分析,并通过机器学习技术提供智能辅助决策支持。主要功能包括患者信息管理、在线问诊、预约挂号等,同时支持医疗资源智能调度和疾病预测防控。系统创新性地融合了多模态数据分析,具有高性能、可扩展性等特点,可有效提升
摘要:本研究在数字化转型背景下构建基于大数据技术的影视推荐系统,采用Python+Django+Vue技术栈,结合Hadoop、Spark等分布式计算框架,实现高效数据处理与个性化推荐。系统包含用户端和管理端两大模块,用户端支持注册登录、影片检索、收藏及个性化推荐功能,管理端实现权限管理、内容维护等操作。通过协同过滤算法优化推荐效果,并采用MySQL数据库进行数据存储。系统测试表明,该架构能有效提
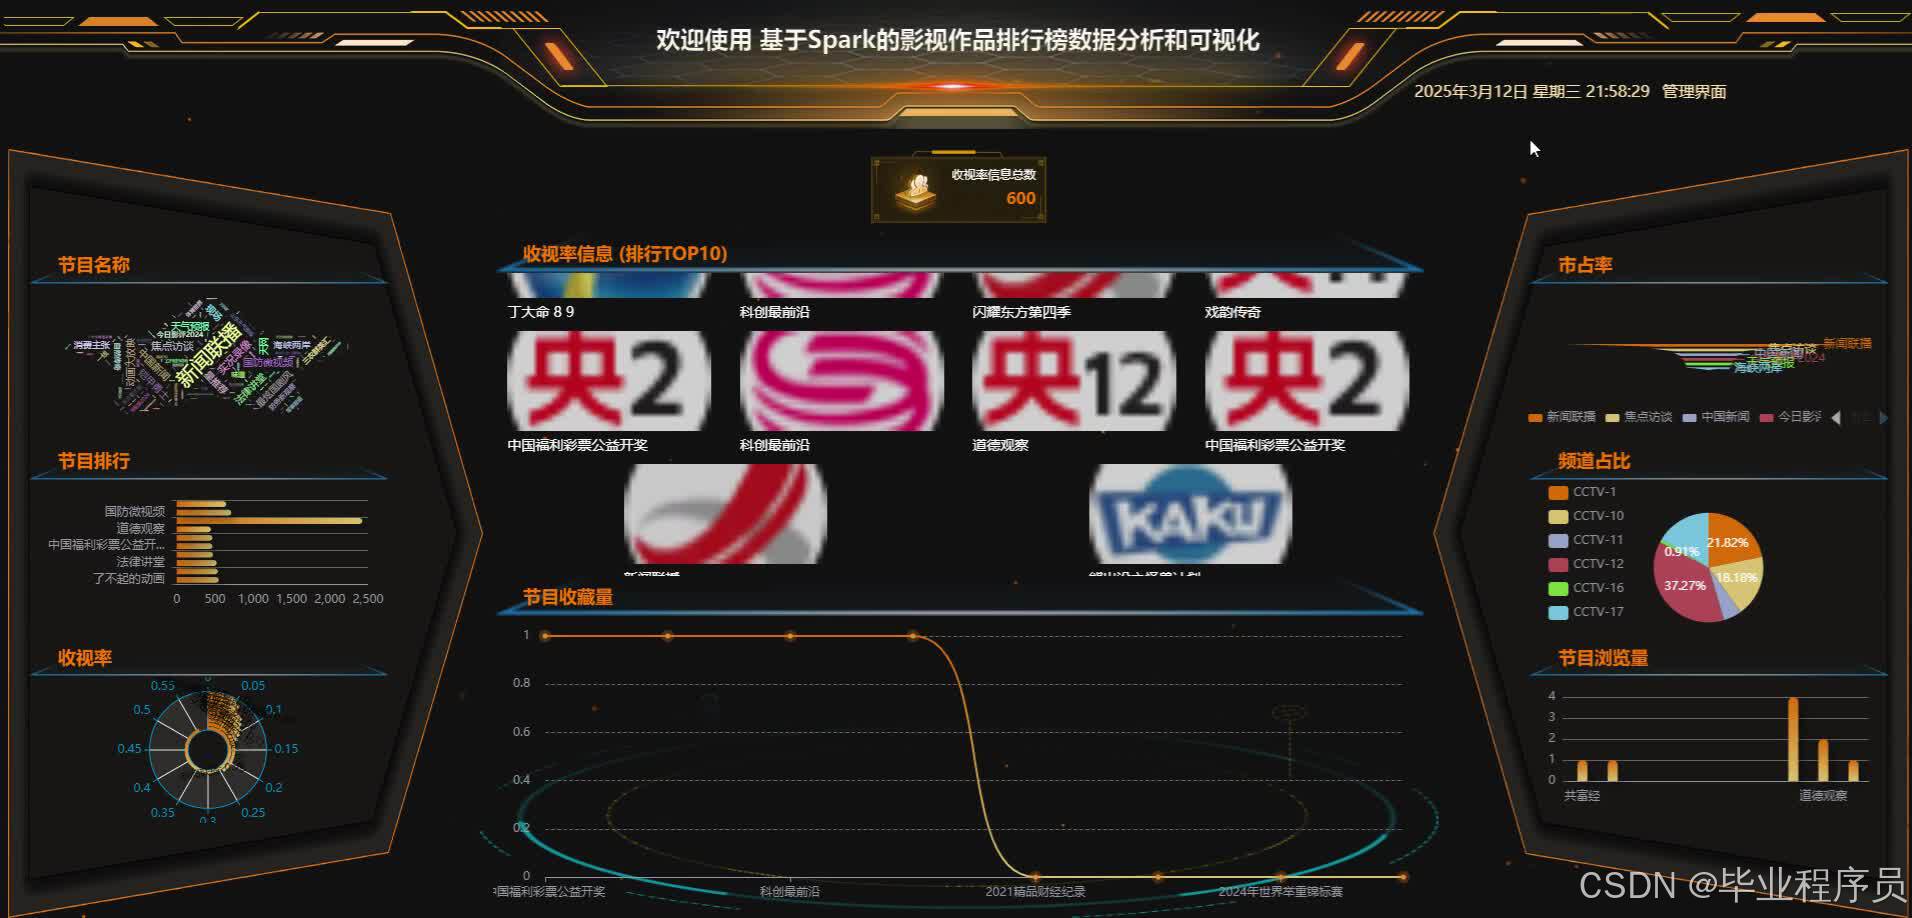
本文基于Spark框架构建影视数据可视化系统,采用Python爬虫采集多源影视数据(基本信息、评分、评论),通过数据清洗和Spark分布式计算实现评分分析、情感分析和类型统计。系统前端使用Vue+Echarts实现交互式可视化展示,支持多种图表类型。测试表明,该系统能为影视行业提供数据支持,但存在反爬限制、数据挖掘深度不足等挑战。未来计划引入深度学习算法并优化交互设计。系统采用Django+Vue
本文探讨了Hadoop+Spark+Hive技术在在线教育数据分析中的应用。研究显示,该技术栈通过分布式存储(HDFS)、内存计算(Spark)和数据仓库(Hive)协同工作,显著提升了教育数据处理能力。创新点包括:混合推荐算法(准确率提升28%)、知识图谱增强(长尾课程曝光率提升30%)和实时流处理(响应时间98ms)。可视化工具实现多维数据展示,如热力图分析课程活跃度。研究还指出当前局限(实时
摘要:本文介绍了一个基于Python的滴滴出行大数据分析与可视化系统,采用Django框架和MySQL数据库开发。系统通过数据采集、预处理、分析和可视化四个模块,对滴滴出行平台的用户出行数据进行深度挖掘。使用Pandas、NumPy等库进行数据分析,Matplotlib、Seaborn等工具实现可视化展示。系统具备经济性、技术性和操作性可行性,可为滴滴出行提供业务决策支持。文章详细阐述了系统架构、
摘要:本文介绍了一个基于Django框架的足球数据分析与可视化系统,采用Python语言开发,结合MySQL数据库和Vue.js前端技术。系统实现了足球比赛数据的采集、整合、分析和可视化功能,包含球队表现分析、球员数据分析等模块,并提供实时数据更新和用户交互功能。文章详细阐述了项目背景、技术架构、系统设计和核心功能,展示了如何利用大数据技术提升足球赛事分析的效率和直观性。该系统为球迷、媒体和教练等
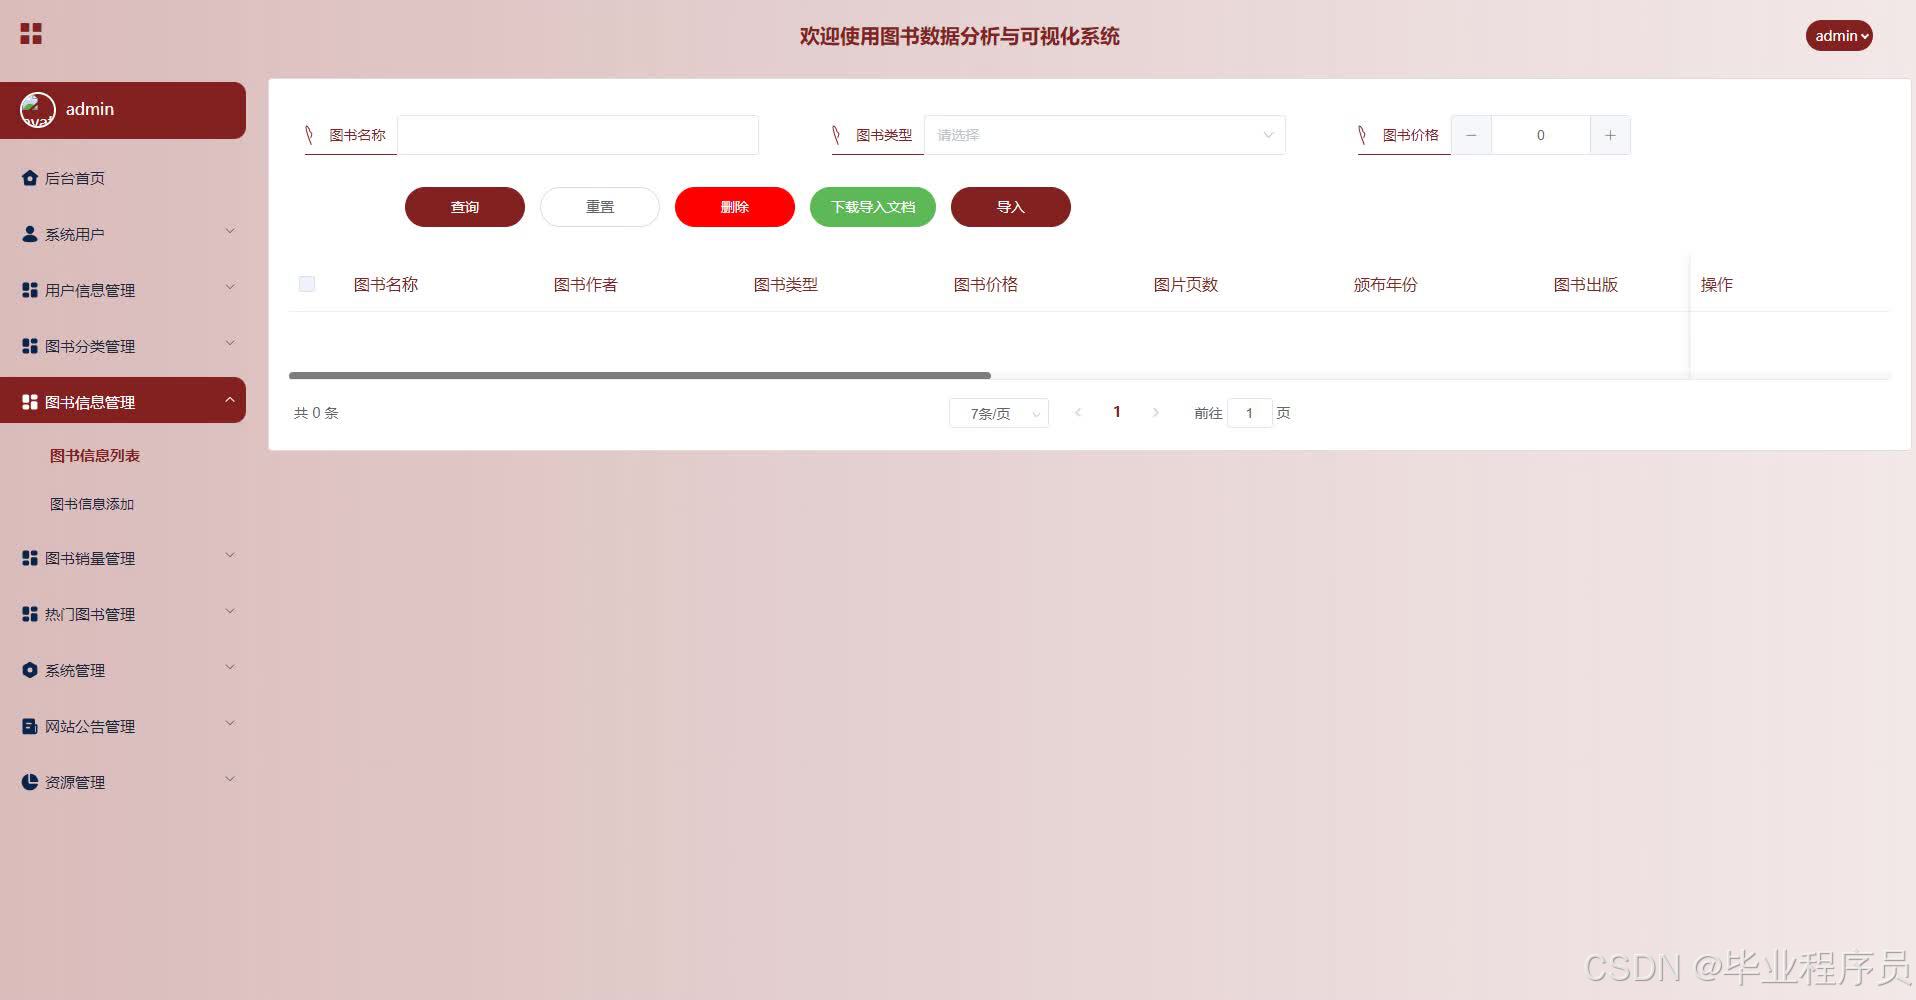
摘要:本文介绍了一个基于Django框架的图书数据分析与可视化系统,该系统整合了大数据处理、数据分析和可视化展示功能。系统采用Python语言开发,使用Django作为后端框架,Vue.js作为前端框架,MySQL作为数据库。主要功能包括:通过爬虫技术采集图书数据,进行数据预处理和分析,最终通过图表等形式实现可视化展示。文章详细阐述了系统架构、技术选型、功能模块、数据库设计以及实现过程,并包含系统
计算机毕业设计hadoop+spark+hive旅游推荐系统 旅游可视化系统 地方旅游网站 旅游爬虫 旅游管理系统 大数据毕业设计 机器学习 深度学习 知识图谱
本文介绍了一个基于Python的大数据航班信息分析系统,该系统整合了Django框架、MySQL数据库和Vue.js前端技术。系统主要功能包括:通过多源数据采集与预处理实现航班数据清洗;运用Pandas等工具进行价格、延误、流量及航空枢纽分析;采用Matplotlib等库实现多维数据可视化展示。文章详细阐述了系统架构设计、核心功能模块实现及测试验证过程,为航空业数据分析提供了完整的解决方案。系统具
本文系统梳理了基于Hadoop+Spark+Hive的租房推荐系统研究进展。通过分析分布式存储与计算框架的技术演进,探讨了协同过滤、内容推荐及混合算法的创新应用,重点阐述了数据预处理与特征工程的关键作用。研究指出当前系统面临数据质量、算法可解释性等挑战,并提出了知识图谱融合、强化学习等未来发展方向。该技术栈有效解决了租房信息过载问题,为实现精准推荐提供了技术支撑。
《基于Hadoop+Spark+Hive的美食推荐系统设计与实现》项目摘要: 本项目旨在构建一个高性能的美食推荐系统,采用Hadoop生态技术实现数据处理与分析。系统架构包含HDFS存储层、Hive数据仓库和Spark计算层,支持离线批处理和实时推荐。主要功能包括:通过Flume/Sqoop采集用户行为与菜品数据,利用Spark实现协同过滤与内容推荐算法,并基于SpringBoot提供RESTfu
本文提出一种基于Hadoop+Spark与知识图谱的中药推荐系统,通过分布式计算框架处理海量中药数据,结合知识图谱实现中药知识的结构化表示。系统采用分层架构设计,融合协同过滤、Wide&Deep模型与图神经网络算法,有效提升推荐准确性和响应速度。实验结果表明,该系统F1分数达0.71,平均响应时间≤500ms,用户满意度达82%,显著优于传统推荐方法。研究为中医药智能化服务提供了创新解决方
本文介绍了一个基于SpringBoot框架和大数据技术的个性化视频推荐系统。系统通过分析用户行为数据(观看历史、搜索记录等),利用Hadoop、Spark等大数据技术和机器学习算法,为用户提供个性化视频推荐。采用前后端分离架构,后端使用SpringBoot框架,前端使用Vue.js,数据库采用MySQL。文章详细阐述了系统架构、技术选型、功能模块和数据库设计,并提供了测试用例和源码获取方式。该系统
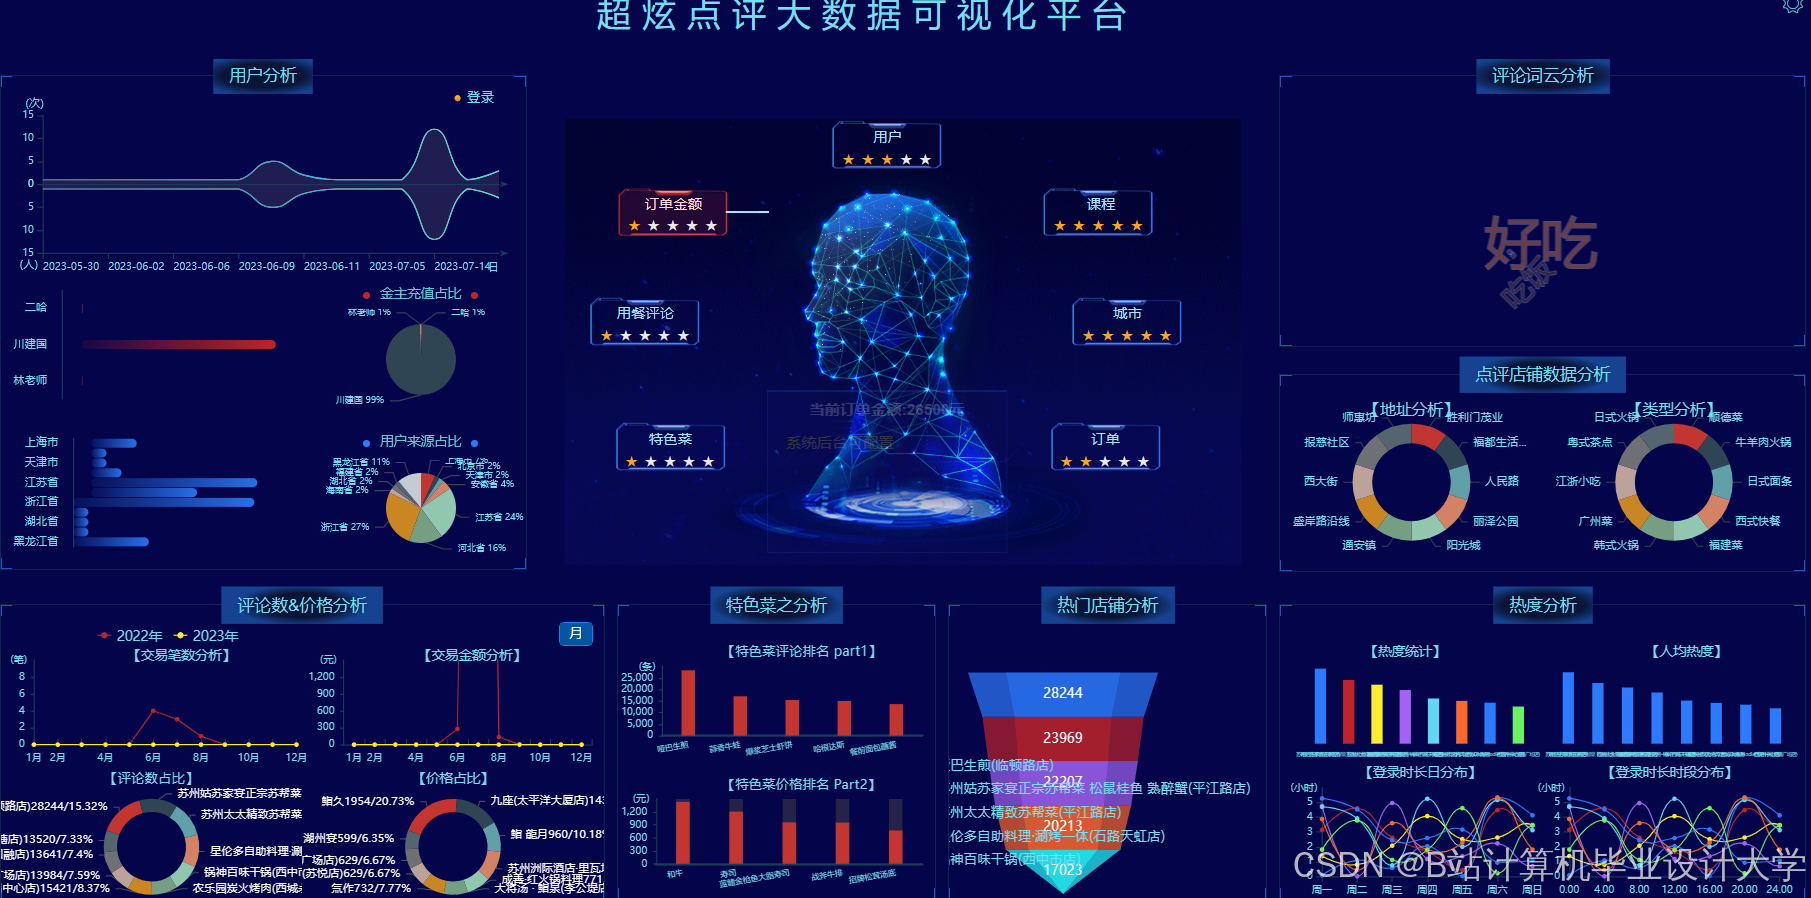
本文介绍了基于Python的餐饮外卖平台数据分析与可视化系统。该系统采用Python+Django框架开发,结合MySQL数据库和Vue.js前端技术,利用Pandas、Matplotlib等工具进行数据处理和可视化分析。文章详细阐述了系统开发的技术背景、功能架构、数据分析流程(包括数据收集、探索、建模和可视化),并提供了系统实现效果图和测试方案。该系统可帮助外卖平台分析用户行为、优化运营策略,为
摘要:本文介绍了一个基于Python的餐厅订单数据分析系统,该系统采用Django框架和MySQL数据库,结合Vue.js前端技术,旨在提升餐厅运营效率和服务质量。系统利用Pandas、NumPy等数据分析库进行订单数据处理与可视化,提供订单管理、数据分析和决策支持功能。文章详细阐述了系统架构、技术选型、核心功能模块及实现过程,并包含系统测试与效果展示。该系统为餐饮行业数字化转型提供了实用解决方案
摘要:本文介绍了一个基于Django和Spark的电力能耗数据分析系统,该系统整合了Python Web框架和大数据处理技术,旨在帮助电力企业优化能源使用。系统采用Django构建前端界面,Spark处理大规模能耗数据,MySQL存储分析结果,主要功能包括数据收集清洗、分布式分析、可视化展示和决策支持。文章详细阐述了系统架构、技术选型(Python 3.7/3.8、Vue.js等)和功能模块,同时
摘要:本项目基于Hadoop框架和Python技术,构建网购平台用户购买力差异分析系统。采用Django+Vue开发,结合HDFS存储和MapReduce处理海量用户行为数据,通过数据采集、预处理、存储、分析及可视化全流程,实现用户购买偏好识别和购买力评估。系统包含前台展示和后台管理模块,采用MySQL数据库,支持管理员和服务人员多角色操作。研究成果可为电商平台优化推荐策略、提升转化率提供数据支持
摘要:本文介绍了一个基于大数据技术的颈椎病预防交流与数据可视化分析平台。该系统采用Java语言开发,基于SpringBoot框架,使用MySQL数据库和Tomcat服务器。平台主要功能包括:1)数据收集与分析,挖掘颈椎病风险因素;2)用户交流互动空间;3)数据可视化展示患病趋势和预防效果。文章详细阐述了系统架构、技术基础、功能模块和数据库设计,并提供了测试用例和源码获取方式。该平台为颈椎病预防和治