
前端小白也能轻松掌握大模型?90天转行上岸路线+收藏攻略
本文为前端零基础转大模型的程序员提供了一套真实可落地、普通人能吃透的90天转行上岸路线。文章分析了前端转AI的天然优势和必须补齐的短板,并详细规划了90天的阶段性精准学习路线,包括Python数据基础、深度学习底层核心、Transformer、LoRA单卡微调实战、简历刚需项目落地、面试冲刺刷题复盘等。最后总结了转行核心总结,强调重工程、重落地、重项目细节、精准对标岗位需求的重要性。
给所有前端零基础转大模型的同学,分享一套真实可落地、普通人能吃透的90天转行上岸路线。无天赋、无科班优势、无算法底子,完全靠阶段性精准学习成功转型,非常适合被裁、想转赛道、零基础小白参考。
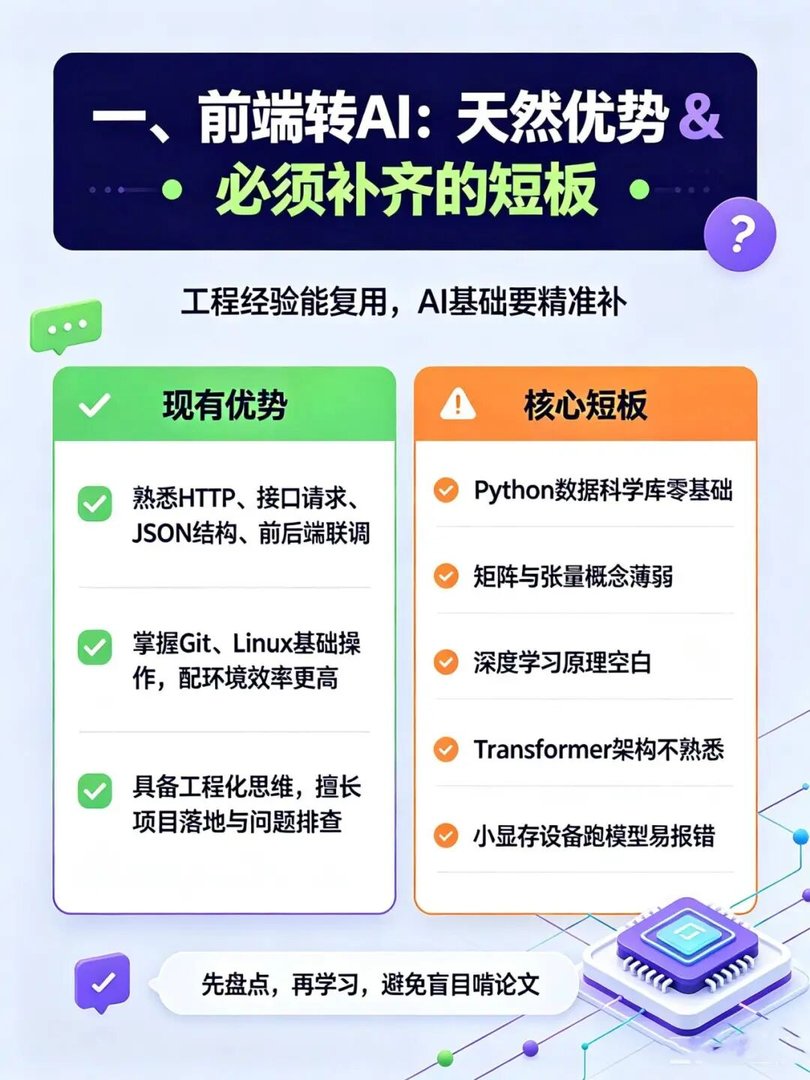
一、前端转AI:天然优势 & 必须补齐的短板
✅ 现有优势(可以直接复用) 1. 熟悉HTTP、接口请求、JSON结构、前后端联调,适配模型服务部署、API对接场景; 2. 掌握Git、Linux基础操作,配环境、跑项目比纯零基础新手快很多; 3. 具备工程化思维,更擅长落地项目、排查业务问题,适配企业AI应用岗需求。
❌ 必须补齐的核心短板 Python数据科学库零基础、矩阵/张量概念薄弱、深度学习原理空白、Transformer完全不懂、本地小显存设备跑模型极易报错。
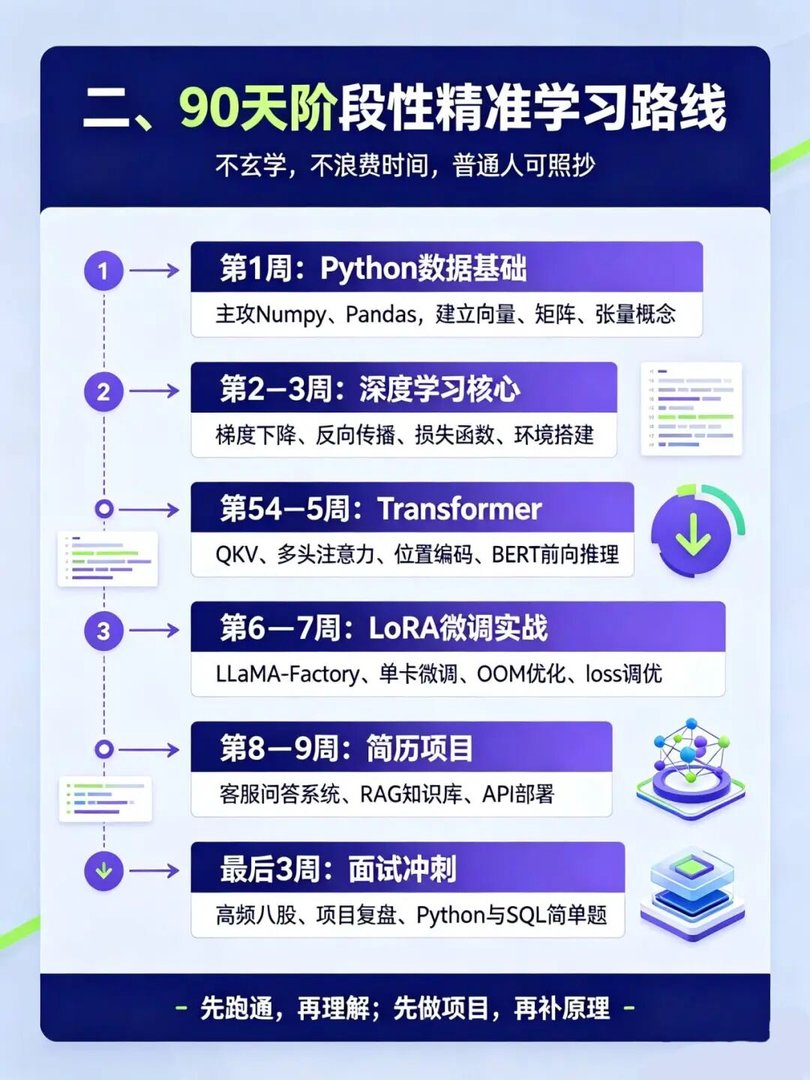
二、90天阶段性精准学习路线(不玄学、不浪费时间)
第1周:极速补齐Python数据基础不用从头啃语法(和JS逻辑互通),直接主攻Numpy、Pandas,建立向量、矩阵、张量核心概念。手动实现简单线性回归,熟悉数据处理逻辑,快速摆脱“只会打印Hello World”的阶段。
第2–3周:深度学习底层核心倍速刷机器学习基础课程,重点吃透梯度下降、反向传播、损失函数调优核心逻辑,不求面面俱到,但必须理解模型权重更新原理。同时完整搭建AI运行环境:CUDA、cuDNN、PyTorch、HuggingFace,解决驱动崩溃、环境冲突等基础问题,保证后续项目可正常运行。
第4–5周:硬啃Transformer(面试核心)放弃复杂数学推导,主打面试能用、项目能跑。吃透QKV计算逻辑、多头注意力机制、位置编码作用、Transformer完整架构。每天实操BERT-base前向推理,熟悉模型输入输出链路,能独立画图、口述原理,应对八股追问。
第6–7周:LoRA单卡微调实战(核心项目能力)主攻企业主流轻量微调方案,使用LLaMA-Factory框架,适配低显存设备。针对性解决OOM显存溢出问题,通过调小batchsize、缩短max_length适配本地6G显存。完成多组数据集微调,掌握数据清洗、噪音过滤、loss调优、模型效果对比的完整流程。
第8–9周:落地2个简历刚需项目(上岸关键)1. 大模型微调客服问答系统:自行采集、清洗对话数据,完成SFT微调,部署为API服务,可稳定响应业务问题; 2. 企业RAG知识库系统:实现文档切片、向量化存储、相似度检索、上下文问答,掌握ChromaDB向量库使用、检索优化、幻觉抑制方案。 所有Bug、报错、优化方案全部复盘,作为面试核心谈资。
最后3周:面试冲刺刷题复盘专攻大模型高频八股:SFT预训练区别、LoRA/Adapter微调差异、RLHF核心流程、显存优化策略、vLLM推理加速、Prompt工程规范。算法不深究难题,只刷Python、SQL简单题,重心放在项目复盘、问题拆解、工程落地。
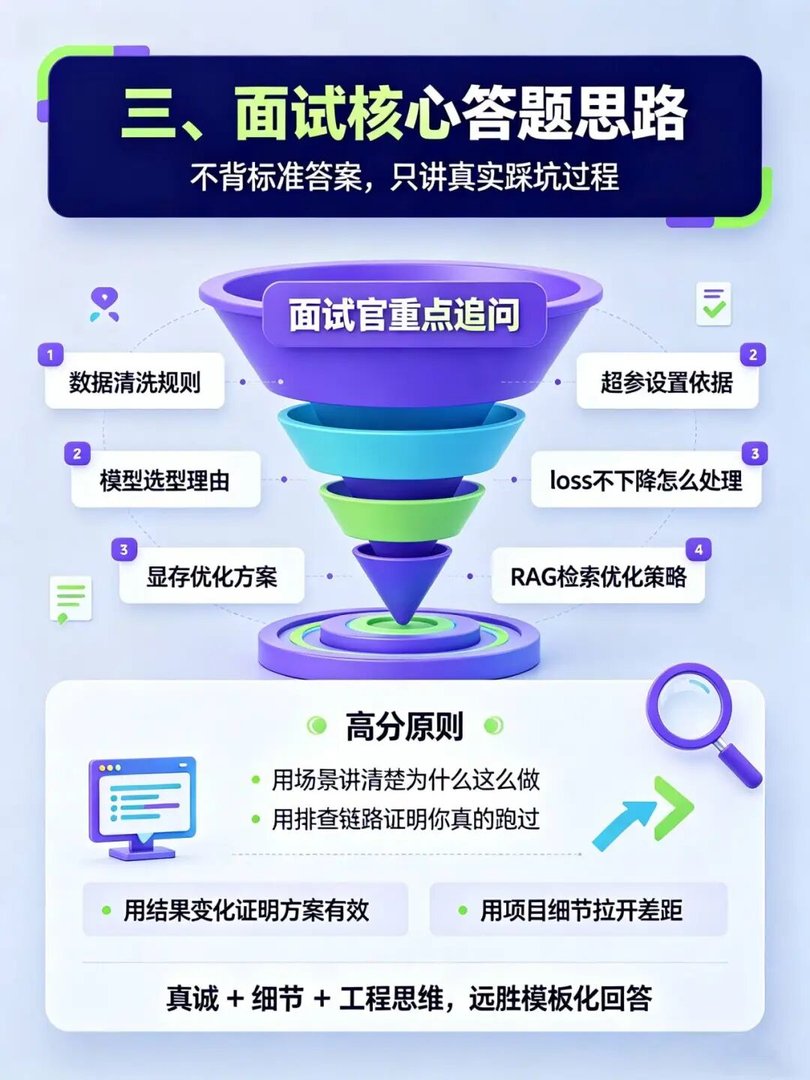
三、面试核心答题思路(通过率极高)面试官重点追问:数据清洗规则、模型选型理由、超参设置依据、loss不下降解决方案、显存优化方案、RAG检索优化策略。 核心原则:不背标准答案,只讲自己实操踩坑、排查、优化的真实过程,真诚且有细节,远超模板化回答。
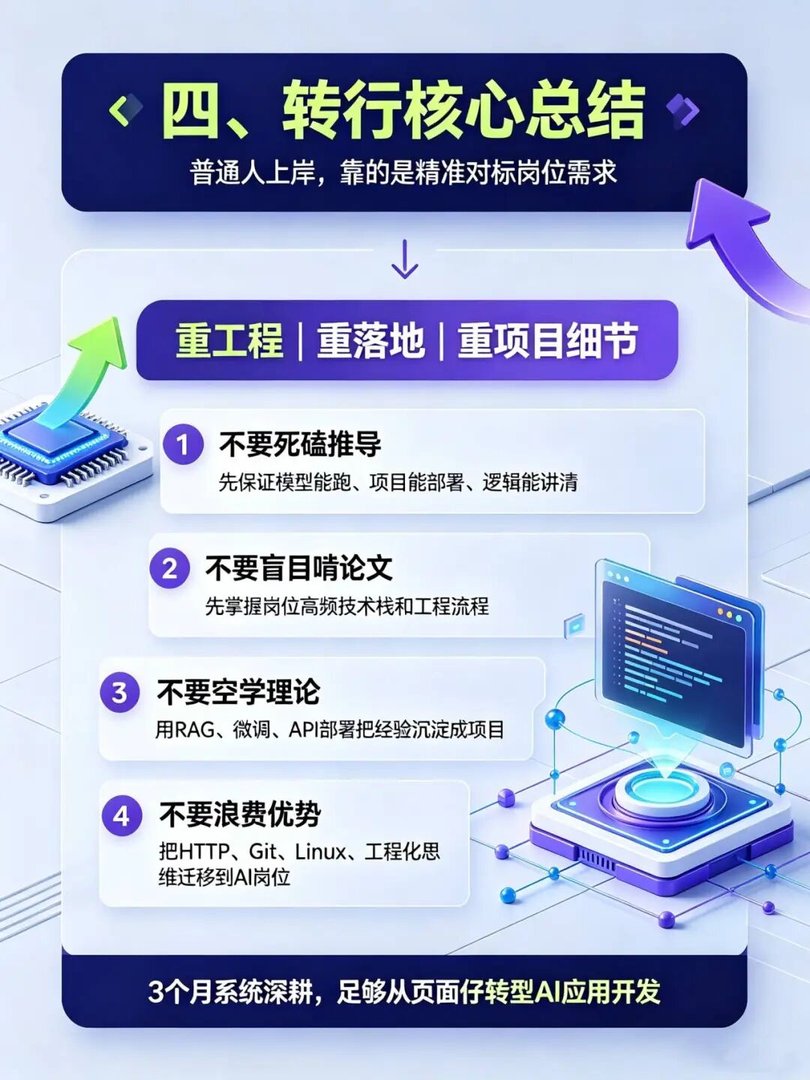
四、转行核心总结前端转大模型,不需要天赋、不需要深厚算法功底,最怕盲目啃论文、死磕推导、追求玄学知识点。普通人上岸的核心:重工程、重落地、重项目细节、精准对标岗位需求。3个月系统深耕,完全足够从页面仔转型AI应用开发。
如何学习大模型 AI ?
由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。
但是具体到个人,只能说是:
“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。
这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。
我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。
我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
这份完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】

为什么要学习大模型?
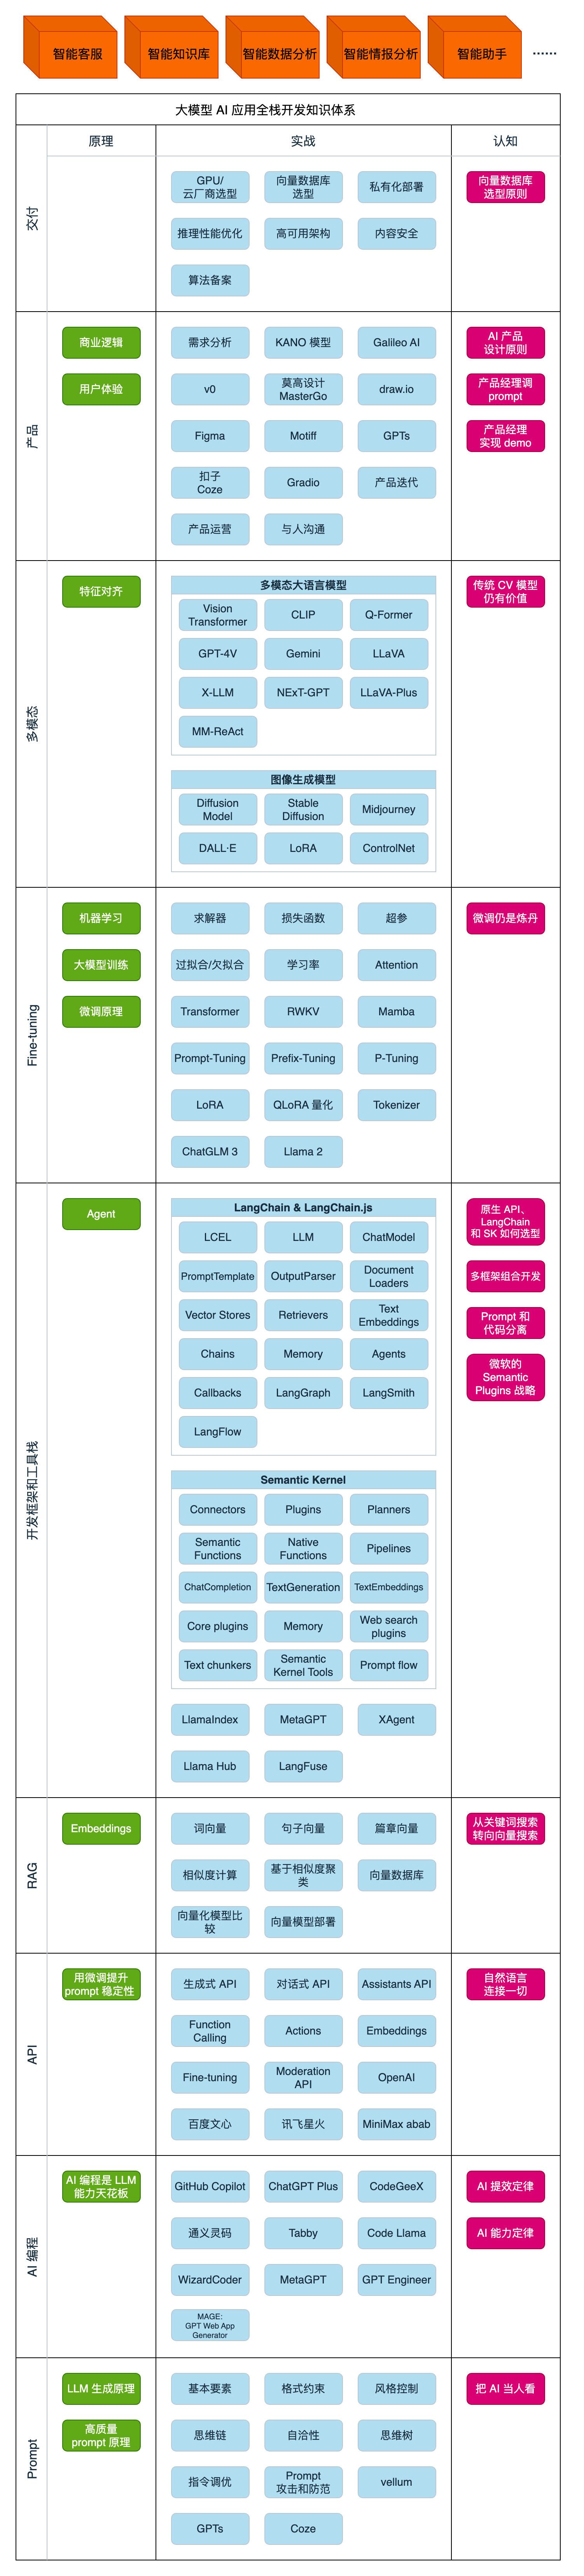
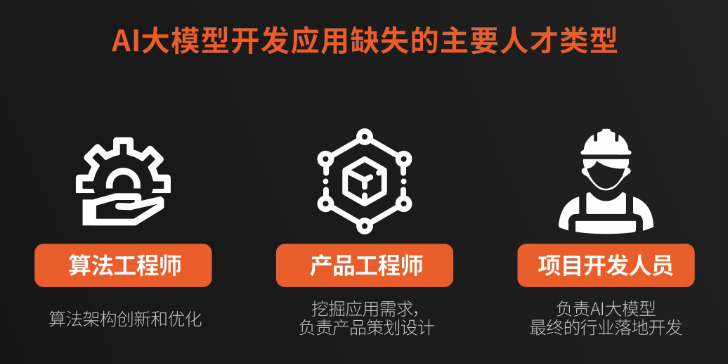
我国在A大模型领域面临人才短缺,数量与质量均落后于发达国家。2023年,人才缺口已超百万,凸显培养不足。随着AI技术飞速发展,预计到2025年,这一缺口将急剧扩大至400万,严重制约我国AI产业的创新步伐。加强人才培养,优化教育体系,国际合作并进是破解困局、推动AI发展的关键。
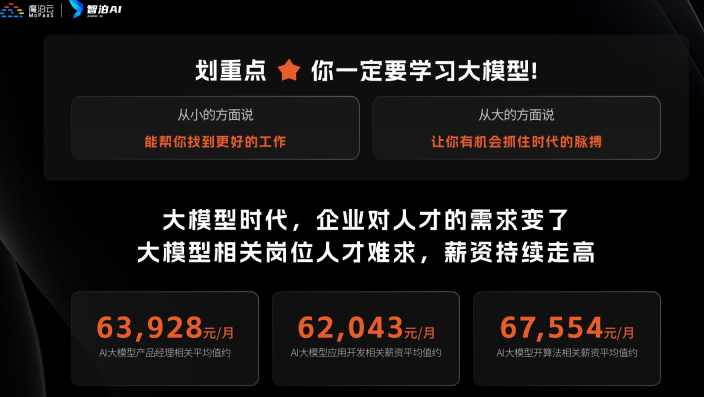
大模型入门到实战全套学习大礼包
1、大模型系统化学习路线
作为学习AI大模型技术的新手,方向至关重要。 正确的学习路线可以为你节省时间,少走弯路;方向不对,努力白费。这里我给大家准备了一份最科学最系统的学习成长路线图和学习规划,带你从零基础入门到精通!
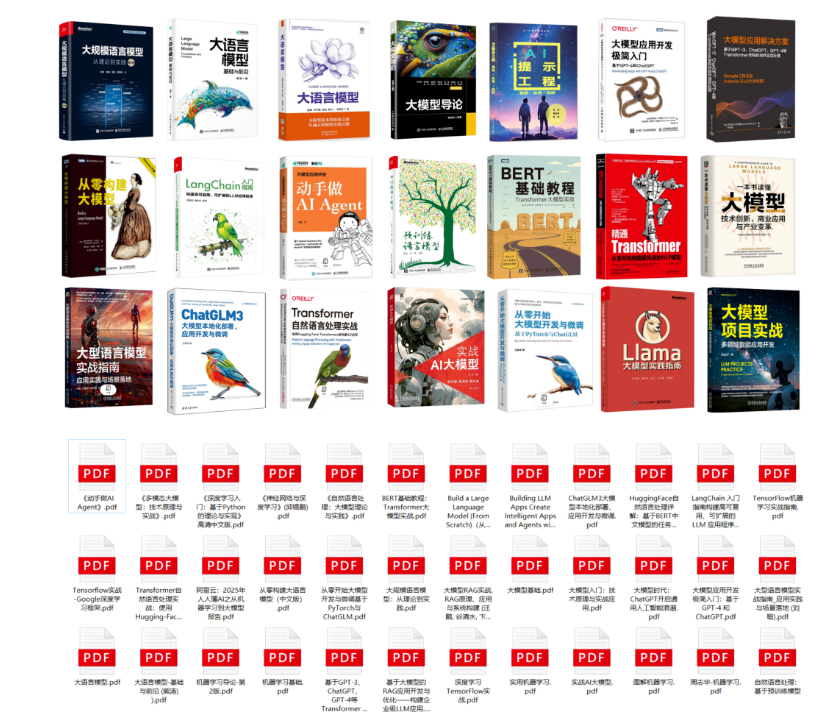
2、大模型学习书籍&文档
学习AI大模型离不开书籍文档,我精选了一系列大模型技术的书籍和学习文档(电子版),它们由领域内的顶尖专家撰写,内容全面、深入、详尽,为你学习大模型提供坚实的理论基础。
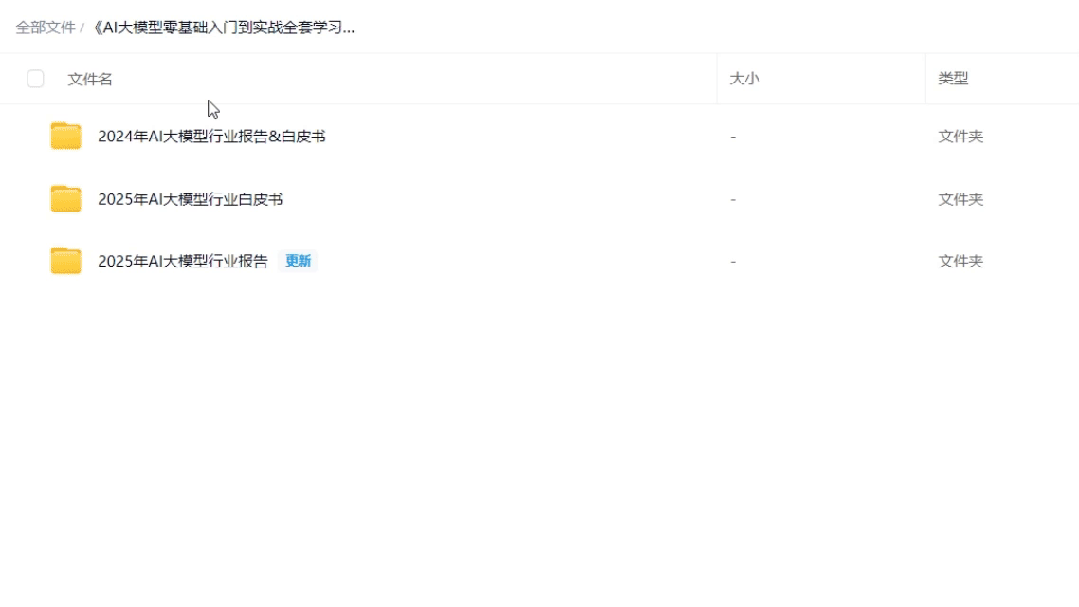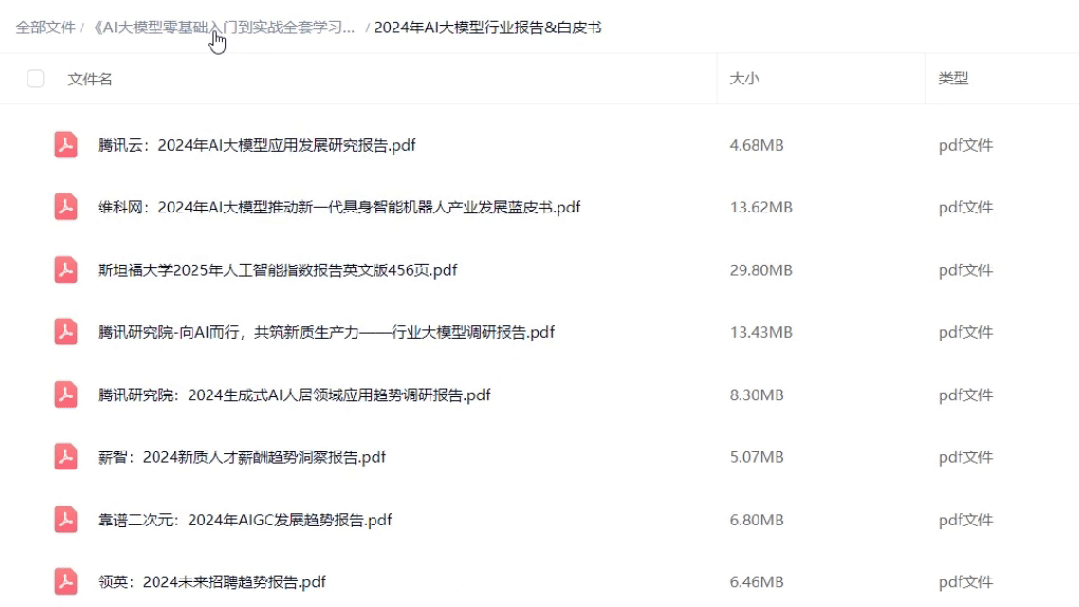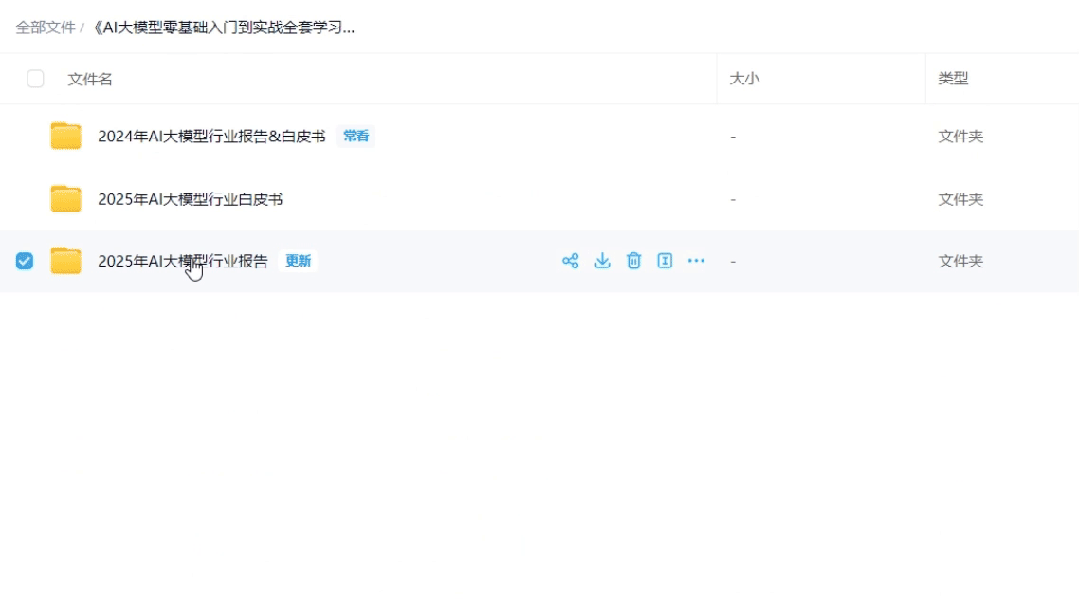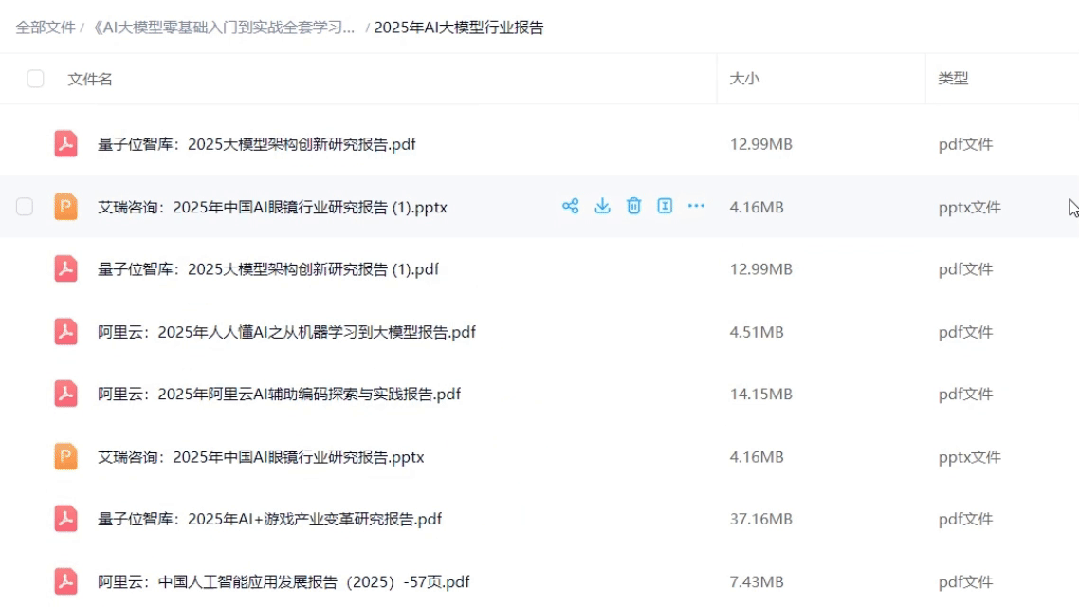
3、AI大模型最新行业报告
2025最新行业报告,针对不同行业的现状、趋势、问题、机会等进行系统地调研和评估,以了解哪些行业更适合引入大模型的技术和应用,以及在哪些方面可以发挥大模型的优势。
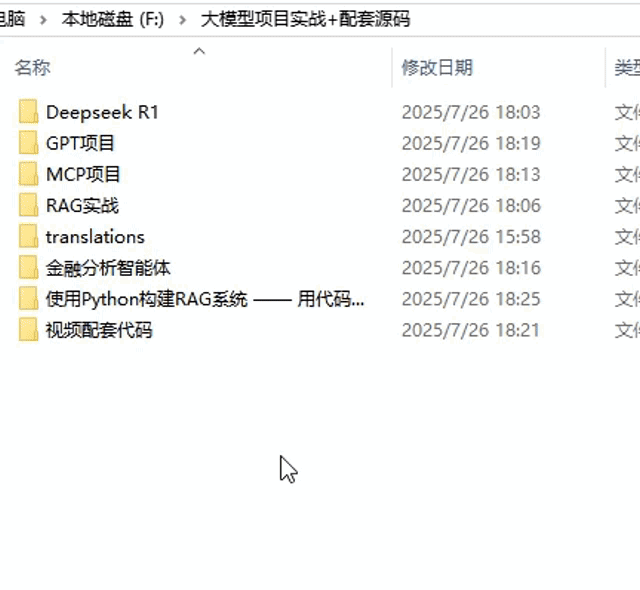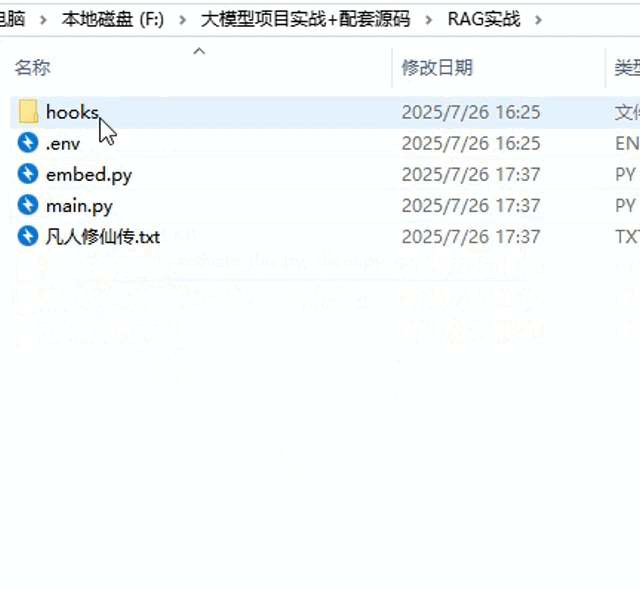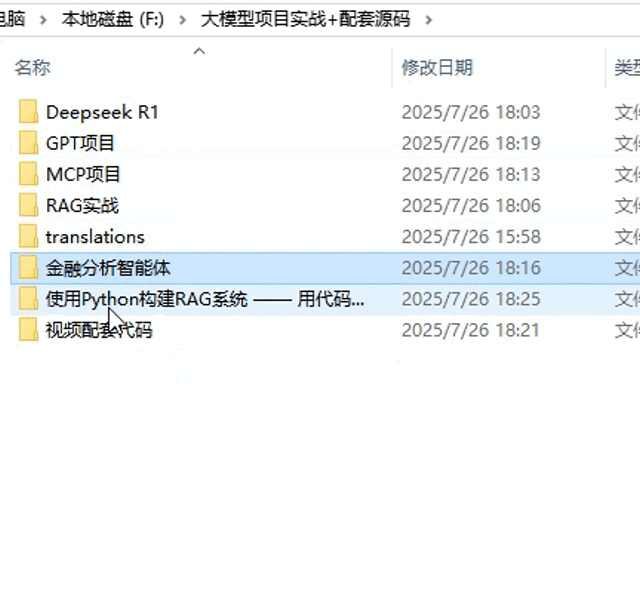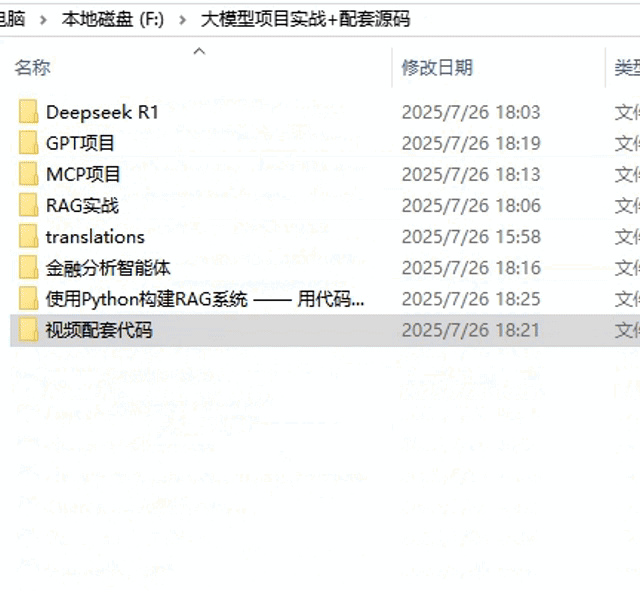
4、大模型项目实战&配套源码
学以致用,在项目实战中检验和巩固你所学到的知识,同时为你找工作就业和职业发展打下坚实的基础。
5、大模型大厂面试真题
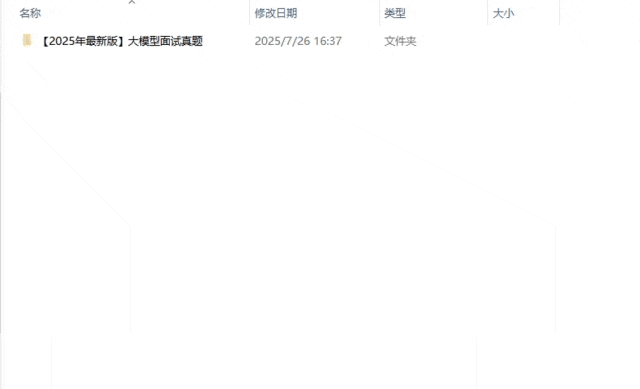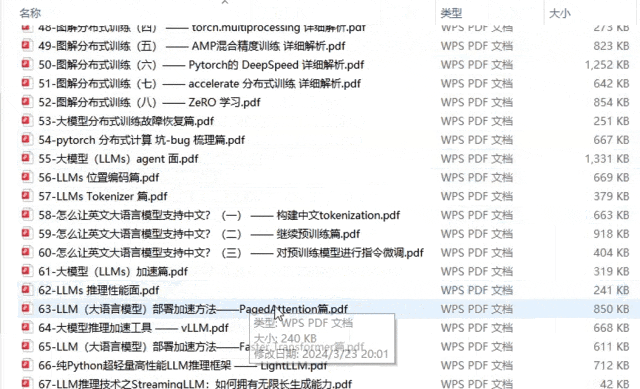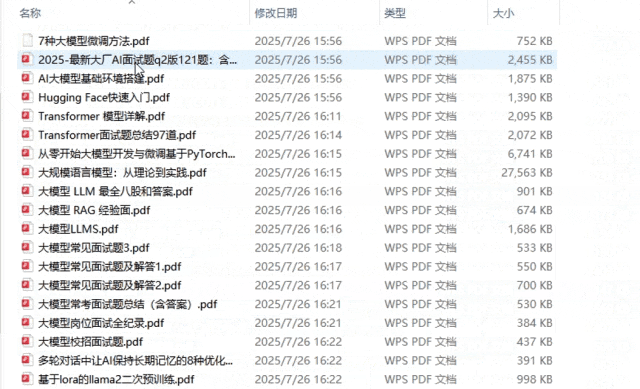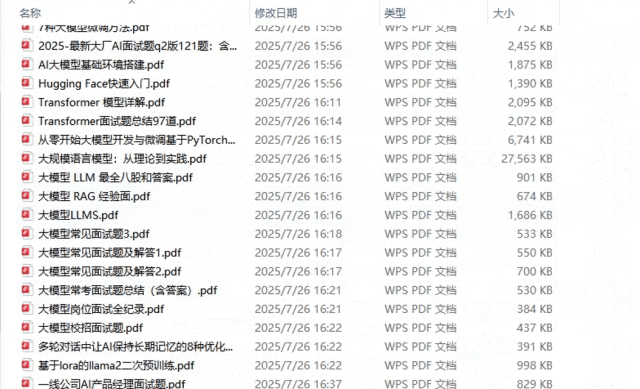
面试不仅是技术的较量,更需要充分的准备。在你已经掌握了大模型技术之后,就需要开始准备面试,我精心整理了一份大模型面试题库,涵盖当前面试中可能遇到的各种技术问题,让你在面试中游刃有余。
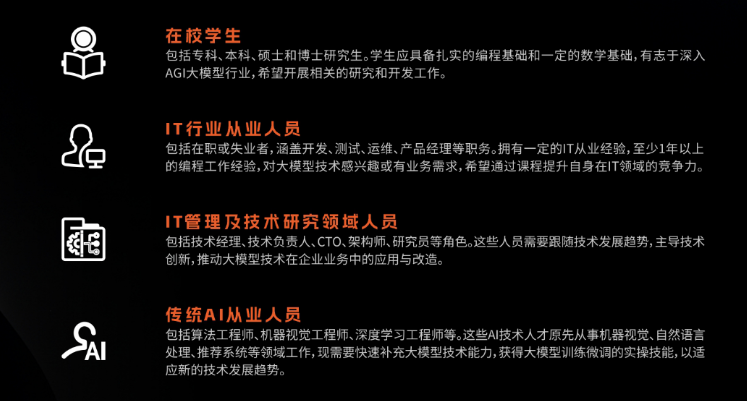
适用人群
第一阶段(10天):初阶应用
该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。
- 大模型 AI 能干什么?
- 大模型是怎样获得「智能」的?
- 用好 AI 的核心心法
- 大模型应用业务架构
- 大模型应用技术架构
- 代码示例:向 GPT-3.5 灌入新知识
- 提示工程的意义和核心思想
- Prompt 典型构成
- 指令调优方法论
- 思维链和思维树
- Prompt 攻击和防范
- …
第二阶段(30天):高阶应用
该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。
- 为什么要做 RAG
- 搭建一个简单的 ChatPDF
- 检索的基础概念
- 什么是向量表示(Embeddings)
- 向量数据库与向量检索
- 基于向量检索的 RAG
- 搭建 RAG 系统的扩展知识
- 混合检索与 RAG-Fusion 简介
- 向量模型本地部署
- …
第三阶段(30天):模型训练
恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。
到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?
- 为什么要做 RAG
- 什么是模型
- 什么是模型训练
- 求解器 & 损失函数简介
- 小实验2:手写一个简单的神经网络并训练它
- 什么是训练/预训练/微调/轻量化微调
- Transformer结构简介
- 轻量化微调
- 实验数据集的构建
- …
第四阶段(20天):商业闭环
对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。
- 硬件选型
- 带你了解全球大模型
- 使用国产大模型服务
- 搭建 OpenAI 代理
- 热身:基于阿里云 PAI 部署 Stable Diffusion
- 在本地计算机运行大模型
- 大模型的私有化部署
- 基于 vLLM 部署大模型
- 案例:如何优雅地在阿里云私有部署开源大模型
- 部署一套开源 LLM 项目
- 内容安全
- 互联网信息服务算法备案
- …
学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。
如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。
这份完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】
更多推荐


 0
 0
- 0


 已为社区贡献97条内容

所有评论(0)