
微服务别直接塞给 Agent:先补上下文地图和契约测试
你把一个跨订单、库存、支付的 user story 丢给 Agent。它改得很快,PR 也像模像样,但只看了订单服务,没发现库存事件的字段约定已经变了。联调一跑,链路炸在最不起眼的接口边界上。
这是跨微服务用 Agent 最容易踩的坑:不是模型不会写代码,而是它没有服务地图,也没有一条能在本地跑起来的契约验证线。
把所有仓库放进一个 workspace 有用,但只能解决“看得到代码”。要让 Agent 真能改跨服务需求,还要补三件事:
1. 全局视图:先知道系统由哪些服务组成。
2. 精准上下文:按需读取服务边界、领域概念和接口协议。
3. 验证闭环:改完代码后,用契约测试和 mock server 自查。
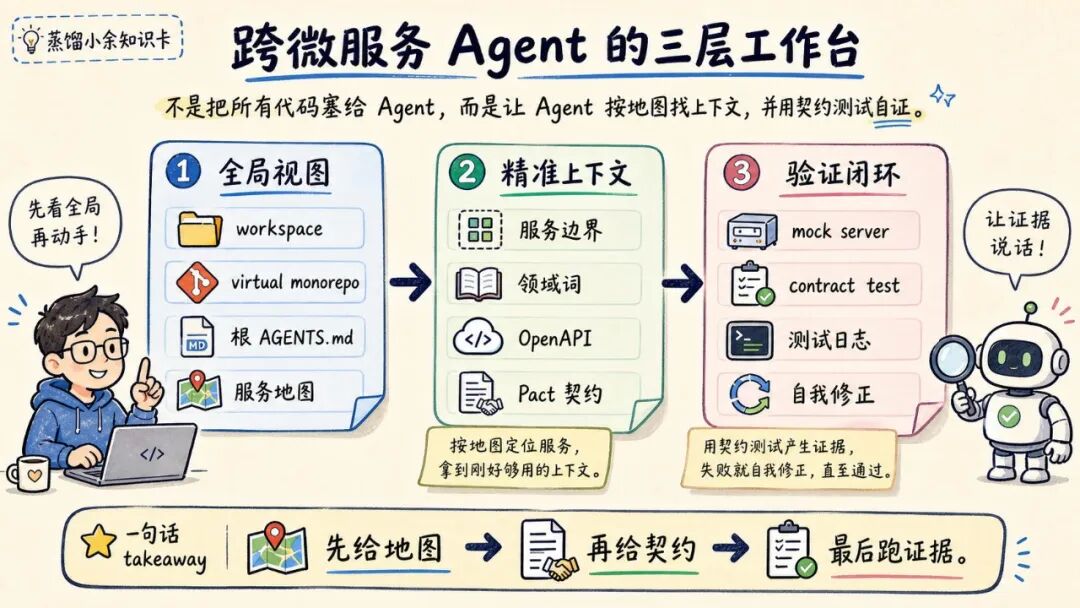
有了服务地图、协议边界和验证闭环,Agent 才不是在一堆仓库里盲翻文件,而是在一张工程地图上做局部探索和局部验证。
一个 workspace 只是起点,不是答案
先把服务放在一个地方,确实值得做。
如果你本来就是 monorepo,Agent 可以同时看到 schema、API 协议、测试代码和多个服务的实现。它不需要在十几个独立仓库之间猜路径、补背景、手动拼调用链。
如果历史原因没法合并成 monorepo,也可以做一个 virtual monorepo:把相关仓库 clone 到同一个本地目录,用统一的根目录给 Agent 入口。
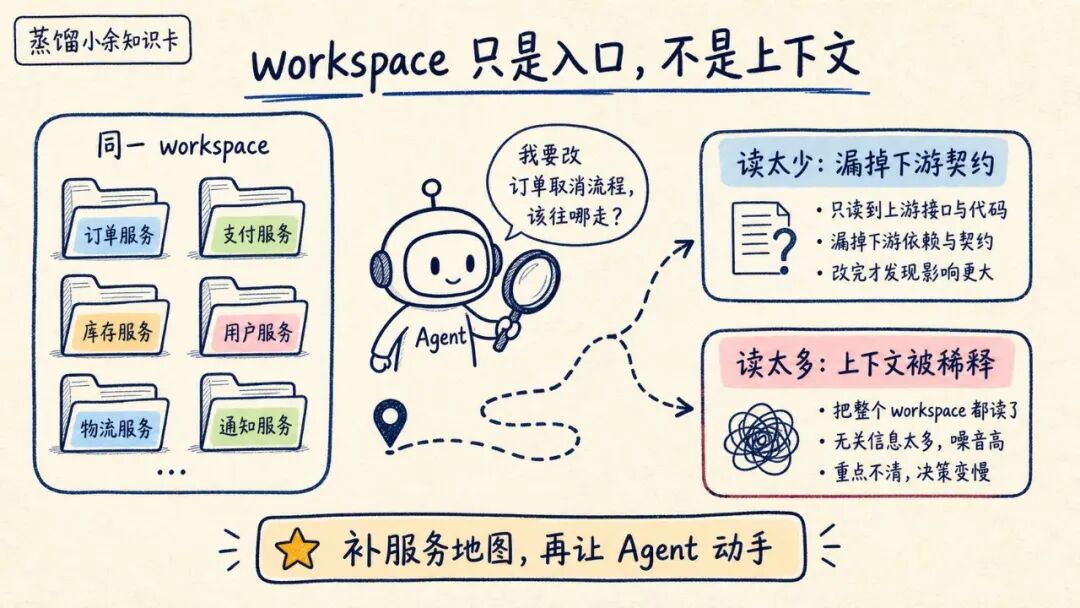
但 workspace 只解决“看得到”的问题,不会自动告诉 Agent “先看什么”。
Agent 一旦面对十几个服务,很容易出现两种坏结果:
• 读太少:只看当前服务,漏掉上游调用方或下游提供方的协议。
• 读太多:把一堆 README、接口文档、旧设计稿全塞进上下文,最后注意力被稀释。
Anthropic 在 context engineering 里强调过同一个取舍:上下文是有限资源。Agent 需要的是高信号、按需加载的材料,不是“所有资料都来一点”。
所以根目录要放的不是一份巨型说明书,而是一张服务地图。
根 AGENTS.md 做路由,服务 AGENTS.md 做边界
我会把跨微服务 Agent 的文档拆成两层。
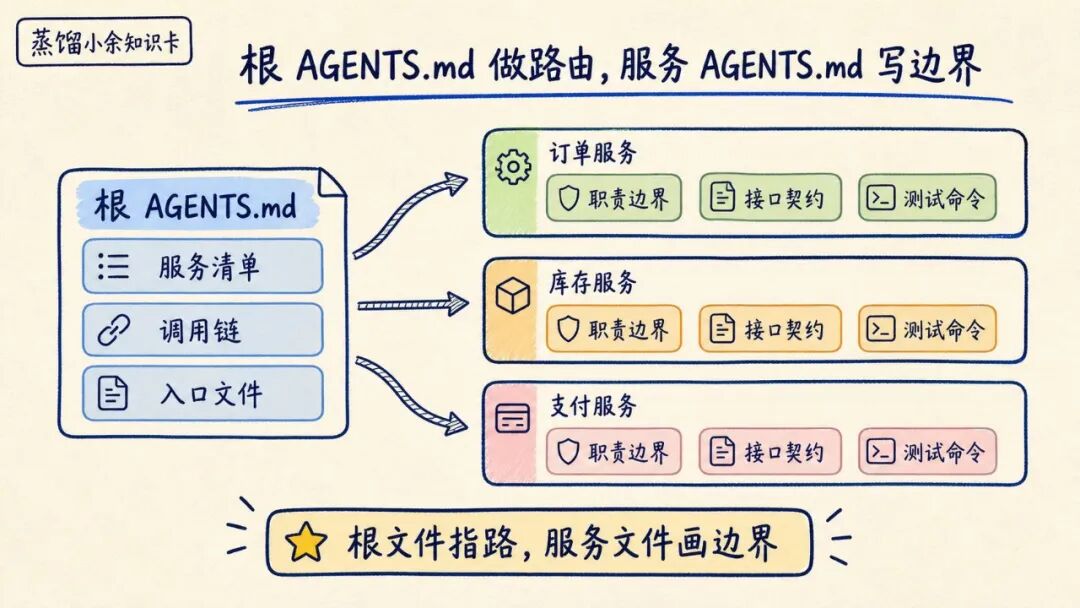
第一层是根目录 AGENTS.md,只回答四个问题:
• 系统里有哪些服务?
• 每个服务负责哪块业务?
• 常见 user story 会跨哪几个服务?
• Agent 要改某类需求时,应该先读哪些服务目录?
根文件不要写太细。它的职责是路由,不是替每个服务写百科。
第二层是服务目录里的 AGENTS.md 或 CLAUDE.md,重点写局部边界:
• 这个服务的 bounded context 是什么?
• 它拥有哪些主要实体和业务词?
• 它暴露哪些 API、事件或队列消息?
• 它依赖哪些上游/下游服务?
• 改动后必须跑哪些测试命令?
这和新人入组很像。你不会一上来塞给他 300 页系统全景文档,而是先给系统地图,再告诉他:这个需求涉及订单、库存和支付,先看这三个服务的边界和契约。
好的上下文结构不负责替 Agent 写答案,它负责告诉 Agent 下一步该去哪里找答案。
手写文档不够,协议才是硬上下文
微服务文档最大的问题不是没人写,而是很快过期。
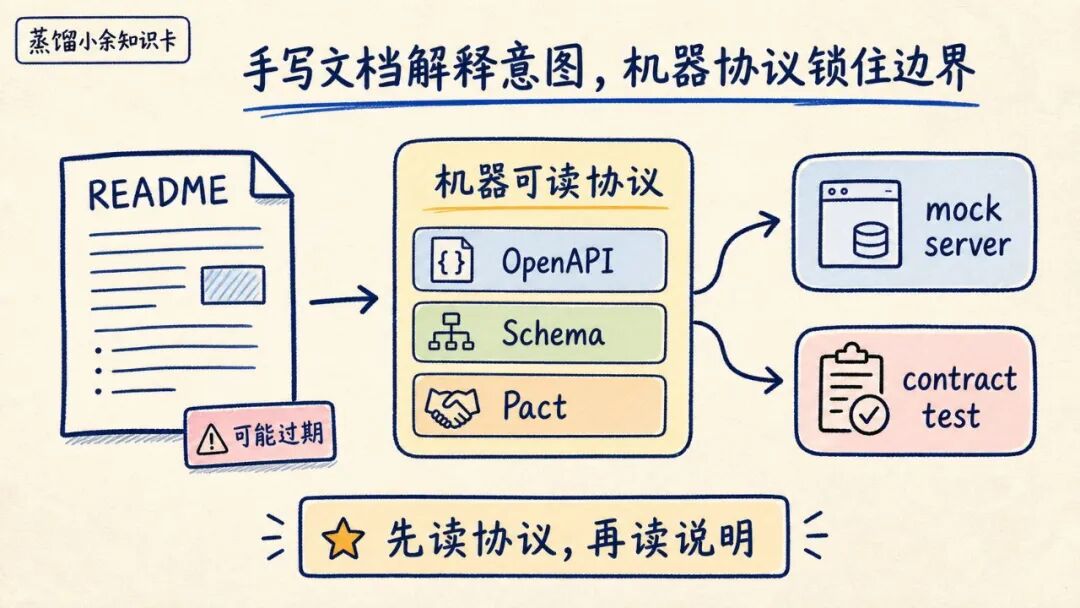
服务接口变了、字段语义变了、错误码变了,README 可能还停留在上个季度。人类开发者会带着怀疑去问同事,Agent 却可能把旧文档当事实。
能从代码或规格生成的内容,尽量不要只靠手写。
OpenAPI、GraphQL schema、protobuf、AsyncAPI、数据库 migration、事件样例、Pact 契约文件,对 Agent 更有价值,因为它们更接近系统真实边界。
OpenAPI 官方定位很直接:它让人和计算机在不看源代码、不抓包的情况下理解 HTTP API 的能力,并且可以被文档、代码生成和测试工具使用。
对 Agent 来说,这决定了它能不能在本地复现另一个服务,而不是凭 README 猜接口。
一份好的 OpenAPI spec,不只是接口说明。它还能生成 mock server,能生成客户端类型,能驱动 contract test,能让 Agent 在本地模拟另一个服务的响应。
手写文档负责解释业务意图,机器可读协议负责约束真实边界。两者缺一不可,但优先级不能反过来。
跨服务需求必须有本地验证闭环
跨微服务改动最麻烦的地方,是验证成本高。
一个 user story 可能要改前端、订单、库存、支付、通知。你不可能让 Agent 每改一次都拉起完整集成环境,更不应该让它改完只说“看起来可以”。
我更愿意把验证拆到协议层。
每个服务提供两类东西:
• mock server:基于 OpenAPI 或固定契约,模拟依赖服务的响应。
• contract test:验证调用方和提供方是否仍然遵守同一个接口约定。
Pact 对 contract testing 的定义很适合微服务:检查应用之间发送或接收的消息,是否符合一份共同理解的契约。它尤其适合多服务环境,因为完整集成测试往往又贵又脆。
把这些入口接进 Agent 工作流后,闭环就变得很具体:
读取根服务地图
-> 定位相关服务
-> 读取服务边界和接口规格
-> 修改局部代码
-> 启动 mock server
-> 运行 contract test
-> 根据失败信息自我修正
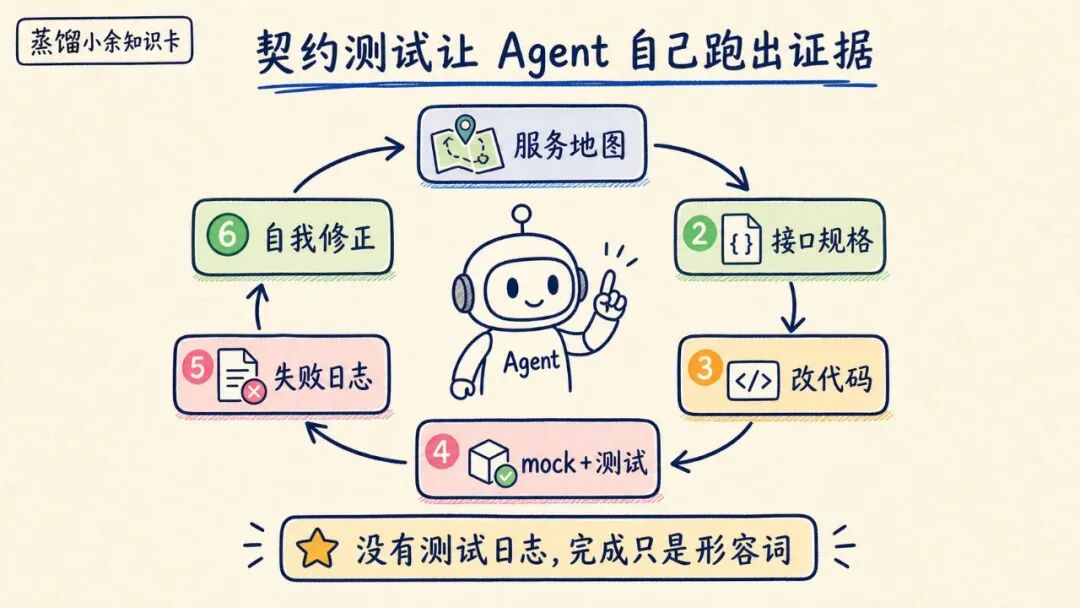
这条链路比“让 Agent 把整个系统跑起来”现实得多,也更容易在普通开发机上复现。
Agent 不需要每次都等完整环境。只要能证明当前服务没有破坏约定,局部改动就可以先进入可评审状态。
给团队的一张落地清单
如果团队准备让 Agent 参与跨微服务开发,我建议先补这张清单。
|
层级 |
要准备什么 |
给 Agent 的作用 |
|
全局视图 |
根 |
知道该看哪些服务,不盲扫仓库 |
|
服务边界 |
服务级 |
理解 bounded context,不乱改别人的业务 |
|
接口协议 |
OpenAPI、schema、事件样例、错误码 |
用机器可读格式锁住真实接口 |
|
验证入口 |
mock server、contract test、局部 CI 命令 |
改完能自查,不靠口头保证 |
|
交付证据 |
测试日志、改动摘要、剩余风险 |
让人类 reviewer 快速接手 |
这张表里最容易被低估的是最后一层:交付证据。
Anthropic 在 long-running agents 的实践里提到,长任务里的 Agent 很容易一次做太多,或者没有充分测试就宣称完成。解决思路不是继续加大 prompt,而是给它 feature list、progress file、git history 和明确的测试工具。
放到微服务里,我会要求 Agent 每次交付时说明:
• 本次改了哪些服务?
• 依赖了哪些接口契约?
• 跑了哪些 contract test?
• 哪些路径还没被验证?
• 是否需要人类确认业务语义?
没有这些证据,Agent 的“完成”只是一个形容词,不是工程状态。
我会怎么落地
如果团队已经有十几个微服务,我不会第一天就要求大家补齐完美文档。
我会按风险顺序做三步:
第一步,选一条高频 user story,把它涉及的 3 到 5 个服务放进 virtual monorepo。根目录只写服务地图和启动方式,不写长篇设计史。
第二步,只给这几个服务补局部 AGENTS.md:职责边界、领域词、关键 API、测试命令。旧文档先不搬,避免把过期信息带进上下文。
第三步,把最关键的服务间接口做成 OpenAPI spec 或 Pact 契约。先让 Agent 跑通一条 contract test,再逐步扩大覆盖面。
这比“先建设完整知识库,再让 Agent 上岗”更现实。
Agent 工程化不追求资料库看起来完整,先追求每次改动都有足够上下文和可验证证据。
最大坑:把文档当上下文,把测试当收尾
很多团队会把文档建设放在前面,把测试放在最后。
在 Agent 场景里,这个顺序要反过来想。
文档是帮助 Agent 找路的,测试才是防止它走偏的。尤其是跨微服务需求,只要协议没被验证,Agent 写出的设计再顺,也可能在真实链路里撞墙。
我的判断很简单:
如果团队只准备做一件事,不要先把所有 README 整理漂亮,先把“服务地图 + 机器可读协议 + 契约测试”连起来。
这套闭环会逼着文档保持克制,也会逼着 Agent 拿局部证据说话。
跨微服务用 Agent,不怕它看不到全部代码,怕的是它看到了太多,却没有一条可靠的验证线。
更多推荐


 6
 0
- 0


 已为社区贡献23条内容

所有评论(0)