
前端转大模型:把落地步骤拆成清单
聊《前端转大模型:一次新的项目切入》之前,先说一句实在的:别急着背概念,先看它在真实项目里到底解决什么问题。
摘要
先把这篇文章的目标说清楚:看完之后,你应该能判断这件事值不值得做,以及从哪里动手。
前阵子我在重构一个内部的智能客服 Demo 时,遇到了一件挺有意思的事。
原本以为前端转做大模型应用,难点在于怎么调 API、怎么写 Prompt,或者搞懂 LangChain 那些复杂的链式调用。结果代码跑通了,对话也流畅,但在测试环境里一切正常,一旦接入真实的权限体系和操作日志,整个系统的稳定性就开始崩塌。
这给我上了重要的一课:大模型应用的护城河,早已不在“能不能生成内容”,而在“能不能在复杂工程中稳定运行”。
现在的行业风向很明确:从炫技式的 Demo 转向关注权限控制、全链路日志和可观测性。对于前端开发者来说,这是一个巨大的机会,因为大部分传统后端出身的同学并不擅长处理这种强交互、流式响应的复杂 UI 状态,而我们需要补上的,恰恰是工程化的短板。
目录
- 前端的转型优势:别只盯着 UI
- AI 应用交互模式:流式输出的陷阱
- 多模态体验:不仅是图片
- 工程化深水区:权限、日志与可观测
- 作品集方向:如何展示你的能力
- 总结
前端的转型优势:别只盯着 UI
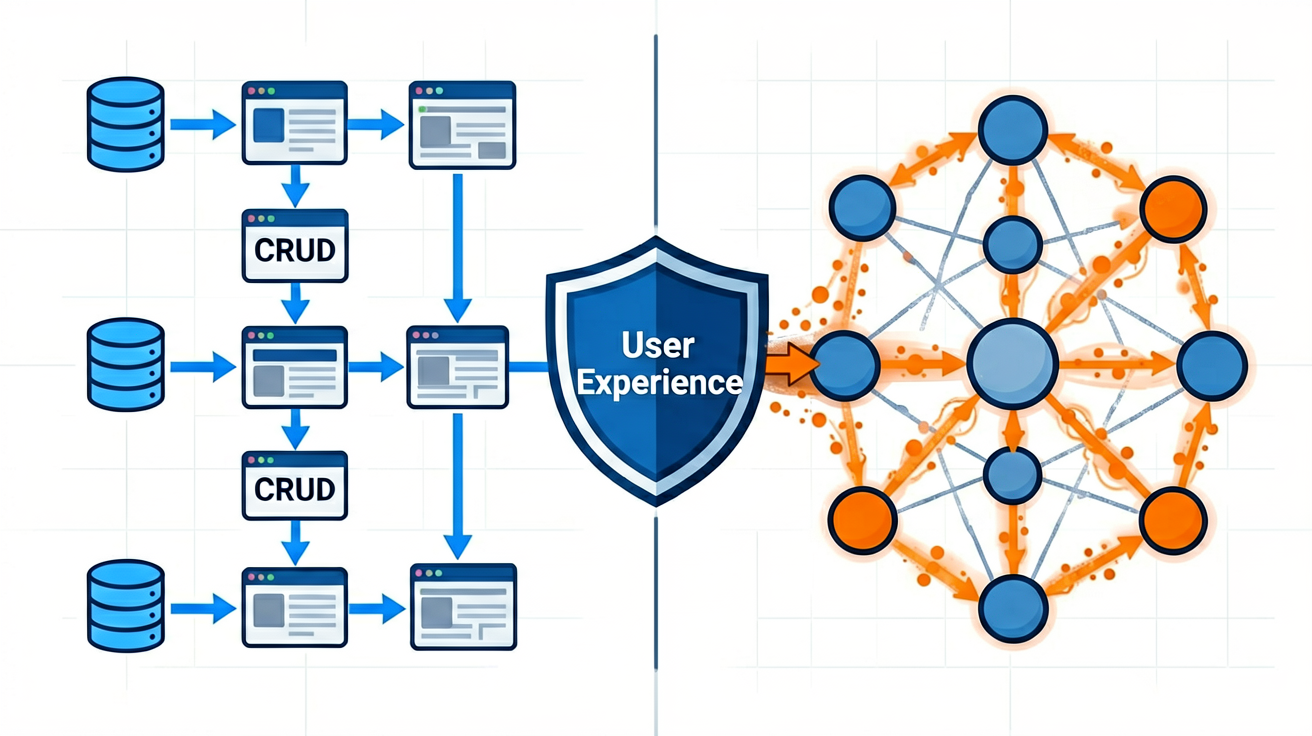
很多人觉得前端转大模型就是做个 Chat 界面,那太狭隘了。
大模型应用(LLM App)本质上是数据流 + 状态机 + 用户交互。前端工程师天然对状态管理敏感。在传统的 CRUD 应用中,我们处理的是确定的数据;而在 LLM 应用中,我们要处理的是非确定性、流式、异步且可能中断的数据。
我的观点是:前端的核心竞争力在于“将不可控的模型输出转化为可控的用户体验”。
当你开始思考如何让一个正在生成的 Token 能够被用户中途打断、如何优雅地展示思考过程(Thought Process)、如何将模型输出的 JSON 实时映射到复杂的组件树中时,你就已经超越了“画页面”的范畴,进入了 AI 产品经理兼高级前端的领域。
不要试图去和后端拼 Python 模型微调的技术深度,那是他们的赛道。你的赛道是交互层的确定性——在模型不确定的世界里,提供确定的交互反馈。
AI 应用交互模式:流式输出的陷阱
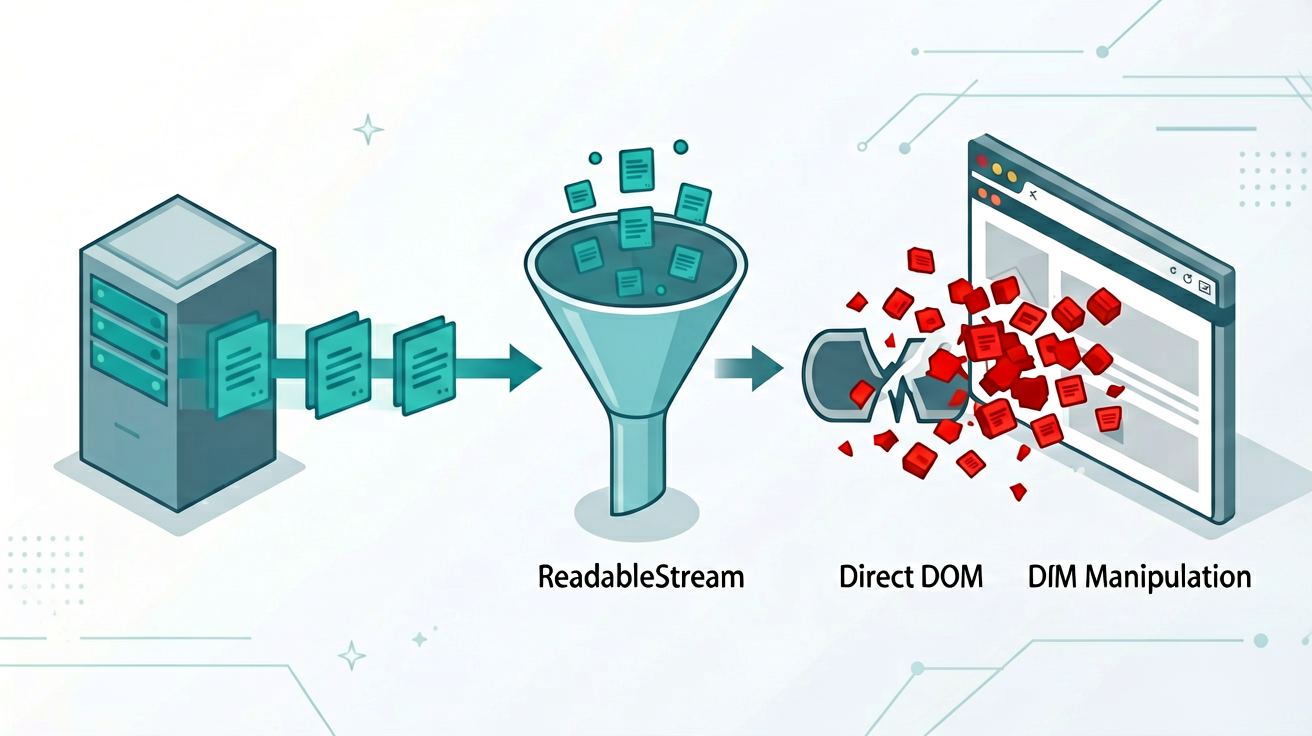
既然提到了流式输出(Streaming),我们就得聊聊这里最常见的坑。
很多初学者会用 fetch 或简单的 axios 去请求 SSE (Server-Sent Events) 接口,然后直接在渲染层拼接字符串。这在 Demo 里没问题,但在生产环境中,你会面临两个问题:
1. 状态丢失:如果网络抖动,用户刷新页面,之前的对话历史如果没持久化好,体验直接归零。
2. 渲染性能:Token 以 20ms 的频率涌入 DOM,如果没有虚拟列表或增量更新策略,浏览器会卡顿。
我推荐的学习路径是从 React Server Components (RSC)或Suspense 的角度去理解流式。即使你不使用 React,也要理解流式响应不是一次性的数据传输,而是一个持续的连接状态。
这里有一个我在实际项目中使用的简单思路,利用 ReadableStream 处理分片数据,避免内存溢出:
// 伪代码示例:处理流式响应的安全方式
async function processStream(response) {
  const reader = response.body.getReader();
  const decoder = new TextDecoder();

  let buffer = '';

  while (true) {
    const { done, value } = await reader.read();
    if (done) break;

    const chunk = decoder.decode(value, { stream: true });
    buffer += chunk;

    // 关键:按行分割,因为 LLM 通常是 SSE 格式,每行以 \n\n 结尾
    const lines = buffer.split('\n\n');
    // 保留最后一个可能不完整的片段
    buffer = lines.pop() || '';

    for (const line of lines) {
      if (line.startsWith('data: ')) {
        try {
          const json = JSON.parse(line.slice(6));
          if (json.content) {
            // 触发 UI 更新,注意防抖或节流
            updateUI(json.content);
          }
        } catch (e) {
          console.warn('Parse error', e);
        }
      }
    }
  }
}
这段代码看似简单,但它强调了缓冲和解析容错,这是后端直出 JSON 不需要考虑,但前端必须面对的脏活累活。
多模态体验:不仅是图片
现在的大模型应用很少只输出纯文本了。PDF 解析、图片上传、甚至语音转文字,这些都属于多模态。
前端在这里的角色至关重要。比如用户上传一张截图,前端不仅要处理文件压缩,还要决定何时将图片传给后端进行 OCR 或视觉模型分析,以及如何在 UI 上展示“正在识别...”的状态。
我的建议是:把多模态当成一种特殊的“富文本编辑器”来做。
你需要设计一套统一的数据结构,无论是文本、图片还是代码块,都抽象为统一的 ContentNode。这样无论底层模型返回什么,前端渲染层都能通过一个通用的组件树进行映射。这种抽象能力,是区分初级和高级 AI 前端工程师的分水岭。
工程化深水区:权限、日志与可观测
回到我最开始提到的那个“踩坑”场景。
当你的应用从内部工具走向对外服务时,单纯的功能可用已经不够了。面试官或技术负责人会问:
- 用户 A 能不能看到用户 B 的对话记录?(权限隔离)
- 模型幻觉导致用户做出了错误决策,怎么追责?(Prompt 版本管理与日志)
- 接口延迟高达 5 秒,是模型慢还是网络慢?(可观测性)
这是前端转型大模型最需要补齐的工程素养。
1. 权限隔离:在前端路由和 API 请求拦截器层面,就要嵌入 tenantid 或 userrole。不要指望后端完全兜底,前端的二次校验是用户体验的第一道防线。
2. 日志埋点:你需要记录每一次调用的 request_id,并将其串联到后续的每一次 Token 推送中。这样当用户报错时,你能通过 request_id 在后端查到具体的 Prompt 和 Context。
3. 可观测性:集成 OpenTelemetry 或类似方案,追踪前端发起请求到收到第一个 Token 的时间(TTFB),这对优化用户体验至关重要。
这部分内容在传统的 MVC 教程里很少讲,但在 AI 应用架构中,它是基石。
作品集方向:如何展示你的能力
如果你想在简历上体现转型成果,不要只放一个“聊天机器人”的截图。那太单薄了。
我建议做以下两个方向的项目之一:
1. 垂直领域的智能助手:比如“法律条文检索助手”。重点展示你如何处理长上下文(Context Window Management),如何做 RAG(检索增强生成)的前端缓存策略,以及如何通过 UI 展示引用来源(Citations)。
2. 可视化 Agent 工作流:做一个拖拽式的 Agent 编排工具的前端部分。展示你如何处理复杂的节点状态管理、连线逻辑以及并发请求。
关键点:在项目介绍中,专门开辟一个章节讲“工程化实践”,列出你如何处理并发、如何设计日志系统、如何保证权限安全。这会让 HR 和技术主管眼前一亮,因为他们知道,写个 Chat 界面的人很多,能把 AI 应用做成稳定产品的人很少。
总结
前端转大模型,不是换一门语言那么简单,而是思维模式的升级。
从“页面渲染者”转变为“AI 交互架构师”。你需要拥抱不确定性,用确定性的工程手段去约束模型的非确定性输出。
这次从 Demo 到生产环境的踩坑经历让我明白:真正的竞争力,不在于你调用了哪个最新奇的模型,而在于你是否构建了支撑模型稳定服务于业务的工程底座。
这条路不容易,但方向是对的。别急着追热点,先把手头的流式交互和权限日志做好,你会发现,很多后端同学搞不定的体验难题,恰恰是你的主场。
资料展示
下面是我整理的AI大模型学习资料和工具包预览,适合收藏后按主题逐步学习。
如果你想看完整资料目录,可以在评论区留言「资料」;也欢迎告诉我你更关注AI大模型里的哪类内容。
更多推荐

 5
 0
- 0


 已为社区贡献135条内容

所有评论(0)