登录社区云,与社区用户共同成长
邀请您加入社区
第1章。
很多手账爱好者习惯在实体纸质手账本上用钢笔随手记下当天的待办清单或情绪碎碎念,随后希望**“拍照一键转录为数字格式并自动同步到 Web 清单中”**。随着 WebAssembly 与端侧轻量化深度学习的发展,已经完全具备了在手机浏览器中秒级识别中文手写体的能力。今天我对四款可在前端 WASM 或本地 Node 环境下直接运行的轻量 OCR 引擎进行了实测。
在人工智能、大模型与云原生技术爆发式增长的今天,GitHub 上每天都会冒出成百上千个宣称“颠覆行业、颠覆上一代框架”的开源项目。
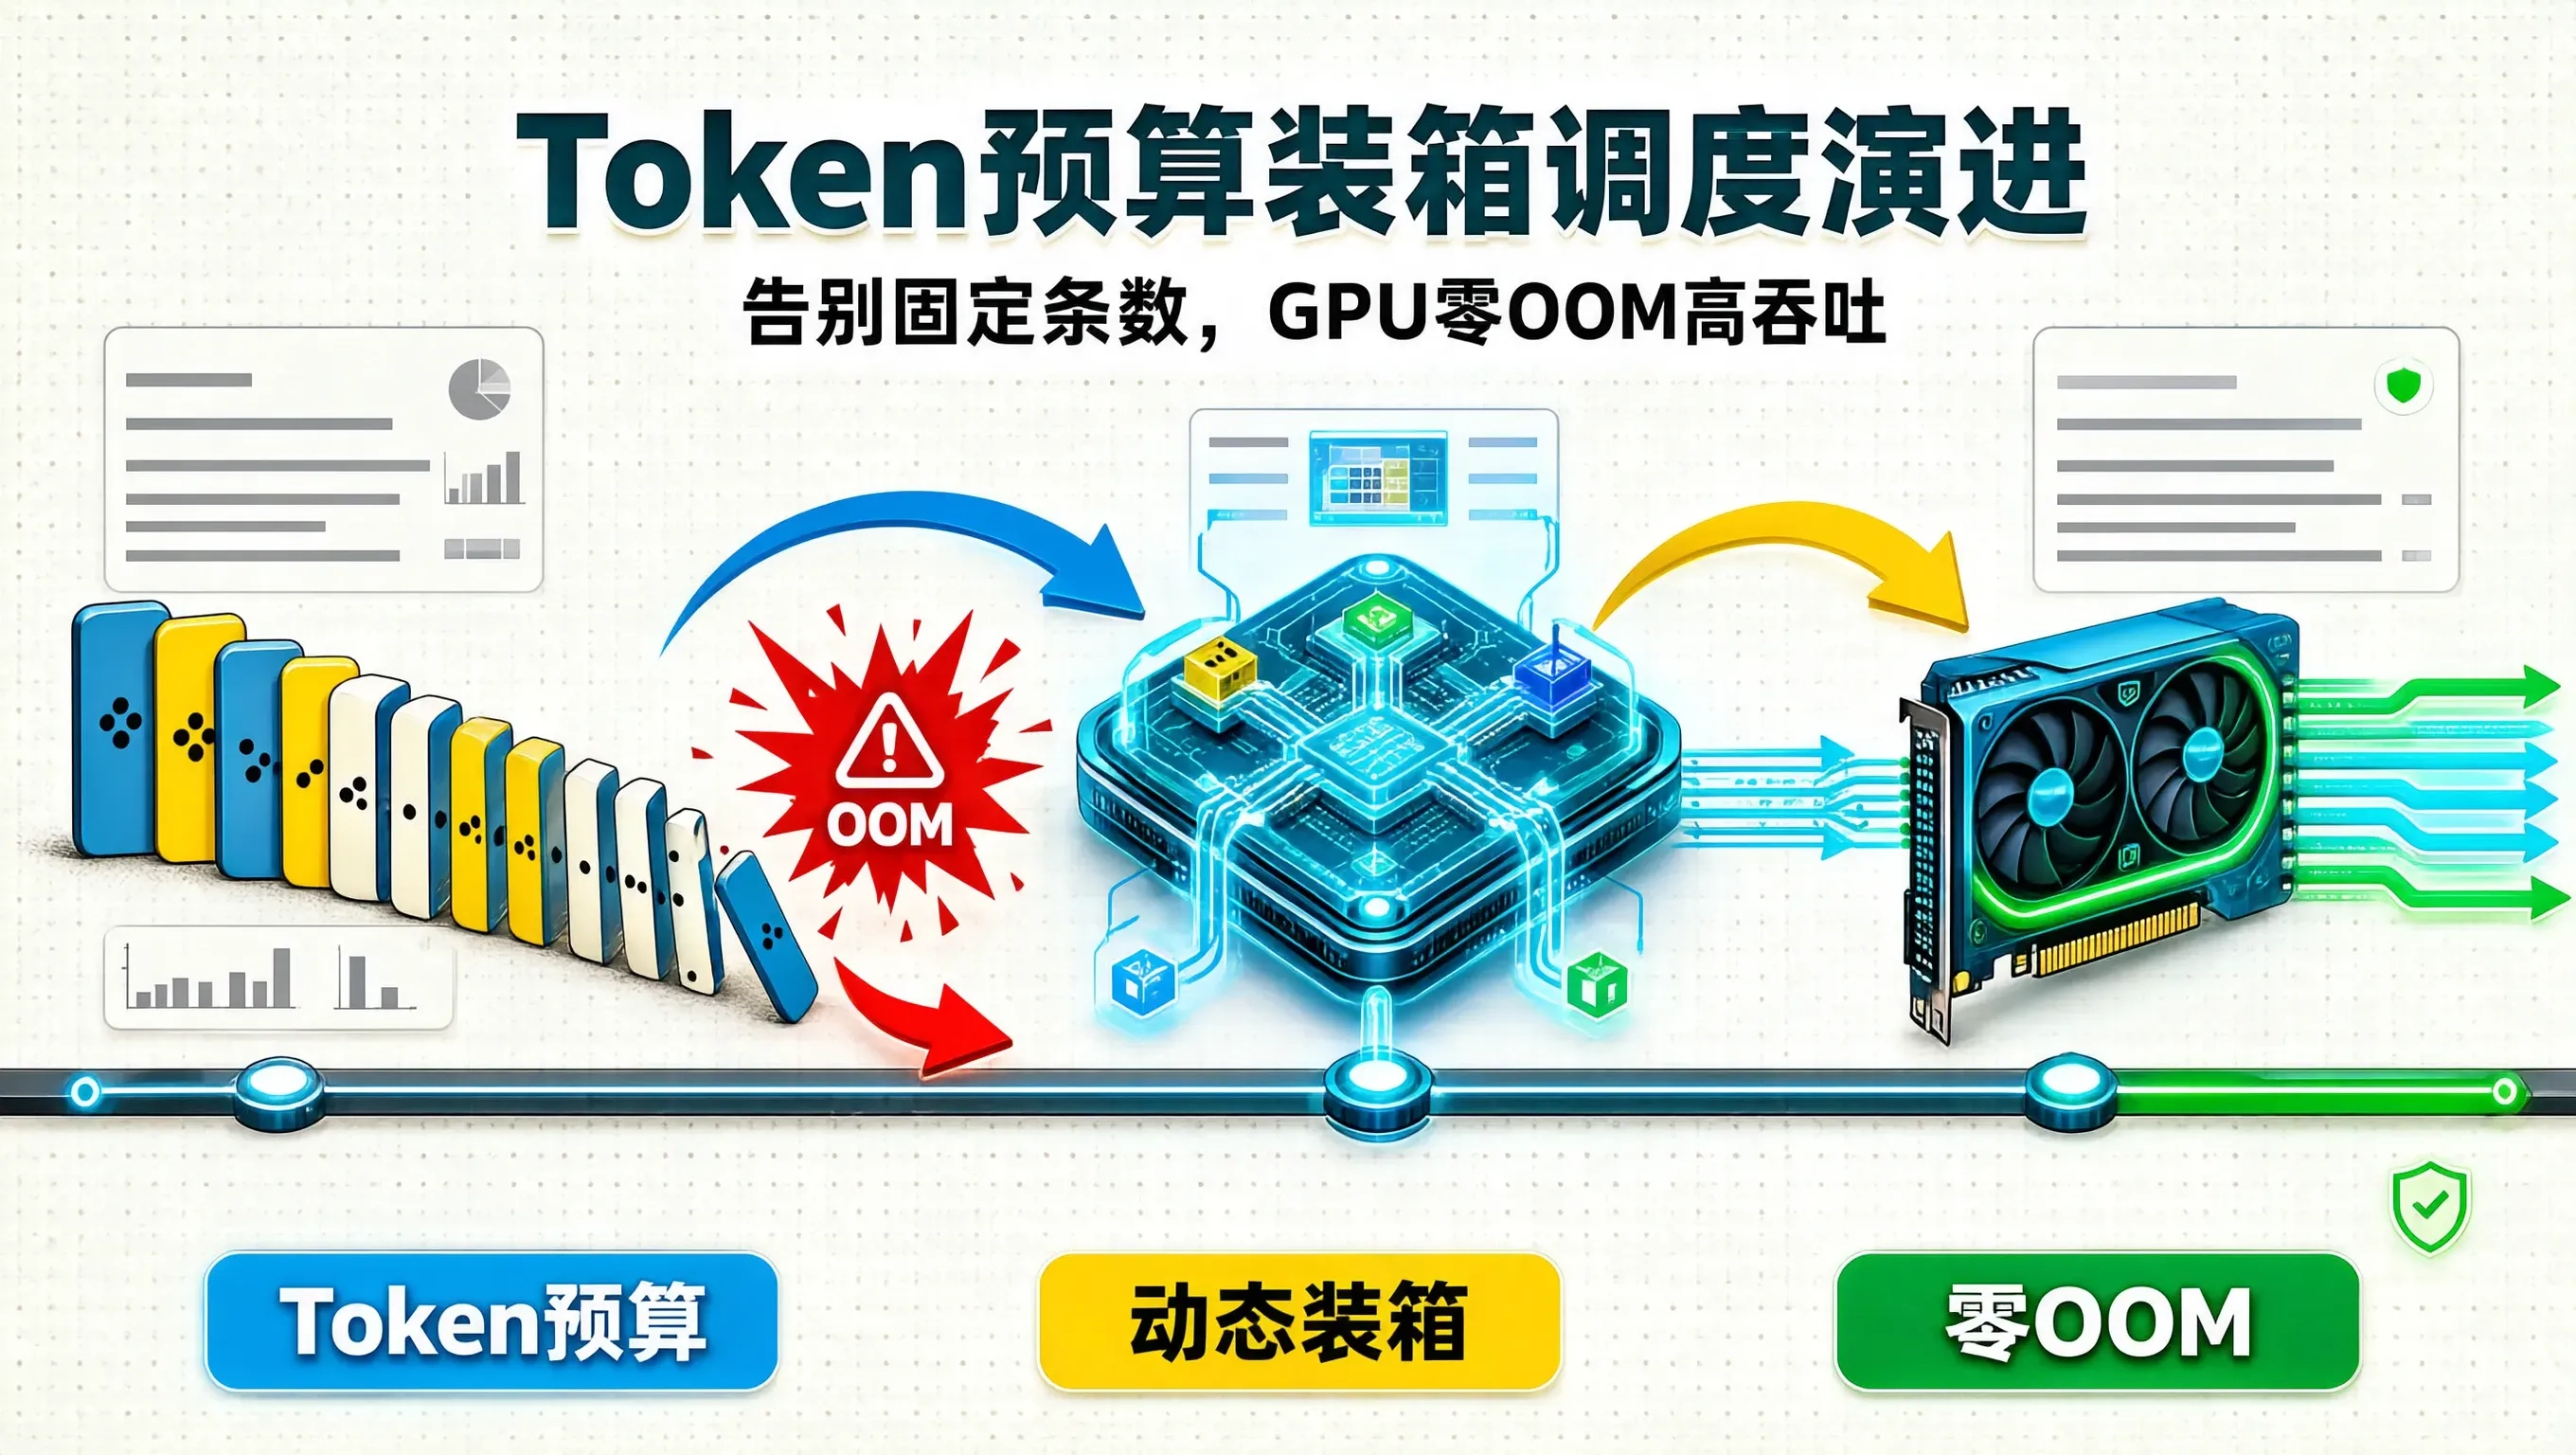
深度学习系统的并发调度,必须深入算力与显存的物理本质。“彻底抛弃固定条数的粗放思维,以 Token 动态预算为装箱标尺,在保证显存绝对安全的前提下将 GPU 矩阵算力压榨至理论巅峰”,是保障大模型批处理服务在复杂异构长短文本冲击下实现零 OOM、高吞吐稳定交付的标准工业级范式。
1.引言1.1 课题背景与意义水稻作为全球主要粮食作物之一,其生长过程中易受多种病害威胁,如稻瘟病、纹枯病等。传统病害检测依赖农业专家人工观察,存在效率低、成本高且主观性强的问题。尤其在小规模种植区域,农户难以及时获取专业指导,常因误判病情导致减产。近年来,计算机视觉技术的发展为农业病害识别提供了新思路,但现有解决方案多集中在云端服务或移动端应用,对网络环境和设备性能要求较高,难以在偏远农村地区普
综合前面的分析可知,“依托GIS的动态路线改良法”不是一种孤立的成本缩减工具,而是助力大庆昌盛中通速递达成经营和运作全方位升级的战略支撑点,该方法期望达到的效果具有多层级,系统性并且影响重大等特点。从直接经济角度而言,此策略着眼于成本结构里占比最高且多余状况最为突出的运输环节,经由对里程和资源实施科学设置,打算达成每年运输成本削减15 - 22万元的效果,进而直接优化网点净利润率1 - 1. 5个
煤炭行业是我国能源产业极为重要的一部分,这个行业一直把安全生产当作最核心的发展诉求,供电系统就像是煤矿生产的“动力心脏”,负责给矿井变电站,主要通风机,井下排水泵以及提升机这些关键设备供电。该系统的设备一旦出现运行异常情况,就很可能造成生产停止,设备损坏,还可能会产生安全事故,所以,国家矿山安全监察局和财政部共同出台的《煤矿及重点非煤矿山重大灾害风险防控创建工程总体方案》专门提出,要给重点煤矿里的
现有的Agent技能自进化方法在迭代更新时,往往因为缺乏对历史经验的积累和对修改幅度的控制,导致优化过程不稳定且效率低下,如何像深度学习中的梯度下降一样稳定、高效地自动优化离散的技能文档?论文提出了SKILLADAM框架,借鉴Adam优化器的思想,通过引入“优化记忆”和“波动驱动的编辑预算”,实现了更稳定、更少迭代次数且更低成本的Agent技能自进化
存货是企业资产的重要形成局部,其经营效率会左右企业的资金周转效率以及经营安全界限,在房地产行业深入调整的大背景下,存货投资调整成了影响企业业绩的关键要素,近年来,房地产定位定调“房住不炒”毫不动摇,而且融资监管政策不断加强约束,房地产行业正在发生从规模扩充迈向品质效益的实质性变革。国家统计局的数据表示,从2022年开始,房地产存货规模已连续四年呈下降态势,2025年上半年,样本房企已竣工存货(即现
第一次接触 AI 开发,最容易被一串名词绕晕:人工智能、机器学习、深度学习、神经网络、大模型、LLM、生成式 AI、RAG、Agent,看起来都像“AI”,却并不处在同一层级。本文从“目标—方法—模型—能力—系统”五个层次重新梳理它们的关系,用一张总览图、多个对比表和可运行的 Python 示例,讲清传统机器学习如何从数据中学习,深度学习为何依赖神经网络,大模型与 LLM 到底是什么关系,以及今天
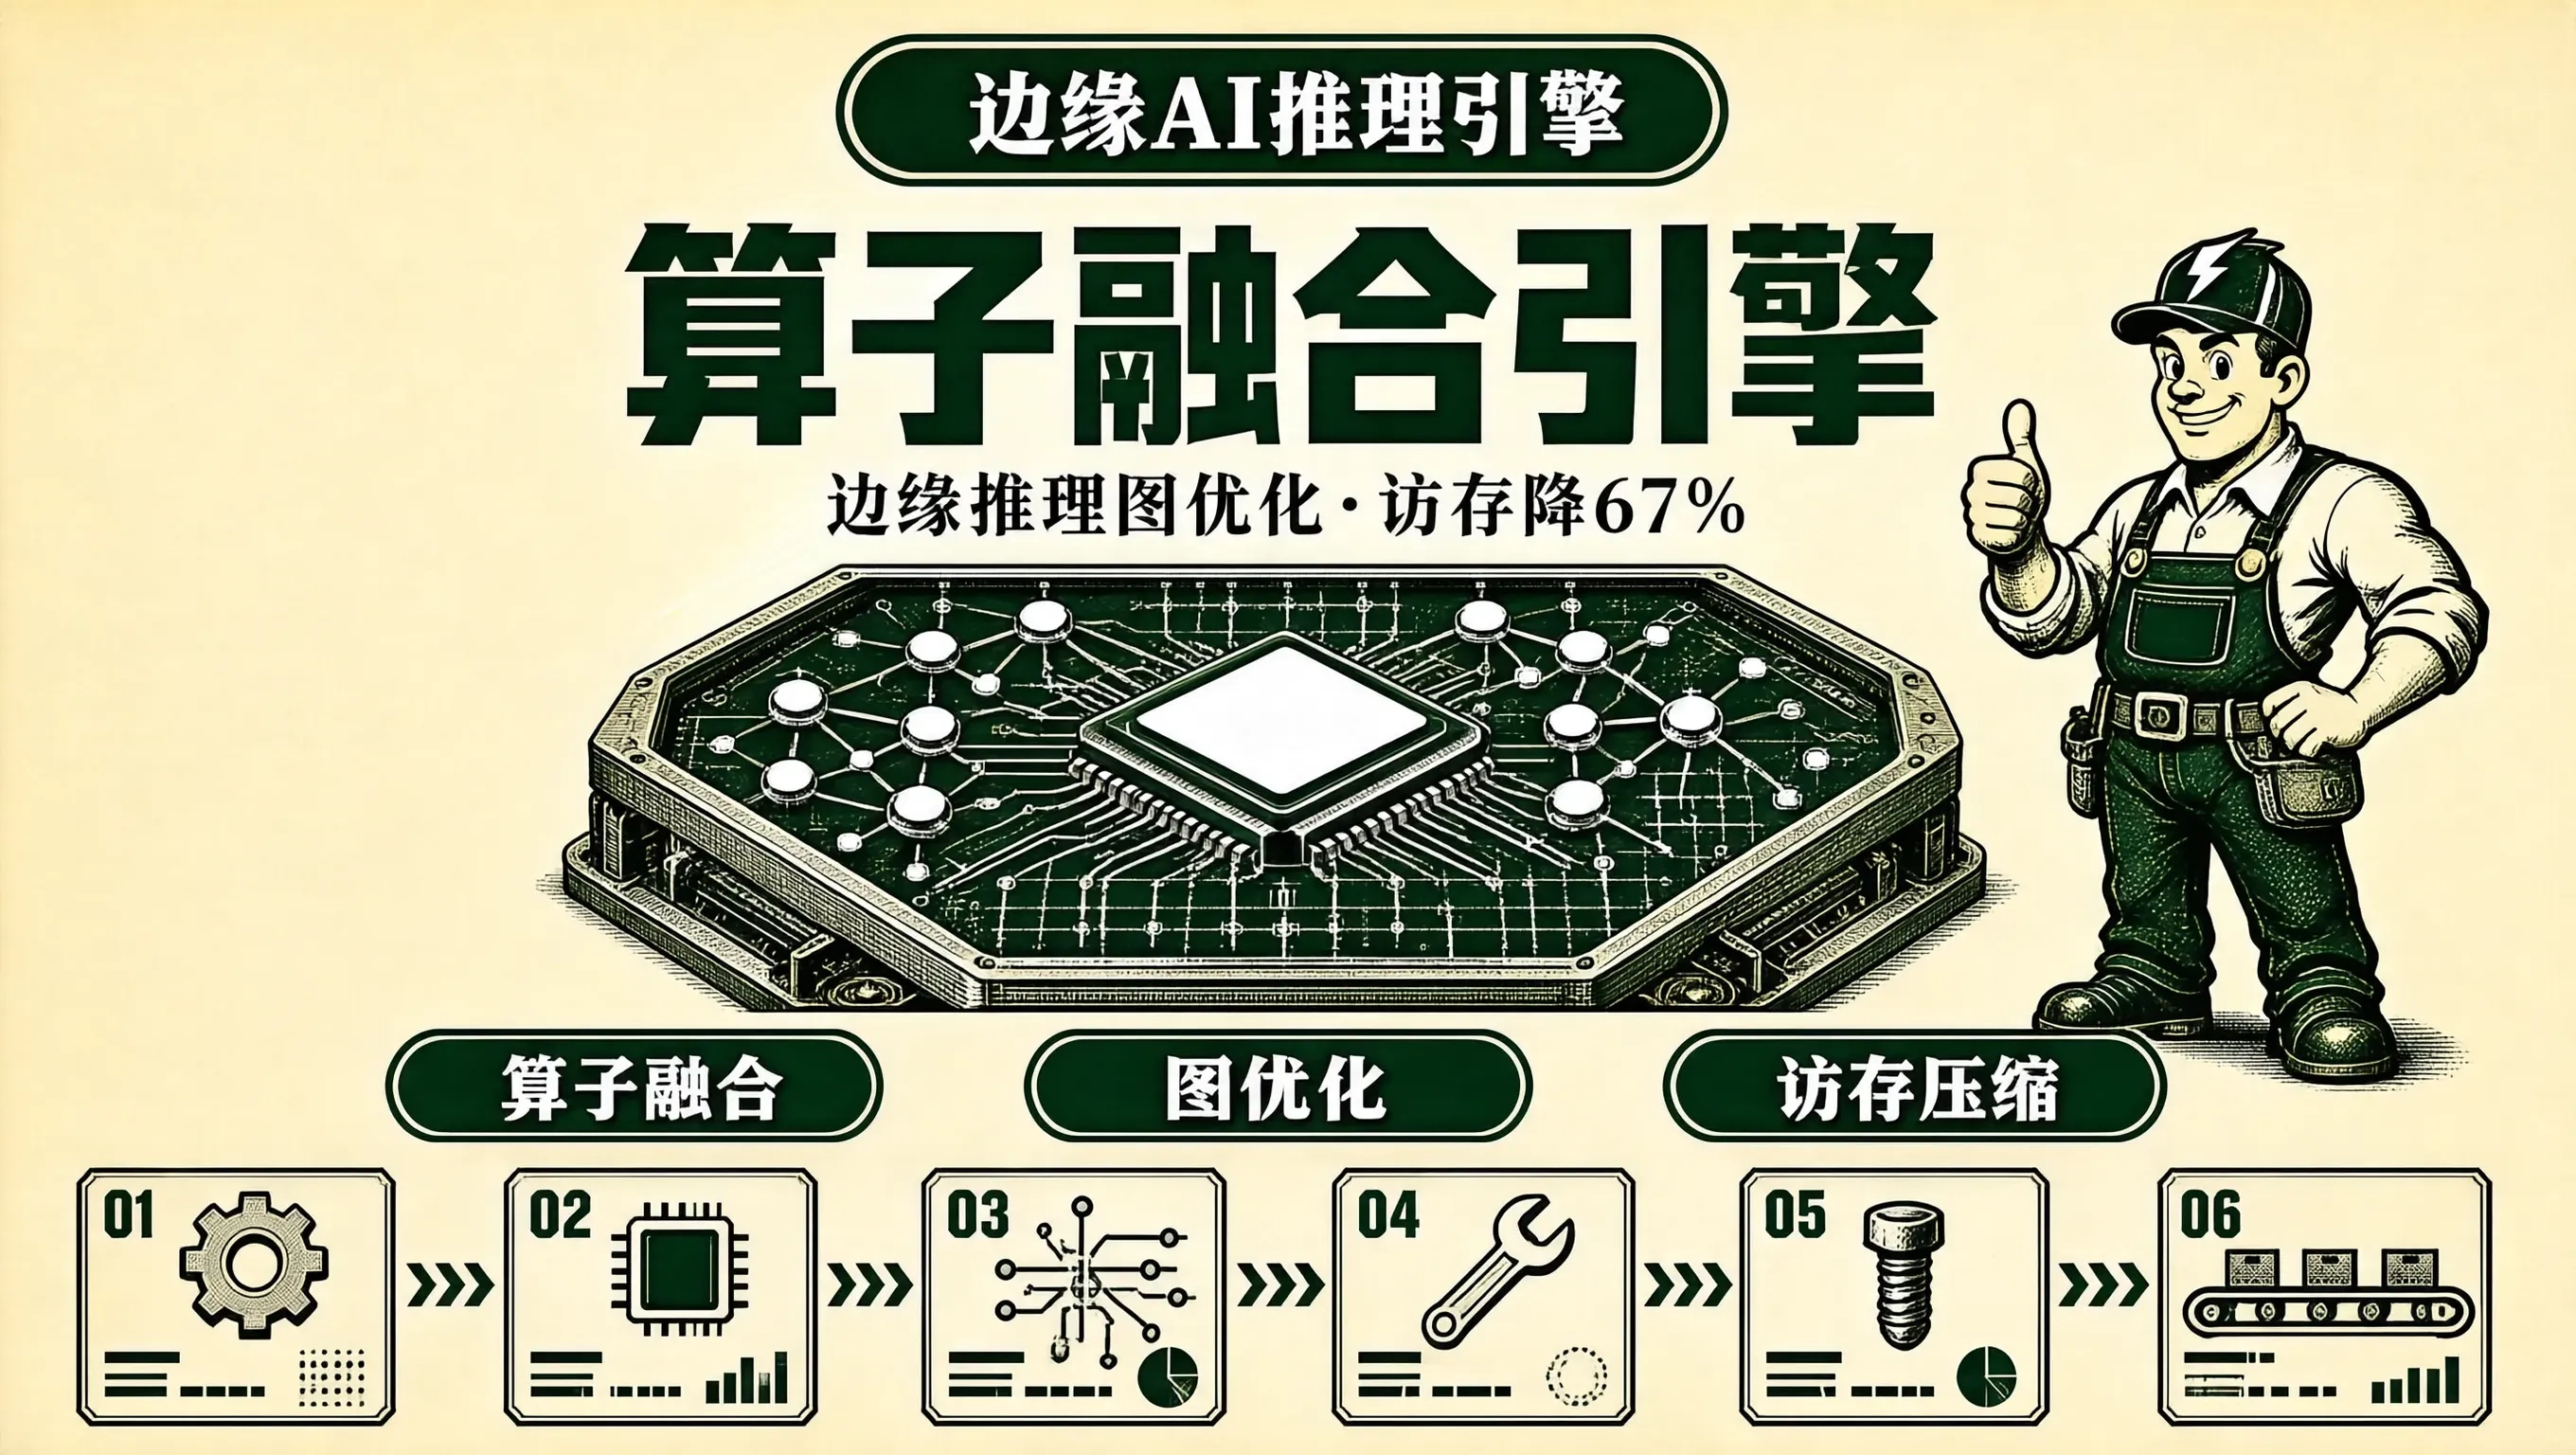
在边缘端神经网络推理引擎(如 TFLite、NCNN、MNN、ONNX Runtime)的计算图编译与优化流水线中,是消除内存搬运瓶颈、提升前向计算速度最核心的离线图优化技术(Graph Optimization)。一个未经优化的原始深度学习模型(如 YOLOv8、ResNet),在结构上充斥着大量密集的**“微算子链条”**。。
人工智能(Artificial Intelligence, AI)的本质是对人类智能的模拟。它不是单一的计算机学科,而是涉及统计学、脑神经科学、社会科学等多领域的交叉学科。简单来说,就是让机器变得“聪明”,能够完成原本只有人类才能做到的任务。大语言模型(Large Language Model, LLM)是人工智能领域的核心突破。它是一种通过海量文本训练而成、拥有巨量参数、能够理解和生成人类语言的
强化学习(RL)研究智能体在与环境交互中通过奖励信号学习最优策略。其框架是马尔可夫决策过程(MDP):智能体在状态sss采取动作aaa,环境返回奖励rrr和新状态s′s's′,智能体学习策略πa∣sπa∣s以最大化累积奖励。虽然预训练主要用自监督学习,但对齐阶段(RLHF,第13章)会用到强化学习:把语言模型视为策略,把人类偏好转化为奖励,用策略梯度方法优化模型。因此,理解强化学习的基本概念对第四
在移动端部署深度学习模型时,ONNX Runtime (ORT) 的最大优势之一是其模块化的执行提供者(Execution Provider, EP)架构。开发者可以通过切换 EP,将计算图调度到 CPU、GPU 或专用 NPU/DSP 上执行。然而在真实的商业级手游项目中,“越接近硬件加速越好”往往是一个美好的幻觉。盲目在 Android 端开启 NNAPI,可能会在高通、联发科或三星芯片上遭遇
在工业物联网(IIoT)边缘网关与远程数据采集系统中,是使用最广泛的轻量级发布/订阅消息总线。MQTT 协议通过设计三种不同的PUBACKPUBLISHPUBRECPUBRELPUBCOMP很多缺乏现场网络排障经验的开发者在设计协议时,常常为了所谓的“绝对安全”,盲目将全网所有的传感器高频遥测报文(每秒数百条)统一配置为。然而,当工业网关被部署到野外 4G/NB-IoT 蜂窝网络中(遭遇)时,Qo
本文提供一套可复现的GPU服务器网络与存储测速流程,帮助开发者在深度学习任务前验证带宽、稳定性、断点续传与数据完整性。通过固定测试文件、连续采样、分层检测DNS、首字节、传输与落盘性能,并结合curl、dd、sha256sum等基础工具,精准定位瓶颈,避免因网络或存储问题导致GPU空转。强调应以持续性能而非瞬时峰值选型算力平台,确保训练高效启动。
本文围绕智能学术搜索相关的学术工具应用,介绍四款可显著提升论文写作效率的工具:依托人工智能技术、具备对话式梳理功能、适用于文献检索梳理的切问学术;可检查优化英语写作语法与风格的Grammarly;适合长文写作、便于组织论文结构的Scrivener;能够简化复杂表达、提升论文可读性的Hemingway Editor。这些工具覆盖论文写作全环节,可帮助研究生高效完成高质量学术写作。
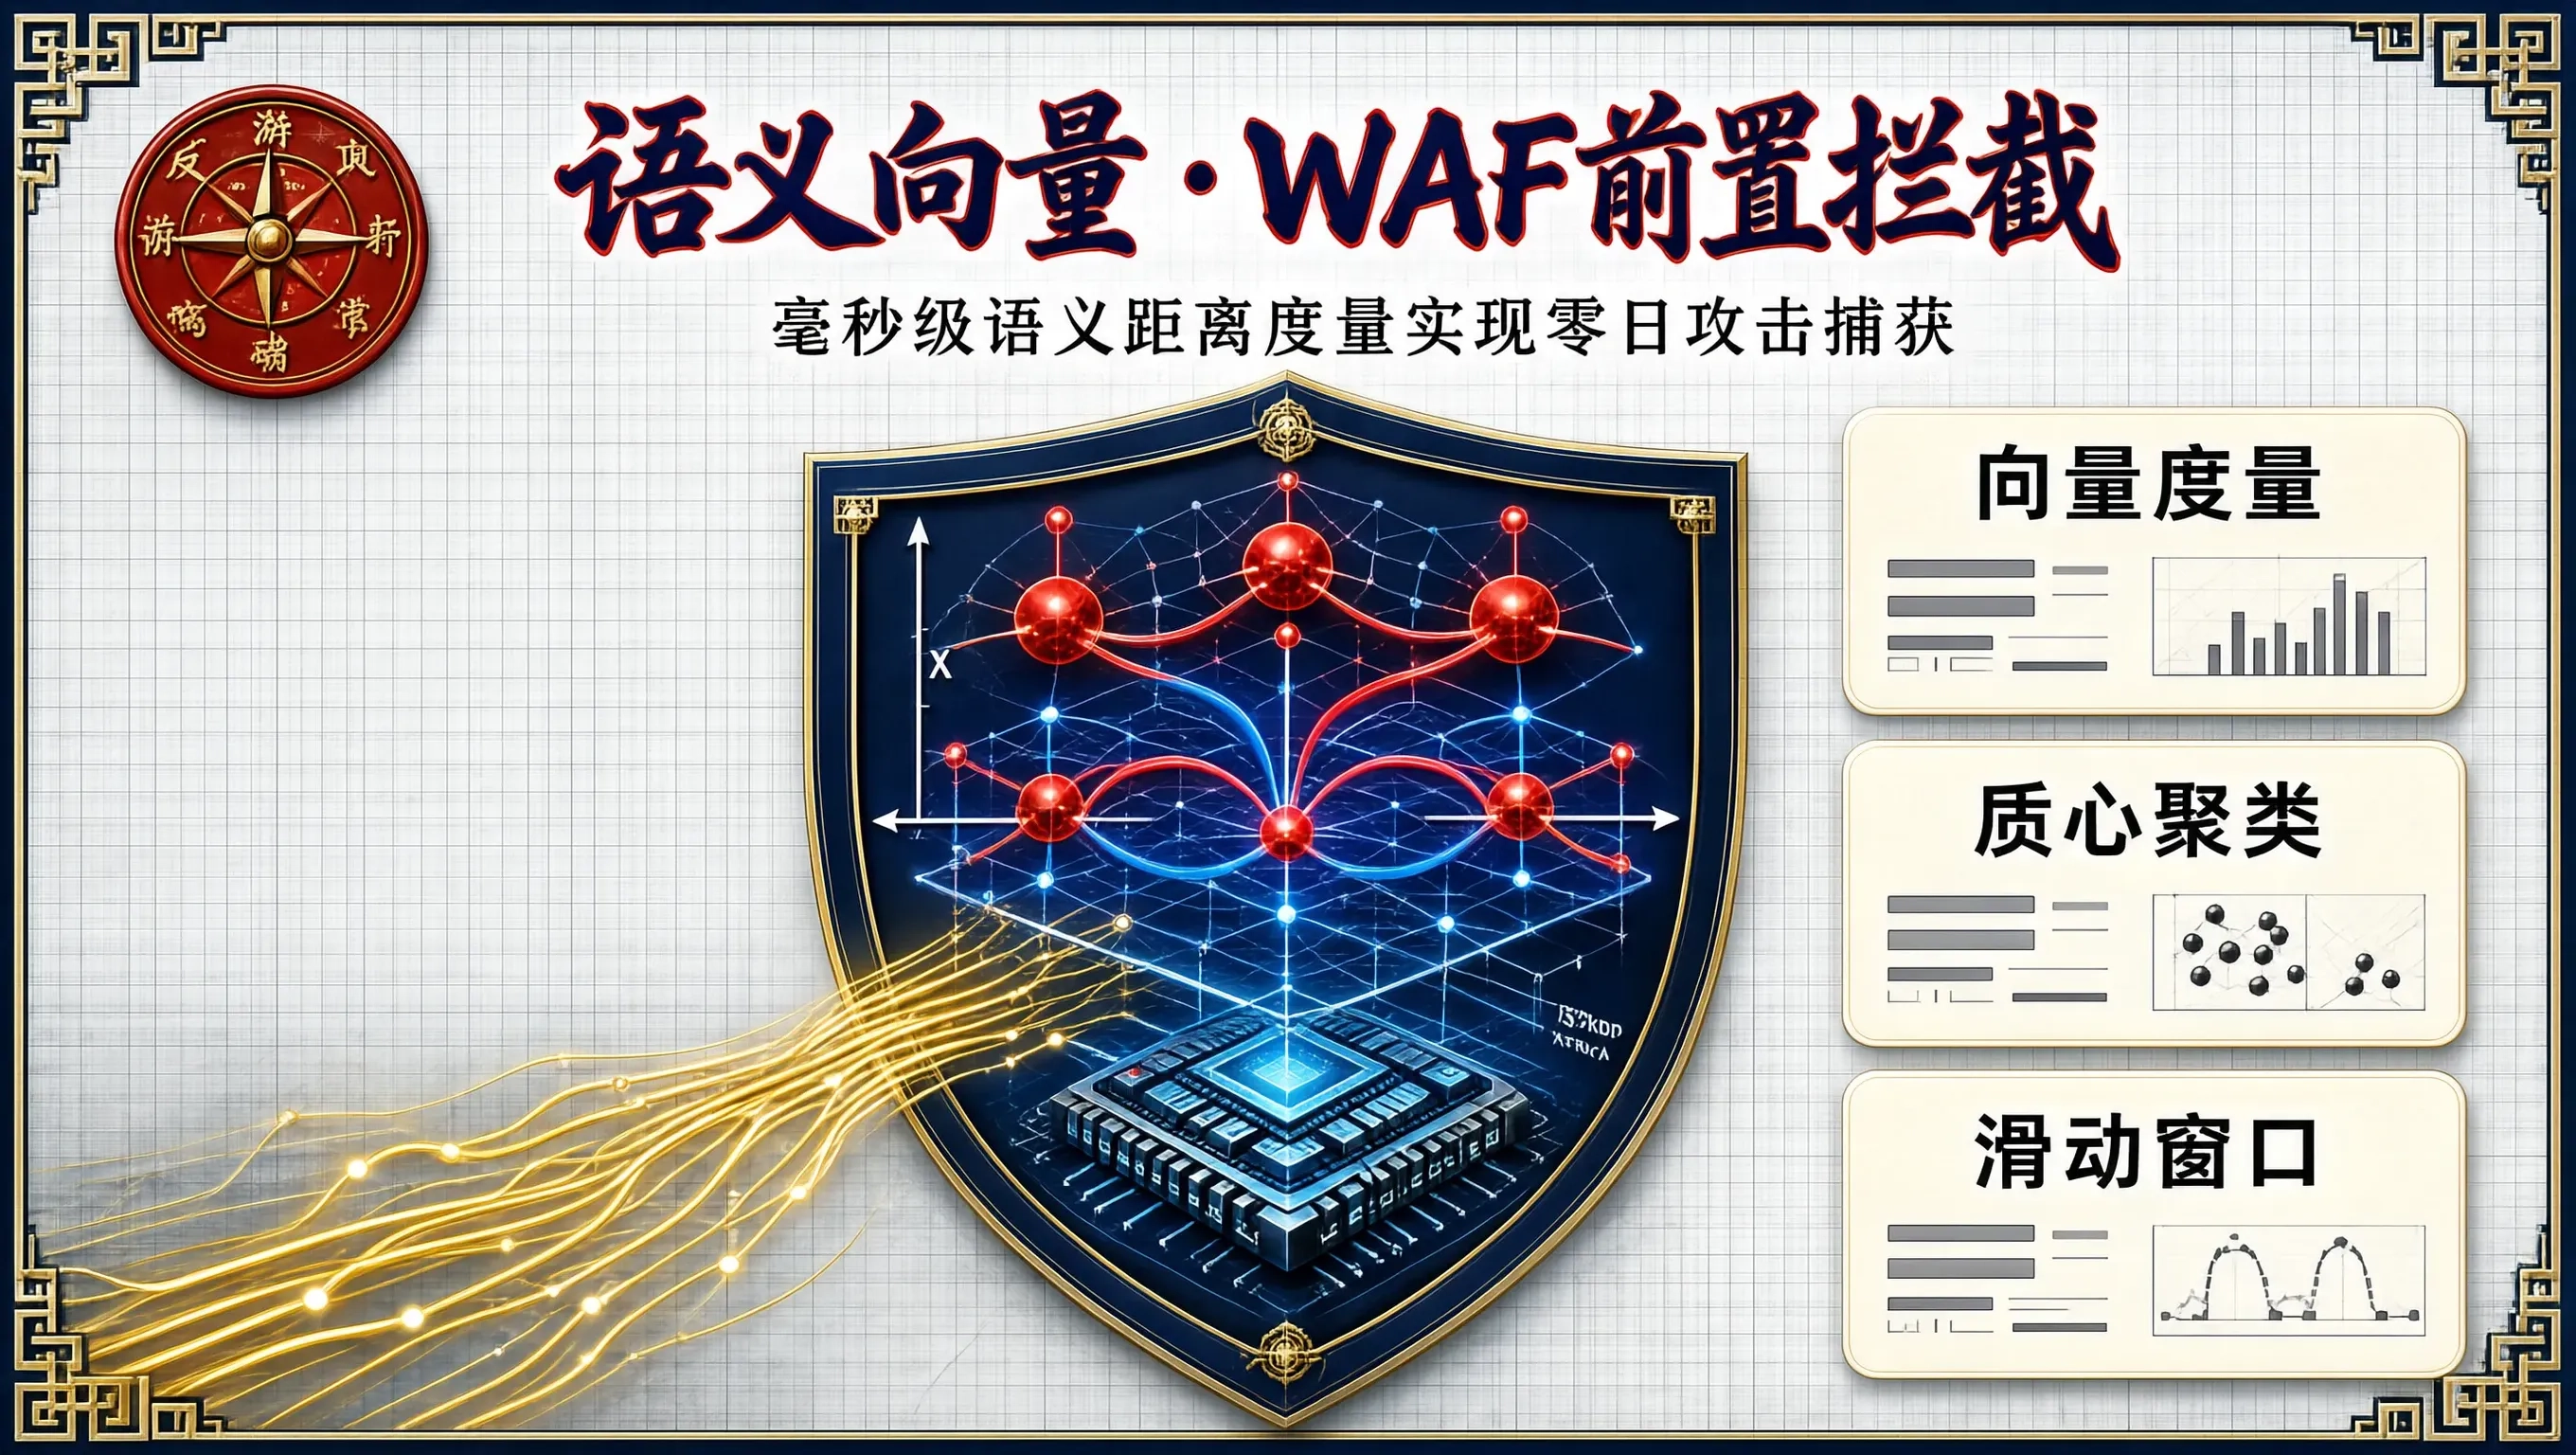
在传统 Web 应用防火墙(WAF)的架构演进中,规则引擎长期处于两难困境:正则表达式黑名单极易被花样繁多的混淆编码与多层包装绕过(如多重 URL 编码、注释插入、大小写交错),而将每一个高并发 HTTP 请求都送入大型深度学习模型或 LLM 又会带来数十毫秒乃至数百毫秒的灾难性延迟。为了在“超低延迟响应”与“深层泛化识别”之间取得最佳工程平衡,成为了现代智能 WAF 的关键演进方向。
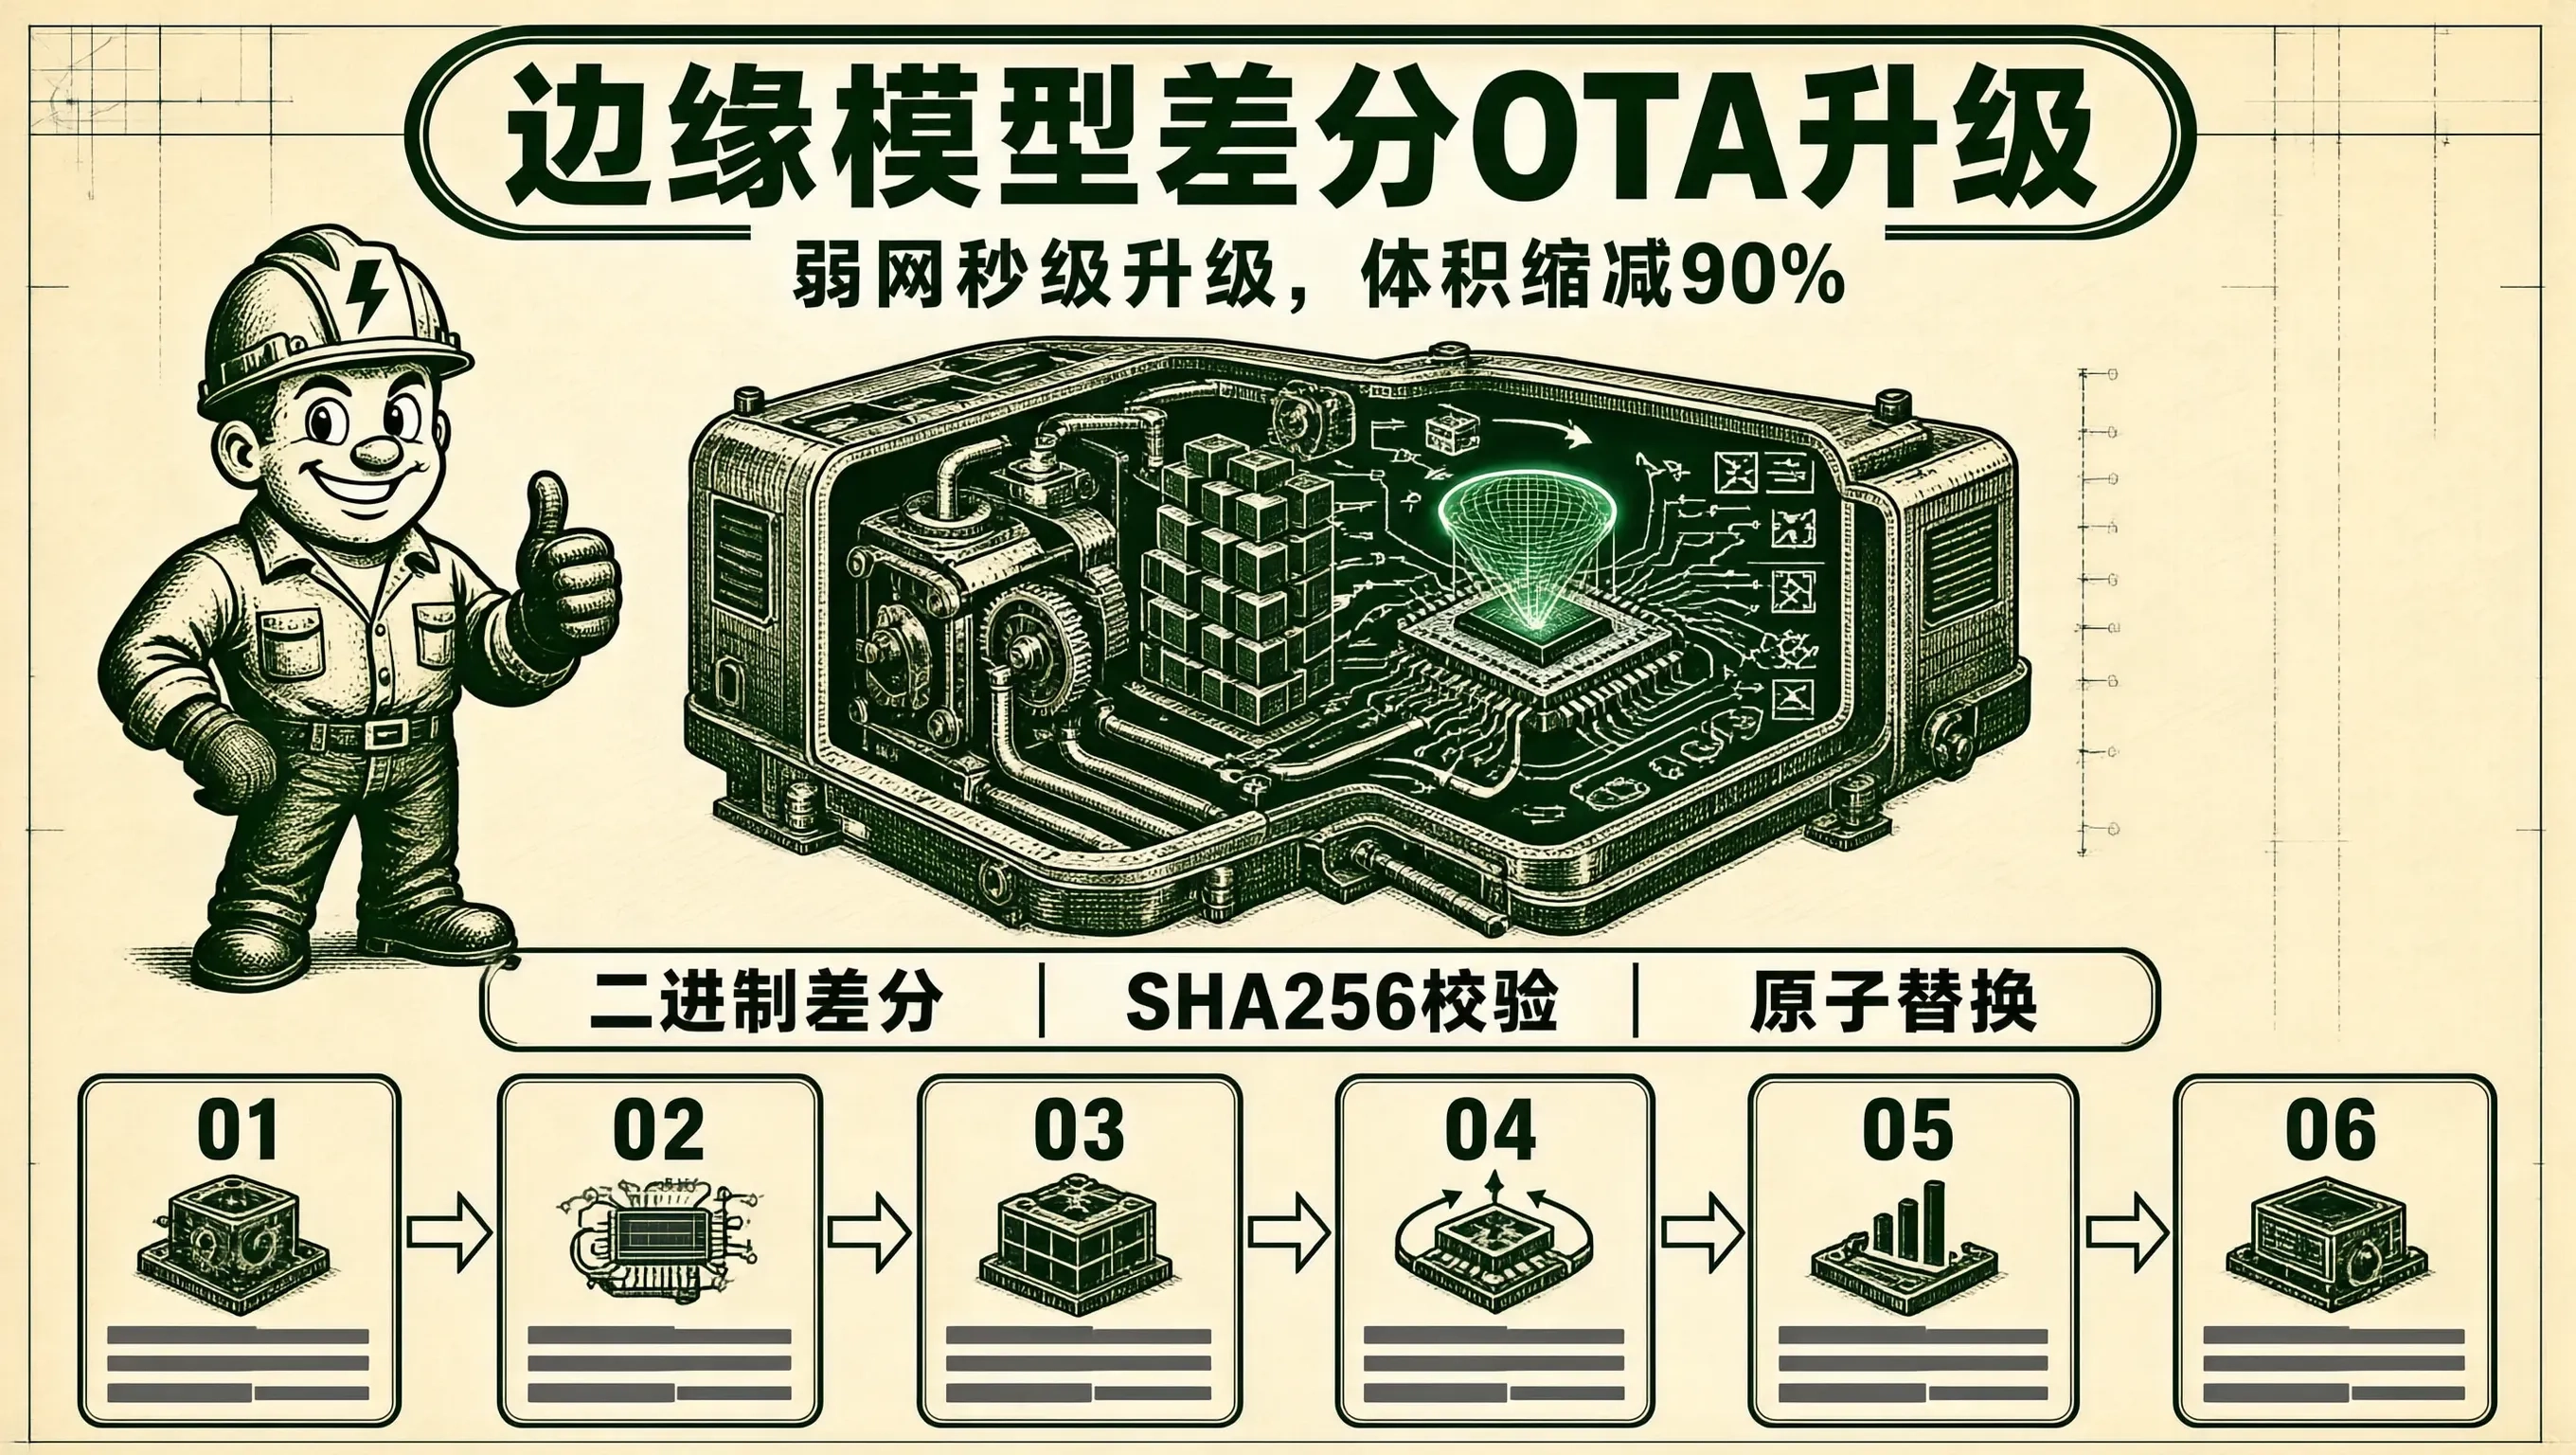
在智能物联网(IoT)与边缘计算设备的规模化落地中,随着业务场景的持续演进与工业缺陷数据的回流,深度学习模型算法需要以极高的频率进行在线迭代。然而,在野外光伏电站、远洋船舶或地下管廊等工业场景中,设备通常通过 4G/NB-IoT 等窄带无线蜂窝网络连接云端,网络信号微弱且流量资费昂贵。如果每次模型升级都通过 OTA(Over-The-Air)下发一个数十兆乃至几百兆的全量模型权重文件,不仅耗费巨额
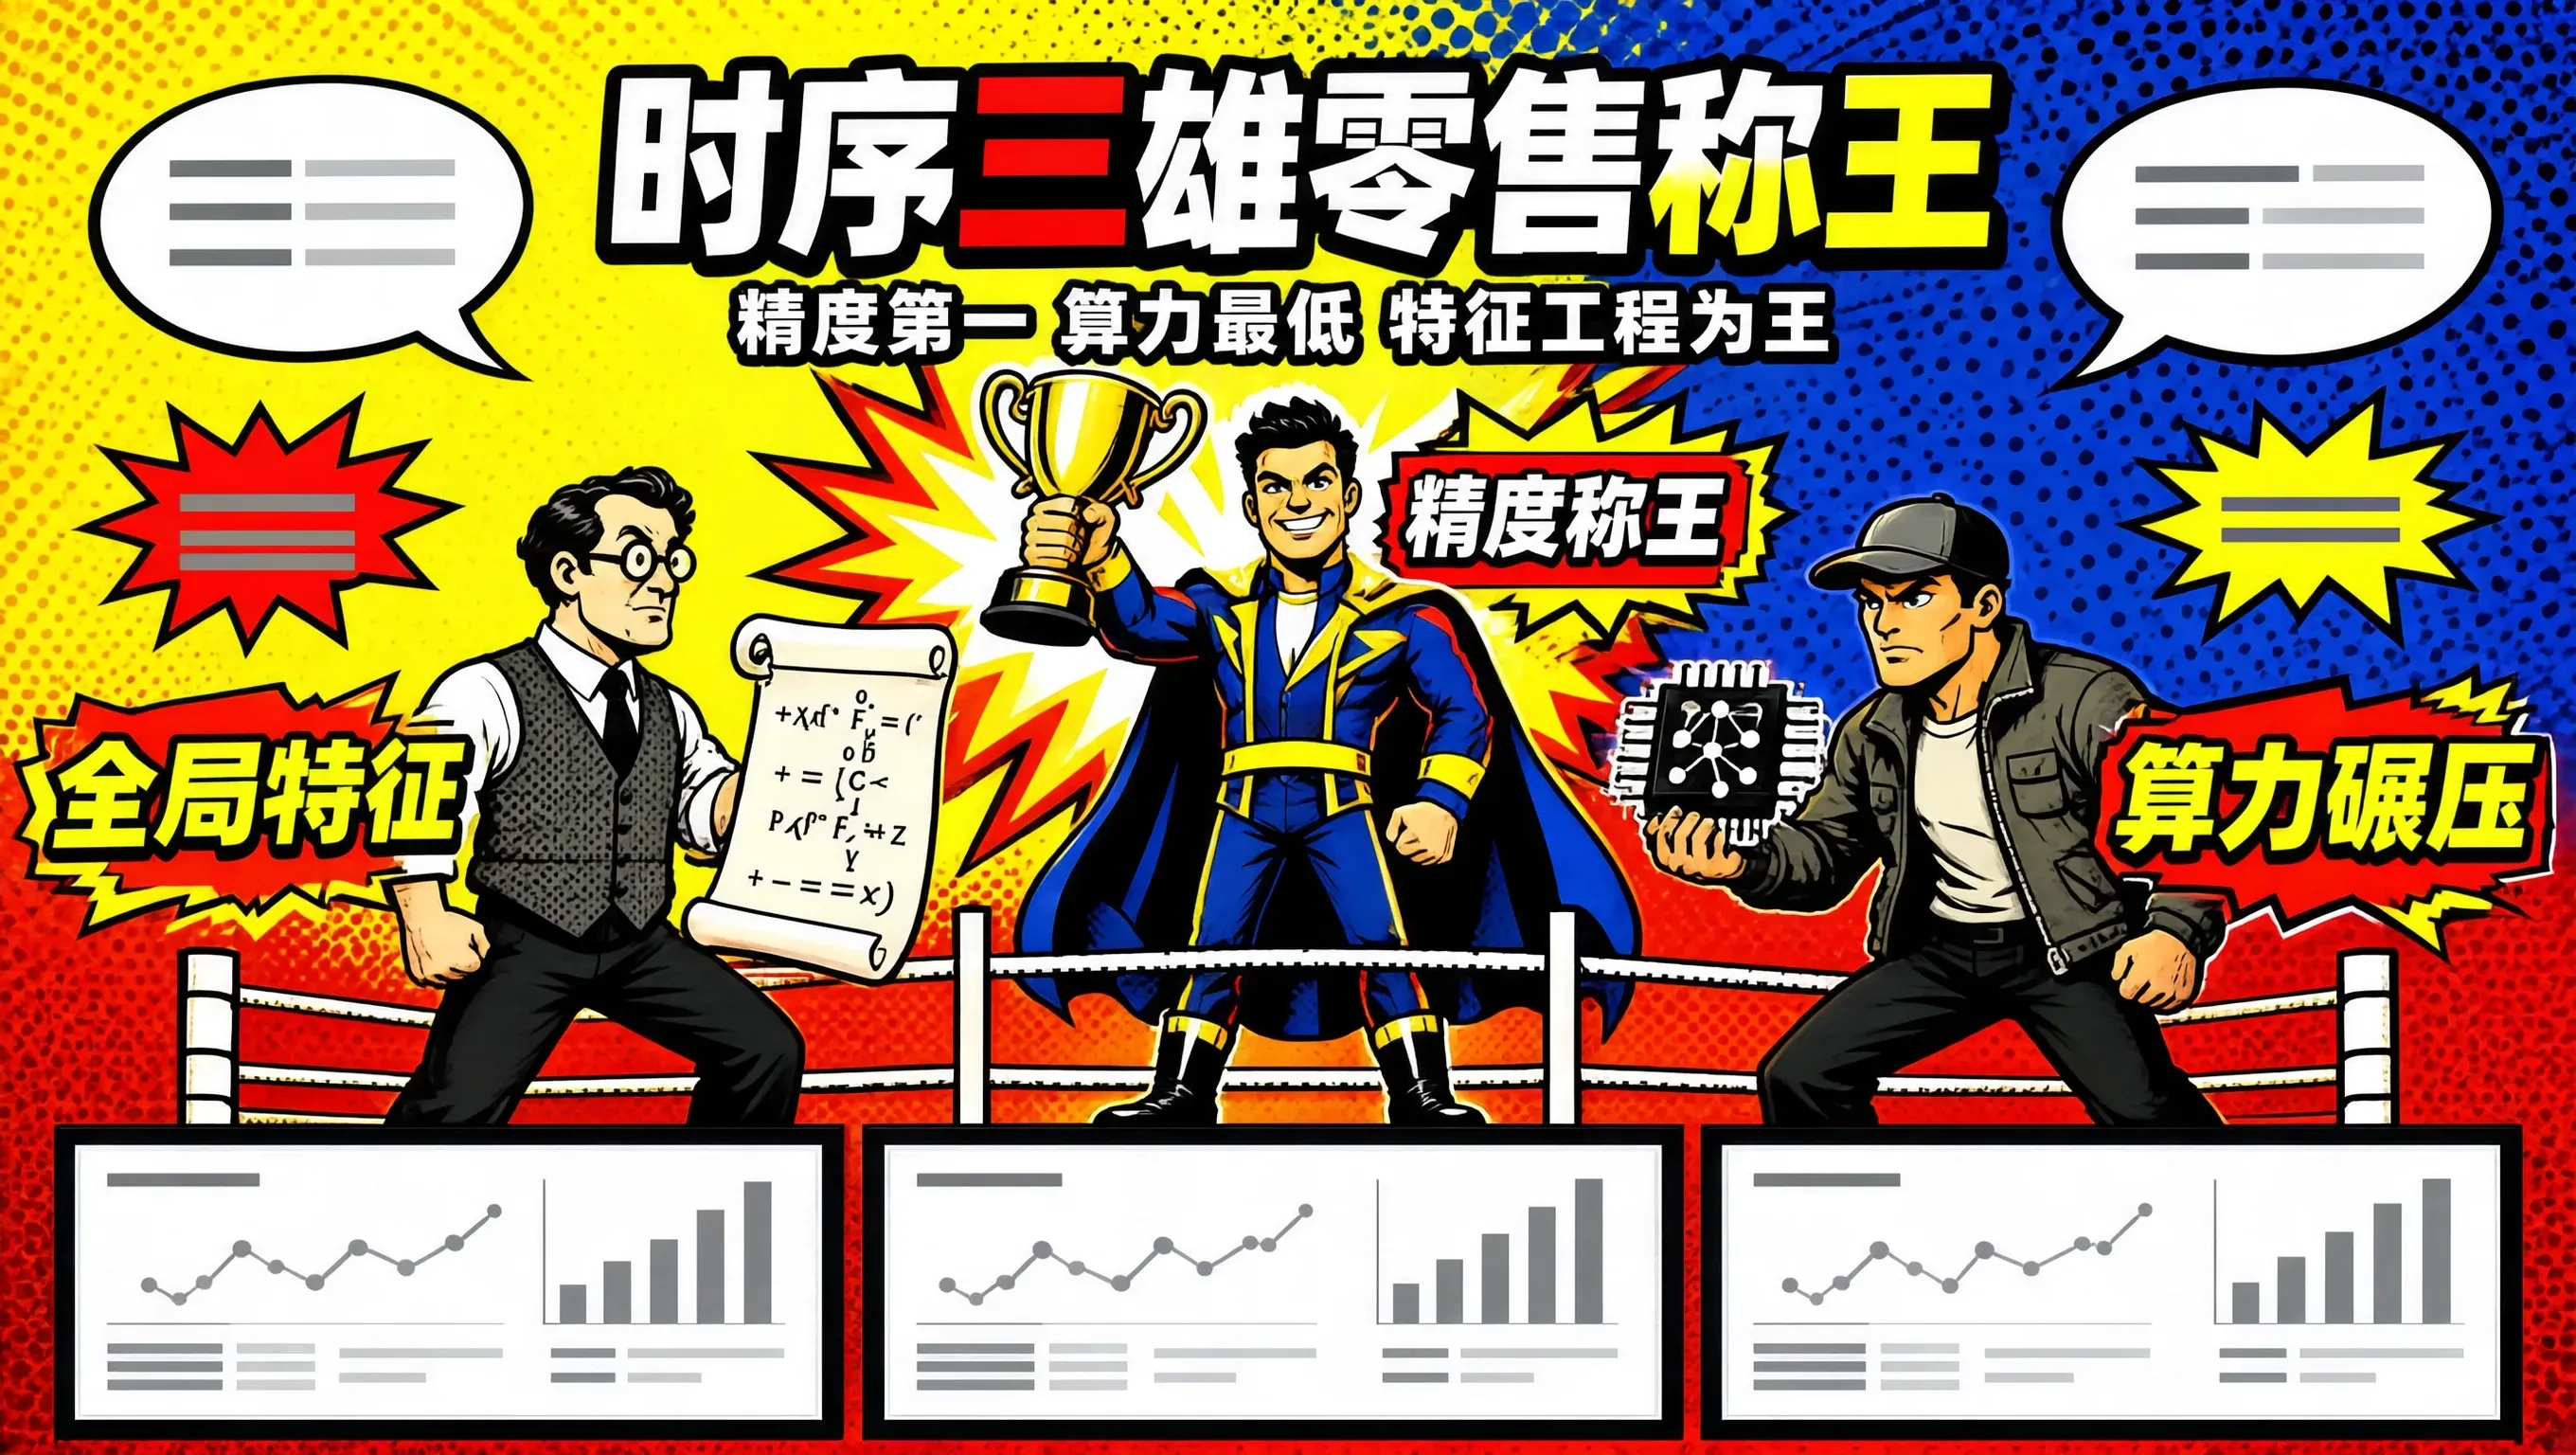
很多技术团队在选型时容易陷入“模型越深越复杂就越准”的思维定势,盲目采购昂贵的 GPU 服务器搭建深度学习训练集群。然而在真实的零售连锁多门店、多 SKU 预测场景下(如 3,000 家门店 × 20,000 款商品 = 6000 万个预测序列),不仅要考虑,还要严密考核。今天我们用一组包含 1,000 个不同特征商品序列的真实零售数据集,对 Prophet、DeepAR 和 LightGBM 进
在深度学习模型压缩的研究文献中,模型剪枝(Pruning)常年占据核心地位。学术界经常出现“将 ResNet-50 权重稀疏度压缩 80%,理论 FLOPs 降低 5 倍且精度近乎无损”的引人注目的结论。很多算法工程师兴冲冲地在 PyTorch 中使用将权重中绝对值较小的元素直接置零,导出一个看似极其“稀疏”的模型。
在现代 GPU(如 NVIDIA A100 / H100)上运行深度学习推理时,硬件计算单元的峰值浮点算力(FLOPs)正在以每两年翻倍的惊人速度膨胀,而高带宽显存(HBM)的物理带宽增长却相对缓慢。这种算力与带宽增速的巨大失衡,导致大模型推理网络中绝大多数非 GEMM 算子(如 LayerNorm、GELU、Residual Add、Softmax)的执行时间,完全被**显存访存延迟(Memor
在 CPU 端进行大模型或通用深度学习推理优化时,如何将大尺寸矩阵乘法(GEMM)或量化点积算子均匀分发到 CPU 的几十个物理核心上,是决定端到端吞吐量的胜负手。在传统的科学计算与 C/C++ 开源项目中,是最普遍采用的多线程并行方案,只需在循环上方加一行指令,编译器就会自动完成线程分发。llama.cpp 和大量底层库在早期也重度依赖 OpenMP。然而,当系统从单次静态批处理演进到高并发、低
在深度学习模型训练完成并转换为推理计算图后,整张网络中存在着大量的静态先验信息:固定的模型权重(Weights)、固定的偏置项(Biases)、固定的超参数(如 LayerNorm 的 $\epsilon = 1e-5$)、以及在导出时遗留的训练专用分支(如 Dropout、梯度检查点标记)。对于 AI 编译器前端而言,与是最基础、但也是收益最立竿见影的两项全局优化 Pass。
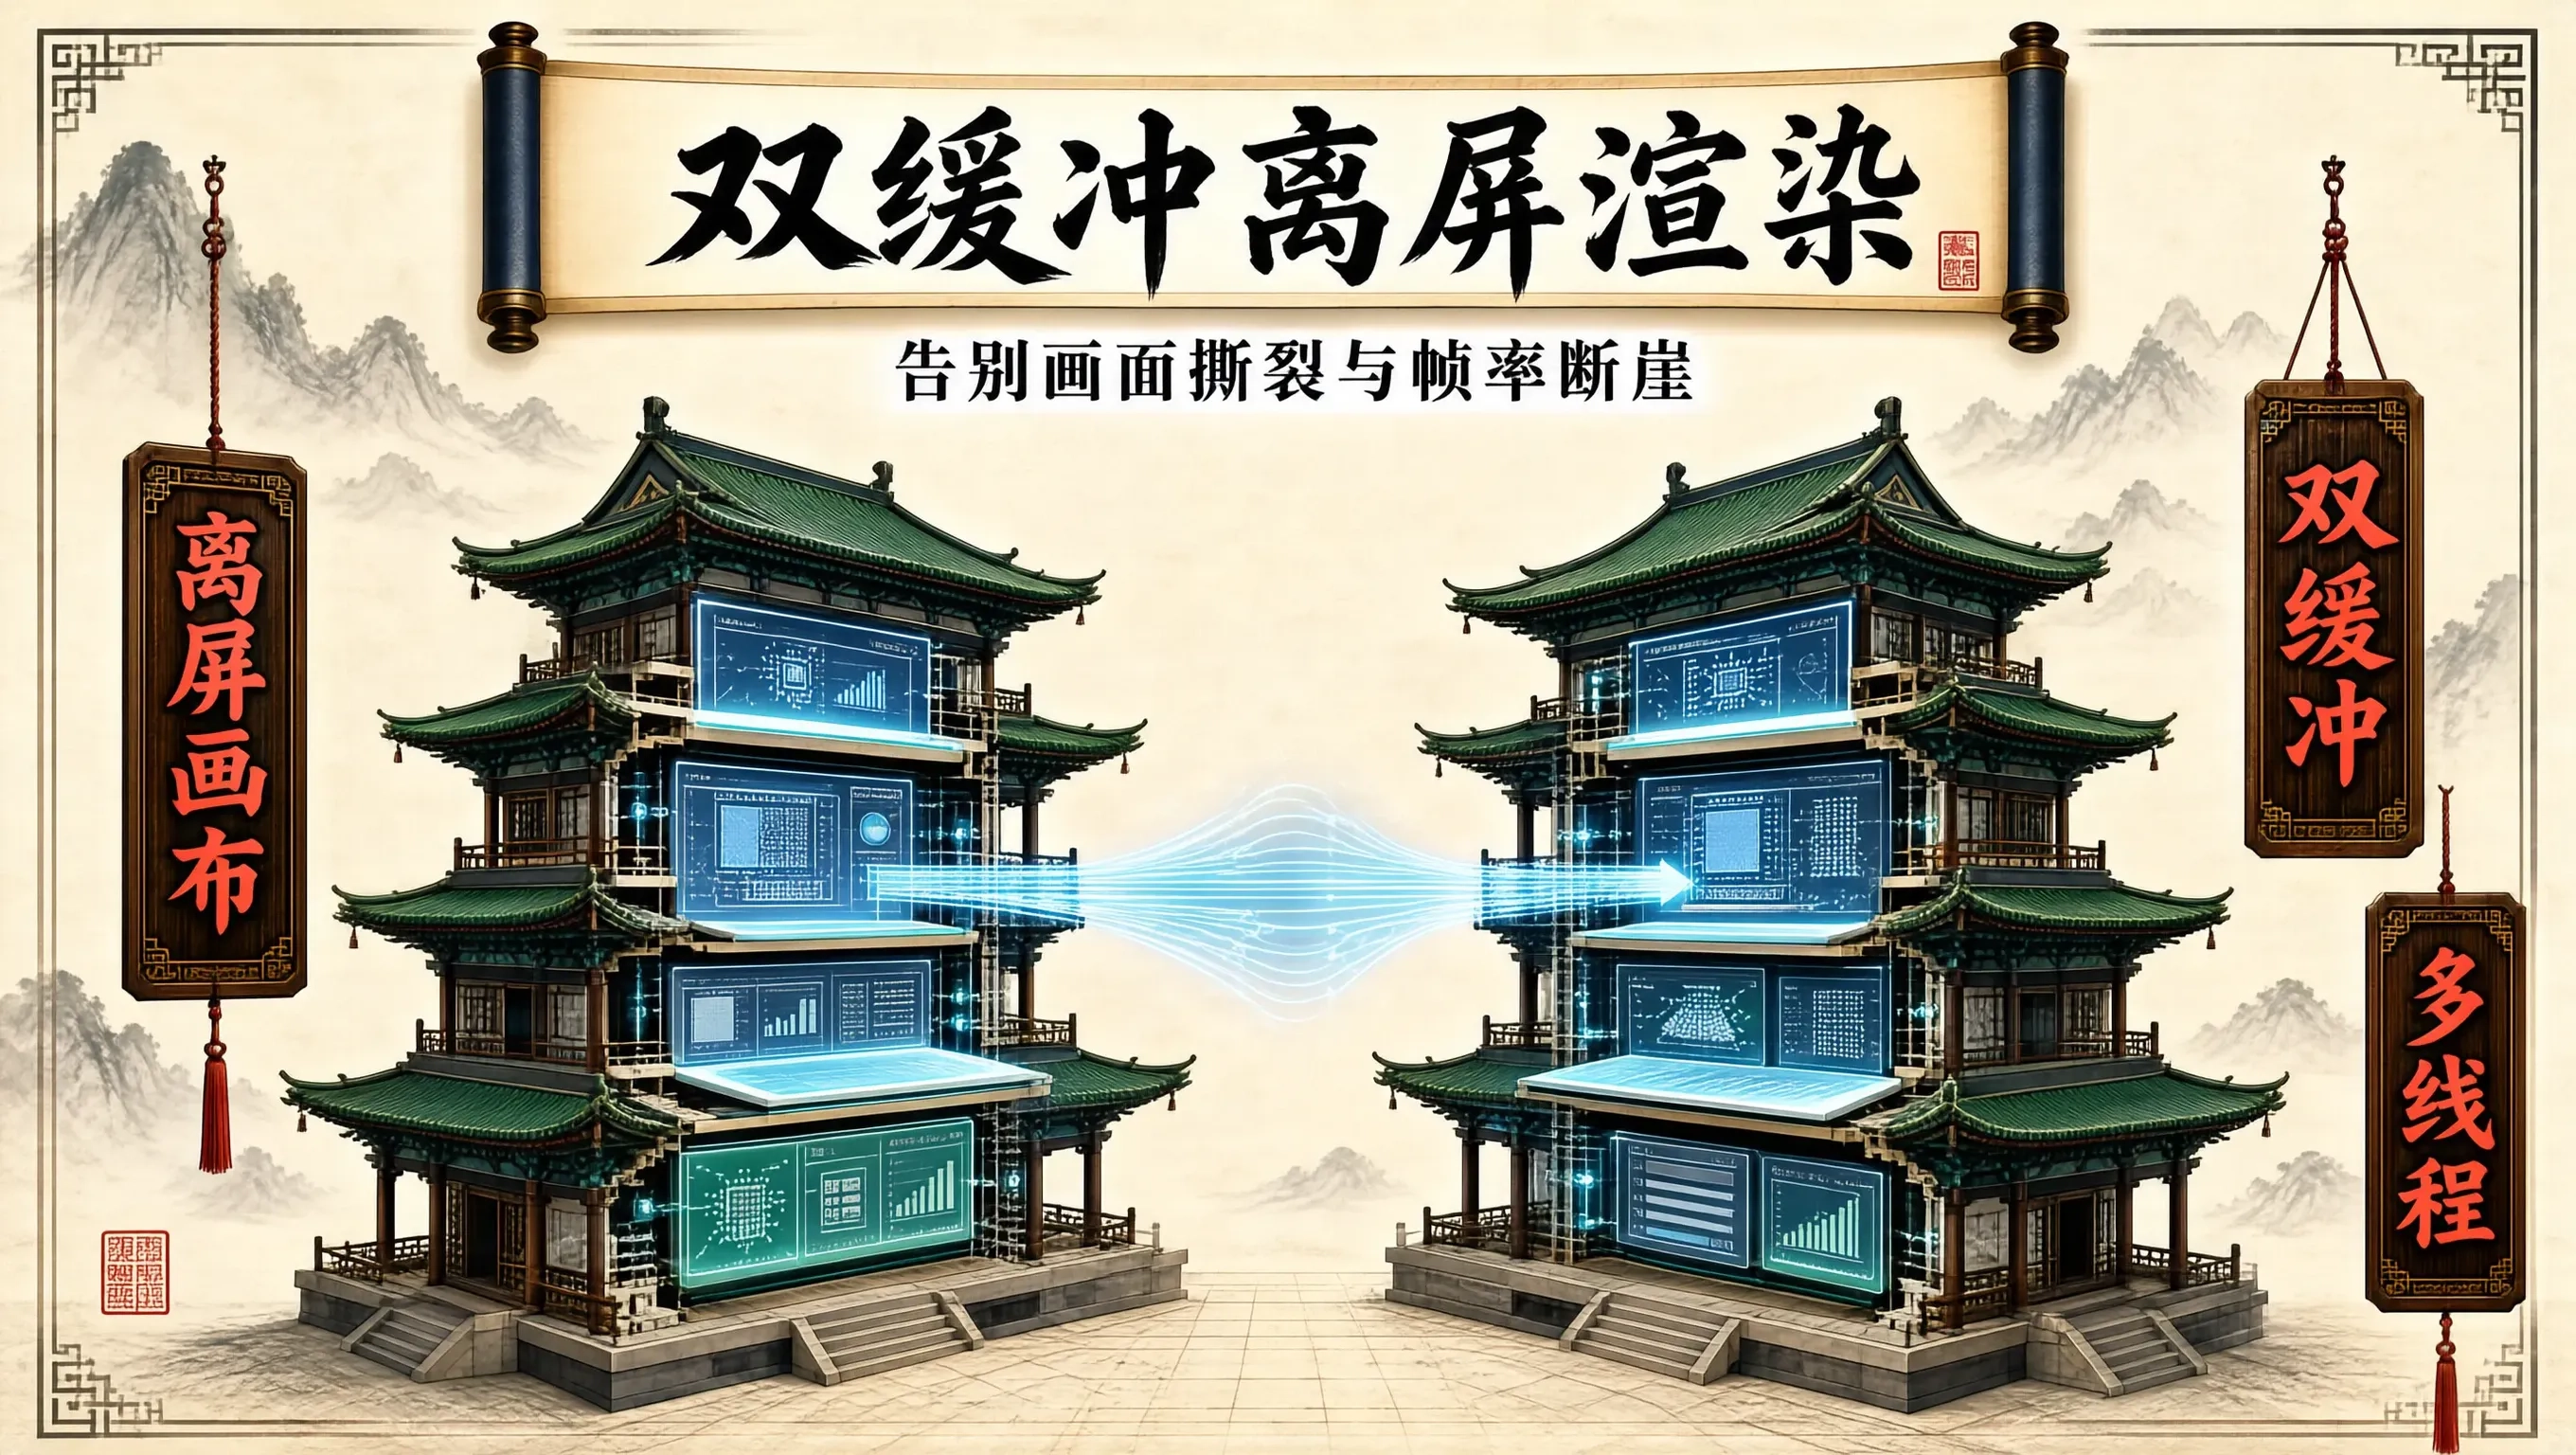
在构建高频金融 K 线图、工业物联网实时监控拓扑或超万点散点图时,Canvas 2D 经常会面临两大性能瓶颈:绘制过程中的画面撕裂与闪烁,以及高频重绘带来的主线程帧率断崖式下跌。许多团队在做 Canvas 性能优化时,往往只把精力放在减少 API 调用次数上,却忽视了画布背后的显存提交时机与渲染管线。合理运用,是让前端 2D 渲染突破瓶颈的关键招式。
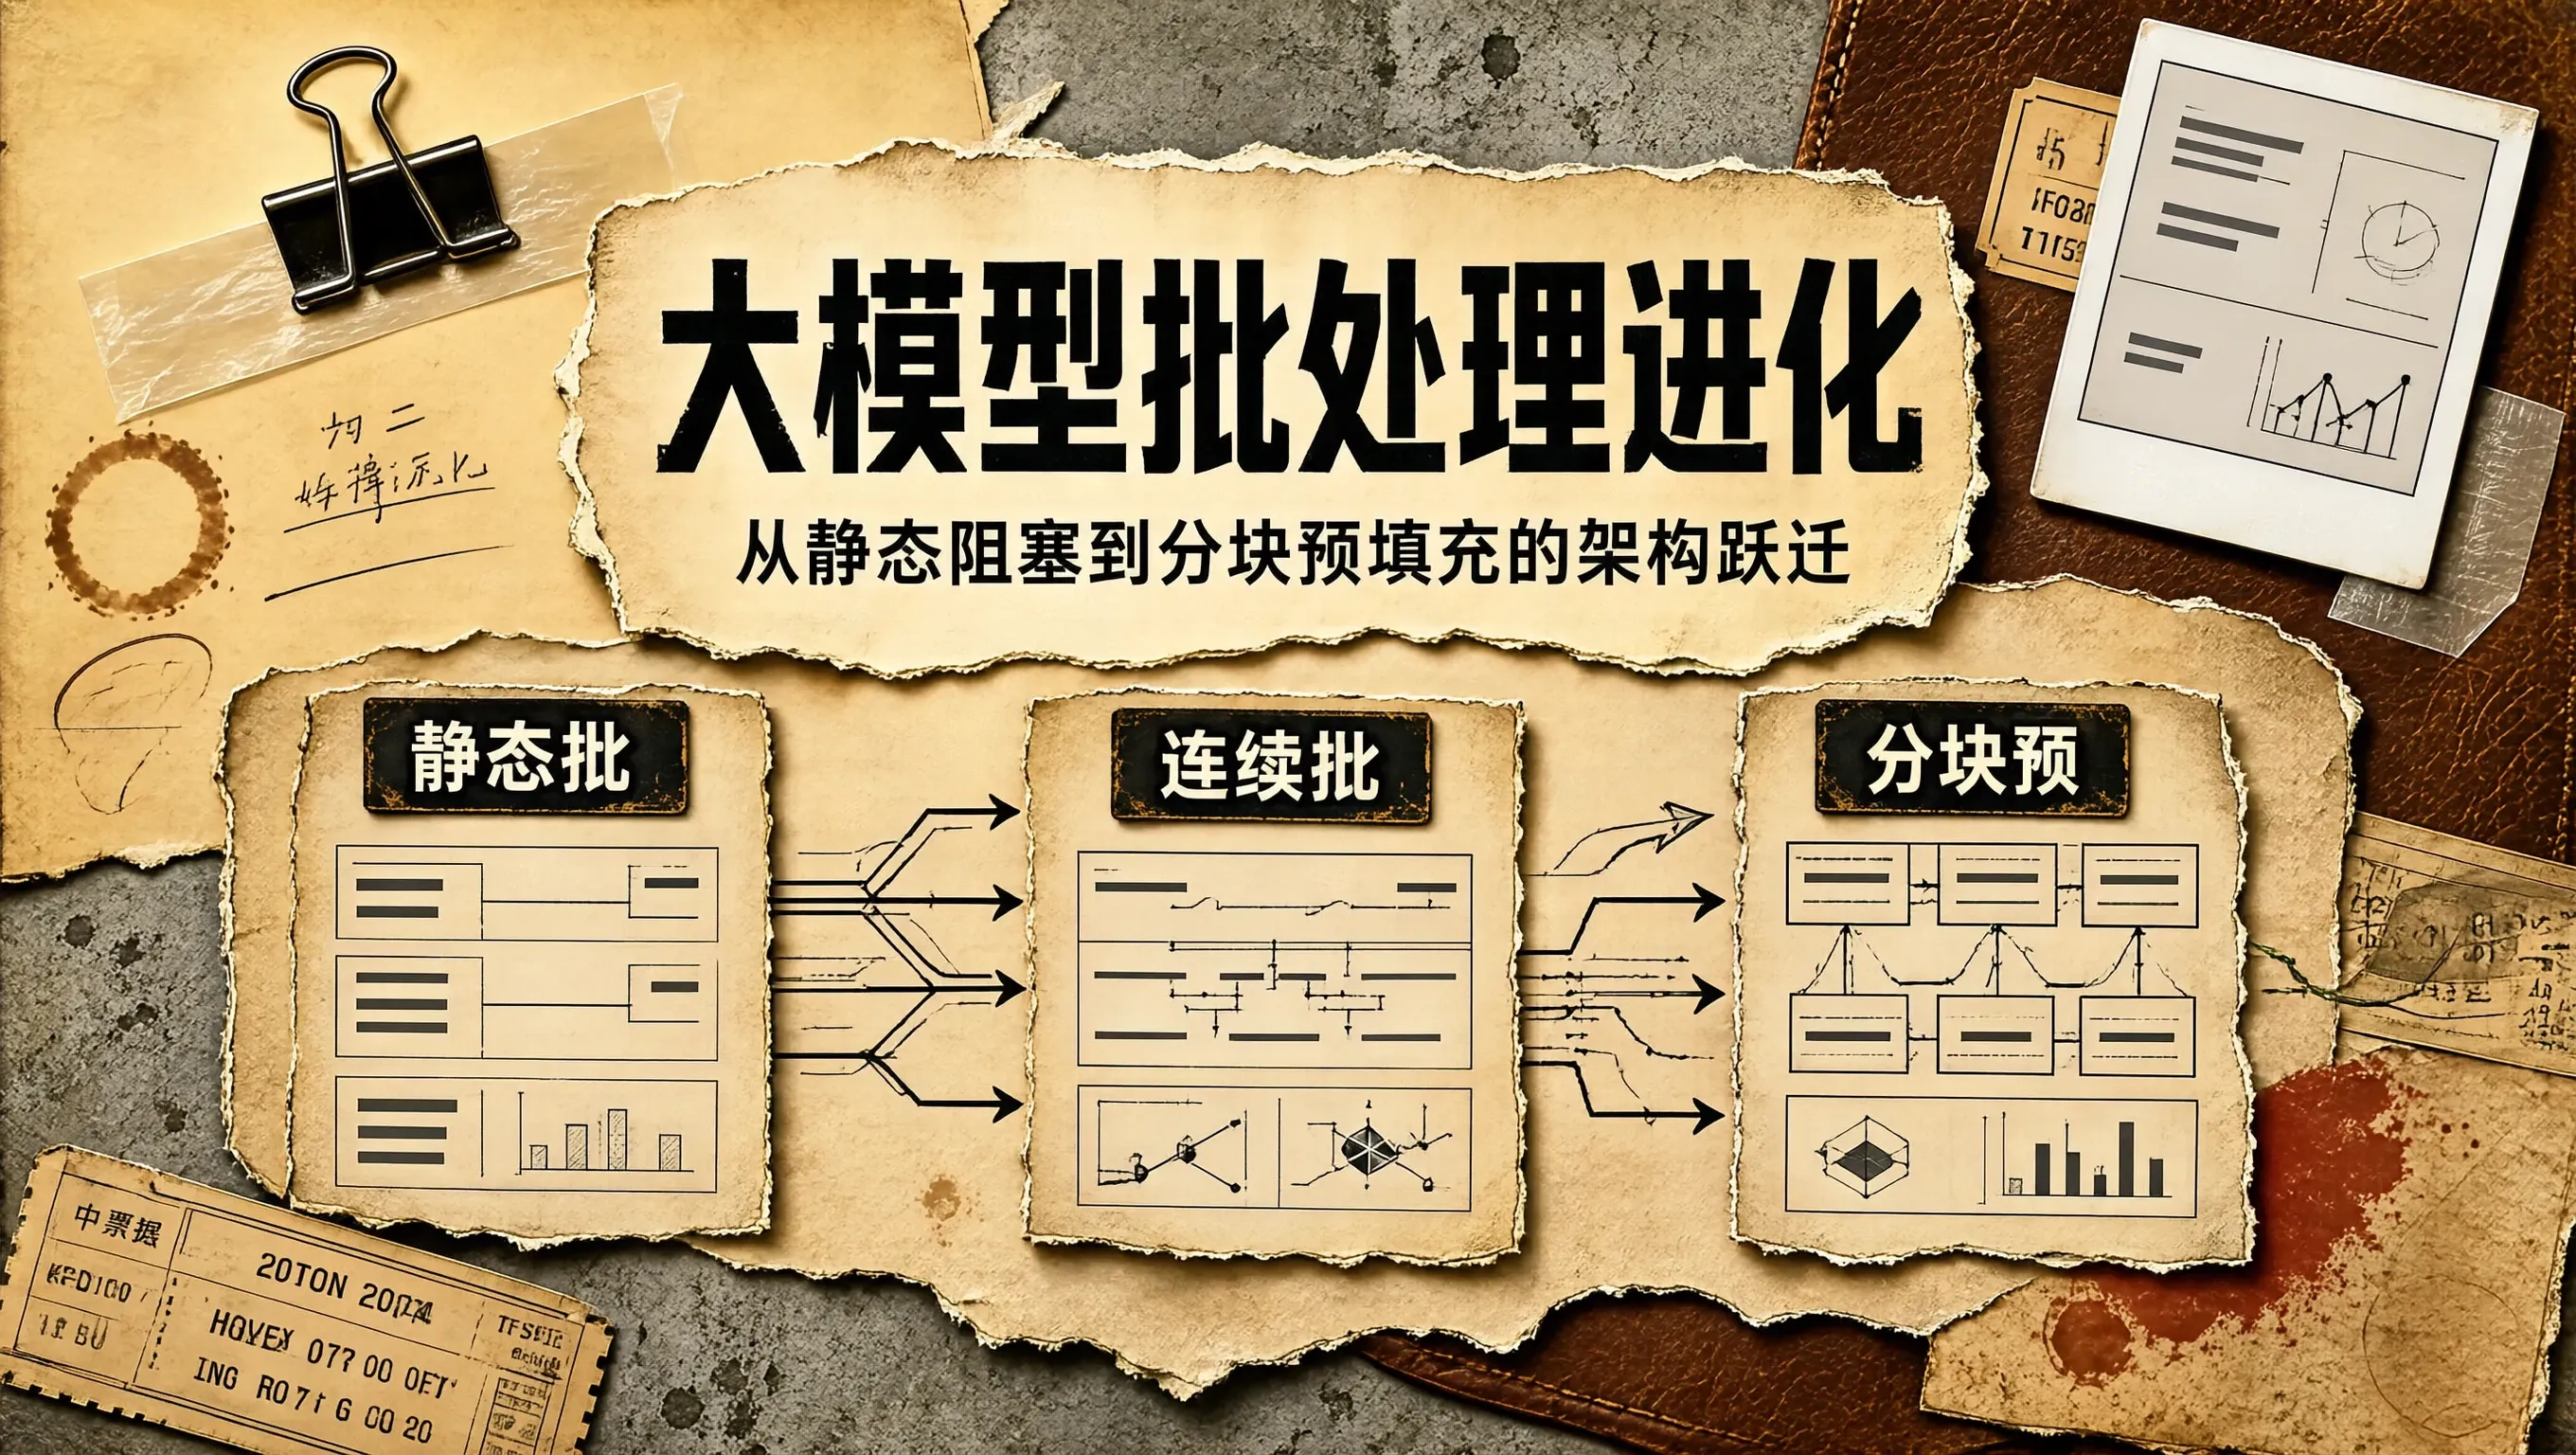
在大模型在线推理服务中,如何将来自不同客户端的并发请求高效打包(Batching),是决定整个服务吞吐量与响应延迟的核心命脉。在传统的深度学习推理(如图像分类或 BERT 时代)中,请求通常具有固定的输入输出长度,静态批处理能够很好地跑满 GPU。然而对于自回归大语言模型(LLM),用户输入的 Prompt 长度可能从几个字跨越到数万字,生成的回答长度也完全不可预测。如果依然沿用传统的批处理思维,
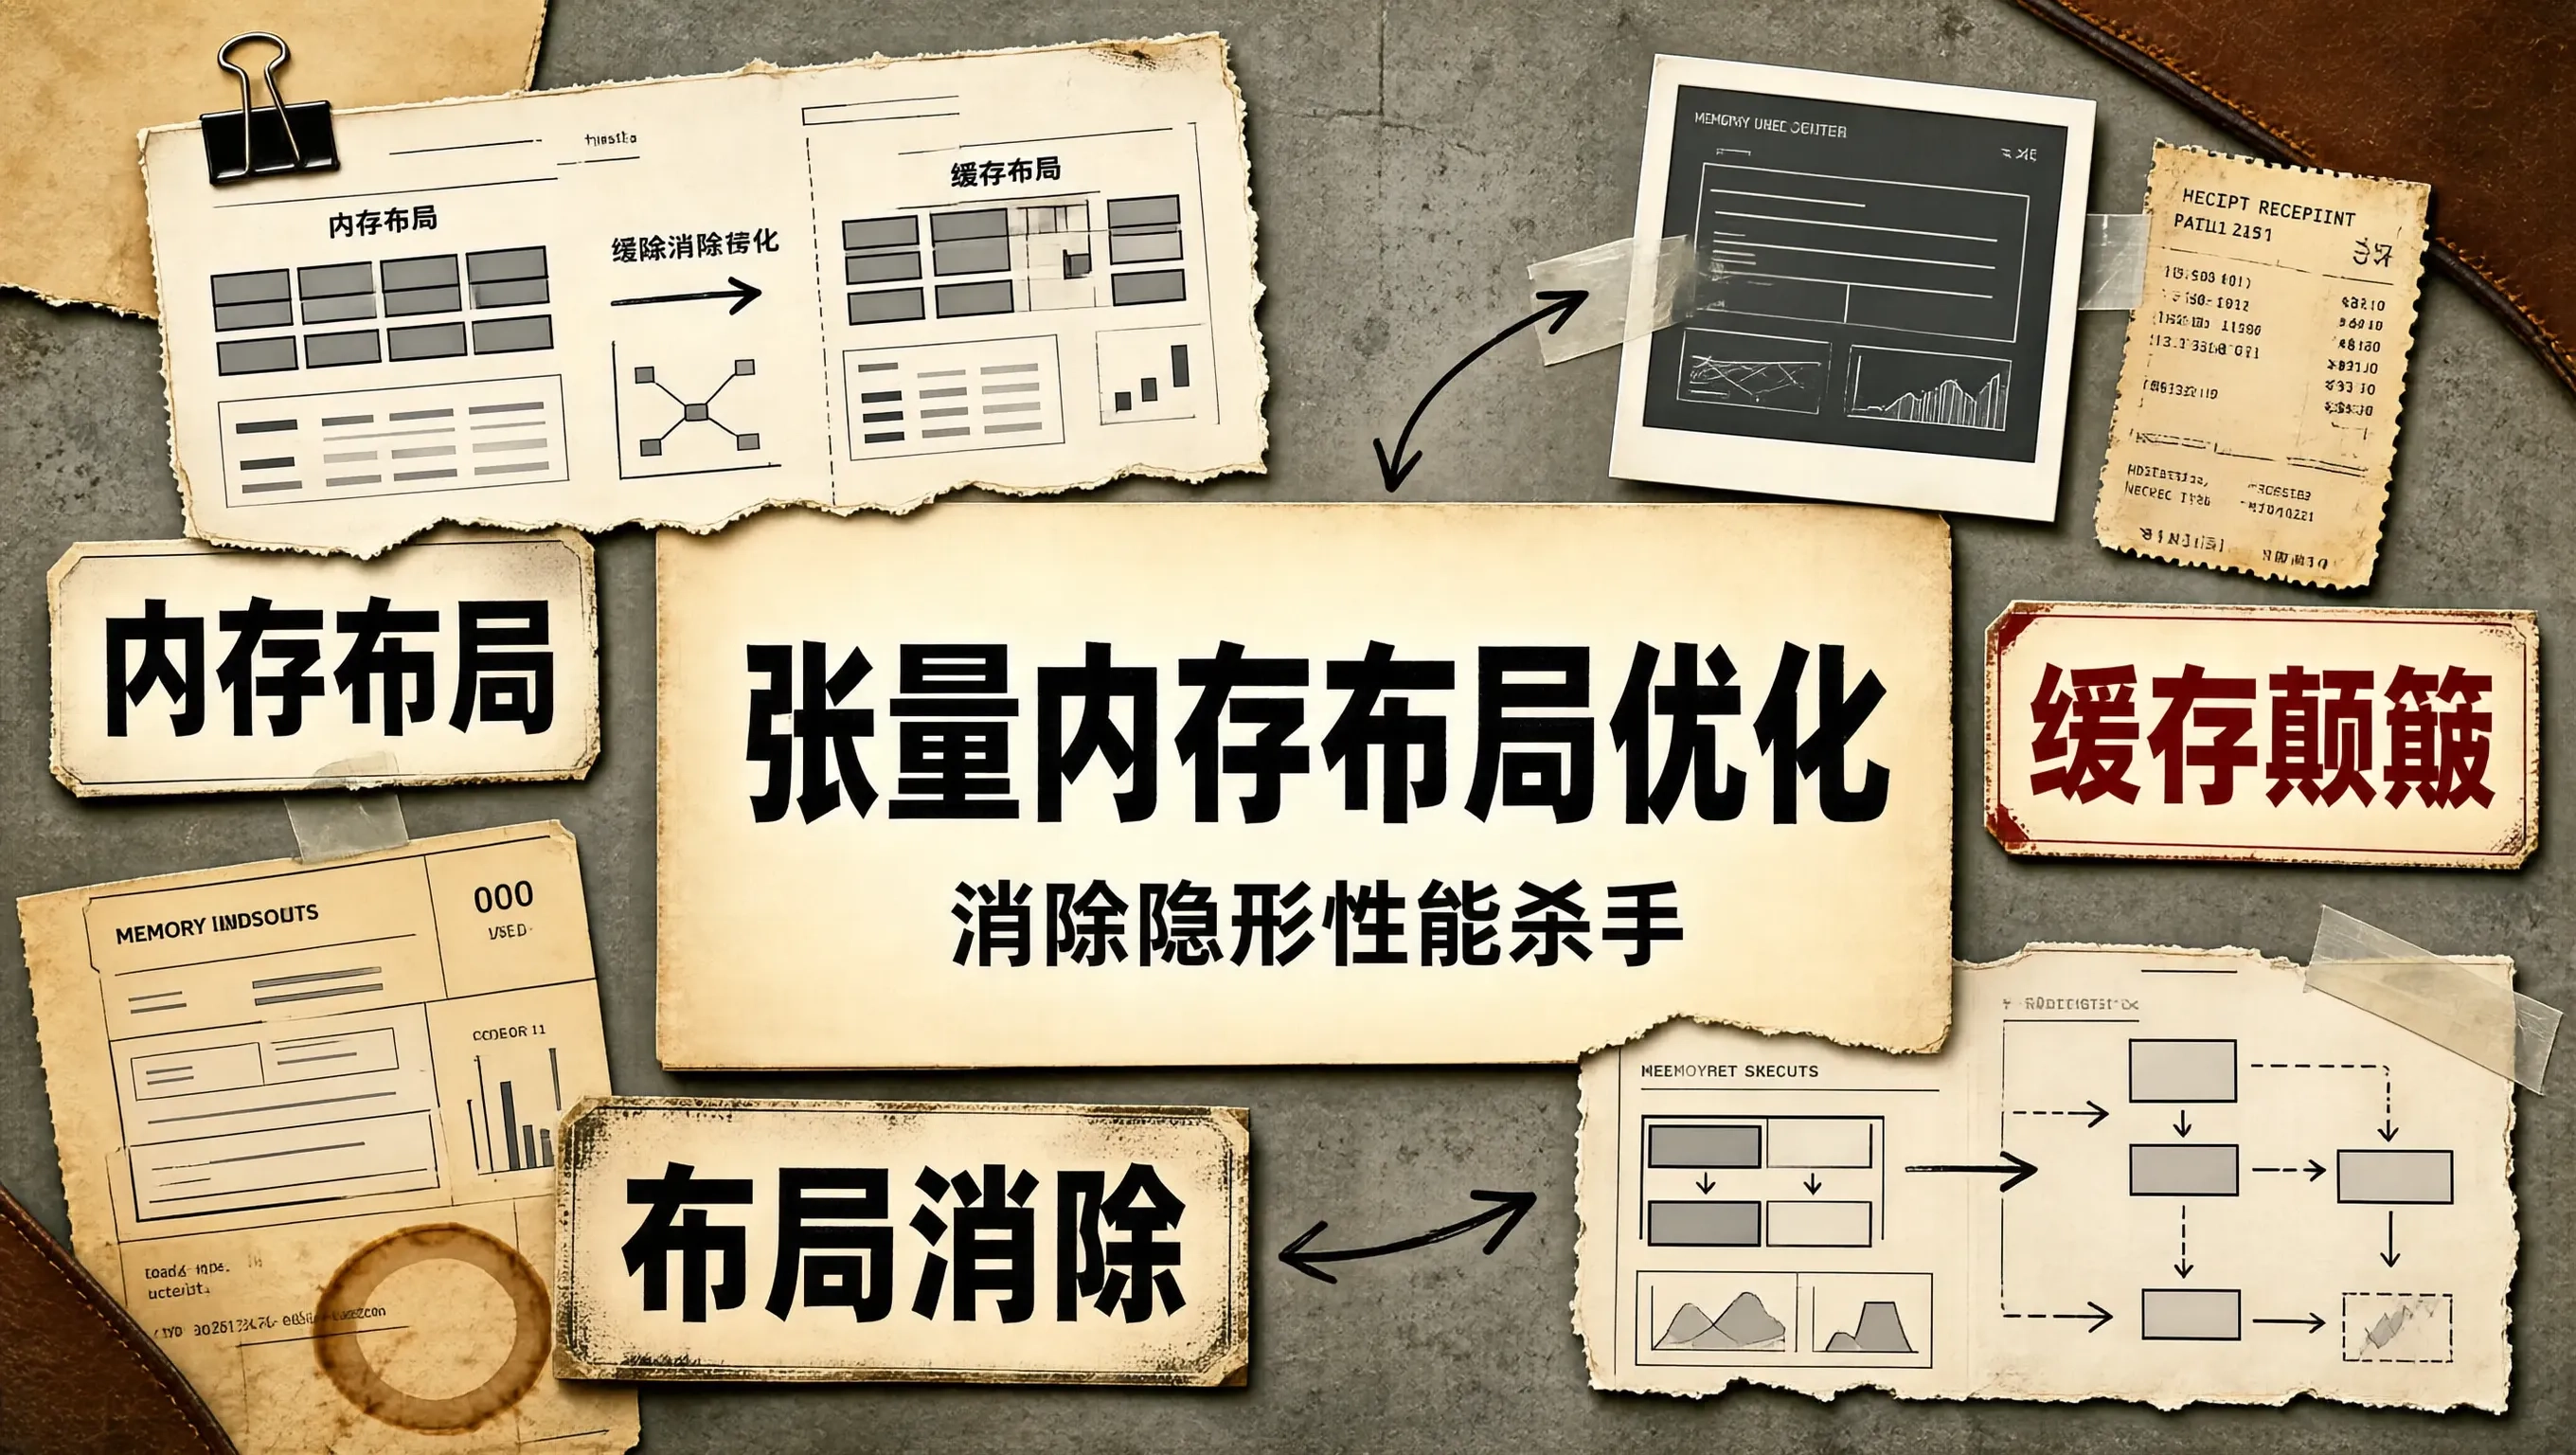
在视觉模型与多模态大模型(Vision-Language Models)的编译优化中,张量的**内存排布格式(Memory Layout / Data Format)**是影响硬件计算效率的最关键因素之一。很多刚接触深度学习底层优化的开发者,经常在模型代码中随意插入permutetranspose或reshape操作,以为这只是简单的几行维度变换。然而在底层硬件层面,一次看似不起眼的从NCHW(通
我整理好的1000+面试题,请看或者最好将URL复制到浏览器中打开,不然可能无法直接打开好了,我们今天针对上面的问题,
大模型应用开发必修课!本文通过通俗易懂的案例详解 RAG (检索增强生成) 的核心原理,对比 LlamaIndex 与 LangChain 的优劣,并手把手带咱们在 Kaggle 环境下,利用 ChromaDB 和 Qwen 模型搭建一个支持私有数据问答的企业级 RAG 系统。
如果你的需求是“写一份系统上线方案”,可以在Prompt中加入这样的角色设定:“请你扮演一位拥有十年经验的运维架构师,负责过多个高并发系统的上线工作。就像你请一个厨师做“一道菜”,他可能会给你端上一盘番茄炒蛋——没错,是菜,但未必是你想吃的。同样重要的是,你也要告诉模型“你是谁”;同样是写技术文档,一个“资深架构师”写出来的风格,和一个“刚入行的初级工程师”写出来的,截然不同。精准生成专业技术文档