


- @2601_96292947


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
AI大模型指参数规模超10亿的深度学习模型,如GPT-3(1750亿参数)等。其核心突破包括参数量的指数级增长、上下文学习能力和多模态融合。从2012年AlexNet到2023年LLaMA 2开源,大模型经历了十年技术演进。关键技术特征遵循"模型效果∝参数规模×数据量×计算量"的定律,依赖Transformer架构的注意力机制等组件。目前已在编程辅助(如GitHub Copilot)、工业质检等领
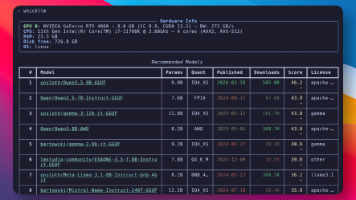
随着开源大模型(如Llama、Qwen、Gemma)性能逼近闭源模型,本地部署需求增长,但模型选择与硬件适配问题突出。为解决试错成本高、部署效率低的问题,开源工具whichllm应运而生。它能根据硬件配置(如显存、CPU)智能推荐最优模型(如RTX 4090优先推荐27B而非32B),综合性能、评分与性价比生成列表,支持一键下载部署(whichllm run)。工具兼容N卡、A卡、Apple芯片及
国外AI大模型最新进展速览(2026年7月) DeepMind推出轻量级图像模型Gemini 3.1 Flash-Lite Image和视频模型Gemini Omni Lite。LMSYS Arena竞技场显示,Anthropic的Claude Sonnet 5强势入局,其家族模型已占据榜单前十半壁江山,而国产GDK系列正对Gemini形成围剿之势。 行业趋势仍由Google、OpenAI、Ant
2026年AI工具盘点:付费与免费选择指南 2026年AI工具市场已趋于成熟,本文精选了十大值得关注的AI工具,分为三个梯队: 第一梯队(全能王者): Gemini 3.1 Pro:谷歌生态核心,多模态能力突出,深度整合Workspace,适合谷歌用户。 Claude 3.7 Opus:代码与写作能力顶尖,上下文窗口极大,适合程序员和作家。 Grok 3:依托X平台数据,实时性最强,风格幽默犀利,
《Large Language Model Course》(LLM-Course)是由谷歌AI开发者mlabonne创建的开源教程(GitHub 80.4k Stars),系统化讲解大模型技术。课程分为三大模块: 基础入门:涵盖数学、Python、神经网络与NLP前置知识,零基础友好。 研究者路线:深入大模型架构、预训练、微调、量化等底层原理,适合学术研究。 开发者路线:聚焦RAG、Agent开发
本文推荐李宏毅教授的大模型入门教程(共11讲),涵盖生成式AI发展、提示词工程、Transformer架构、多模态模型等内容,适合快速掌握大模型核心知识。教程注重实践与前沿技术(如GPT-4o解析),并提供配套学习礼包,包括系统路线、书籍、行业报告、实战项目及面试题库,分四阶段(初阶应用→高阶应用→模型训练→商业闭环)帮助学习者从入门到就业。领取方式见文末。
本文系统分析了十种主流大语言模型(LLM)服务引擎和工具的技术特点与应用场景,涵盖从浏览器端推理到企业级部署的解决方案。WebLLM利用WebGPU实现浏览器端高性能推理;LM Studio提供本地化离线运行环境;Ollama专注轻量级本地部署;vLLM则通过PagedAttention技术优化GPU内存管理。这些工具在兼容性、计算效率、数据隐私等方面各具优势,同时也存在硬件依赖、模型支持等局限性
本文介绍了如何在Mac本地部署和运行大型语言模型(LLM)的开源工具Ollama,Windows系统同理。首先下载安装Ollama,通过终端命令ollama run mistral下载并运行mistral-7b模型进行测试。接着配置前端界面,使用Docker运行open-webui项目,通过浏览器访问本地3000端口即可操作模型。文章强调即使老旧硬件(如2017款MacBook Pro)也能运行,
本文介绍了DeepSeek模型微调的理论与实践,重点探讨了LoRA(低秩适配)技术在高效微调中的应用。通过分解全秩矩阵为低秩矩阵乘积,LoRA显著减少了参数数量和计算成本。文章对比了多轮对话数据集的三种构建方法,推荐了兼顾效率与信息利用的标签构造方式,并解释了LLM通过掩码注意力机制实现多轮对话独立学习的原因。此外,详细分析了LoraConfig参数设置(如target_modules选择、秩r和
本文介绍了利用PgsFile库与Gemini-2.0大模型实现网络爬虫的新方法。通过解析Quotes to Scrape网站第5页数据(包含名言文本、作者信息及分类标签),展示了无需传统XPath解析技术,直接使用大语言模型提取结构化信息的可行性。文章包含详细代码示例,演示了如何通过get_data_html_online函数获取网页内容,并配合Gemini-2.0生成JSON格式的解析结果。该方