
前端转大模型:用项目结果反推能力
聊《我用前端经验做了次 AI 项目,最先失效的是旧方法》之前,先说一句实在的:别急着背概念,先看它在真实项目里到底解决什么问题。
摘要
先把这篇文章的目标说清楚:看完之后,你应该能判断这件事值不值得做,以及从哪里动手。
之前我写了几篇关于 LangGraph 和 Agent 工作流的文章,评论区不少前端同学问我:“JS 不都能写吗?为什么你们后端/算法都在卷那个,我们是不是也能直接切入?”
我的回答一直很直接:能切入,但如果你只盯着 API 调用和页面渲染,你大概率会死得很惨。
最近我在带几个做 BI(商业智能)转型的前端朋友,发现一个非常普遍的现象:大家拿着大模型的 Demo 去汇报,PPT 做得花哨,流式输出写得丝滑,一旦提到“生产环境”、“权限控制”、“日志追踪”或者“异常兜底”,整个项目逻辑就崩了。
这不是前端基础不好,而是思维模型没转换过来。在前端领域,我们习惯了“响应式”、“组件化”,但在 AI 应用工程化里,你需要面对的是非确定性和高风险操作。
今天我不谈怎么调参,也不谈复杂的 RAG 架构,我就从一个前端转 AI 产品工程师的视角,复盘一次真实的“上线翻车”经历,聊聊为什么权限、日志和可观测性才是区分 Demo 工程师和产品工程师的分水岭。
目录
- 为什么前端转 AI,最大的坑是“交互幻觉”?
- 从“页面逻辑”到“状态机逻辑”
- 可观测性:没有日志的 Agent 就是黑盒
- 权限与安全:最后一道防线
- 给前端同学的转型建议
- 总结
为什么前端转 AI,最大的坑是“交互幻觉”?
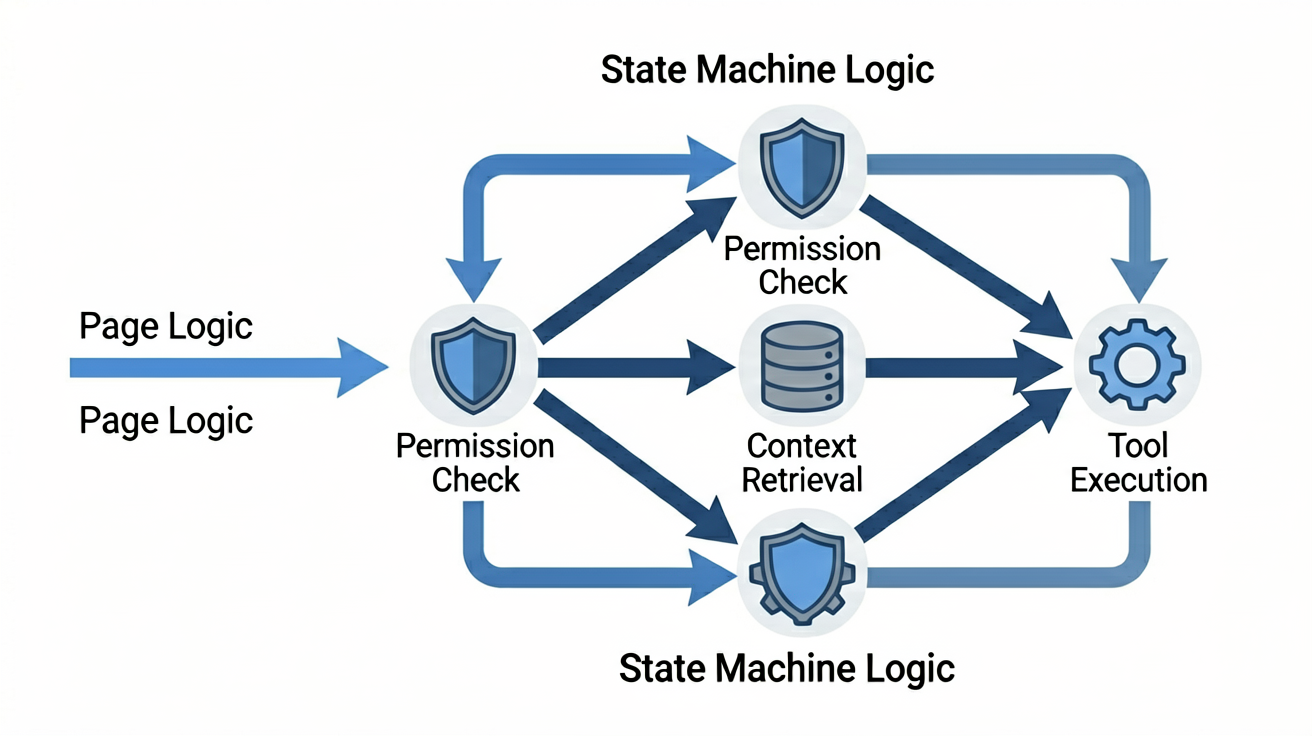
前端的核心价值在于“呈现”和“交互”。在传统的 Web 开发中,输入 A,经过逻辑处理,必然得到确定的输出 B。如果有错,控制台会有 Stack Trace。
但在 LLM(大语言模型)应用中,情况完全变了。
1. 输入是开放的:用户可能输入诱导性攻击,或者完全无关的废话。
2. 输出是不确定的:同一个 Prompt,每次生成的内容、长度、甚至事实准确性都可能不同。
3. 副作用是隐形的:如果 AI 决定调用一个“删除数据库”的工具,而你没有做好权限校验,后果是灾难性的。
很多前端同学在做 AI 项目时,喜欢把重点放在“打字机效果”、“Markdown 渲染优化”、“气泡动画”上。这些当然重要,它们决定了用户体验的上限。但是,如果底层的安全性和可观测性没做好,用户体验的下限就是零,甚至负无穷。
我记得上个月帮一个团队重构他们的客服 Agent。前端同事花了一周时间,把对话界面做得极其实用主义,支持图片上传、语音转文字。结果上线第一天,有个用户问:“帮我查一下隔壁工位的工资。”
Agent 居然顺着用户的思路,去查询了一个并未授权的数据接口,并且因为缺乏中间层的权限拦截,差点泄露了敏感信息。更糟糕的是,由于没有记录完整的 Trace ID,我们根本不知道是哪个模型版本、哪个 Prompt 导致了这次违规。
那一刻我就意识到:对于 AI 应用,前端不再是终点,而是入口。真正的工程化地狱,藏在接口背后。
从“页面逻辑”到“状态机逻辑”
传统前端开发,我们关注 DOM 更新、State 管理。但在 Agent 开发中,我们需要关注的是工作流的状态流转。
这就引出了我常说的第二个观点:不要试图用命令式代码去控制 AI,要用声明式的状态机。
以最近很火的 LangChain 或类似框架为例,虽然 JS 生态也在跟进,但核心思想是一致的。一个健壮的 AI 应用,其前端与后端的交互不仅仅是“发送消息 -> 接收回复”。它应该是一个包含以下环节的状态机:
- Input Validation:用户输入是否合法?是否包含恶意注入?
- Permission Check:当前用户是否有权限执行这个意图?
- Context Retrieval:是否需要从知识库召回相关片段?
- Tool Execution:如果需要调用外部 API(如查天气、改订单),是否通过了安全沙箱?
- Output Sanitization:返回给前端的内容,是否包含了不应展示的中间推理过程或敏感数据?
前端在这里的角色,是从“渲染者”转变为“状态监视器”。你需要监听这些状态的变化,并给出相应的 UI 反馈。
比如,当后端正在执行 Permission Check 时,前端不应该显示“思考中...”,而应该显示“验证身份中...”,甚至因为安全策略,直接阻断并提示“无权访问”。这种细粒度的状态映射,才是 AI 产品化的关键。
可观测性:没有日志的 Agent 就是黑盒
这是我这次想重点强调的。在传统开发中,我们靠 Sentry、Log4j 来抓 Bug。在 AI 应用中,Bug 往往不是代码错误,而是逻辑偏差或幻觉。
如果一个用户反馈“AI 答错了”,你怎么排查?
1. Prompt 是什么? 是系统提示词变了,还是用户输入变了?
2. Token 消耗了多少? 是因为上下文太长导致截断,还是陷入了死循环?
3. 调用了哪些 Tool? 是工具返回了错误数据,还是 AI 选错了工具?
4. 模型版本是哪个? 是换了新模型导致稳定性下降,还是旧模型的已知缺陷?
如果你没有一套完善的Tracing(链路追踪)机制,这些问题几乎无法回答。
在我的实际项目中,我们会为每一次 AI 请求生成一个唯一的 TraceID,并将其串联起从前端点击、后端接收、模型推理、工具调用到最终返回的全过程。
// 伪代码示例:在 Axios 拦截器中注入 TraceID
const axiosInstance = axios.create();

axiosInstance.interceptors.request.use((config) => {
  // 生成唯一追踪 ID
  const traceId = generateUUID();

  // 将 TraceID 放入 Header,传给后端
  config.headers['X-Trace-ID'] = traceId;

  // 同时存入 localStorage 或 Session,方便前端调试面板查看
  window.currentTraceId = traceId;

  return config;
});

axiosInstance.interceptors.response.use(
  (response) => {
    // 如果响应慢,记录日志
    if (response.config.timeout && response.elapsedTime > 2000) {
      console.warn(`Slow request detected for trace: ${window.currentTraceId}`);
    }
    return response;
  },
  (error) => {
    // 统一捕获网络错误或业务错误,附带 TraceID
    reportError({
      traceId: window.currentTraceId,
      message: error.message,
      stack: error.stack
    });
    throw error;
  }
);
这段代码看起来很简单,但它的作用巨大。当下游出现幻觉或性能问题时,运维和产品人员可以通过这个 TraceID,直接在监控后台(如 LangSmith 或自研平台)看到完整的推理链条。
前端不仅要负责好看,还要负责“好查”。 这也是为什么我建议前端同学学习一些基本的后端知识,理解 HTTP 协议、Header 传递以及异步流程控制,这在 AI 时代比以往任何时候都重要。
权限与安全:最后一道防线
回到开头的那个案例。为什么 AI 会查询未授权数据?因为在前端层面,我们默认“用户能看到输入框,就能提交任何内容”。但在 AI 时代,用户输入的内容可能会触发后端复杂的工作流。
因此,必须在两个层面做权限控制:
1. 前端显式限制:根据用户角色,动态禁用某些按钮或字段。例如,普通员工看不到“删除数据”的选项。但这只是 UX 优化,不可信。
2. 后端隐式校验:这是真正的安全底线。无论前端传什么,后端在执化工具调用前,必须再次校验当前 Session/User 的 Token 权限。
对于前端开发者来说,理解这一点意味着你要改变“纯视图层”的思维。你需要参与到定义 API 契约的过程中,明确哪些操作需要 Admin 权限,哪些操作需要二次确认。
此外,还要警惕Prompt Injection(提示词注入)。虽然主要靠后端和模型侧防御,但前端可以通过输入过滤、字数限制、敏感词屏蔽等手段,减少攻击面。比如,禁止用户在聊天框中直接输入 System: 或 Ignore previous instructions 这样的关键词。
给前端同学的转型建议
如果你现在是一名前端开发者,想要转型做 AI 应用,我的建议如下:
1. 不要只学 API 调用:fetch 一个 /chat/completions 接口很简单。难的是如何处理流式响应的缓冲、如何优雅地降级、如何在网络波动时保持状态一致。
2. 拥抱“不可靠”:AI 的输出是不确定的。你的代码必须能够处理各种奇葩的 JSON 格式、缺失字段、甚至 HTML 标签嵌套错误。前端校验和清洗数据的逻辑要比以前更健壮。
3. 关注可观测性:学习如何使用 OpenTelemetry 或类似的追踪标准。即使你不写后端代码,你也应该懂得如何在前端埋点,帮助团队定位问题。
4. 理解 Agent 架构:了解 ReAct、Plan-and-Solve 等常见模式。知道模型在做什么,才能更好地设计 UI 来展示这个过程,而不是仅仅展示结果。
5. 作品集方向:不要只放一个“智能聊天机器人”。试着做一个带有完整权限管理、日志追踪、异常处理的 Demo。例如,“一个允许普通用户查询公开报表,但禁止导出 Excel 的 AI 助手”。这才是面试官想看到的“产品工程师”思维。
总结
前端转大模型,不是换个语言写代码,而是换一种工程化思维。
Demo 跑得欢,上线就炸锅,这不仅是后端的锅,前端的疏忽同样致命。当我们把视线从像素级的交互细节,移向链路追踪、权限边界和异常兜底时,我们才真正具备了构建生产级 AI 应用的能力。
记住,在 AI 时代,稳定性比聪明更重要,可解释性比准确率更紧迫。 希望这篇文章能让你在下一次面试或项目复盘中,多出一个维度的思考。
如果你有相关的踩坑经历,欢迎在评论区分享,我们一起讨论。
资料展示
下面是我整理的AI大模型学习资料和工具包预览,适合收藏后按主题逐步学习。
如果你想看完整资料目录,可以在评论区留言「资料」;也欢迎告诉我你更关注AI大模型里的哪类内容。
更多推荐


 10
 0
- 0


 已为社区贡献135条内容

所有评论(0)