登录社区云,与社区用户共同成长
邀请您加入社区
1688API
讲解hook定位cookie加密位置
该PHP脚本实现抖音评论发布功能,包含完整的请求参数和头部生成逻辑。主要功能包括:生成128位设备标识(Uifid)、构建符合抖音规范的客户端数据(Bd-Ticket-Guard-Client-Data)、模拟RSA公钥格式,以及生成会话特征(X-Tt-Session-Dtrait)。脚本通过CURL发送POST请求,包含视频ID、评论内容等表单数据,并设置严格符合抖音要求的请求头(User-Ag
selenium爬虫自动化
智能优化算法
今天推荐一款专业的国外数据安全擦除工具——SuperEraser,能够彻底删除硬盘、内存、移动硬盘、U盘等存储设备中的数据,确保删除后无法恢复,保护用户隐私安全。除基础文件擦除外,软件还提供软件卸载功能,并可在卸载后执行深度清理,其清理效果显著优于系统自带的卸载工具。
爬山算法是一种简单而有效的启发式搜索算法,它基于贪心策略在给定的问题域中寻找局部最优解。尽管爬山算法存在一些局限性,如容易陷入局部最优解和对初始解敏感等,但它仍然在许多实际应用中发挥着重要作用。通过引入随机性、接受次优解或采用群体搜索策略等方式,可以改进爬山算法的性能和鲁棒性。
优化算法入门系列文章目录(更新中): 1. 模拟退火算法 2. 遗传算法 一. 爬山算法 ( Hill Climbing ) 介绍模拟退火前,先介绍爬山算法。爬山算法是一种简单的贪心搜索算法,该算法每次从当前解的临近解空间中选择一个最优解作为当前解,直到达到一个局部最优解。 爬山算法实现很简单,其主要缺点是会陷入局部最优解,而不一定能搜索
对执掌荣耀一年多的李健来说,排名掉出前五的荣耀,需要一个大爆款。时下人们对远近距离拍照、摄影或者自拍等各类玩法的选择面太广,既有大疆等手持式影像设备,亦有手机大厂们层出不穷的TCQncy.cN高清影像产品,还有各式各样的专业摄影相机,对部分消费者而言,各家披露的参数以及实际拍摄效果已经卷到难分伯仲的地步。从一款新机放大来看整个荣耀,它短期难改荣耀困境,荣耀在公开场合提及了有信心重回国内前三的想法,
本文是《Scrapy框架实战教程》下篇,重点讲解Scrapy的高级功能和实战应用。主要内容包括:1)中间件开发,实现随机UA、代理IP池、请求重试和动态渲染等功能;2)管道高级用法,支持多存储、批量处理和数据验证;3)Scrapy-Redis分布式爬虫架构,解决大规模数据采集问题;4)性能优化策略和反爬应对方案;5)监控告警系统构建。通过完整的分布式电商爬虫案例,展示了如何将各项技术整合应用,实现
本文记录了作者开发国外App爬虫时遇到的401未授权错误问题。通过排查发现该App采用OAuth2.0 PKCE认证流程,其中code_verifier和code_challenge是关键字段。文章详细介绍了两个字段的生成方法:code_verifier是随机字符串,code_challenge则是其SHA256哈希值的Base64URL编码。作者提供了Python和JavaScript的实现代码
Clipsheet是一款完全开源的Chrome爬虫插件,通过易用的交互界面以所见即所得的方式,快速的从页面中采集到你想要的表格,且可以通过简单配置将采集工作自动化。
本项目通过爬虫获取历史天气数据,利用数据分析工具进行清洗和合并,为重庆气候趋势分析提供了可靠的数据支持。通过优化爬虫策略和代码结构,提高了爬取效率和稳定性。
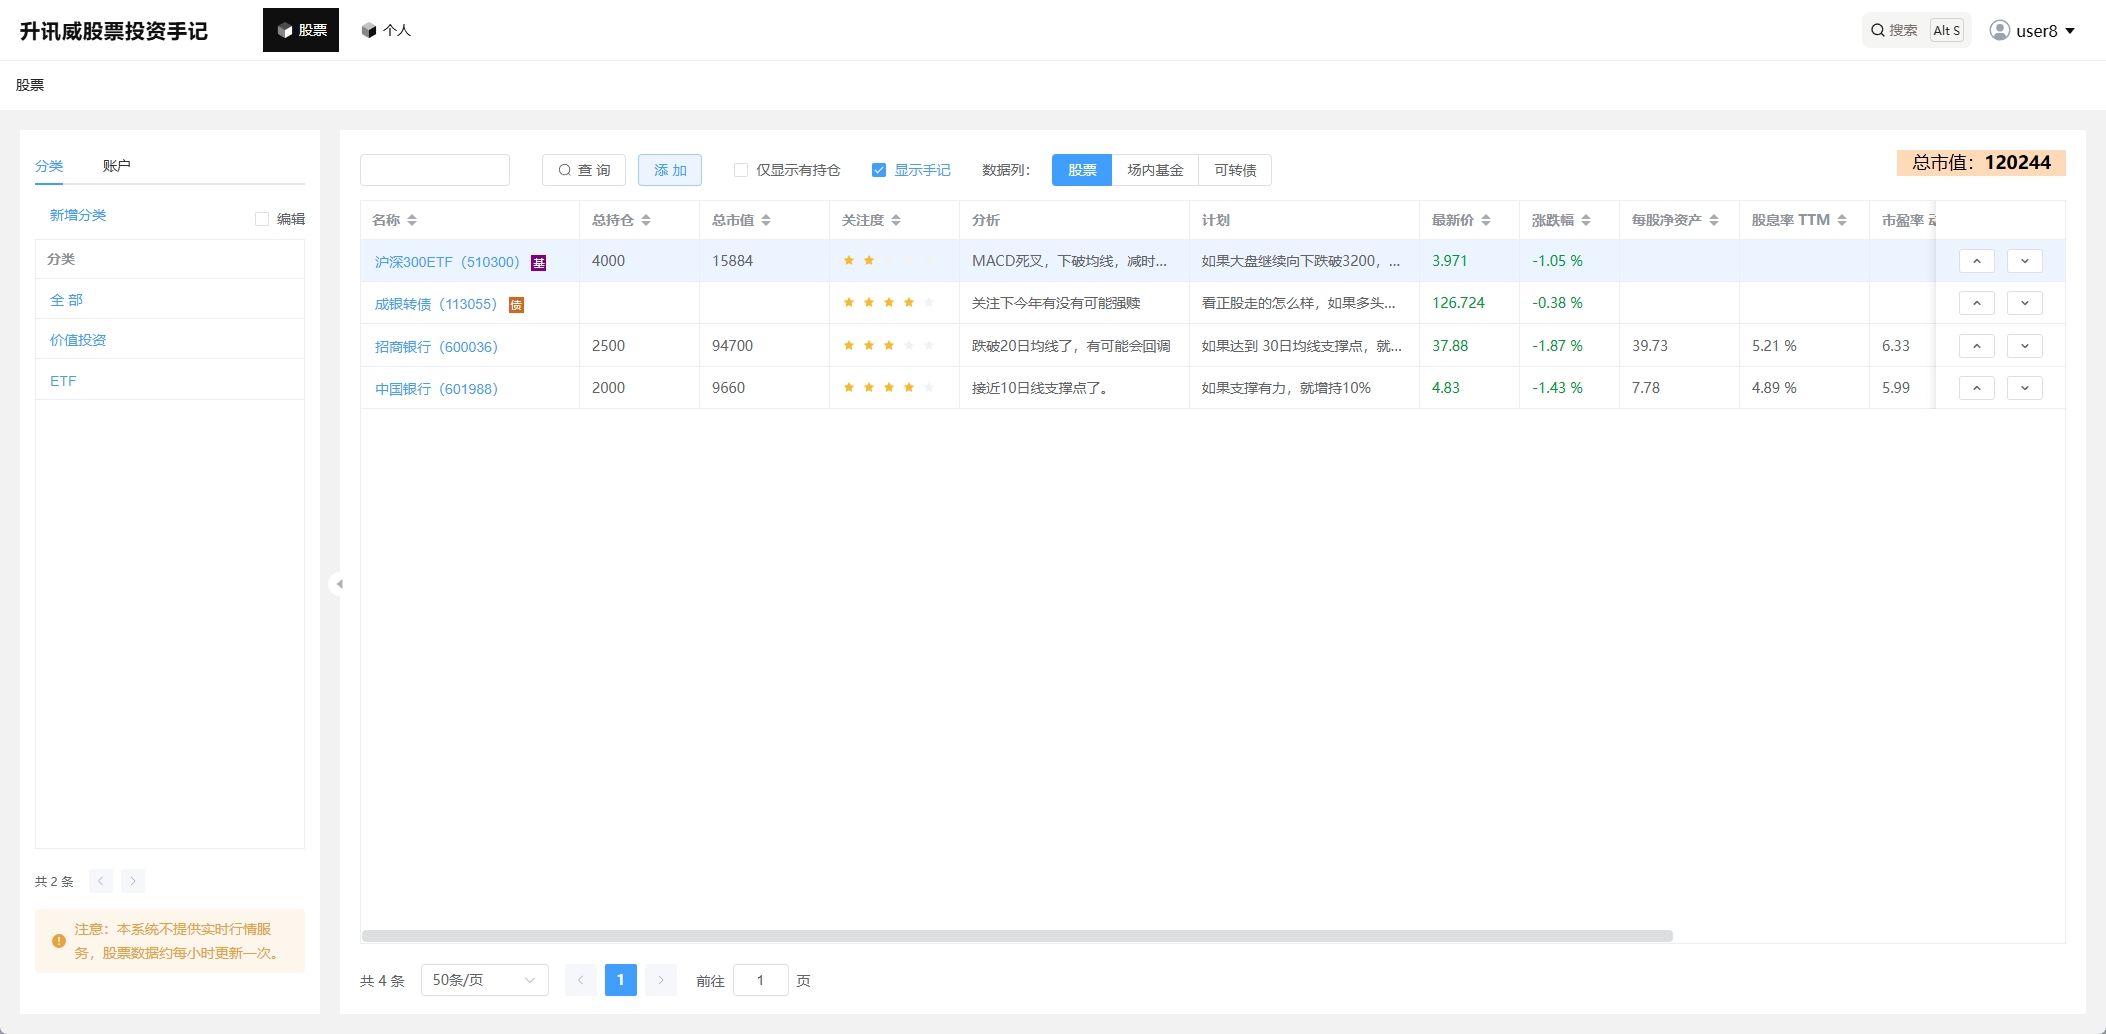
最近给一个私募大佬帮忙做了一些股票交易有关的系统,其中涉及到行情数据抓取的问题,一番摸索之后,把成果在这里做个分享。我把行情抓取的部分,和一个写手记的小功能,单独拿了出来放在一个小系统里面,可以免费使用
爬虫,又称为网络爬虫或网页爬虫,是一种自动浏览互联网的程序,它按照一定的算法顺序访问网页,并从中提取有用信息。用户代理(User-Agent):模拟浏览器访问,避免被网站识别为机器人。请求处理:发送HTTP请求,获取网页内容。内容解析:使用正则表达式或DOM解析技术提取所需数据。数据存储:将提取的数据保存到数据库或文件中。错误处理:处理请求超时、服务器拒绝等异常情况。爬虫软件是一个强大的工具,能够
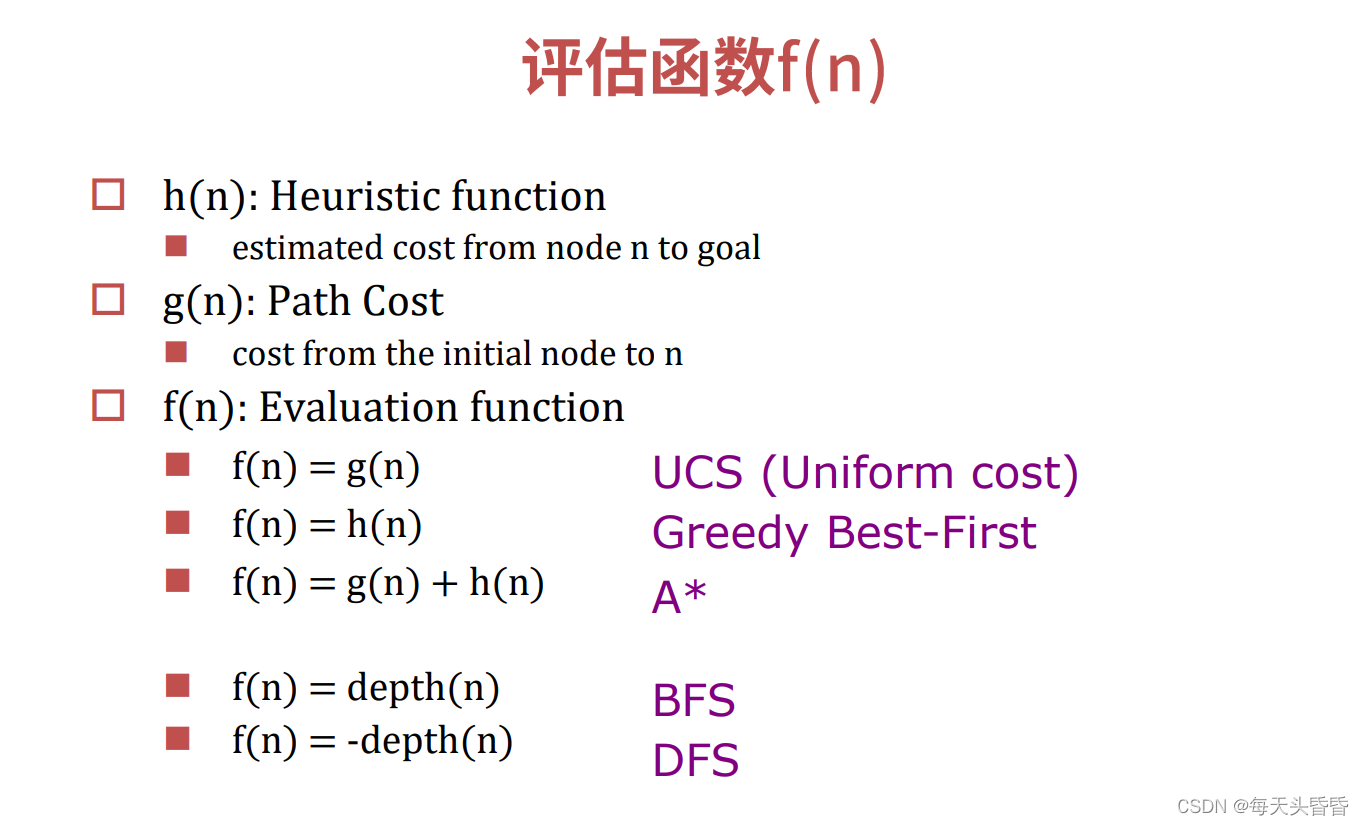
进化算法(evolutionary algorithm)可以看作随机束搜索的变体,算法的动机明显来自生物学中自然选择的隐喻:一个由个体(状态)组成的种群,其中最适应环境(值最高)的个体可以生成后代(后继状态)来繁衍下一代,这个过程被称为重组(recombination)。然而,使用一个好的启发式函数,复杂性可以大大降低,对于某些问题可以达到O(bm)。在每次迭代中,它都会做出在当前看来最优的(即可
最近公司有数据爬取的业务,我在网上看了好多文章,对于htmlutil技术栈介绍的文章都比较零散,自己做的时候分不清每种类对应的前端标签,所以准备分享一下这方面的知识!话不多说,上正文
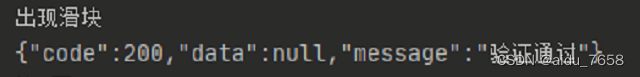
利用python第三方库过抖音小店后台滑块
将整数字段从默认的int64转换为int32或int16,浮点字段从float64转换为float32,可以节省大量内存。使用pd.read_csv()时设置chunksize参数,可以迭代处理数据块,避免一次性加载所有数据导致内存不足。与CSV相比,Parquet和Feather格式具有更快的读写速度和更小的文件尺寸,特别适合大数据场景。将数据导入SQL数据库,利用SQL的索引和查询优化功能处理
本文探讨如何不依赖高等数学构建机器学习模型,通过试错法揭示数据科学本质。从概率累积现象切入,以丙烷罐泄漏为例展示指数衰减模型。重点介绍爬山算法:通过随机变异和贪心选择优化参数,用标准正态分布平衡微调与跳变。实战部分演示徒手实现线性回归(15万次迭代优化参数)和逻辑回归(处理分类问题),强调最大似然估计的思想转变。最终指出机器学习是算力与智慧的平衡,打破传统数学壁垒,为初学者提供全新学习路径。
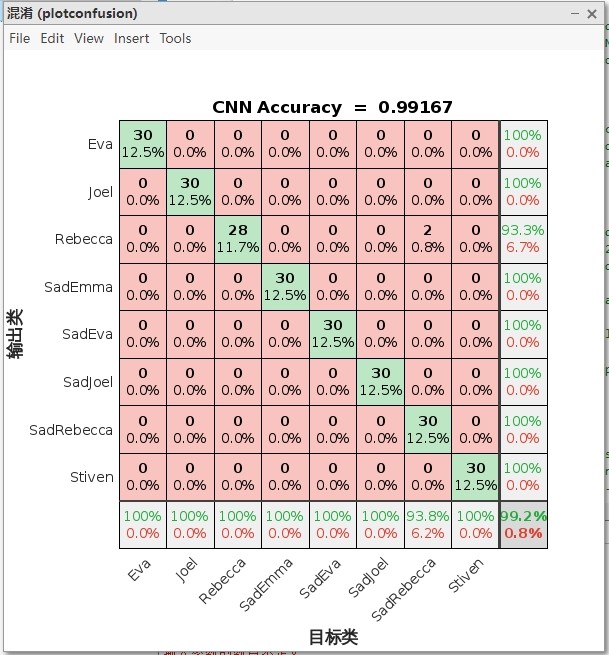
整体来说,蜜蜂CNN模糊进化深度学习算法结合了多种技术,在人脸识别上展现出了很好的潜力,感兴趣的小伙伴可以一起研究研究,说不定能挖掘出更多有趣的应用呢。就像前面说的,如果每个类样本数量变化了,这个值得跟着改。最后,CNN网络权重(来自全连接层)使用蜜蜂算法训练,以自然启发的方式进行拟合(这里是蜜蜂的行为)。最后,CNN网络权重(来自全连接层)使用蜜蜂算法训练,以自然启发的方式进行拟合(这里是蜜蜂的
该文分析深圳航空网站的反爬虫Cookie机制,重点解析x-s3-sid、x-s3-tid和x-s3-s4e三个Cookie的生成逻辑。作者使用浏览器开发者工具结合AntiDebug Breaker插件进行Hook调试,发现x-s3-sid由服务器直接返回,而x-s3-tid通过前端JavaScript混淆代码动态生成。通过断点调试和代码解混淆,还原了其构造过程:提取特定字符拼接成"x-s3-tid
在人工智能和机器学习领域,优化算法是提升模型性能的核心手段。传统爬山算法作为一种经典的局部搜索策略,因其简单高效而被广泛应用,但其容易陷入局部最优解、依赖单一目标函数的局限性也日益凸显。为了解决这一问题,一种结合了系统化评估体系的优化新思路应运而生。该技术通过引入多维度、可解释的评估指标(如任务成功率、安全合规性、响应自然度等),为优化过程提供更丰富的梯度信息和方向指引,从而引导算法在复杂的策略空
在AI智能体(Agent)开发中,如何确保其可靠、高效地完成复杂任务是一个核心挑战。这涉及到对Agent行为的引导、控制与评估,其原理在于通过工程化框架为AI提供稳定的任务执行路径与决策支持。从技术价值看,一套系统的控制策略能显著提升Agent的可靠性、可预测性与任务完成率,是智能体实现实际应用的关键。其应用场景广泛覆盖代码生成、数据分析、自动化流程处理等需要多步骤推理的领域。本文聚焦的“Harn
本文探讨了利用AI技术解决Python爬虫IP封禁问题的方法。传统代理池管理存在效率低、易识别等缺陷,而AI辅助工具如ProxyPoolAI能通过智能代理筛选、动态更新和失效预警提升爬虫成功率。解决方案包含三大模块:AI驱动的代理管理工具选型、基于日志分析的封禁识别,以及自动生成代理切换与失效检测代码。实测表明,该框架可将中断率降低60%,代理成本减少30%。未来可结合深度学习预测反爬策略变化,并
实例化类,然后直接运行run()方法就好。
合理的线程生命周期管理是并发编程的基础,需要确保线程的正确启动、同步和资源释放,避免僵尸线程或资源泄漏的问题。现代C++中可以通过结合std::thread、std::mutex和std::condition_variable等组件实现高效的线程池,有效减少线程创建销毁的开销并提高任务执行效率。std::mutex是最基本的互斥量类型,但现代C++还提供了更细粒度的锁类型,如std::shared
/ 异步处理响应 client.newCall(request).enqueue(new Callback() { @Override public void onResponse(Call call, Response response) { if (response.isSuccessful()) { String jsonData = response.body().string();在构建
简单来说:接口格式兼容 OpenAI 官方 SDK。这种调用方式:第三方接口也能直接使用。如果本身就在使用:OpenAI SDKCursorDifyOpenWebUI其实迁移到 OpenAI-Compatible API 的成本非常低。base_url=即可完成兼容。对于 AI Workflow 场景来说,统一接口确实会方便很多。
这一限制给NDK接口对接带来了诸多不便:开发者必须将组件创建任务通过任务队列提交至UI线程,不仅增加了开发复杂度,更关键的是,当需要动态创建大量组件时,所有任务会堆积在单一UI线程中串行执行。系统线程池(4个)和自定义线程(2个,分别异步/同步挂载)并行创建Button组件,组件创建完成后自动挂载到UI主树,页面显示带有“系统框架线程”、“用户线程1”、“用户线程2”标签的Button;非多线程组
新人来问我,我能告诉他“这个条款三年前改过一次,原因是当时吃了官司”。DeepSeek给了我语言理解能力,公司的知识图谱给了我专业判断力。合在一起,我不只会找问题,还能说清楚“问题在哪、怎么改、为什么这样改”。法务老大没直接批我,而是把修改逻辑录进去,告诉我“下次遇到类似情况,这样处理更好”。法务每次修改文本,我都知道改了哪里、为什么改、最后怎么定的。这些“为什么”积累起来,成了我能教给下一个人的
在404的位置,上传你刚才做好的404.html文件,或者填好文件路径。不然不仅访客体验差,搜索引擎也会觉得你网站乱糟糟的,影响收录。我之前图省事弄过,结果被搜索引擎判定为违规跳转,收录掉了不少。我当时就写了一句“页面走丢啦,点击返回首页”,再加个链接。如果还是显示服务器的报错页面,就回去检查文件路径和权限。我第一次就是路径填错了,弄了半天还是默认报错,白忙活。后来花了点时间研究,踩了几个坑,给你
摘要: 面对2026年AI驱动的立体化反爬技术(如TLS指纹、前端行为分析、动态验证码),传统爬虫手段已失效。本文提出基于YOLOv8的目标检测方案,通过标注数据集、训练定制模型(识别率超90%),并集成到爬虫流程中,高效破解复杂验证码。同时强调需结合行为模拟(如随机延迟、自然鼠标轨迹)和指纹隐藏(使用Playwright)绕过前端监测。最终指出,AI定制化破解与合规操作是未来反反爬的核心方向,技
如果目标网站的验证码字体、大小、位置都固定,可以用 OpenCV 的模板匹配。掌握这些方法,是为了更好地理解攻防原理,从而构建更健壮的系统,或者在合法授权下进行安全测试。如果你有几百张标注好的验证码数据,可以自己搭一个简单的卷积神经网络(CNN)。无论是点选验证码里的多个图标,还是滑块验证码里的缺口和滑块,YOLO都能精准定位。是国内开发者开源的神器,集成了多种识别模型,对中文、算术题、简单滑块都
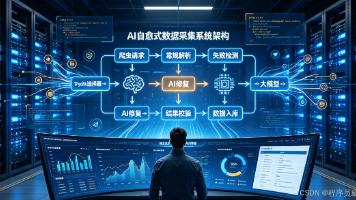
用了半年自愈方案,最大的感受是:它没有消灭运维工作,而是把“紧急救火”变成了“计划性维护”。工程师不用再半夜改代码,只需要每周花一小时复核AI修复的规则,优化Prompt和校验逻辑。别追求100%自愈率。初期能达到70%就很有价值,剩下30%复杂场景留给人工,逐步迭代比一步到位更靠谱。优先复用已有资产。历史解析规则、数据校验函数都是宝贵素材,喂给大模型比从零训练效果好得多。严格遵守合规底线。自愈只
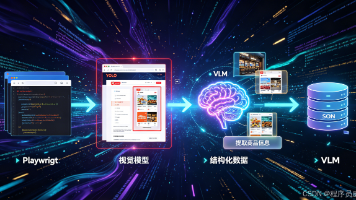
本文介绍了一种基于GPT-4o的自然语言数据采集方案,旨在替代传统爬虫中繁琐的规则维护工作。作者分享了工程落地的关键步骤:通过Playwright渲染页面并截图,用结构化Prompt引导GPT-4o进行语义解析,再通过Pydantic校验输出。文章重点剖析了三个实践难题(模型幻觉、长列表漏采、成本控制)的解决方案,并给出分级处理架构图。该方案在作者业务场景中显著降低了维护成本,但强调需权衡响应速度
本文系统梳理了2026年数据采集技术的分层体系与选型策略。文章提出四个关键层级:基础层(requests+lxml)、渲染层(playwright)、智能辅助层(YOLO模型)和语义层(大模型),并给出各层的适用场景、代码示例和避坑指南。作者强调技术选型应遵循"能用简单不用复杂"的核心原则,通过分层决策流程图演示如何根据场景特点选择最优方案。最后指出工程师的核心竞争力在于精准匹配问题与工具的能力,
这套自适应工具上线后,页面改版导致的采集中断时长下降了85%,运维从“半夜救火”变成了“每周复盘”。别追求全自动。初期AI修复成功率70%就很有价值,剩下30%复杂场景留给人工迭代,逐步优化比一步到位更靠谱。优先复用历史资产。旧解析规则、校验函数、标注数据都是宝贵素材,喂给AI比从零开始效果好十倍。性能与智能要平衡。95%的请求走传统解析,只有5%触发AI,这才是能上生产的方案。全量AI调用只适合
本文介绍了一种基于AI Agent的零规则数据采集方案,通过语义理解替代传统爬虫的硬编码规则。方案采用YOLO模型检测页面区块,再结合视觉语言模型(VLM)进行语义提取,实现无需维护XPath/CSS选择器的数据采集。文章详细拆解了技术实现路径,包括页面渲染、区块裁剪、Prompt工程和数据处理流程,并总结了实际落地中的三大挑战(模型幻觉、长列表漏采、显存不足)及其解决方案。该方案在业务场景中验证
本文分享了如何将Python爬虫性能从100请求/秒优化到10000+请求/秒的实战经验。作者通过逐步优化实现了性能的显著提升:首先进行基础优化(禁用日志、复用连接池)使性能提升3倍;然后重构为异步爬虫(使用aiohttp+信号量控制并发)达到2000请求/秒;接着通过内存优化(对象池/流式处理)提升到3500请求/秒;最后采用多进程+异步混合和分布式架构(Redis任务队列)突破10000请求/
摘要:AI赋能的爬虫开发新范式 本文分享了作者使用DeepSeek V3进行爬虫开发的实战经验。通过对比测试,DeepSeek在爬虫开发领域展现出78%的一次生成成功率、优秀的中文反爬理解能力和极高性价比等优势。文章提出了完整的AI爬虫工作流,强调"AI生成+人类验证"的协作模式,并分享了三种Prompt模板:基础爬虫、反爬处理和分布式爬虫模板。通过电商评论爬取的实战案例,展示
爬山算法
——爬山算法
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 乐奇 Rokid 开放社区

 天工造物局
 DAMO开发者矩阵









 码道开发者社区
 亚马逊云科技技术品牌专区


 AI Agent技术社区
 HarmonyOS开发者社区
 CSDN-OPC开发者社区
 openEuler 社区
 AtomGit开源社区
 DeepSeek技术社区