登录社区云,与社区用户共同成长
邀请您加入社区
工业现场最怕“低频故障”:一年才出两三回,回回都是新症状。用 ChatGPT 直接问?它只会给你“通用答案”。用传统 RAG?先请老师傅把 10 年维修记录“标注”一遍,成本直接劝退。中南大学+哈工大团队最新发表在《Advanced Engineering Informatics》的研究,把“强化学习”塞进 RAG:不标数据、不调 LLM,只靠一个“游走”智能体,在维修日志里自己找答案。实测结果:
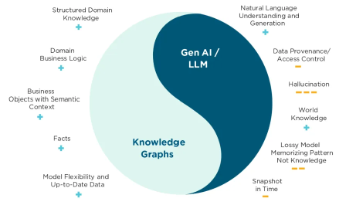
GraphRAG通过引入知识图谱将非结构化数据转化为结构化认知,解决了传统RAG在处理复杂关系时的瓶颈。它实现了多跳推理、全局摘要和可解释性溯源三大技术飞跃,使大模型从"搜索数据"升级为具备"推理洞察"的智能系统,为企业AI应用提供了更强大的认知能力,虽面临构建成本和维护挑战,但代表了大模型知识增强的重要方向。
本文详细介绍了如何使用RAG技术构建企业级问答系统,从基础实现(文档切分、向量化、检索)开始,逐步引入评测体系、总结索引、重排序等优化技术,并通过量化指标驱动系统迭代。文章提供了完整的工程实现方法和可复用的模式,帮助读者建立"先度量后优化"的系统优化思维,最终实现高准确率的企业级问答解决方案。
文章深入探讨了嵌入模型在RAG系统中的核心作用,系统介绍了词嵌入、句嵌入、文档嵌入等类型及其适用场景,并解析了上下文窗口、分词方式、维度等关键参数。通过医疗论文检索实例,演示了如何根据实际需求选择合适嵌入模型,并介绍了MTEB基准测试工具的使用方法。文章强调,选择嵌入模型应超越单纯依赖评分,而应综合考虑应用场景、语言支持、专业词汇处理能力等实际因素。
本文介绍了RAG(检索增强生成)技术,它通过外部知识库动态补充信息,提升大语言模型回答的准确性和时效性。文章详细讲解了使用Spring AI框架实现基于本地知识库的AI问答系统,包括环境准备、依赖引入、文档处理、向量转换存储、查询增强等关键步骤。通过具体的代码示例,展示了如何构建和测试一个能够基于特定文档回答问题的AI助手系统,有效解决了传统LLM可能产生的"幻觉"或过时回答问题。
bRAG-langchain是一个专注于LangChain框架下RAG技术的开源学习项目,通过一系列结构化的Jupyter Notebooks提供从入门到精通的学习路径。项目涵盖RAG基础架构、多查询检索、智能路由、高级索引和重排序等核心技术,帮助开发者构建高效、智能的RAG系统。它不仅提供可运行代码示例,还提供清晰的学习路径,是开发者掌握RAG技术的宝贵资源。
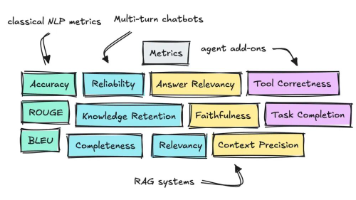
本文探讨了Agentic AI的评估方法,重点介绍了大语言模型(LLM)应用在多轮对话、检索增强生成(RAG)和智能体(Agent)场景下的评估指标与工具。传统NLP任务依赖准确率、BLEU等指标,而现代LLM应用更依赖语义评估和LLM-as-a-judge模式。多轮对话需关注相关性、知识留存等指标;RAG系统需分别评估检索(如Precision@k)和生成环节;智能体则需测试任务完成度和工具调用
Spring AI 驱动的企业级 RAG 系统:从技术原理到落地实践,一文看懂!
检索增强生成系统(RAG)正从早期“检索+生成”的简单拼接,走向融合 **自适应知识组织**、**多轮推理**、**动态检索** 的复杂知识系统(典型代表如 *DeepResearch*、*Search-o1*)。但这种复杂度的提升,使科研人员在 **方法复现**、**快速迭代新想法** 时,面临着高昂的工程实现成本。
本文详解大模型生态五大核心技术:MCP(连接外部世界的接口)、Agent(智能执行体)、RAG(检索增强生成,解决幻觉问题)、RPA(自动化执行者)和A2A(智能体间协作协议)。这些技术共同构建了更智能、高效的AI应用体系,推动AI向"能理解、会思考、可行动"的通用人工智能迈进。文末提供系统学习资源,帮助读者从零入门到实战掌握大模型技术。
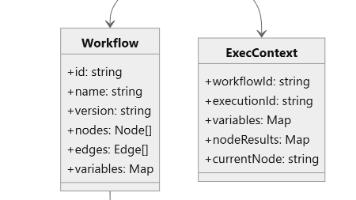
Dify是集"工作流引擎+RAG管道+代理系统+模型与工具生态+观测与运维"于一体的生产级大模型应用平台。采用微服务架构,通过可视化方式实现AI应用开发,包含完整的RAG处理流程、智能代理系统和工具集成生态。平台强调可观测性、可回放性和可扩展性,提供规范化的节点管理、上下文控制与数据流管理,帮助企业以工程化方式可靠落地大模型应用。
本文分享了使用Milvus搭建RAG服务的实战经验,包括云端数据库选择、创建Collection、字段设计、索引设置、数据插入和查询等关键步骤。作者强调应根据项目实际需求决定是否采用RAG,适用于严肃场合或大模型无知领域,而非所有场景都需RAG。提供了清晰的界面操作和API调用方法,帮助读者快速搭建RAG原型。
你是否想过,如何让多个AI“专家”协同完成一项任务?今天,我们将使用Python和功能强大的LangChain框架搭建一个小型AI智能体团队。我们的目标是创建一个具备以下功能的系统:
我们首先要明确一个概念,即智能体是基于大模型应用设计的一套机制,其本质是大模型提供的函数调用功能(function call),包括现在的MCP服务;而框架只是对这些原生能力的封装,便于开发人员进行功能开发,而不用去处理太多细节性问题。
本文详细介绍LangSmith在LangChain应用中的调试与追踪功能,展示如何评估RAG系统性能,以及使用LangServe快速部署API服务。同时涵盖生产环境中的监控与日志管理,帮助开发者实现从开发到部署的全生命周期管理,代码已开源在GitHub。
本文介绍了企业级RAG系统的完整实施框架,强调其价值在于"先取证、再生成、可追责"。文章详细阐述了五大核心工程:构建权威来源目录、实现句级来源标注、建立可信度评分机制、设计可运维的RAG流水线,以及建立持续评测与运营体系。这套方案帮助企业构建可信、可追溯的答案供应链,将RAG从概念转化为生产力,确保AI回答的权威性、可追溯性和可信度。
【值得收藏】一文读懂LightRAG:大模型检索增强生成的架构设计与实现指南
EmbeddingGemma是Google发布的开源小规模多语言文本嵌入模型,旨在常见设备(如手机、笔记本、台式机)上高效运行,同时在 MTEB / MMTEB 等评测任务中保持与同类模型竞争的性能。其核心价值在于:支持离线运行、保护隐私、内存占用小、兼容多种推理框架,并提供灵活的输出维度。
Meta提出的REFRAG框架针对RAG系统处理长上下文时的延迟高和内存贵问题,利用RAG的块对角注意力稀疏性,通过"压缩-感知-扩展"三步走方式,无需修改LLM结构即可实现高效解码。该框架采用课程学习和强化学习进行训练,实验结果显示可实现30倍TTFT加速和16倍上下文外推,在相同延迟预算下准确率提升1.22%(强检索)与1.93%(弱检索),显著优于传统方法。
本文深入探讨RAG系统中数据解析的关键作用,指出基础加载器如PyPDFLoader的局限性,提出分层解析策略:基础层(Unstructured.io)、高效层(MarkItDown、PyMuPDF4LLM)和攻坚层(Marker、MinerU等)。详细介绍了表格、图像及图文混合的处理方案,提供可扩展解析管道实现,并展望多模态化、知识图谱增强等未来方向,助开发者构建高质量RAG系统。
检索增强生成(RAG)自 2020 年 Meta “DPR+T5” 论文起,已从“外挂知识库”演进到“可编程、可解释、可审计”的复杂系统。然而,领域缺乏一份PRISMA 级的系统性综述来梳理:
本文介绍了本地部署私有化知识库的解决方案,通过Dify应用框架整合DeepSeek-R1大模型实现技术文档的智能检索。方案优势包括:1)提供媲美商业模型的交互体验;2)完全离线运行保障数据安全;3)符合企业合规要求。部署步骤包括:安装Docker和ollama→下载DeepSeek-R1模型→配置Dify框架→构建知识库和智能体应用。文章还分享了AI大模型学习路径,包含提示词工程、RAG系统开发等
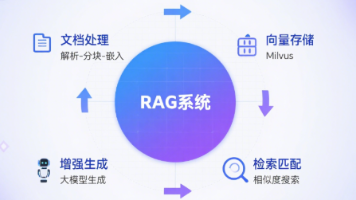
RAG(Retrieval-Augmented Generation,检索增强生成)是一种结合查找信息和生成答案能力的 AI 技术。