登录社区云,与社区用户共同成长
邀请您加入社区
这篇论文对普通读者的意义不在于又造了一个新 RAG——它直接戳破了"RAG 就是 AI 记忆"这个默认认知。OpenAI 的 Dreaming 在 2026 年 6 月上线了后台合成记忆,方便但用户既不能检查、不能控制、也无法带走。MOSS 走的是另一条路:因为记忆结构是标准 SQL、语料是纯文本,整个系统可以无变换地迁移——跨云、进入国家云区域、落到笔记本上。记忆这件事,可能从一开始就不该交给
这两天整体就是期末周夹着面试准备一起往前走。数据库书本内容复习完了,顺便过了一遍事务和隔离级别;算法开始做栈专题,三道题都比较基础,但能帮我重新理解栈和队列的特性;数值计算刚开始复习,确实有点难。现在比较焦虑的是项目没时间看,尤其是 RAG 项目之前没有真正吃透。后面如果还有时间,我想把项目按“链路、核心问题、可优化点、面试怎么讲”重新整理一遍。期末周先活下来,项目和简历等考试结束后再集中补。
Graphiti创新性地解决了AI记忆的结构化问题,超越了传统RAG的检索式思维。其核心在于构建时序知识图谱,通过双时态数据模型追踪信息的时效性,而非简单存储数据。系统包含Episode、Entity、Edge三大要素,支持实体去重合并和关系时效标记。Graphiti采用三层混合检索机制(关键词+向量+图遍历),并引入社区发现功能自动聚类相关话题。其Saga设计能串联相关事件形成故事线。相比传统方
GraphRAG通过引入知识图谱将非结构化数据转化为结构化认知,解决了传统RAG在处理复杂关系时的瓶颈。它实现了多跳推理、全局摘要和可解释性溯源三大技术飞跃,使大模型从"搜索数据"升级为具备"推理洞察"的智能系统,为企业AI应用提供了更强大的认知能力,虽面临构建成本和维护挑战,但代表了大模型知识增强的重要方向。
MySQL 的核心灵活性之一就是可插拔式存储引擎(Storage Engine)。每个表可以选择不同的引擎,来决定底层的数据组织、索引结构与事务特性。但在实际项目中,几乎所有面试官都会问:“InnoDB 和 MyISAM 有什么区别?为什么 InnoDB 是默认引擎?因为它直接体现你是否真正理解数据库的事务、锁、恢复机制与索引存储方式。InnoDB 和 MyISAM 的区别,不仅是“事务 vs 非
本文对比分析了深度搜索(Deep Search)与检索增强生成(RAG)两大技术。深度搜索是传统搜索与AI的结合,侧重于基于语义的精准检索,输出搜索结果列表;而RAG则侧重于根据检索结果增强大模型生成能力,直接输出自然语言回答。两者目标相似但技术路径不同,深度搜索可作为RAG的检索模块,共同应用于搜索引擎、智能客服等场景,是互补而非替代的技术范式。
想象一下,你在做金融RAG项目。 你的知识库不是几篇网页文章,而是成堆的 PDF、PPT、扫描件、Excel、合同。这些文件内容格式复杂:
本文记录了实现全屏可拖动滑动侧边栏时遇到的两个核心问题及解决方案。首先针对enableEdgeToEdge导致的渲染不全问题,分析了View渲染机制,提出两种解决方法:使用fitsSystemWindows属性或通过添加透明TopView动态调整布局。其次利用反射技术突破DrawerLayout限制,通过运行时修改私有ViewDragHelper参数,实现了自定义拖动范围控制(全屏/半屏/自定义距
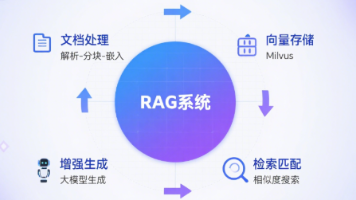
Spring AI 驱动的企业级 RAG 系统:从技术原理到落地实践,一文看懂!
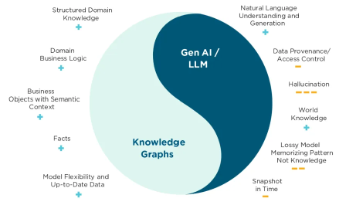
本文探讨知识图谱结合大语言模型在法规合规领域的应用价值,以欧盟数字运营韧性法案(DORA)为案例,展示GraphRAG技术如何通过消除幻觉风险、提供可解释的合规指导,显著提升法律专业人士和领域专家的工作效率。
本文提出了一种将Word试卷中的数学公式转换为LaTeX格式并保持位置准确性的解决方案。通过POI读取Word文件,遍历XWPFParagraph段落获取XML文本,使用DOM解析器定位oMath节点,将数学公式转换为LaTeX格式后替换原节点内容,最后重新生成Word文档。该方法解决了公式转换过程中出现的顺序错乱问题,实现了试卷内容从非结构化到结构化的转换。文中详细介绍了处理流程,包括XML解析
文章讲述传统后端/系统工程师如何转型进入AI大模型领域。通过展示技术栈迁移、RAG系统构建、模型微调和生产化落地的实践,强调工程思维在AI领域的应用价值。分享了三大生存法则:拒绝算法洁癖、构建监控矩阵和锻炼抽象能力。文章指出,掌握工程化落地的工程师正在重构智能世界的基础架构,传统开发技能与AI技术的融合是未来关键。
本文分享了使用Milvus搭建RAG服务的实战经验,包括云端数据库选择、创建Collection、字段设计、索引设置、数据插入和查询等关键步骤。作者强调应根据项目实际需求决定是否采用RAG,适用于严肃场合或大模型无知领域,而非所有场景都需RAG。提供了清晰的界面操作和API调用方法,帮助读者快速搭建RAG原型。
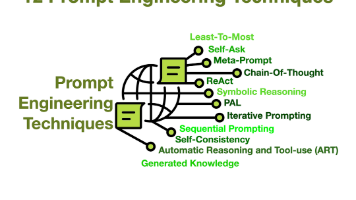
本文探讨了从Prompt Engineering到Context Engineering的关键转变,强调Context Engineering是构建高效AI Agent的核心学科。文章详细介绍了RAG作为基础架构,包括高级分块策略、重排序技术及"Lost in the Middle"问题解决方案,并探讨了智能体系统的上下文管理框架和工作流编排技术。Context Engineering作为连接LL
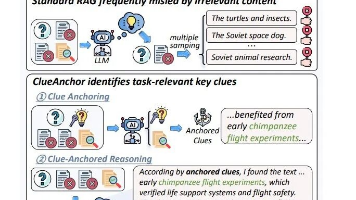
摘要:检索增强生成(Retrieval-Augmented Generation, RAG)借助外部知识增强大型语言模型(Large Language Models, LLMs)的能力,从而提升事实准确性。然而,现有 RAG 系统往往未能充分利用检索到的文档,无法提取并整合支持可靠且可解释推理所需的关键线索,尤其在相关证据隐含、分散或被噪声掩盖的场景中,这一问题更为突出。**为解决该问题,我们提出
在LLM驱动的知识检索增强(RAG)领域,主流方法面临困境:
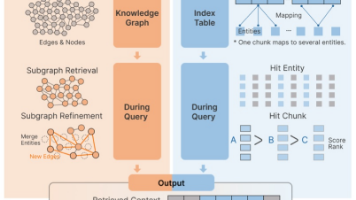
现有检索增强生成(RAG)系统存在两大局限:* **依赖扁平数据表示**:难以捕捉实体间复杂关系,导致回答碎片化(如无法关联“电动汽车”、“空气质量”、“公共交通”的相互影响)。* **缺乏上下文感知**:检索时难以整合多源信息的关联性,生成的回答可能遗漏关键依赖关系。
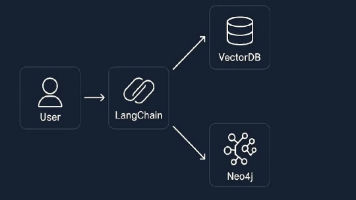
学习如何结合 Neo4j 知识图谱和 LangChain,打造精准、可解释、适合生产环境的 Retrieval-Augmented Generation (RAG) 系统。
但问题是,现在很多网站的结构变得越来越复杂,页面元素是动态加载的,还会频繁调整 HTML 结构,尤其是新闻类页面,隔三差五改一次版。这个任务也可以交给AI处理,我们先将结果复制下来,复制到任意的AI聊天窗口中,增加提示词:从上面的文本中提取新闻的标题、链接、所属板块、发布时间,将结果编写为一个json文件,格式为[{"title":?, "time":?, "topic":?采购成功后,我们会在我
RAG项目中的向量化实战:精准检索的核心技术 本文详细介绍了RAG(Retrieval-Augmented Generation)项目中实现精准文档检索的向量化技术。文章首先分析了传统关键词检索的局限性,如无法处理同义词、语义偏差和多语言问题。随后深入解析了向量化技术的核心原理:将文本转化为高维向量,使语义相似的文本在向量空间中更接近。通过具体代码示例展示了如何调用Embedding API实现文
“我的扣子智能体每天稳定运行,用户反馈也不错,但三个月了,还是不知道怎么变现......”这种消息,我每周都要收到几十条。回想去年此时,我和团队也遇到同样的问题。今天,我要分享的是我们陪伴1287名开发者实战总结出的六条变现路径,每一条都经过真实验证。