登录社区云,与社区用户共同成长
邀请您加入社区
文章摘要: Bright Data Scraper Studio提供两种爬虫工作模式:Code Worker(轻量HTTP协议)和Browser Worker(全浏览器模拟)。前者速度快、成本低,适合静态页面;后者支持JS渲染和交互,适用于动态网站。核心选型原则是优先尝试Code Worker,仅当数据不全时切换Browser Worker。针对多阶段任务(如列表页+详情页),推荐开启分段配置(W
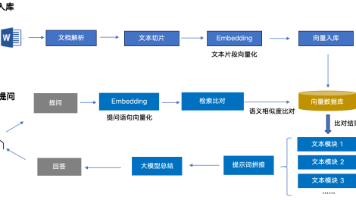
过去两年,做私有知识问答时,RAG 经常会成为那个默认答案:先建知识库,切 chunk,做 embedding,再把相关片段塞给模型。
长期做海外数据采集的开发从业者应该清楚,现阶段行业内并没有一套能够通吃全平台的采集解决方案。常规业务模式下,技术团队需要单独对接搜索、电商、社交不同赛道的抓取服务商,单独维护多套密钥、接口适配层、异常处理逻辑。这种碎片化的接入方式,不仅会拉高开发接入成本,后续运维、问题排查、版本迭代的隐性成本同样居高不下。近期Dataify推出一体化统一抓取API,官方核心卖点十分直白:过简单的 API 调用,即
① 文档处理“重切割、轻结构”,源头丢失语义;② 检索策略“单一化、无优化”,无法支撑工业级场景;③ 长文档处理“缺分层、少关联”,上下文完整性不足。针对这三大短板,以下“三板斧”解决方案可实现全链路语义保障。尼恩提示:要拿到 高薪offer, 或者 要进大厂,必须来点高大上、体系化、深度化的答案, 整点技术狠活儿。只要按照上面的 尼恩团队梳理的 方案去作答, 你的答案不是 100分,而是 120
RAG(检索增强生成)通过检索专业领域知识增强LLM回复质量,解决专业知识不足问题。完整流程包括数据清洗、chunk分块、Embedding嵌入、检索和生成。数据清洗确保知识质量;分块优化检索效率;Embedding将文本转为向量存入数据库;检索采用全文、向量或混合技术;最后结合用户问题与检索知识生成高质量回答。
本文介绍了RAG技术在大模型中的应用,包括其架构图、技术要点和适用场景。文章探讨了RAG技术的局限性,并提出数据库与RAG融合的最佳实践方案,通过强化大模型的SQL-Call能力处理精确计算和统计问题。对比了业界常见技术方法的优缺点,展示了如何利用RAG技术解决大模型在知识库应用中的挑战,为开发者提供实用的技术选型参考。
网易CodeWave作为国内首个全栈可视化开发平台,通过智能开发底座和NASL语言实现前后端一体化开发。本文以构建宝可梦图鉴应用为例,展示其核心能力:通过自然语言描述直接生成包含数据模型、API接口和前端页面的完整应用框架;通过可视化设计器快速完善UI交互(如卡片布局、属性标签)和复杂逻辑(如属性筛选);利用NASL语言统一描述前后端逻辑,自动编译为可运行代码。相比传统AI编码工具聚焦局部代码优化
但是我们也不能将所有文件都放入知识库中,而应区分文件是否与用户需求相关,判断它是针对某次具体需求,还是某一类需求都会涉及该文件。对于仅针对当前问题的一次性需求,应引导客户通过对话窗口上传文件并提问,接着利用插件解析文件内容,并将其放入 prompt 中。
想象一下,你在做金融RAG项目。 你的知识库不是几篇网页文章,而是成堆的 PDF、PPT、扫描件、Excel、合同。这些文件内容格式复杂:
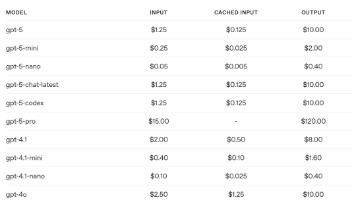
本文分享了企业级RAG系统的实战经验。作者基于在制药、金融等行业构建10余个RAG系统的实践,总结了关键挑战和解决方案:1)优先进行文档质量检测并分类处理;2)采用层级化分块策略替代固定分块;3)构建专业领域元数据架构;4)实施混合检索方法。文章详细介绍了文档评分系统、分层检索等技术实现,并对比了不同模型的成本效益(Qwen可节省85%成本)。核心观点认为企业RAG的成功70%依赖工程能力,20%
你是否曾梦想构建一个能自主规划、长期运行、完成复杂任务的 AI 智能代理?**DeepAgents 0.2** 来袭——为你解锁构建“深层智能体”的新方式!
作为一名和数据打交道的开发者,相信大家都经历过这些头疼时刻:自己写的爬虫跑得好好的,突然就因为IP被封而中断;面对JavaScript渲染的复杂页面,传统的请求-解析方式彻底失效;数据量一大,不仅速度慢,还动不动就程序崩溃。最近,我有机会深度体验了**亮数据(Bright Data)的爬虫API**(Crawl API),它宣称能一站式解决上述所有痛点。今天,就通过**这篇视频+图文的深度评测**