大厂RAG面试都在问什么?24道真题整理,悄悄练熟,现场拿捏面试官!
1、什么是检索增强生成(RAG)?
RAG(Retrieval-Augmented Generation,检索增强生成)是一种结合查找信息和生成答案能力的 AI 技术。
它由 Facebook 在 2020 年提出,主要用于问答、聊天机器人等需要大量知识的任务。
RAG 是一种结合“查资料”和“写答案”的技术。
它先从外部资料中找到相关信息,再用这些信息来生成更准确的回答。常用于问答系统、聊天机器人、内容创作等场景。
(一)RAG 的工作原理
核心思路是:
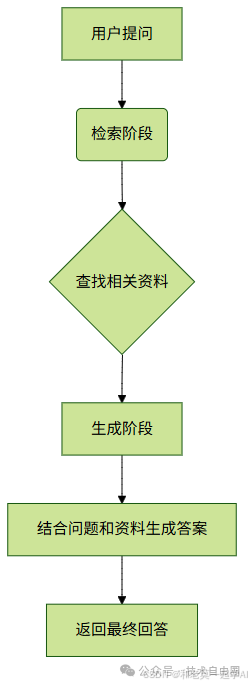
先查资料,再写答案
流程如下:
(1) 查找相关资料(检索)
用户提问后,系统会用一个“查资料工具”在知识库中找相关内容。
这个工具可以基于关键词、语义或向量匹配等方式搜索。
(2) 根据资料写答案(生成)
把用户的问题 + 查到的资料一起交给一个“写答案模型”。
模型根据这些信息写出最终回答。
(二)RAG 的优点
✅ 回答更真实,减少胡编乱造
✅ 知识可以随时更新,不用重新训练模型
✅ 回答有依据,更容易解释来源
✅ 特别适合专业领域,比如医疗、法律、教育等
(三)RAG 的常见用途
场景 举例
客服机器人 自动回答产品问题
医疗助手 结合医学资料提供建议
法律咨询 根据法规生成意见
教育辅导 解读教材内容
企业内部助手 快速查找公司文档并总结
(四)RAG 的流程图
Mermaid
(五)RAG 的不同版本
基础版 RAG:用密集向量检索 + 序列生成模型(如 T5)
混合 RAG:结合关键词检索(如 BM25)和向量检索(如 DPR)
进阶版 RAG:支持多轮检索、自我反思机制,提升准确性
(六)总结
RAG = 查资料 + 写答案
它让 AI 在回答问题时更有依据,特别适合需要准确性和时效性的任务。随着大模型的发展,RAG 成为了构建实用 AI 工具的重要技术之一。
2、你能解释RAG与传统语言模型之间的基本区别吗?
RAG(检索增强生成)和传统语言模型的最大不同,在于它们获取知识、更新知识以及使用知识的方式不一样。主要有三点:
知识从哪来
怎么更新知识
适合做什么事
(一)什么是传统语言模型?
像 GPT-2、GPT-3 这类模型是“纯生成式”的。
它们通过大量文本训练,把知识记在脑子里。你问问题时,它就靠自己记住的内容回答。
特点:
所有知识都存在模型里,不能查外部资料
模型训练完后,知识就不能变了
如果没学过某个知识点,可能会乱说(幻觉)
(二)什么是 RAG 模型?
RAG 是“先查资料,再回答”的模型。它有两个步骤:
(1) 查资料:根据你的问题,去数据库或网页中找相关信息
(2) 生成答案:结合查到的资料,生成一个准确的回答
特点:
可以查外部资料,比如维基百科、企业内部文档
想更新知识,只要改资料库就行,不用重新训练模型
回答基于真实信息,不容易出错
(三)主要区别总结
方面 传统模型 RAG 模型
知识来源 全靠模型自己学 查外部资料 + 模型生成
更新知识 要重新训练模型 只需更新资料库
准确性 容易编造或过时 更准确,因为查最新资料
灵活性 知识固定 支持多种资料源
适用场景 日常问答、写故事等 专业领域、客服、企业查询
(四)举个例子
比如你问:“2024年诺贝尔物理学奖是谁?”
传统模型:如果它没学过2024年的数据,可能瞎猜或说不知道。
RAG模型:会先去网上查“2024诺贝尔物理奖”,然后根据查到的结果回答。
总结一句话:
传统模型靠“脑中记忆”回答问题,RAG模型则是先查资料再回答,就像一个会查资料的助手。
🧠 核心流程图
3、RAG在人工智能中有哪些常见应用?
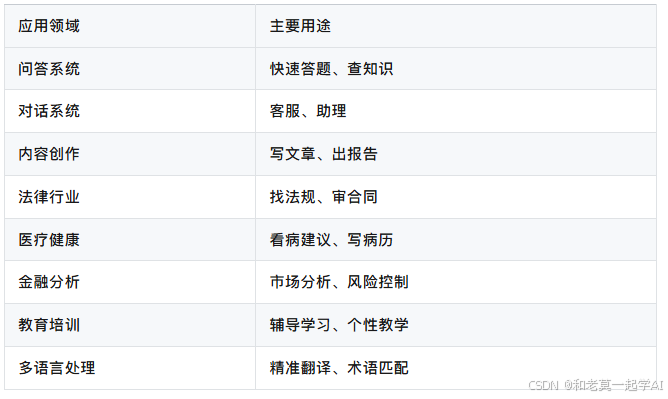
RAG 是一种结合“查资料”和“写内容”的技术。
它先从大量资料中找到相关信息,再根据这些信息生成回答或文本。这种技术在很多领域都有实际用途。
(1)问答系统
用途:用户提问题,系统自动查找答案。
例子:
智能客服
学生作业答疑
医疗健康咨询
(2)聊天机器人
用途:让聊天机器人回答时有依据,不乱说。
优点:
回答更真实可靠
知识可以随时更新,不用重新训练模型
例子:
公司客服机器人
虚拟导购助手
(3)写作辅助工具
用途:帮人快速找资料,然后写文章、报告、摘要等。
例子:
新闻稿写作助手
论文写作参考
商业分析报告生成
(4)法律与合规
用途:帮助查找法律条文、案例,生成合法建议。
优点:
查法条快又准
写文书更规范
例子:
法律文件起草
合规审查工具
(5)医疗与生命科学
用途:医生看病、开药、写病历时参考最新医学知识。
优点:
减少误诊
提高效率
例子:
医学问答助手
病历自动生成工具
(6)金融与投资
用途:根据市场数据、财报、新闻生成分析和预测。
例子:
自动生成财报摘要
投资建议推荐
风险预警系统
(7)教育与学习
用途:根据学生情况提供个性化学习内容和反馈。
例子:
智能辅导老师
自适应学习平台
自动批改作业并给建议
(8)多语言翻译
用途:翻译时结合行业术语,提高准确性。
例子:
行业专用词翻译
多语言文档本地化处理
核心流程图
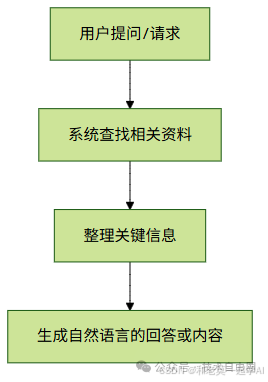
这个流程就是 RAG 的核心逻辑:先查资料,再生成内容。
如需了解某个具体领域的细节,也可以继续深入探讨。
4、RAG如何提高AI模型响应的准确性?
RAG(检索增强生成)是一种把“查资料”和“写答案”结合起来的技术。它能让AI在回答问题时,不只是靠自己记住的知识,还能去外面“查最新资料”,从而提高回答的准确性、相关性和时效性。
下面是 RAG如何让AI回答更准 的几个关键点:
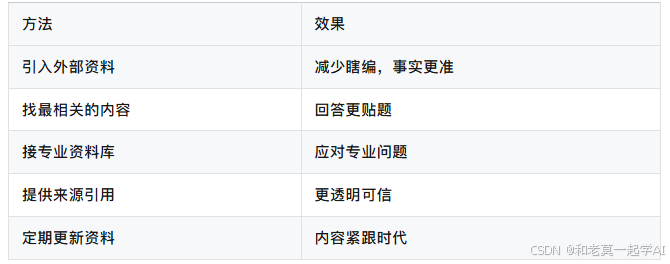
(1)查外部资料,减少瞎编
AI模型的知识是固定的,不能随时更新。
RAG会先从外部数据库中找到相关信息,再让AI根据这些新资料来生成答案。
这样可以避免AI因为知识过时或不全而乱说。
✅ 示例:
问“2024年诺贝尔物理学奖得主是谁?”
传统AI可能答错,RAG会先查最新资料,再给出正确答案。
(2)动态找最相关的资料,回答更有针对性
RAG会根据用户的问题,在大量文档中找出最相关的部分。
AI基于这些资料来回答,而不是只靠自己记的那点东西。
回答更贴切,不会泛泛而谈。
✅ 示例:
问“特斯拉最近自动驾驶有什么新进展?”
RAG会查官网、新闻稿等,然后生成具体回答。
(3)可以定制专业领域的知识库
在医疗、法律、金融等领域,通用AI的知识可能不够专业。
RAG可以接入特定领域的资料库(比如医学论文、法规文件),让AI也能处理专业问题。
✅ 示例:
医生问某种药的副作用,RAG可以从药品说明书中提取信息,给出可靠建议。
(4)答案有出处,更可信
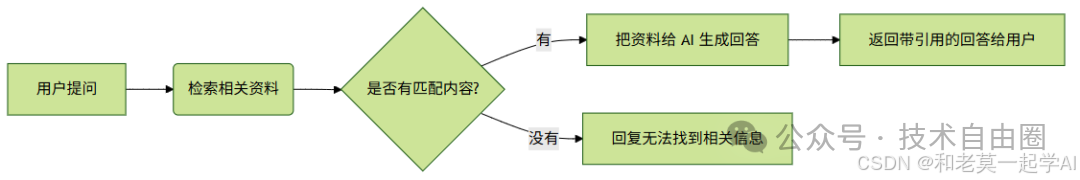
RAG生成的答案通常会带上来源链接或文档引用。
用户可以看到依据,判断是否可信。
比起传统AI“黑箱”式的回答,这种做法更透明。
✅ 示例:
回答中注明“根据世界卫生组织2024年的报告……”
(5)知识库可更新,内容不过时
外部资料可以定期更新,确保AI用的是最新的信息。
而普通AI一旦训练完成,知识就固定了。
总结:RAG提升回答质量的核心方法
5、RAG中检索模型的重要性是什么?
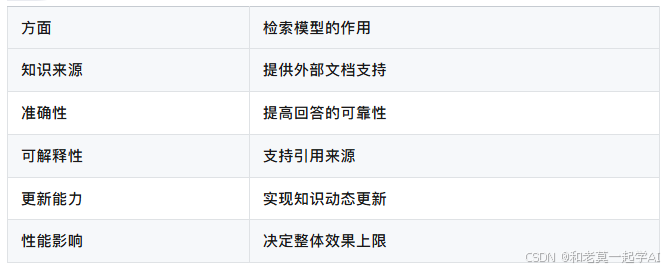
在 RAG(Retrieval-Augmented Generation,检索增强生成)系统中,检索模型就像一个“资料查找员”,它的任务是从外部知识库中快速找到和用户问题相关的信息,供后面的生成模型使用。以下是它为什么这么重要的几个原因:
(1)找对信息,才能答对问题
RAG 是把语言模型和外部知识结合起来。
检索模型负责从大量文档中找出最相关的几段话,确保回答有依据、不落伍。
✅ 举例:如果用户问“2024年诺贝尔物理学奖得主是谁?”,模型本身可能不知道,但检索模型能从最新资料里找到答案。
(2)让回答更靠谱,减少胡编乱造
语言模型有时会“瞎说”,而检索模型引入真实来源的内容,可以避免这种错误。
所有回答都可以查到出处,让人信得过。
(3)不用把所有知识都装进模型
不需要把所有知识都训练进模型里,而是用的时候临时查。
这样模型更轻便,更新知识也更容易(只要换文档库就行)。
(4)知识可以随时更新
外部文档库是可以随时修改的,所以新消息也能马上用上。
而传统模型的知识是固定的,只能重新训练才能更新。
(5)检索质量决定最终效果
如果检索模型没找对内容,生成模型也很难给出好答案。
所以,检索模型的好坏直接影响整个系统的水平。
小结:
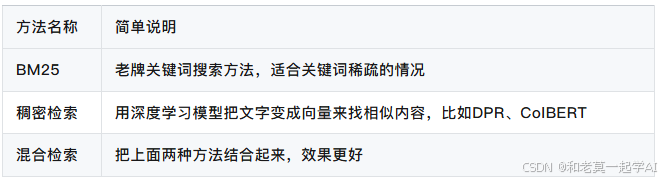
常见的检索方法:
BM25(传统关键词匹配)
Dense Retrieval(如 DPR, ColBERT,基于语义向量)
混合检索(结合关键词和语义)
如果你想知道怎么评估或优化检索模型的效果,也可以继续问我。
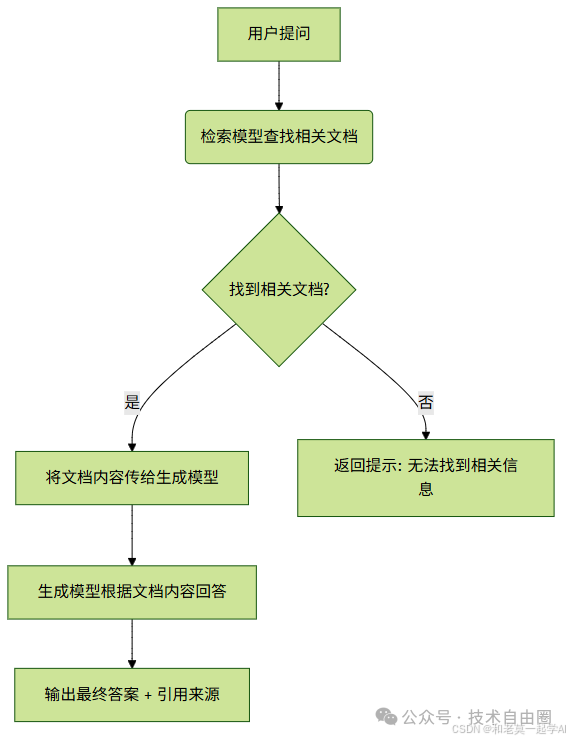
核心流程图
下面是一个简单的 图,展示 RAG 中检索模型的核心流程:
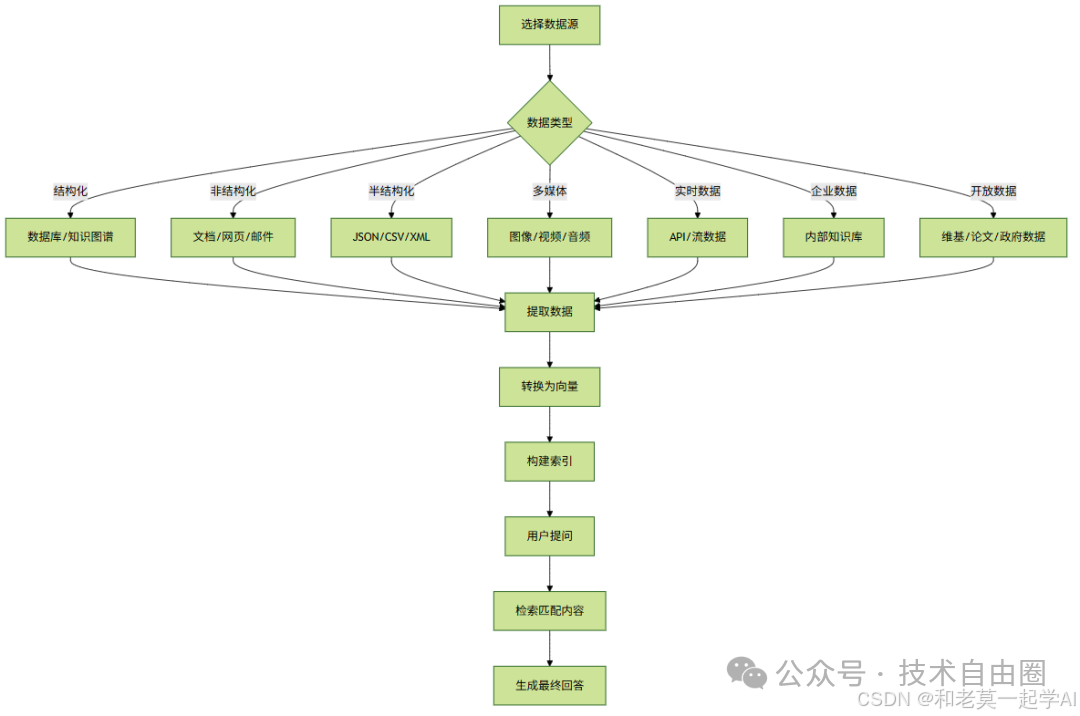
6、RAG系统通常使用哪些类型的数据源?
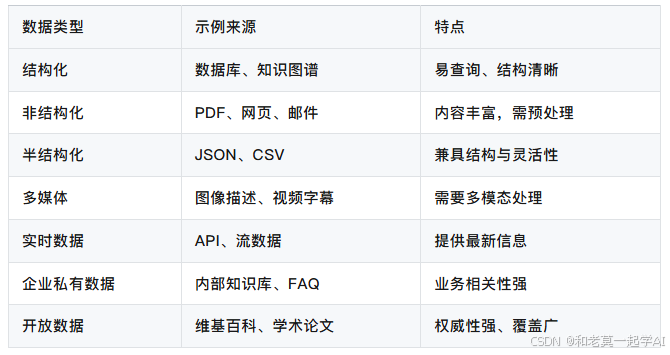
RAG(检索增强生成)是一种让AI回答更准确的方法。它不是只靠模型自己“记住”的知识,而是通过查找外部资料来补充信息。为了做到这一点,RAG可以使用多种不同类型的数据来源。下面是一些常见的类型:
(1)结构化数据
这类数据格式清晰,像表格一样有明确的列和行。
数据库(如MySQL、PostgreSQL)
数据仓库(如Snowflake)
知识图谱(如Wikidata)
比如:客户名单、产品库存表、订单记录等。
(2)非结构化数据
没有固定格式,比如文章、邮件、网页内容,需要处理后才能用。
PDF、Word文档
网页内容(爬虫抓取)
邮件、聊天记录
社交媒体帖子
比如:新闻稿、用户评论、公司白皮书等。
(3)半结构化数据
介于上面两者之间,有标签或分隔符,但不完全是表格。
JSON 文件
XML 文档
CSV 文件
比如:API返回的数据、日志文件、配置文件等。
(4)多媒体数据(需多模态支持)
包括图片、视频、音频等内容,通常要配合文字一起使用。
图片+说明文字
视频字幕
音频转成的文字
比如:图表说明、教学视频中的讲解词等。
(5)实时数据
用来获取最新信息,提升回答的时效性。
天气、股票、新闻API
实时消息流(如Kafka)
实时数据库(如Firebase)
比如:交通状况、股市行情等。
(6)企业内部数据
公司自己维护的知识库或文档系统。
内部知识平台(如Confluence)
常见问题库(FAQ)
公司政策手册、培训材料
比如:员工手册、客户服务记录等。
(7)公开数据
来自公共领域的权威资源,适合补充通用知识。
维基百科
学术论文网站(如arXiv)
政府开放数据、开源项目文档
比如:法律条文、科学事实、历史事件等。
总结:常见数据源一览表
核心流程图
7、RAG如何促进对话AI领域的发展?
RAG(检索增强生成)是一种结合“查资料”和“写答案”的新技术,它让聊天机器人变得更聪明、更实用。它不是靠自己“记住”所有知识,而是在回答问题前先去“查资料”,再根据查到的内容来组织语言。这种方式带来了不少好处:
(1)回答更准确、更新更快
怎么做:先从外部数据库或网页中找最新信息,再用这些信息生成答案。
好处:
不依赖训练时学到的老知识,能用最新的数据。
比如维基百科更新了,它也能马上知道。
(2)懂得更多、看得更深
怎么做:借助专业资料库,比如医学书、法律条文等。
好处:
能回答专业问题,比如看病、理财、打官司。
多轮对话也不容易跑题。
(3)更容易看懂它是怎么想的
怎么做:它的答案都有出处,可以告诉你“这个信息来自哪里”。
好处:
用户更信任它的回答。
工程师也更容易找出错误并改进。
(4)更懂你想要什么
怎么做:在查资料时会考虑你的历史记录、偏好或当前上下文。
好处:
回答更贴合你的需求。
比如客服系统可以根据你之前的问题推荐解决方案。
(5)维护起来更轻松
怎么做:把知识存在外面,而不是全装进模型里。
好处:
想更新知识只需要改资料库,不用重新训练整个模型。
长期使用成本更低。
(6)实际应用很广泛
例子:
客服机器人:快速查找产品说明或常见问题。
教育辅导:根据教材内容解答学生疑问。
医疗助手:参考医学指南给出建议。
公司内部助手:帮你查公司制度或项目文档。
总结
RAG 技术让聊天机器人不再只靠“死记硬背”,而是像人一样先查资料再作答。这让它更聪明、更灵活、更容易控制。
随着技术的发展,RAG 将会在各种智能对话场景中越来越重要。
8、RAG中的检索组件扮演什么角色?
在 RAG(检索增强生成)系统中,检索组件就像一个快速查找资料的小助手。
它负责从外部的知识库中找到和用户问题相关的内容,然后把这些信息交给后面的“回答生成器”来使用。
(一)它的主要作用:
(1) 快速定位有用的信息
用户问完问题后,它会去一个提前准备好的知识库(比如维基百科、公司文档等)里找答案。
找到的内容会作为背景材料,供后面生成答案时参考。
(2) 让回答更准确、更新更快
大模型本身知道的东西是固定的,但通过检索组件可以加入最新的信息。
比如你想知道“今年诺贝尔物理奖是谁”,模型可能不知道,但检索组件能从最新资料里找到。
(3) 减少胡编乱造
大模型有时会“瞎说”。有了真实来源的资料,就能让它说话更有依据,少出错。
(二)它是怎么工作的?
(1) 用户提出问题(例如:“量子计算是什么?”)
(2) 检索组件把问题转成计算机能理解的形式(通常是向量)
(3) 在知识库里找最相关的几段话或文档
常用工具:FAISS、倒排索引、ANN近似匹配
(4) 返回几个最相关的资料片段
(5) 把这些资料和问题一起交给生成组件
(6) 生成组件根据这些信息组织出最终的回答
(三)常用的几种检索方法
9、RAG如何处理偏见和错误信息?
RAG(检索增强生成)是一种结合“查资料”和“写答案”的技术。它先从外部知识库中查找相关信息,再根据这些信息生成回答。
但问题是:如果查到的内容本身有问题(比如有偏见或错误),那最终的回答也可能出错。
我们来看看它是怎么出问题的,以及有哪些办法可以减少这些问题。
(一)为什么RAG会引入偏见或错误?
(1) 查资料阶段的问题:
如果查到的资料本身就带有偏见或错误,那结果自然也会受影响。
查找时可能更偏向某些网站(比如权威网站),导致信息不全面。
(2) 写答案阶段的问题:
模型可能会直接照搬查到的内容,不管是不是对的。
它很难判断哪些信息是可信的,哪些是误导性的。
(二)解决偏见和错误的方法
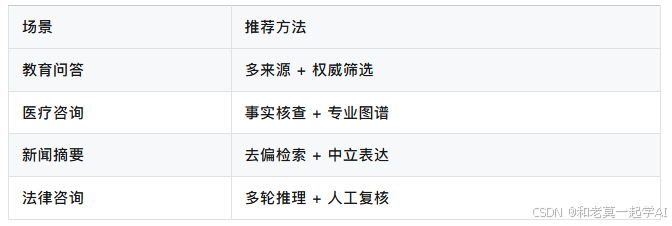
(1)在“查资料”阶段优化:
多来源查找:
不只查一个地方,而是多个地方都看看,避免被单一观点带偏。
评估可信度:
给每个资料打分,优先选质量高、权威性强的内容。
去偏算法:
调整搜索结果,不让某一种观点占太多比例。
(2)在“写答案”阶段优化:
事实核查:
写答案前先检查一下查到的信息是否靠谱,可以用知识图谱等工具辅助验证。
多轮推理:
不只看一份资料,而是综合多个证据来得出结论。
控制语言风格:
让模型尽量说中立、客观的话,减少主观偏见。
(3)后期处理与改进:
人工审核 + 用户反馈:
有人定期检查输出内容,用户也可以指出问题。
对抗训练:
教模型识别那些容易出错的地方,提高抗干扰能力。
说明出处:
回答时告诉用户依据来自哪里,方便追溯。
(三)不同场景下的建议做法
(四)总结
RAG虽然能提升回答质量,但也容易受原始数据影响。要让它更可靠,可以从三个方面入手:
✅ 数据方面:资料要多样、高质量
✅ 模型方面:加事实核查、去偏机制
✅ 用户方面:提供反馈渠道、说明来源
10、使用RAG而不是其他自然语言处理技术的益处是什么?
RAG(检索增强生成)是一种结合搜索和生成的技术。它不是凭空编答案,而是先查资料,再根据查到的内容来回答问题。
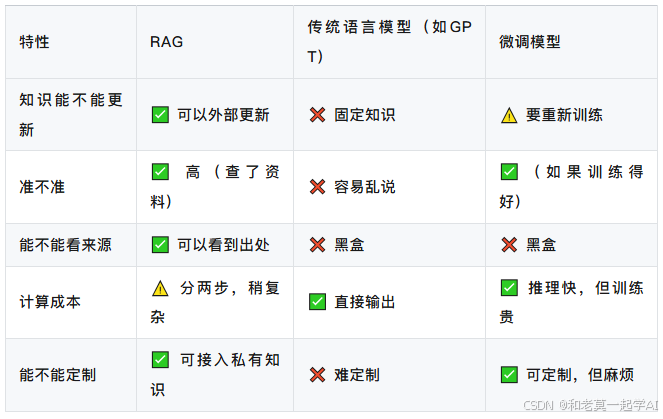
相比传统方法,它有以下优势:
✅ 1. 回答更准确、更靠谱
RAG会先从知识库中找相关信息,再生成答案。
这样回答基于真实数据,而不是模型自己“猜”的。
特别适合医疗、法律、企业内部查询等对准确性要求高的场景。
✅ 2. 能用最新的信息
普通模型的知识是固定的(比如只学到2023年的数据)。
RAG可以通过更新知识库获取新信息,不需要重新训练整个模型。
适合新闻摘要、市场分析等需要实时更新的应用。
✅ 3. 减少胡说八道的情况
大模型有时会“编故事”,说一些不存在的事。
RAG通过先查后答的方式,避免乱说,提高可信度。
✅ 4. 看得出答案是从哪来的
RAG可以告诉你答案来自哪些文档或资料。
用户知道出处,更容易信任结果。
对金融、法律等行业特别重要。
✅ 5. 容易接入专业领域的知识
可以把企业的FAQ、数据库、内部文档等作为知识来源。
不用为每个领域单独训练一个大模型,节省时间和资源。
✅ 6. 比微调更省事
微调模型需要大量数据和计算资源。
RAG只需要更新知识库就能适应新任务,维护起来也更容易。
✅ 7. 小语种或冷门领域也能用
如果某个领域没有太多训练数据,很难训练出好模型。
RAG可以在没有大量标注数据的情况下,靠已有文档辅助生成答案。
📌 总结:RAG 和其他技术对比
11、你能讨论一个RAG特别有用的场景吗?
🧠 场景背景:
大公司通常有很多内部资料,比如技术文档、操作手册、常见问题解答、项目记录等。员工经常需要从中找信息来解决问题。
以前的做法是手动查文档、问同事或翻静态网页,效率低还容易出错。
✅ RAG怎么解决这个问题?
RAG 把“找资料”和“写答案”两件事结合起来,当用户提问题时:
(1) 先从资料中找出最相关的内容
(2) 再根据这些内容生成自然语言的回答
这样既不用提前写好所有答案,又能减少AI乱编的情况,因为回答是有依据的。
🔍 举个例子:
你在一家通信公司工作,问:
“最新的5G基站部署要求是什么?”
系统会:
自动从内部资料里找到《5G基站部署指南》
提取关键信息(如天线高度、功率设置、频段要求)
把这些内容整理成一段通顺的回答
而不是让AI凭空说,也不是只给一堆文档链接。
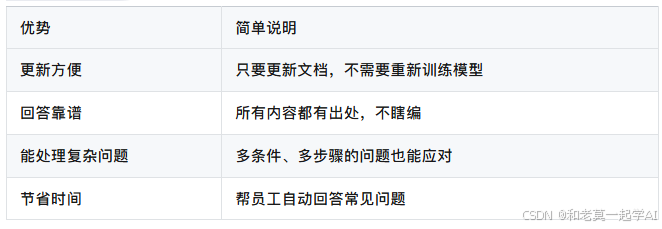
🌟 RAG的优势:
12、RAG如何与现有的机器学习管道集成?
RAG(检索增强生成)是一种结合了“找资料”和“写答案”的方法。它先从外部知识库中找到相关信息,再把这些信息交给生成模型,让回答更准确、更有依据。
如果你想把 RAG 加入你已有的机器学习流程中,可以按照以下几个步骤来操作:
(一)搞清楚你现在的流程是怎样的
大多数机器学习流程包括以下几步:
(1) 数据清洗:整理输入的数据。
(2) 特征处理:提取有用的信息给模型使用。
(3) 训练或推理:训练模型或者用模型做预测。
(4) 结果处理与上线:优化输出结果并部署上线。
(二)RAG 的基本流程
RAG 主要有两个部分组成:
(1) 检索器(Retriever):负责从知识库中找出相关的内容。
可以用传统方法(如 TF-IDF、BM25),也可以用向量搜索(如 DPR、FAISS)。
(2) 生成器(Generator):根据原始问题 + 检索到的内容,生成最终的回答。
常见的语言模型有 T5、BART、LLaMA 等。
(三)怎么把 RAG 加进你的流程里?
(1)把 RAG 当成一个“增强生成模块”
如果你已经有生成模型(比如 Seq2Seq 模型),可以在它的输入中加入检索到的相关内容,这样模型就能参考更多信息来生成答案。
示例代码(不需改动)
input_with_context = f"问题:{question}\n相关资料:{retrieved_text}"
response = generator(input_with_context)
(四)构建外部知识库
你需要准备一个知识库,里面放你想让模型参考的内容,比如 FAQ、文档、数据库等。然后对这些内容进行预处理、分块、编码,方便检索器快速查找。
(五)评估与调优
集成完 RAG 后,要测试效果,看看是否提升了准确性。
你可以通过调整检索方式、生成策略、上下文长度等方式来优化性能。
13、RAG在自然语言处理中解决了哪些挑战?
RAG(检索增强生成)是一种结合了查资料和写答案的技术。
它能解决很多传统 AI 模型在处理语言时遇到的问题,特别是在需要大量知识的任务中表现很好。
(1)知识更新问题
问题:老模型的知识是固定的,只能回答训练数据里的内容,不能知道最新的事。
RAG 怎么做:
在回答前先去网上或数据库里查最新信息。
这样就能回答像“2024年奥运会金牌榜”这种新问题。
✅ 示例:问最近的新闻,RAG 可以查到最新消息再回答你。
(2)事实准确性问题
问题:有些 AI 会乱编话,听起来有道理但其实是假的。
RAG 怎么做:
回答前先查权威资料,比如医学书或政府网站。
然后再根据这些真实资料来写答案,减少瞎说。
✅ 示例:问某种病怎么治,RAG 会参考正规医学资料来回答。
(3)专业领域支持不足
问题:通用 AI 对法律、医疗等专业问题了解不深。
RAG 怎么做:
可以接入不同领域的资料库,比如法律条文、专利文件等。
不用重新训练整个模型,就能变成某个行业的专家助手。
✅ 示例:问合同条款,RAG 可以查法律条文给出专业建议。
(4)输入太长处理不了
问题:很多 AI 只能看一小段文字,太长就看不懂。
RAG 怎么做:
自动挑出最相关的部分来看。
减少干扰,让 AI 更专注关键信息。
✅ 示例:读一篇论文摘要,RAG 可先找出重点段落再总结。
(5)复杂问题不会推理
问题:有些问题要分几步才能想清楚,AI 做不到。
RAG 怎么做:
分多轮查资料、一步步推理。
每次查完都得出一点结论,再接着查下一步。
✅ 示例:问“谁拿过诺贝尔奖又当过联合国秘书长?”,RAG 会分步查人、查经历。
(6)个性化需求难满足
问题:通用 AI 难以适应企业或个人的特殊需求。
RAG 怎么做:
用户可以上传自己的资料,比如公司文档、客户记录。
AI 就可以根据这些资料来定制服务。
✅ 示例:公司内部问答系统,可以基于员工上传的资料来回答问题。
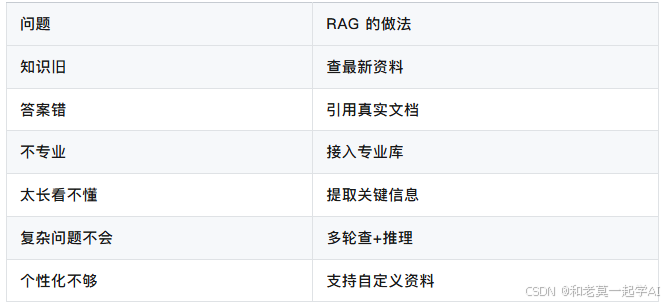
总结:RAG 解决了哪些问题?
14、RAG如何确保检索到的信息是最新的?
为什么要关注信息的新鲜度?
RAG(检索增强生成) 是一种结合“查资料”和“写答案”的技术。它先从外部知识库中查找相关信息,再用这些信息来生成更准确的回答。
但问题在于:如果知识库里是旧数据,那回答就可能出错。
所以,确保检索到的信息是最新的,是使用 RAG 的关键。
如何保证检索信息是新的?
(1)定期更新知识库
怎么做:
定时抓取最新资料(比如新闻、网页等)。
调用API获取实时数据(如天气、股票)。
优点:能控制知识质量。
缺点:需要维护更新机制,占用资源。
(2)实时检索
怎么做:用户提问时直接联网搜索最新结果。
例子:像 Google 或 Bing 提供的搜索接口就可以用。
优点:信息最及时。
缺点:响应慢一点,费用高。
(3)时间戳排序
怎么做:给每条资料打上时间标签,优先返回最近的内容。
优点:不用频繁更新也能提高新鲜度。
缺点:长期不更新的数据还是会过时。
(4)增量更新
怎么做:只更新有变化的部分,而不是全部重做。
优点:节省时间和资源。
缺点:实现起来复杂,要能识别哪些内容变了。
(5)静态+动态知识混合使用
怎么做:把稳定的知识(如百科)和经常变的知识(如新闻)分开处理,最后合并使用。
优点:兼顾效率和时效。
缺点:需要多个模块配合。
(6)人工审核与反馈
怎么做:让用户举报错误,或安排人员检查高频问题。
优点:提升准确性。
缺点:成本高,不能完全自动化。
总结对比表
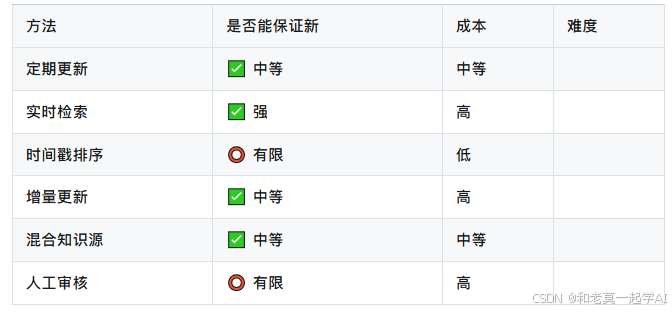
推荐做法
对时效要求高的场景(如股市、新闻):用实时检索 + 时间戳排序;
通用问答系统:建议定期更新 + 时间戳过滤 + 版本管理;
所有系统都应建立监控和反馈机制,持续优化。
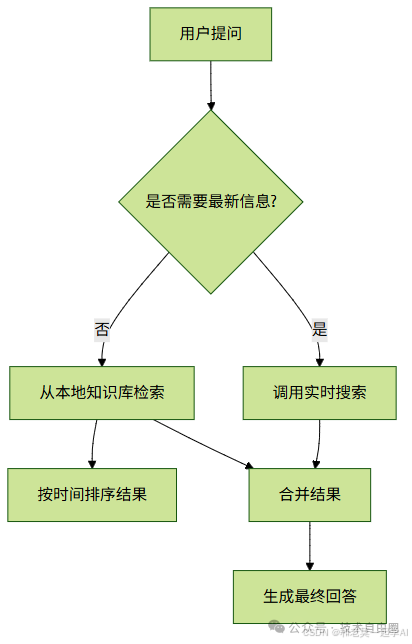
核心流程图
15、你能解释RAG模型是如何训练的吗?
RAG(Retrieval-Augmented Generation,检索增强生成)是一种结合查找信息和生成答案能力的 AI 技术。
它由 Facebook 在 2020 年提出,主要用于问答、聊天机器人等需要大量知识的任务。
💡 核心思想:先查资料,再回答问题
RAG 的基本思路是:
不靠脑子记所有知识,而是遇到问题时先去查资料,再根据查到的内容来组织答案。
这样做的好处:- 不用把所有知识都塞进模型里;- 可以随时更新知识库;- 答案有据可依,更容易解释;- 更准确、更及时。
🔧 工作原理:两个模块配合完成任务
RAG 分成两个部分:
(1) 检索器(Retriever)
功能:从一堆文档中找出和问题相关的资料。
常用方法:DPR(稠密向量检索),像搜索引擎一样工作。
输入:用户的问题 → 输出:几个相关段落。
(2) 生成器(Generator)
功能:根据问题和找到的资料,写出自然语言的回答。
常用模型:BART 或 T5 这类预训练语言模型。
输入:问题 + 找到的资料 → 输出:最终答案。
怎么训练?
RAG 可以整体训练,也可以分开训练。
(1)检索器训练(可选)
如果已有现成的检索模型(如 DPR),可以直接用。
如果要自己训练,可以用对比学习的方法,让模型学会区分对错文档。
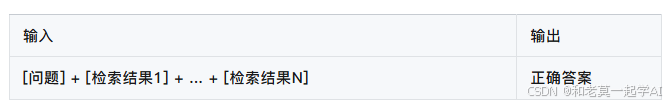
(2)生成器训练
数据格式如下:
(3)联合训练(进阶玩法)
Retriever 和 Generator 一起训练,效果更好,但对算力要求高。
具体步骤:
(1) 用户输入一个问题;
(2) 检索器在知识库中找几篇相关的文章或段落;
(3) 把问题和这些资料一起交给生成器;
(4) 生成器根据这些内容写出答案。
✅ 优点总结
知识更新方便:只需更新资料库,不用重新训练模型;
答案有依据:可以看到引用来源;
减少胡说八道:因为答案基于真实资料。
⚠️ 缺点说明
依赖资料质量:如果找不到相关内容,答案可能不准;
响应慢一点:多了一个查找步骤;
训练复杂:特别是联合训练时,资源消耗大。
16、RAG对语言模型的效率有何影响?
RAG 是一种结合了“找资料”和“写内容”的技术。它先从外部知识库中找到相关信息,再用这些信息来辅助生成更准确的回答。
虽然效果更好了,但也带来了一些效率上的问题。
(一)回答变慢了
为什么:
多了一个“找资料”的步骤。
查找过程可能需要复杂的计算,比如向量匹配。
影响:
比直接生成答案的模型(如GPT)慢一些。
在高并发或实时场景下会更明显。
(二)占用资源更多
为什么:
要额外运行一个“查找模块”,比如编码器 + 向量数据库。
“查”和“写”两个阶段都要消耗计算资源。
影响:
成本更高,尤其在手机、嵌入式设备上不太适用。
(三)系统扩展难
为什么:
知识库越大,查找越慢。
数据更新频繁时,还要不断重建索引。
影响:
维护成本高,不适合经常变动的数据环境。
(四)训练效率变化不大,但更复杂
为什么:
分两步训练:先训练查找部分,再训练生成部分。
可以分别优化,但整体流程更复杂。
影响:
单次训练时间差不多,但开发调试更麻烦。
(五)提升效率的方法
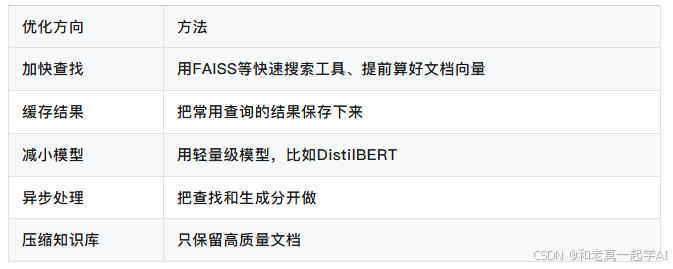
总结
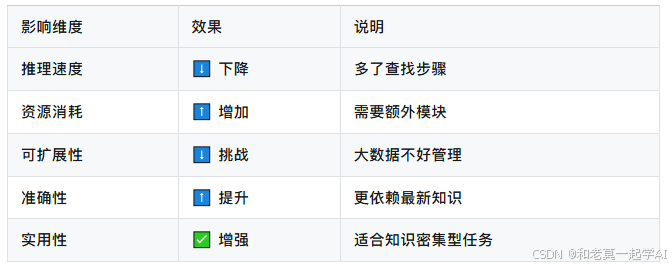
适用场景建议:
适合使用RAG的场景:
需要引用外部资料的任务(如问答、客服)
对准确性要求高的场景
知识经常更新的情况
不适合使用RAG的场景:
实时性要求高的场景(如语音助手)
设备资源有限(如手机端)
不依赖外部知识的任务(如写小说)
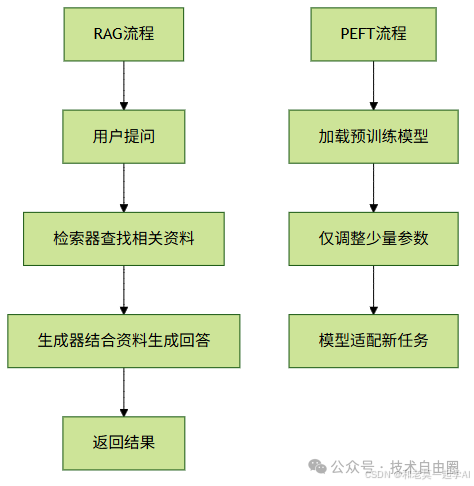
17、RAG与参数高效微调(PEFT)有何不同?
RAG 与 PEFT:两种增强大模型的方法
RAG 和 PEFT 是用来提升或定制大语言模型的两种不同方法。
它们的目标和使用方式不同,适合的场景也不同。
(一)基本概念
- RAG(Retrieval-Augmented Generation)
是什么:先查资料,再生成答案。
怎么工作的:
先从知识库中找相关信息(检索器)
再根据找到的内容生成回答(生成器)
- PEFT(Parameter-Efficient Fine-Tuning)
是什么:只动一点点参数,就能让模型适应新任务。
常用方法:
LoRA
Prefix Tuning
Prompt Tuning
Adapter Tuning
(二)对比一览表
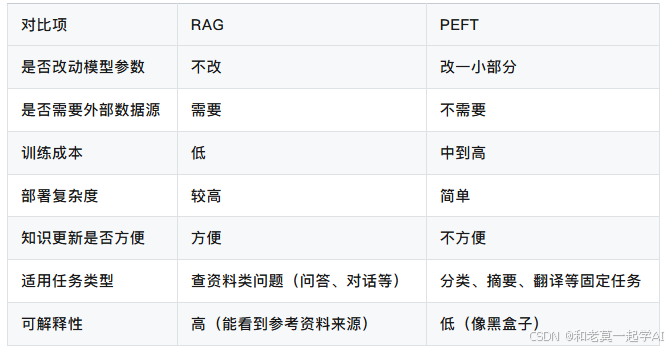
(三)典型应用场景
RAG 的用武之地
客服机器人
法律、医疗问答助手
实时更新信息的系统
PEFT 的常见用途
资源有限时定制模型
快速适配新任务
多任务共享基础模型
模型压缩后部署在手机等设备上
(四)优缺点总结
RAG 的优点和缺点
✅ 优点:
不改原始模型
知识可以随时更新
回答更准确、有依据
❌ 缺点:
构建检索系统麻烦
回答速度可能慢
检索不准就会影响结果
PEFT 的优点和缺点
✅ 优点:
微调快、资源少
部署简单
适合特定任务
❌ 缺点:
更新知识不方便
像黑盒子一样难理解
效果可能不如全量微调
(五)可以一起用吗?
当然可以!比如:
用 LoRA 微调生成器,让它更适合某个专业领域;
同时用 RAG 提供最新知识,提高准确性。
这样既能节省资源,又能灵活应对变化。
(六)一句话总结
RAG 是“借资料答题”,PEFT 是“小改模型做定制”。
选哪个,看你的任务需求和资源情况。
核心流程图
18、RAG如何增强人与AI的协作?
RAG:让 AI 更聪明地回答问题
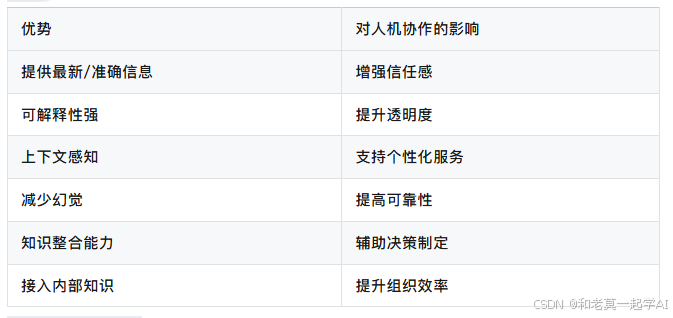
RAG(检索增强生成)是一种结合“查资料”和“写答案”的技术。
它先从外部知识库中查找相关信息,再把这些资料交给 AI 来生成回答。
这样可以让 AI 的回答更准确、有依据,也更容易让人理解和信任。
(1)靠“新数据”能给出最新、更准的答案
RAG 让 AI 能实时查阅最新的资料,不会像传统 AI 那样只靠“老数据”来回答。
用户看到的回答是有来源的,自然更放心。
✅ 适用场景:客服、医疗、法律等对准确性要求高的地方。
(2)“有据可依”, 看得出 AI 是怎么想的
RAG 在回答时会附带引用来源,比如文档或网页链接。
这样用户就知道 AI 不是瞎说的,而是“有据可依”。
✅ 示例:AI 回答技术问题时,可以附上参考资料链接。
(3)更懂你想要什么
RAG 会根据你的问题动态查找最相关的资料,让回答更贴合你的需求。
在连续对话中也能记住上下文,保持逻辑连贯。
✅ 适用场景:学习辅导、企业内部问答、个性化推荐等。
(4)减少胡编乱造的情况
因为答案是基于真实资料生成的,所以 AI 很少会“编故事”。
对需要高可靠性的任务来说非常重要。
(5)一起做决定更高效
RAG 帮 AI 快速整理大量信息,生成建议,辅助人做出更好的判断。
用户也可以参考 AI 提供的资料进一步分析或调整。
✅ 适用场景:商业分析、政策制定、科研辅助等。
(6)连接公司内部的知识库
企业可以把 RAG 接入自己的数据库、文档系统或知识图谱。
让 AI 成为员工快速获取内部知识的好帮手。
总结:
最后一句话:
RAG 技术让 AI 不再是个“黑盒子”,而是一个能查资料、讲道理、帮你思考的好助手。未来,随着技术的发展,RAG 将在更多专业领域帮助人和 AI 更好地合作。
19、你能解释RAG系统的技术架构吗?
📚 什么是 RAG?
RAG(Retrieval-Augmented Generation,检索增强生成)是一种结合了“查资料”和“写答案”的技术,常用于问答系统、聊天机器人等需要引用外部知识的场景。
💡 核心思想
在回答问题前,先从外部资料中找到相关信息,再用这些信息来辅助生成答案。这样可以让答案更有依据、更准确。
传统模型像 GPT 是靠训练时记住的知识回答问题;而 RAG 则像是边查资料边答题,能用最新的、外部的信息来生成答案。
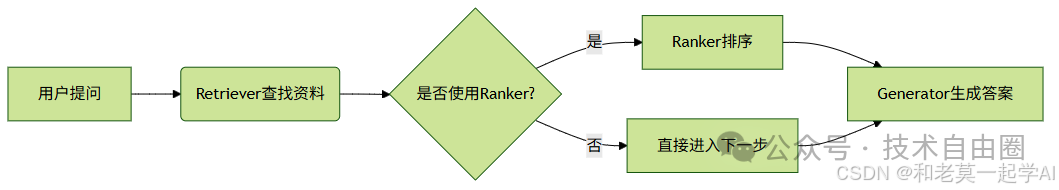
⚙️ RAG 系统的组成
RAG 系统主要由三部分组成:
(1)查找器(Retriever)
功能:从大量文档中快速找出与问题相关的资料
方法:- 向量匹配(如 FAISS、DPR)- 关键词搜索(如 BM25)
(2)排序器(Ranker,可选)
功能:把找出来的资料按相关性排序
方法:
更精细的语义模型打分(如交叉编码器)
(3)生成器(Generator)
功能:根据问题和找到的资料,生成自然语言的回答
方法:- 使用像 BART、T5、GPT 这样的模型- 输入 = 问题 + 找到的资料
🔁 工作流程
🧪 示例说明(以问答为例)
用户问:“爱因斯坦得过哪些奖?”
(1) Retriever 从维基百科等资料中找到相关内容
(2) Ranker(如果有)选出最相关的几段
(3) Generator 结合问题和资料,输出答案,比如:“爱因斯坦于1921年获得诺贝尔物理学奖……”
✅ 优点总结
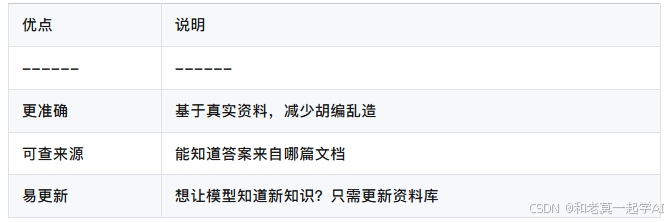
🌐 应用场景
客服机器人
公司内部知识库问答
医疗/法律助手
教育辅导系统
大模型扩展知识插件
🛠️ 常见工具
Hugging Face Transformers(含 RAG 模型)
FAISS / Milvus(高效向量检索)
Elasticsearch / BM25(关键词检索)
DPR(Facebook 提出的检索方法)
📝 总结
RAG 把“查资料”和“写答案”结合起来,解决了传统模型知识老、容易瞎说的问题,是构建高质量问答系统的重要方式之一。
20、RAG如何在对话中保持上下文?
(一)什么是RAG?
RAG(检索增强生成) 是一种结合“查资料”和“写回答”的方法。它的工作流程分为两步:
(1) 查资料(Retrieval):从知识库中找相关信息。
(2) 写回答(Generation):用找到的信息和用户的问题一起生成答案。
(二)为什么要保留上下文?
在聊天过程中,用户可能会连续提问,后面的问题可能依赖前面的内容。
比如:- 用户问:“北京有什么好玩的?”- 系统回答后,用户接着问:“那上海呢?”
如果不记得前面说了什么,“上海呢”就很难理解成“上海有什么好玩的”。
(三)RAG怎么保留上下文?
(1)记录对话历史
把每一句话都记下来,传给模型参考。
例如:
User: 北京有什么好吃的?
System: 北京有烤鸭、炸酱面…
User: 那上海呢?
处理最后一句时,把整个对话作为输入的一部分,帮助模型理解“那”指的是前面说的“好吃的”。
(2)在查资料时也看上下文
不只是看当前问题,还要结合之前聊过的内容来重构查询。
比如:- 当前问题是“那上海呢?”- 结合上下文变成“上海有什么好吃的?”
这样再去查资料会更准确。
(3)生成答案时融合上下文和资料
生成回答时,把三样东西一起交给模型:
用户当前说的话
对话历史(上下文)
查到的相关信息
这样模型就能写出连贯又准确的回答。
(4)管理对话状态
长期对话中可以记录一些关键信息,比如:
用户喜欢旅游还是美食
已经聊过哪些话题
用户有没有特别偏好
这些信息可以在后续对话中被使用,让系统更懂用户。
(5)滑动窗口机制
如果对话太长,只保留最近几轮内容,比如最近3~5句话。这样既能减少负担,也能保留足够的上下文。
(四)一个简单例子
对话过程如下:
(1) 用户:北京有什么好吃的?
(2) 系统:查“北京美食”,回答:烤鸭、炸酱面等。
(3) 用户:那上海呢?
(4) 系统:
理解为“上海有什么好吃的”
查“上海美食”
回答:小笼包、蟹粉小笼等
(五)总结方法
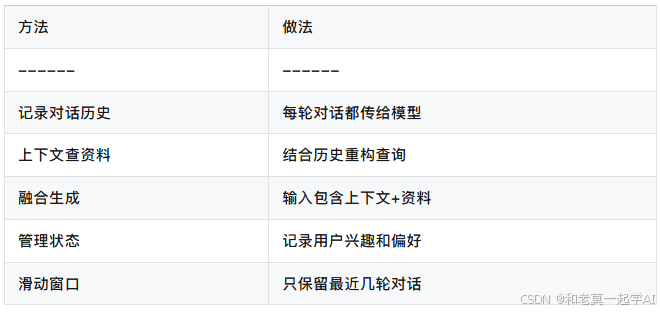
(六)核心流程图
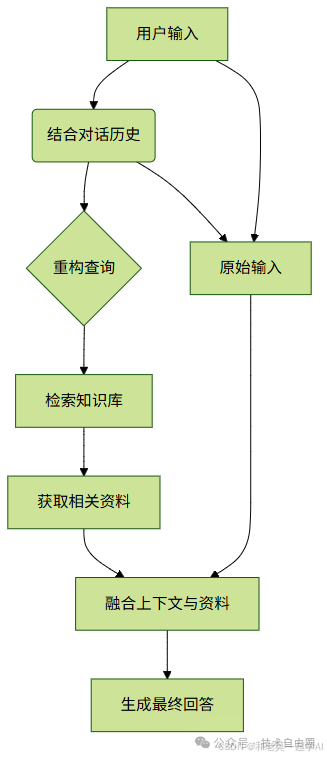
21、RAG有哪些局限性?
RAG 是一种结合“查资料”和“写答案”的技术。
它先从外部知识库中查找相关信息,再用这些信息生成回答。虽然这种方法能提高回答的准确性和时效性,但也存在一些问题。
(一)依赖外部资料的质量
(1) 资料质量决定结果好坏
如果资料本身有错误、过时或不全,那最终的回答也可能出错。
资料覆盖范围不够广,可能找不到相关的内容。
(2) 维护成本高
想让资料保持最新,需要经常更新,这会消耗大量人力和资源。
(二)检索效率不高
(3) 查资料太慢
在大规模资料库里找相关内容(比如用向量匹配),速度可能很慢,影响整体响应时间。
(4) 占用资源多
查资料 + 写答案两个步骤一起运行,对服务器要求高,尤其在多人同时使用时更明显。
(三)查资料和写答案配合不好
(5) 查到的内容可能无关或重复
查回来的信息可能不相关或重复,导致写出来的答案混乱或啰嗦。
(6) 模型对资料依赖不稳定
有时模型太依赖查到的内容,忽略自己已有的知识;
有时又完全忽略查到的内容,只用自己的知识,造成浪费。
(四)难以控制和解释
(7) 出错难定位
如果最后的答案错了,很难判断是查资料的问题,还是写答案的问题。
(8) 无法控制如何使用资料
比如不知道模型是否优先用了新资料,或者怎么处理互相矛盾的信息。
(五)开发和部署复杂
(9) 训练困难
查资料和写答案的模块通常是分开训练的,很难做到统一优化。
(10) 部署麻烦
-
需要同时搭建查资料系统和写答案系统,涉及多个组件的整合,技术门槛高。
(六)安全与隐私风险
(11) 可能泄露敏感信息 -
如果资料里包含机密内容,可能会在检索过程中不小心暴露出来。
(12) 版权问题 -
使用第三方资料时,可能存在未经授权引用内容的风险。
总结:RAG 的主要问题分类
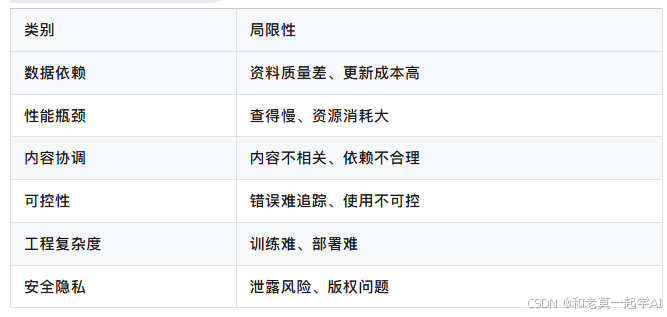
21、RAG如何处理需要多跳推理的复杂查询?
有些问题不能靠一次搜索就能回答清楚,需要多次查找信息并把它们连起来思考。
这种能力叫做“多跳推理”。
(一)什么是“多跳推理”?
就是说,要回答一个问题,得先查一次资料,再根据这个结果继续查下一轮,直到找到最终答案。
举个例子:
问:“《哈利·波特》的作者出生在哪里?”
第一步:查《哈利·波特》是谁写的 → J.K. 罗琳
第二步:查J.K. 罗琳的出生地 → 英国格洛斯特郡
这就用了两次查找,中间还要动脑连接信息。
(二)RAG怎么处理这类问题?
普通RAG只能做一次查找+一次回答。
要解决复杂问题,就得用一些特别的方法。
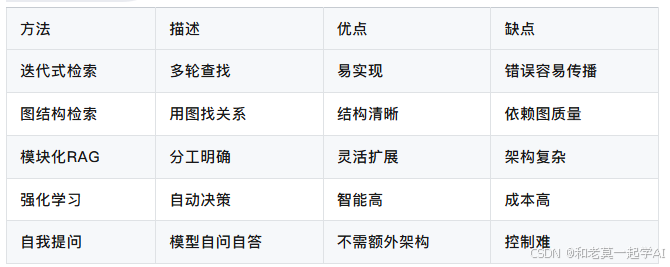
方法1:一步步来,边查边问(迭代检索)
原理:
把大问题拆成小问题;
每次查一点,然后根据结果提出新问题;
继续查下去,直到得到完整答案。
示例:
问:“谁写了《百年孤独》,他还在哪部作品中出现过?”
(1) 查《百年孤独》的作者 → 加布里埃尔·加西亚·马尔克斯
(2) 再查他的其他作品 → 《霍乱时期的爱情》等
工具支持:
可以用 HotpotQA 这类数据集训练模型;
也可以让模型自己决定下一步查什么。
方法2:用关系图来找答案(图结构检索)
原理:
把知识整理成一张图,比如人和书的关系;
在图上找路径,看看问题里的东西是怎么连起来的。
应用场景:
适合人物关系、事件因果等问题;
需要有结构化的知识库,比如维基百科。
方法3:分模块处理(模块化 RAG)
把整个流程分成几个部分:- 分析问题- 多轮查找- 推理分析- 最后输出答案
特点:
各部分可以单独优化;
可以接入外部工具,比如搜索引擎或数据库。
方法4:让模型自己学着走(强化学习)
原理:
让模型像玩游戏一样学习怎么查;
它会根据已经查到的信息,决定下一步该查什么。
优势:
能自动找到最优路径;
适合开放性问题。
方法5:让模型自己提问(自我提问法)
原理:
大模型自己先想中间问题;
然后一个个查,一步步得出答案。
示例:
问:“谁写了《百年孤独》,他还写了什么?”
→ 模型自己想:“我得先知道作者是谁。”
→ 查完作者后,再问:“他还有哪些作品?”
实现方式:
主要是通过提示词设计实现;
可以结合检索系统一起使用。
(三)效果评估与难点
评估方法:
EM(完全匹配)
F1分数(部分匹配)
使用专门的数据集测试,如 HotpotQA、Musique 等
主要挑战:
第一步错了,后面全错;
中间步骤不好控制;
缺乏大量标注数据;
多次检索影响速度。
(四)总结对比表
(五)未来方向
更聪明的排序机制
专为多跳任务设计的训练目标
检索和推理一起优化
和知识图谱深度结合
支持图文视频的多跳推理
🔄 核心流程图
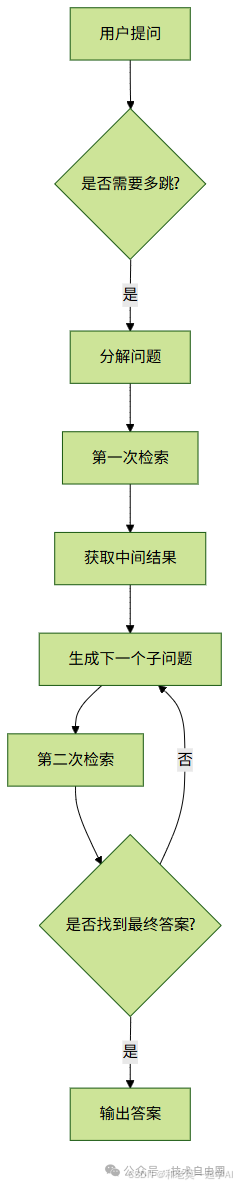
这个图展示了多跳推理的基本流程:从问题出发,判断是否需要多跳 → 分解问题 → 多轮检索 → 整合信息 → 输出答案。
23、知识图在RAG中扮演什么角色?
知识图谱在RAG中的作用
知识图谱(Knowledge Graph)可以提升 RAG(检索增强生成)系统的理解和回答能力。
传统 RAG 主要靠文档或向量数据库来查找信息,而加入知识图谱后,系统能更好地理解问题背后的含义,还能进行逻辑推理。
下面介绍知识图谱在 RAG 中的几个主要作用:
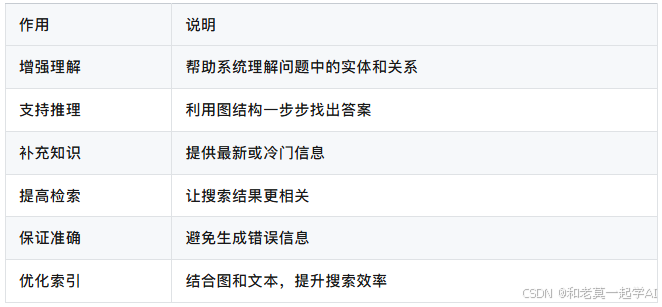
(1)让检索更准确
知识图谱记录了各种实体之间的关系。
当用户提问时,系统可以通过这些关系找到更相关的答案。
比如问“爱因斯坦的学生有哪些?”,系统能通过图谱找到“指导学生”这条关系,快速定位答案。
(2)增强理解与推理
一般 RAG 只能做简单的语义匹配,但复杂问题需要一步步推理。
知识图谱用三元组(A 和 B 是什么关系)的形式存储信息,支持多步推理。
比如问“《相对论》作者的导师是谁?”,系统可以先找作者,再找他的导师。
(3)补充新知识和冷门知识
大模型的知识是固定的,对新出现的信息或冷门知识了解有限。
知识图谱可以随时更新,作为外部知识源,补足模型的短板。
(4)解决多跳问题
多跳问题是那种需要查多个信息点才能回答的问题。
知识图谱本身就是一个连接很多信息的网络,特别适合处理这类问题。
比如问“美国总统出生在哪里?”,系统可以先查现任总统是谁,再查他的出生地。
(5)提高生成内容的准确性
在生成答案时,系统会参考知识图谱里的事实,避免胡编乱造。
这样输出的答案更可靠,也更一致。
(6)优化检索索引
把知识图谱和文档结合,可以建立更智能的检索方式。
不只是靠关键词匹配,还可以根据语义路径来找答案,效果更好。
总结:知识图谱在 RAG 中的作用
应用举例
医疗问答:用医学知识图谱辅助医生或患者获取专业建议。
金融风控:分析企业之间的关系,识别潜在风险。
智能客服:结合产品知识图谱,快速解答用户问题。
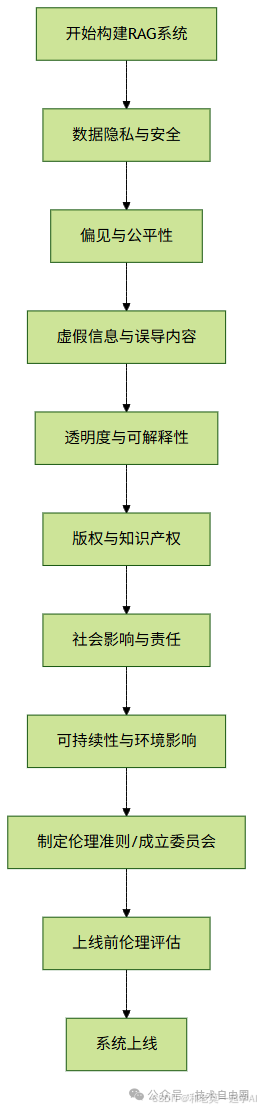
核心流程图
24、实施RAG系统时有哪些伦理考虑?
在使用 RAG(检索增强生成)系统 时,不仅要考虑技术实现,还要关注它可能带来的伦理问题。因为这类系统会用到大量数据和模型,影响用户、社会甚至环境。
下面是几个关键方面:
(一)🔒 数据隐私与安全
用户输入的内容不能被泄露或滥用。
使用的数据必须合法获取,不能侵犯他人隐私。
要有权限控制机制,防止数据被不该看到的人访问。
✅ 重点:保护用户信息,遵守相关法律(如GDPR、PIPL)。
(二)⚖️ 偏见与公平性
如果检索的数据本身有偏见(比如性别歧视、种族偏见),输出结果也可能不公平。
要定期检查数据,避免过时或带有歧视的内容进入系统。
输出内容应尽量中立,避免误导。
✅ 重点:确保数据和输出都公平公正。
(三)⚠️ 虚假信息与误导内容
如果知识库中有错误信息,系统可能会生成不准确的回答。
即使数据没问题,生成模型也有可能“编造”事实(幻觉)。
出现错误时要明确谁来负责。
✅ 重点:建立验证机制,减少错误和虚假内容。
(四)🔍 透明度与可解释性
用户应该知道他们在跟AI对话。
应该告诉他们系统用了哪些数据,怎么生成答案。
最好能提供引用来源,让用户自己判断信息是否可信。
✅ 重点:让系统更透明,提升用户信任。
(五)©️ 版权与知识产权
检索到的内容不能直接照搬,否则可能侵权。
生成内容也不能太像原文,否则可能涉嫌抄袭。
要标注出处,必要时获得授权。
✅ 重点:尊重版权,合理引用。
(六)🌍 社会影响与责任
自动化系统可能取代人工岗位,需要评估对就业的影响。
系统可能被恶意使用,比如制造假新闻、诈骗等。
内容要符合主流价值观,不能违法或有害。
✅ 重点:防范滥用,承担社会责任。
(七)🌱 可持续性与环境影响
系统运行效率要高,避免浪费资源。
尽量采用绿色计算方式,降低能耗。
✅ 重点:节能环保,可持续发展。
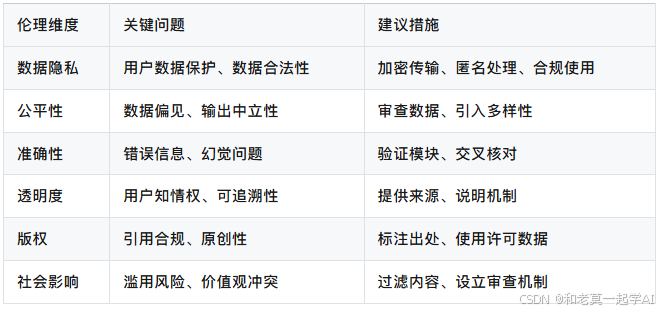
✅ 总结:RAG系统伦理要点一览表
普通人如何抓住AI大模型的风口?
领取方式在文末
为什么要学习大模型?
目前AI大模型的技术岗位与能力培养随着人工智能技术的迅速发展和应用 , 大模型作为其中的重要组成部分 , 正逐渐成为推动人工智能发展的重要引擎 。大模型以其强大的数据处理和模式识别能力, 广泛应用于自然语言处理 、计算机视觉 、 智能推荐等领域 ,为各行各业带来了革命性的改变和机遇 。
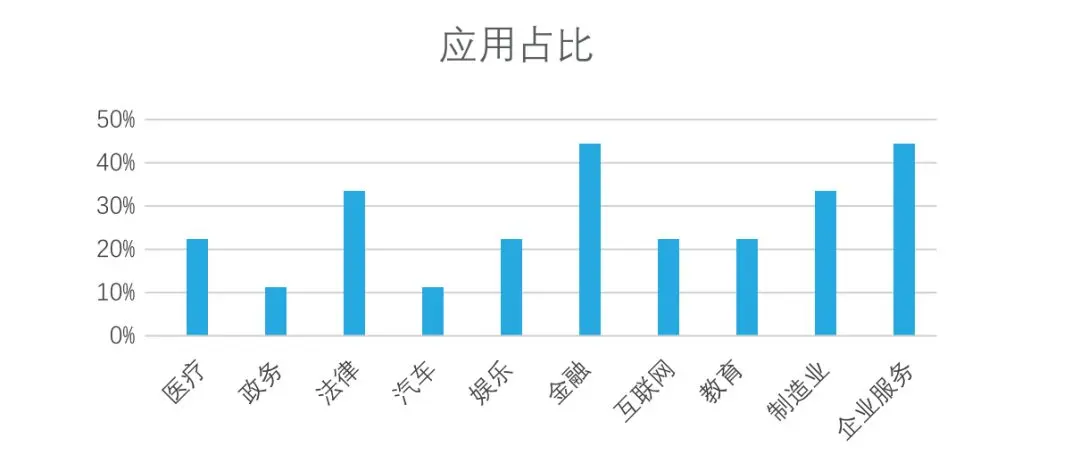
目前,开源人工智能大模型已应用于医疗、政务、法律、汽车、娱乐、金融、互联网、教育、制造业、企业服务等多个场景,其中,应用于金融、企业服务、制造业和法律领域的大模型在本次调研中占比超过 30%。
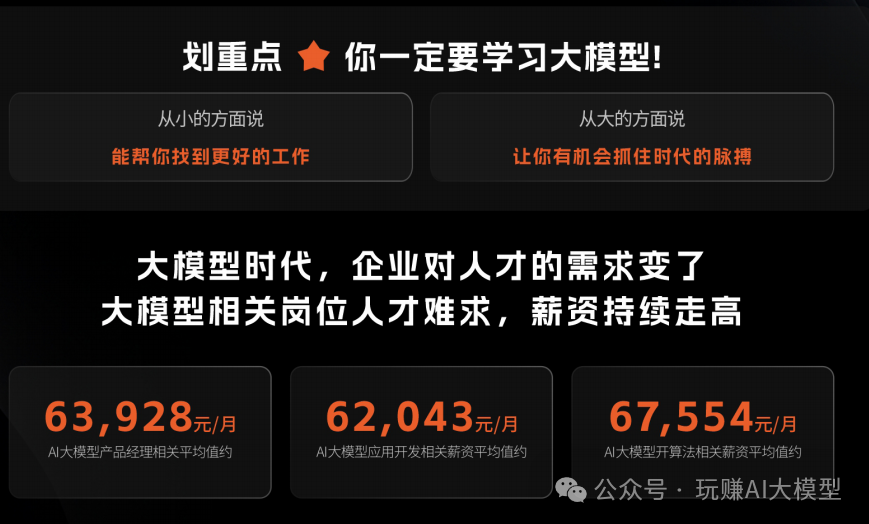
随着AI大模型技术的迅速发展,相关岗位的需求也日益增加。大模型产业链催生了一批高薪新职业:
人工智能大潮已来,不加入就可能被淘汰。如果你是技术人,尤其是互联网从业者,现在就开始学习AI大模型技术,真的是给你的人生一个重要建议!
最后
只要你真心想学习AI大模型技术,这份精心整理的学习资料我愿意无偿分享给你,但是想学技术去乱搞的人别来找我!
在当前这个人工智能高速发展的时代,AI大模型正在深刻改变各行各业。我国对高水平AI人才的需求也日益增长,真正懂技术、能落地的人才依旧紧缺。我也希望通过这份资料,能够帮助更多有志于AI领域的朋友入门并深入学习。
真诚无偿分享!!!
vx扫描下方二维码即可
加上后会一个个给大家发
大模型全套学习资料展示
自我们与MoPaaS魔泊云合作以来,我们不断打磨课程体系与技术内容,在细节上精益求精,同时在技术层面也新增了许多前沿且实用的内容,力求为大家带来更系统、更实战、更落地的大模型学习体验。
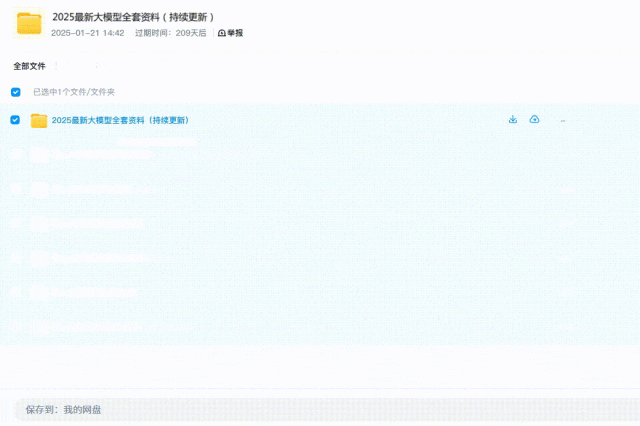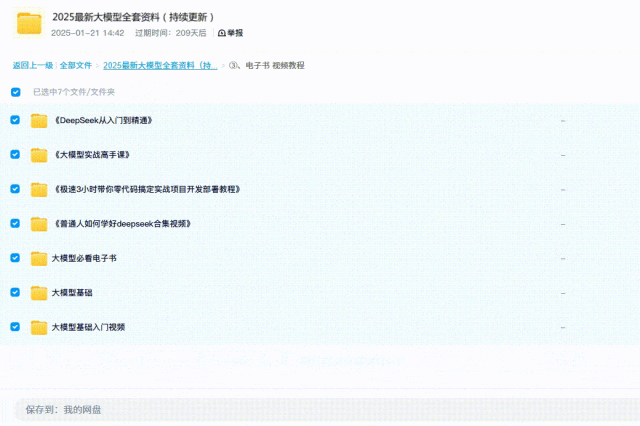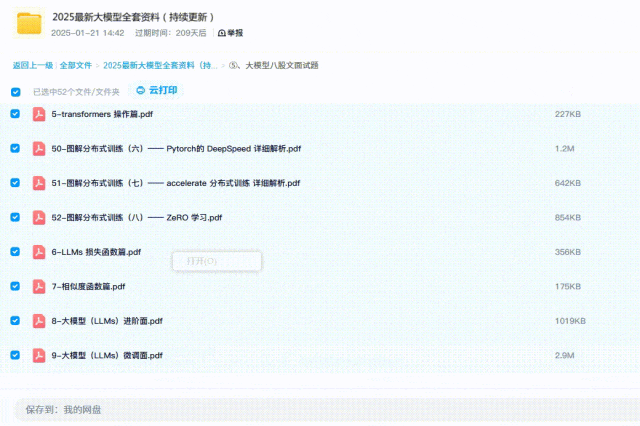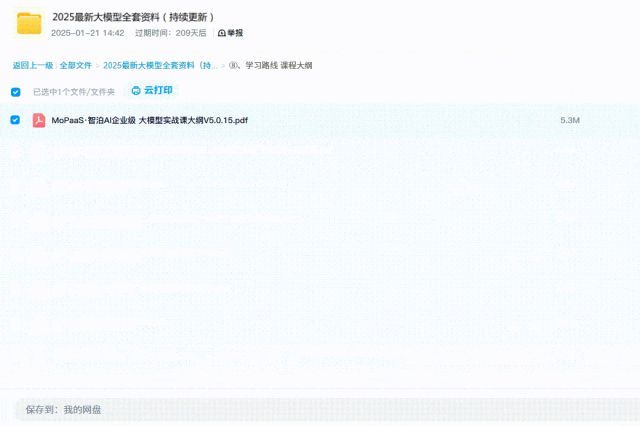
希望这份系统、实用的大模型学习路径,能够帮助你从零入门,进阶到实战,真正掌握AI时代的核心技能!
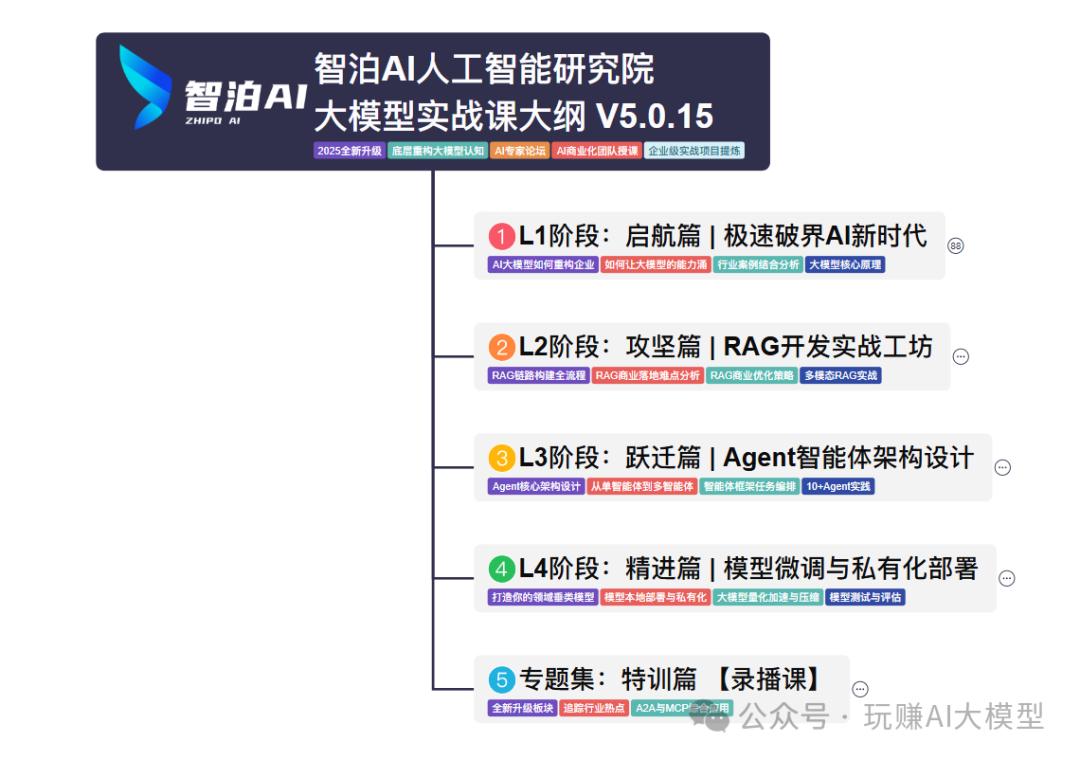
01 教学内容
-
从零到精通完整闭环:【基础理论 →RAG开发 → Agent设计 → 模型微调与私有化部署调→热门技术】5大模块,内容比传统教材更贴近企业实战!
-
大量真实项目案例: 带你亲自上手搞数据清洗、模型调优这些硬核操作,把课本知识变成真本事!
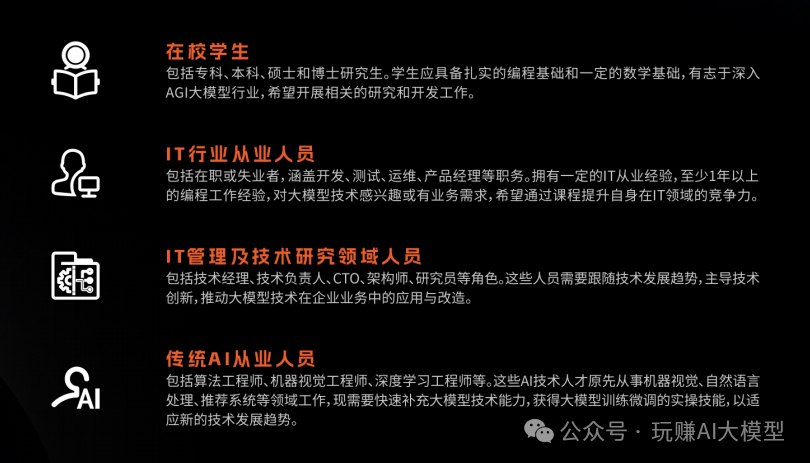
02适学人群
应届毕业生: 无工作经验但想要系统学习AI大模型技术,期待通过实战项目掌握核心技术。
零基础转型: 非技术背景但关注AI应用场景,计划通过低代码工具实现“AI+行业”跨界。
业务赋能突破瓶颈: 传统开发者(Java/前端等)学习Transformer架构与LangChain框架,向AI全栈工程师转型。
vx扫描下方二维码即可
本教程比较珍贵,仅限大家自行学习,不要传播!更严禁商用!
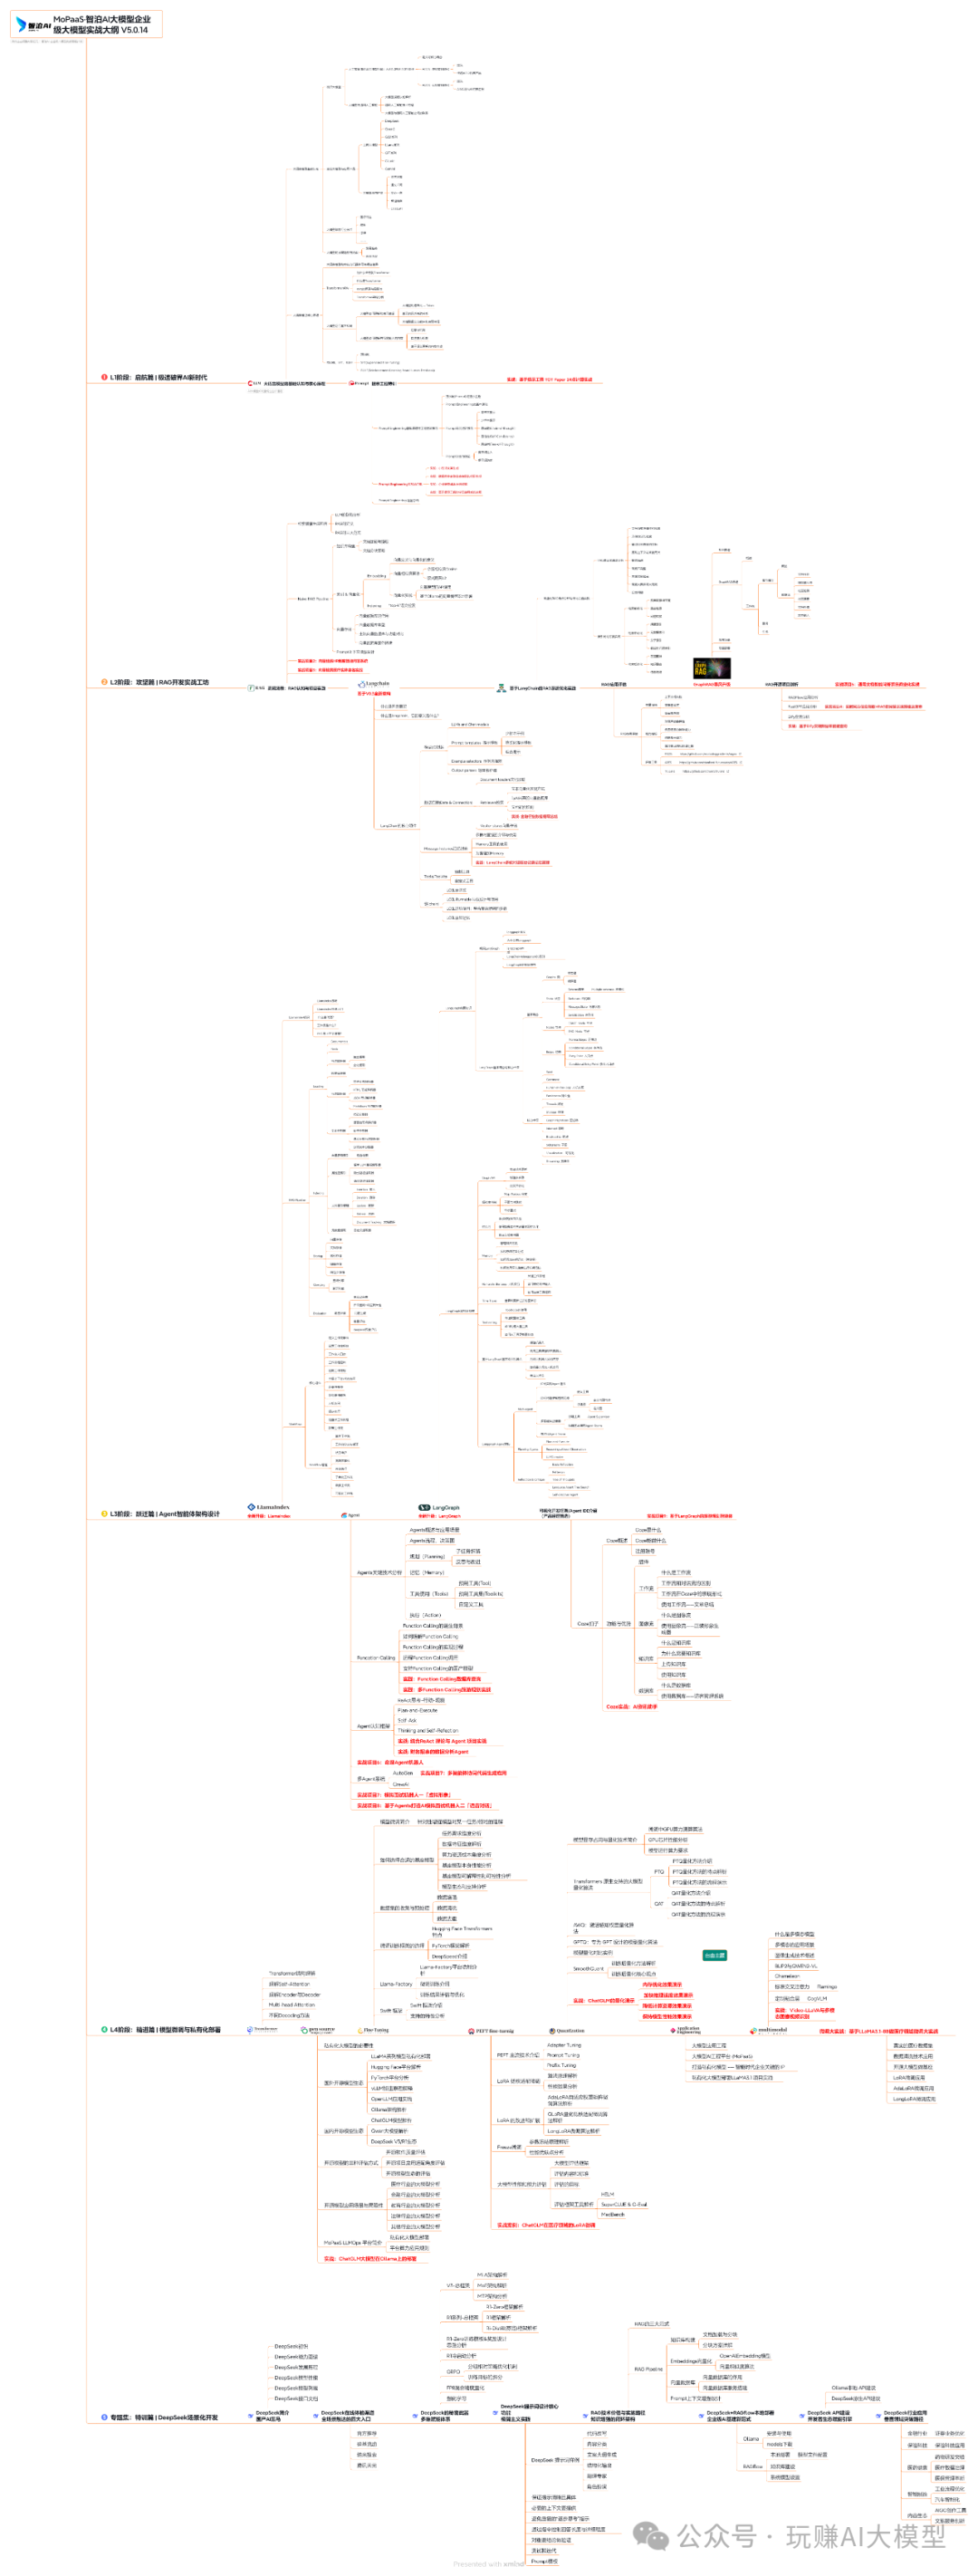
03 入门到进阶学习路线图
大模型学习路线图,整体分为5个大的阶段:
04 视频和书籍PDF合集
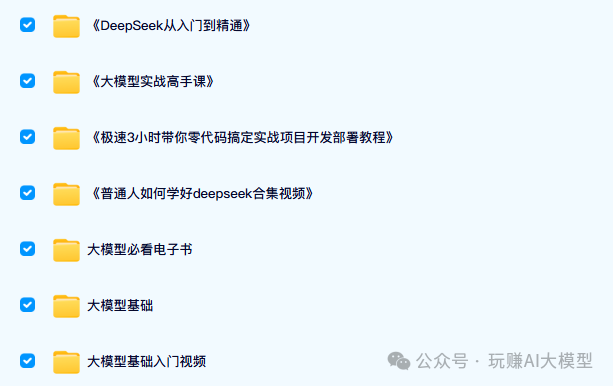
从0到掌握主流大模型技术视频教程(涵盖模型训练、微调、RAG、LangChain、Agent开发等实战方向)
新手必备的大模型学习PDF书单来了!全是硬核知识,帮你少走弯路(不吹牛,真有用)
05 行业报告+白皮书合集
收集70+报告与白皮书,了解行业最新动态!
06 90+份面试题/经验
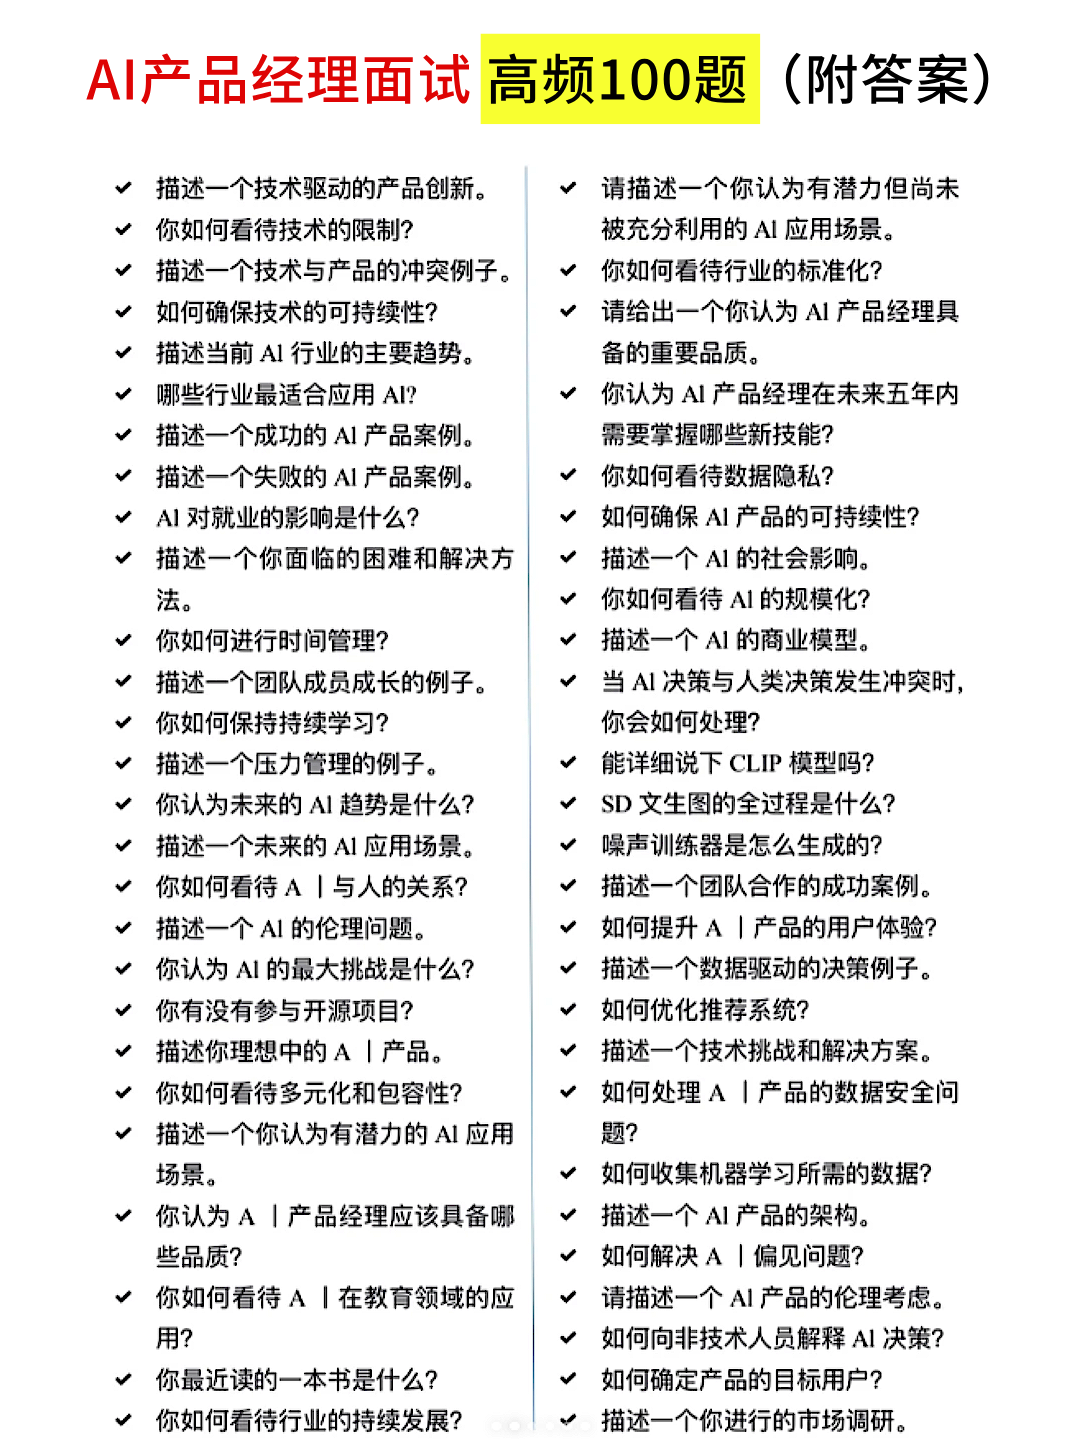
AI大模型岗位面试经验总结(谁学技术不是为了赚$呢,找个好的岗位很重要)
07 deepseek部署包+技巧大全
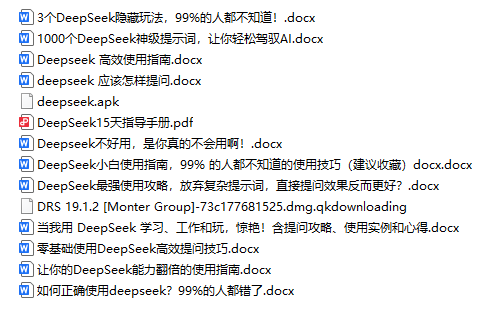
由于篇幅有限
只展示部分资料
并且还在持续更新中…
真诚无偿分享!!!
vx扫描下方二维码即可
加上后会一个个给大家发
为武汉地区的开发者提供学习、交流和合作的平台。社区聚集了众多技术爱好者和专业人士,涵盖了多个领域,包括人工智能、大数据、云计算、区块链等。社区定期举办技术分享、培训和活动,为开发者提供更多的学习和交流机会。
更多推荐
 14
 0
- 0


 已为社区贡献20条内容

所有评论(0)