登录社区云,与社区用户共同成长
邀请您加入社区
基于RAG技术的智能问答系统,具备以下核心特点: 技术架构 采用检索增强生成(RAG)技术路线 支持多格式文档解析(PDF/DOCX/TXT/MD) 兼容Chroma/Milvus向量数据库 可对接DeepSeek/Ollama等大语言模型 核心功能 知识库分类管理 智能文档分块解析 混合检索(语义+关键词) 溯源标注(附带原文参考) 流式问答输出 应用价值 解决大模型幻觉问题 支持企业知识库管理
随着无人机技术在物流配送、电力巡检、应急救援、环境监测等领域的广泛应用,其作业环境逐渐从结构化静态场景向非结构化动态场景拓展。动态环境中存在移动障碍物(如行人、车辆、其他飞行器)、突发障碍(如临时施工区域、天气突变导致的危险区域)等不确定因素,对无人机的自主避障能力和路径规划实时性提出了严苛要求。传统路径规划方法(如 A*、Dijkstra 算法)虽能在静态环境中生成最优路径,但面对动态变化时存在
本文将结合 DeepSeek R1 模型在 Amazon Bedrock 上的无服务器部署案例,展示如何在Free Tier 2.0的环境中快速搭建可用的AI API,从注册到调用,完整体验“云端新起点”。如今,亚马逊云科技正通过Free Tier 2.0与Serverless的组合,让每一个开发者、研究者和企业都能以可负担的方式,进入AI的未来。整个实践证明,在亚马逊云科技的生态中,AI不再是“
摘要:本文介绍了国内首个具备原生视觉理解能力的编程模型Doubao-Seed-Code。相比传统AI模型只能处理文字描述,该产品能直接解析UI图片中的布局、组件和设计语言,并生成可用代码。通过QT仪表盘项目实测显示,其代码生成效果优于ChatGPT等模型。该模型兼容ClaudeCode,迁移成本低,且提供高性价比的订阅方案(最低9.9元/月)。作为国内编程模型的新物种,Doubao-Seed-Co
1.1.关于 DragonHD区域 1:操作区,工具的基本操作包含设置 DDR clk 频率,设置循环次数和启动/停止测试。区域 2:平台用例区,选择平台后该区域显示选定平台的所有用例,用户可屏开,收缩和勾选需要测试的 用例。区域 3:测试信息区,该区域显示设备测试进度,测试状态,测试结果和过程日志信息。区域 4:软件功能区,包含的操作包含打开配置模版,保存配置模板,更新升级,退出软件。
本文探讨了C++头文件重定义问题的两种解决方案:传统的#ifndef宏守卫和现代的#pragma once指令。通过实例分析头文件重复包含导致的编译错误,文章对比了两种方法的优缺点,认为#pragma once更简洁、安全且高效,建议开发者优先采用,仅在特殊兼容性需求时使用传统宏守卫方式。
随着人工智能技术的发展,构建通用人工智能成为一个重要目标。通用人工智能需要具备广泛的认知能力,可以感知环境、进行复杂推理、做出判断,并采取行动参与各类任务。近年来,大语言模型的进步为实现通用人工智能带来了希望。它们在语言理解、推理、知识学习等方面表现卓越,被视为通用人工智能的潜在途径。如何在大语言模型的基础上构建真正的智能体,使其具备自动感知环境、推理规划、执行交互等全方位能力是一个关键课题。本文
摘要 本文深入剖析了C++ STL中vector容器的底层设计与实现原理。重点解析了vector的三大核心指针_start、_finish、_end_of_storage的协同工作机制,通过指针关系判断容器状态,实现高效的内存管理和随机访问。详细介绍了迭代器的原生指针实现方式及其失效场景,包括扩容导致的指针失效问题。文章还探讨了vector的多重构造函数设计,包括默认构造、初始化列表构造和填充构造
MySQL 的核心灵活性之一就是可插拔式存储引擎(Storage Engine)。每个表可以选择不同的引擎,来决定底层的数据组织、索引结构与事务特性。但在实际项目中,几乎所有面试官都会问:“InnoDB 和 MyISAM 有什么区别?为什么 InnoDB 是默认引擎?因为它直接体现你是否真正理解数据库的事务、锁、恢复机制与索引存储方式。InnoDB 和 MyISAM 的区别,不仅是“事务 vs 非
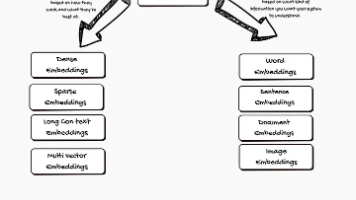
文章深入探讨了嵌入模型在RAG系统中的核心作用,系统介绍了词嵌入、句嵌入、文档嵌入等类型及其适用场景,并解析了上下文窗口、分词方式、维度等关键参数。通过医疗论文检索实例,演示了如何根据实际需求选择合适嵌入模型,并介绍了MTEB基准测试工具的使用方法。文章强调,选择嵌入模型应超越单纯依赖评分,而应综合考虑应用场景、语言支持、专业词汇处理能力等实际因素。
想象一下,你在做金融RAG项目。 你的知识库不是几篇网页文章,而是成堆的 PDF、PPT、扫描件、Excel、合同。这些文件内容格式复杂:
今天,我们必须正视一个问题:对于任何严肃的 Web 应用项目,继续依赖 localStorage 已成为一种技术债。是时候丢掉这根“拐杖”,全面拥抱更强大、更专业的 IndexedDB 了。
随着医疗信息化的深入推进,传统纸质出生证明填报方式逐渐暴露出效率低下、易出错、数据难以追溯与管理等问题。医院需要一种能够高效、准确、规范地收集和管理新生儿出生信息的电子化解决方案。出生证明作为重要的法律文件,其填写流程复杂、涉及字段多、校验规则严格,因此亟需通过信息化手段提升填报效率与数据质量。
文章详细介绍了企业级RAG系统的构建经验,包括文档质量检测与分类处理、层级化分块策略、混合检索方法及置信度驱动路由等技术要点。作者分享了制药、金融等领域10+个实际项目经验,强调了文档质量检测优先、元数据架构比Embedding模型更重要、混合检索是必须的等关键经验,并提供了具体代码示例和工程实践建议。25 年以来写了 55 篇技术 Blog,字数也累计超过 50 万字。每篇内容背后都是几十甚至上
以上只是通用的运行库dll处理方式,如果你遇到缺失文件是第三方的软件文件,那么就需要下载到属于这个程序所匹配的版本的文件,然后将这个文件复制到这个程序的安装目录下才能解决问题。如果我们遇到关于文件在系统使用过程中提示缺少找不到的情况,如果文件是属于运行库文件的可以单独下载文件解决,但还是建议安装完整的运行库,可以尝试采用手动下载替换的方法解决问题!文件下载完成后,下方列表会有很多个不同版本的文件,
DMPC方法通过将每个车辆的控制问题分解为局部优化问题,并利用滚动优化策略进行求解,实现车辆的协同控制。建立车辆动力学模型:考虑异构车辆的动力学差异,采用包含车辆质量、空气阻力系数、滚动阻力系数等参数的非线性车辆动力学模型。设计DMPC控制器:每个车辆作为一个独立的智能体,利用预测状态信息建立自身的优化问题。优化问题的约束包括车辆的动力学约束、控制输入约束和安全距离约束。信息传递机制:每个车辆将自
文章讲述传统后端/系统工程师如何转型进入AI大模型领域。通过展示技术栈迁移、RAG系统构建、模型微调和生产化落地的实践,强调工程思维在AI领域的应用价值。分享了三大生存法则:拒绝算法洁癖、构建监控矩阵和锻炼抽象能力。文章指出,掌握工程化落地的工程师正在重构智能世界的基础架构,传统开发技能与AI技术的融合是未来关键。
本文分享了使用Milvus搭建RAG服务的实战经验,包括云端数据库选择、创建Collection、字段设计、索引设置、数据插入和查询等关键步骤。作者强调应根据项目实际需求决定是否采用RAG,适用于严肃场合或大模型无知领域,而非所有场景都需RAG。提供了清晰的界面操作和API调用方法,帮助读者快速搭建RAG原型。
你是否想过,如何让多个AI“专家”协同完成一项任务?今天,我们将使用Python和功能强大的LangChain框架搭建一个小型AI智能体团队。我们的目标是创建一个具备以下功能的系统:
本文全面解析2025年顶级AI智能体框架,包括LangChain、AutoGen、CrewAI及LangGraph等新兴工具。详细阐述各框架的核心概念、优势、适用场景和代码示例,强调框架在抽象底层细节、提供可组合模块和智能体编排方面的重要性。通过对比表格,帮助开发者根据项目需求选择最适合的框架,加速AI智能体开发进程。
本文探讨了从Prompt Engineering到Context Engineering的关键转变,强调Context Engineering是构建高效AI Agent的核心学科。文章详细介绍了RAG作为基础架构,包括高级分块策略、重排序技术及"Lost in the Middle"问题解决方案,并探讨了智能体系统的上下文管理框架和工作流编排技术。Context Engineering作为连接LL
在LLM驱动的知识检索增强(RAG)领域,主流方法面临困境:
智能体的基础是大模型的函数调用,而框架只是对其能力的封装。**”**我们首先要明确一个概念,即智能体是基于大模型应用设计的一套机制,其本质是大模型提供的函数调用功能(function call),包括现在的MCP服务;而框架只是对这些原生能力的封装,便于开发人员进行功能开发,而不用去处理太多细节性问题。
检索增强生成(RAG)是一种用于构建大型语言模型(LLM)驱动型应用的技术。它借助外部知识源,为大型语言模型提供相关背景信息,从而减少幻觉现象。就好比给 LLM 配备了一个小型的“资料库”,当用户提出问题时,系统会在资料库中查找相关内容并提供给 LLM,以帮助其生成更准确的回答。基本的 RAG 流程包括检索组件(通常由嵌入模型和向量数据库组成)和生成组件(大型语言模型)。在推理阶段,用户问题用于在