登录社区云,与社区用户共同成长
邀请您加入社区
import re"""Markdown 文档结构分析器从 MD 文本中提取各类结构特征,供策略推荐引擎使用。"""# --- 正则模式 ---\[.*?\]\(.*?\)')!)\[.*?\]\(.*?\)')!??]+')# 场景特征检测?r'^(?各正则的作用正则匹配目标示例Markdown 标题## 二级标题表格行| 列1 | 列2 |列表行- 项目1. 步骤代码块标记```python_
Bright Data SERP API 提供一站式搜索引擎结果采集解决方案,解决自建爬虫面临的IP封禁、验证码、限流等问题。该API整合代理管理、反封锁逻辑和数据解析功能,支持全球30+搜索引擎和31种语言,可按城市级定位模拟真实搜索。其优势包括:只为成功请求付费、5秒内极速响应、支持12类结构化结果解析。用户注册后每月享有5000次免费额度,通过简单API调用即可获取JSON/HTML格式的搜
文章摘要: Bright Data Scraper Studio提供两种爬虫工作模式:Code Worker(轻量HTTP协议)和Browser Worker(全浏览器模拟)。前者速度快、成本低,适合静态页面;后者支持JS渲染和交互,适用于动态网站。核心选型原则是优先尝试Code Worker,仅当数据不全时切换Browser Worker。针对多阶段任务(如列表页+详情页),推荐开启分段配置(W
现在很多安全工具都在集成AI,但模式都是“脚本调用AI来分析输出”。我试着把这个关系倒过来——让AI坐在操作席上,自己决定每一步该做什么。这个框架在DC-1靶机上能稳定运行:只给一个IP,AI自己完成了从扫描到提权的完整攻击链。过程中它出现了一些让我意外的行为,比如理解模糊的提示、从错误中自我纠正。本文是对这次尝试的如实记录。
基于RAG技术的智能问答系统,具备以下核心特点: 技术架构 采用检索增强生成(RAG)技术路线 支持多格式文档解析(PDF/DOCX/TXT/MD) 兼容Chroma/Milvus向量数据库 可对接DeepSeek/Ollama等大语言模型 核心功能 知识库分类管理 智能文档分块解析 混合检索(语义+关键词) 溯源标注(附带原文参考) 流式问答输出 应用价值 解决大模型幻觉问题 支持企业知识库管理
① 文档处理“重切割、轻结构”,源头丢失语义;② 检索策略“单一化、无优化”,无法支撑工业级场景;③ 长文档处理“缺分层、少关联”,上下文完整性不足。针对这三大短板,以下“三板斧”解决方案可实现全链路语义保障。尼恩提示:要拿到 高薪offer, 或者 要进大厂,必须来点高大上、体系化、深度化的答案, 整点技术狠活儿。只要按照上面的 尼恩团队梳理的 方案去作答, 你的答案不是 100分,而是 120
功能:指定预训练模型的仓库地址(来自 Hugging Face Hub)细节解析:专门优化句子嵌入的库,基于 Hugging Face Transformers 封装,适合语义相似性、文本匹配任务:模型基座是 RoBERTa(优化版 BERT),"large" 表示模型规模(隐藏层维度 1024),专门为句子级嵌入训练,知识图谱中用于将实体描述、关系描述等文本转换为语义向量(后续用于实体匹配、关系
利用MCP实现电商决策智能助手
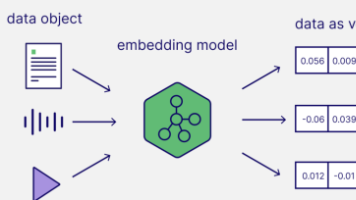
向量检索是目前 RAG匹配文档最重要的实现方式之一,其有效性和性能关系到RAG的可用性。这是常识通过sklearn余弦相似度,示例使用向量相似度的方法匹配文档的过程。除ollama进行向量计算外,示例过程仅使用numpy、sklearn,最基础展示文档相似匹配过程。
随着人工智能技术的发展,构建通用人工智能成为一个重要目标。通用人工智能需要具备广泛的认知能力,可以感知环境、进行复杂推理、做出判断,并采取行动参与各类任务。近年来,大语言模型的进步为实现通用人工智能带来了希望。它们在语言理解、推理、知识学习等方面表现卓越,被视为通用人工智能的潜在途径。如何在大语言模型的基础上构建真正的智能体,使其具备自动感知环境、推理规划、执行交互等全方位能力是一个关键课题。本文
HTML_FILE="/storage/emulated/0/Download/OnePlus Share/11.14 脚本测试/index.html"WWW_SRC_DIR="/storage/emulated/0/Download/OnePlus Share/11.14 脚本测试" # ← 整目录。echo "APK 已保存到:${OUT_DIR}/${APK_NAME}"echo "APK
本文系统梳理了RAG中数据加载与文本分块策略,从基础到高级方法详解,强调高质量分块是检索与生成效果的基石,助你构建更可靠、高效的RAG系统。
本文系统分析了多种先进RAG(检索增强生成)技术的核心架构与应用场景。T-RAG专注于表格数据处理,GraphRAG利用知识图谱增强推理能力,CRAG引入检索质量校正机制,Self-RAG通过自反思优化生成质量,RAG-Fusion采用多查询融合提升召回率,Rewrite-Retrieve-Read则通过查询重写优化检索效果。各技术针对不同需求场景具有独特优势,如复杂推理推荐GraphRAG,多轮
本文介绍Spring AI框架,它为Spring开发者提供统一API抽象,让AI集成变得简单。文章详解其核心概念(模型抽象、提示模板等),并通过代码示例展示基础应用、流式响应、RAG实现和模型路由等功能,同时提供企业级应用的最佳实践与常见陷阱解决方案。
本文介绍了强化学习的基本概念及DQN算法实现。强化学习中智能体通过状态转移和奖励函数与环境交互,DQN算法通过神经网络替代传统Q表来预测动作价值。文章详细说明了单模型DQN的实现过程,包括游戏环境定义、神经网络构建、数据池管理和训练流程。并针对单模型可能存在的价值高估问题,提出双模型DQN改进方案,通过延迟更新目标网络来提高稳定性。此外还介绍了三种进阶改进:加权数据池采样优化训练数据选择;Duel
数据中心代理则来源于云服务器或机房节点,延迟低、速度快、成本较低,适合进行大规模、高频率的数据采集,但由于集中度高、特征明显,几乎不被识别,因此更适合初步采集或趋势分析场景。移动代理的IP则来自4G或5G移动网络节点,每次请求都经过手机基站分配临时地址,其真实性和随机性极强,几乎不被识别,非常适合移动端搜索排名与App内SEO优化的数据采集,但价格昂贵、稳定性略受限制。通过动态更新代理节点,我们可
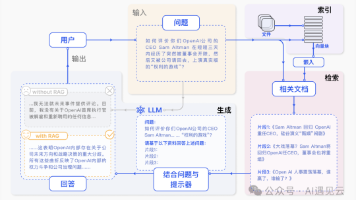
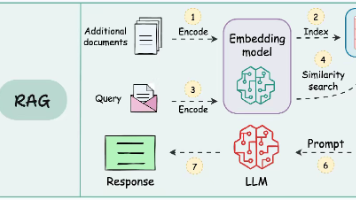
在人工智能领域,检索增强生成(Retrieval Augmented Generation, RAG)是一种结合信息检索和生成式人工智能的技术,它通过从外部数据源中检索相关信息,来辅助大语言模型(Large Language Model, LLM)生成更为准确、上下文相关的答案。
但是我们也不能将所有文件都放入知识库中,而应区分文件是否与用户需求相关,判断它是针对某次具体需求,还是某一类需求都会涉及该文件。对于仅针对当前问题的一次性需求,应引导客户通过对话窗口上传文件并提问,接着利用插件解析文件内容,并将其放入 prompt 中。
想象一下,你在做金融RAG项目。 你的知识库不是几篇网页文章,而是成堆的 PDF、PPT、扫描件、Excel、合同。这些文件内容格式复杂:
程序员必看!什么是 RAG?为什么学大模型一定要懂它?
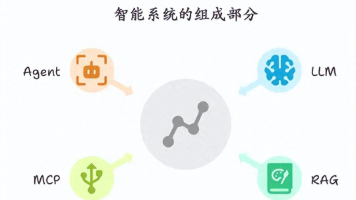
一句话总结:LLM 是核心的智力,而 RAG、MCP、Agent,则是在这个智力基础上,搭建起来的知识体系、协作体系和执行体系。
RAG系统优化:相似度召回与重排序的协同作用 本文探讨了RAG系统中相似度召回与重排序的协同工作机制。相似度召回负责从海量文档中快速筛选候选内容,而重排序则对召回结果进行精细筛选,提高最终输出的准确性。作者通过实际案例展示了两种方法的互补性:当降低相似度阈值提高召回率时,重排序能有效过滤无关内容。文章还对比了Embedding模型的高效性与Reranker模型的精准性,指出两者结合可实现效率与准确
基于RAG的法律条文智能助手(方案篇),实现与部署,微调与部署
本文提供了在PyCharm中搭建RAG系统的完整指南,包含环境配置、工具安装和代码实现等关键步骤。教程首先介绍如何配置conda虚拟环境和安装必要的Python包(如chromadb、langchain等),然后详细说明如何启动向量数据库和部署Ollama大语言模型。最后通过代码示例演示了知识库加载和向量存储的实现过程。文中还附赠大模型学习资料包,包含学习路线、实战案例和面试题库等内容,适合零基础