登录社区云,与社区用户共同成长
邀请您加入社区
本文记录了将 kotlinx-datetime 适配至 OpenHarmony 的完整过程。针对其缺乏 ohosArm64 发布物的问题,通过接入 HarmonyOS Kotlin 定制版、声明 target 并复用 Native 实现,成功构建兼容库。核心难点在于时区数据缺失——沙箱环境无 /usr/share/zoneinfo,遂结合 @ohos.i18n 获取系统时区 ID,并回退至内置 T
本文详细记录了将KMP生态中的导航框架Decompose适配至OpenHarmony的过程。基于Essenty已实现的生命周期与状态管理,利用其与Decompose组件上下文的高度兼容性,仅需补充4个平台相关声明中的3个(锁、主线程检查、错误打印),并显式声明ohosArm64 target及依赖nonWebMain源集,最终成功构建HAR包并在真机上验证导航、返回键、状态保留等核心功能。整个过程
我们的三个正式目标平台是Android、iOS和HarmonyOS。它们不是空白工程:登录、交易、行情、权限、埋点、路由、主题,都已经在各自宿主中长期运行。任何跨端方案如果要求这些能力整体重写,代价都会远高于收益。因此一开始就有一个前提:跨端层只能以增量方式进入宿主,原生继续负责自己擅长、也必须负责的部分。H5是项目当前主要使用的跨平台技术。在需求变化快、展示型内容较多的场景中,H5仍然高效,发布
针对组件下沉到原生平台后「身份、可访问性文案、源码位置」等信息丢失的问题,团队提出了「编译期记录调用点 + 运行时采集高层语义」的方案,支撑 AI 精准定位、代码修改与自动化测试,为连接编码、运行与验证搭建了基础能力。正如多位嘉宾反复强调的:AI 的价值不在于「能生成代码」,而在于「能稳定交付」。面对存量代码规模大、文档缺失与零异常上线的高质量要求,团队构建了分阶段 AI 转移流水线,遵循「上下文
AC自动机是一种高效的多模式匹配算法,结合Trie树和KMP思想,支持O(n+m+z)时间复杂度匹配。其核心包括Trie结构、失败指针和输出链,通过构建阶段预处理模式串,搜索阶段快速跳转匹配。Java实现展示了节点结构、插入模式串、构建失败指针和文本搜索的全过程。算法适用于敏感词过滤、DNA匹配等场景。优化策略包括数据结构精简、构建过程改进和内存优化,可提升30-50%性能。AC自动机的高效性使其
在数据结构与算法课程中,串的匹配中,时间和空间消耗最大的是BF蛮力法。基于BF蛮力法的低效率,KMP算法减少了不必要的无效匹配。算法中的核心是要对子串计算next值下面先来看下公式的定义:这个公式比较抽象,我们用这个公式来看看教材上的一个子串的计算过程。模式串的index计算j123456789...
本文记录了将KMP存储库KStore适配至OpenHarmony的完整过程。针对官方无ohosArm64产物的问题,通过接入HarmonyOS Kotlin定制版、声明目标平台、解决沙箱路径缺失难题(采用“应用层传路径”方案),并成功导出能力给ArkTS、打包HAR接入鸿蒙工程,最终在真机验证数据持久化功能。文章剖析了KStore源码结构与适配关键点,总结八条踩坑清单,为同类KMP库鸿蒙化提供可复
本文为Kotlin Multiplatform三方库鸿蒙化适配系列第三篇,聚焦于KMPNotifier在OpenHarmony上的适配。作者放弃等待上游支持与自绘通知UI,选择通过ArkTS桥接@kit.NotificationKit,将跨平台通知模型接入鸿蒙系统。核心挑战在于鸿蒙通知点击需经WantAgent回灌至EntryAbility,重构事件模型。文章详细记录6个ArkTS真实签名踩坑,最
本文为KMP库鸿蒙化适配第三篇,聚焦Essenty库的时序假设问题。与前两篇“能力缺失”不同,Essenty依赖平台在正确时机通知生命周期并保存状态,鸿蒙无现成宿主导致状态丢失隐晦难查。作者将库分三类:纯逻辑层(无需修改)、平台注入层(需实现*Owner接口)、落盘层(用kotlinx-serialization输出JSON,对接kotlinx-io沙箱)。通过将OpenHarmony生命周期映射
本文详述了将 Kotlin Multiplatform 三方库 kotlinx-datetime 适配至 OpenHarmony 平台的全流程。针对 ohosArm64 缺失官方构建产物的问题,通过接入 HarmonyOS Kotlin 定制版插件、声明 target 并复用 Native 实现,成功编译通过。核心难点在于时区数据缺失——因 OpenHarmony 沙箱无 /usr/share/z
Vico 是一个面向 Compose Multiplatform 的多平台图表库。它的核心价值不在某一个页面,而在于图表模型、数据范围、坐标轴、图层和交互状态可以在共享代码中组织,然后交给不同平台的渲染层显示。
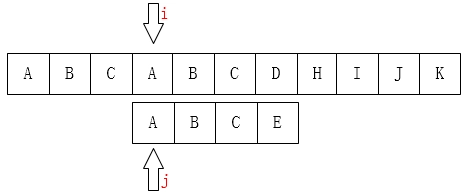
周一学了KMP算法,这几天一直都搞不懂为什么,所以准备好好整理一下KMP的门道。KMP算法就是两个字符串在匹配过程中,子串在主串中第一次出现的位置,之前的BF算法是i、j每次都在两个字符串中遍历,若发生错误,i每次回溯到i+1的位置,j回溯到0,这样理解是非常简单的,时间复杂度是O(M*N),为了对字符串匹配问题进行优化,所以出现了KMP算法,KMP算法的时间复杂度是O(M+N),节省了很多的时间
字符串有很多比较经典的算法问题,例如:LIS(最长递增子序列)、LCS(最长公共子序列、最长公共子串)、LCP(最长公共前缀)、LPS(最长回文子序列、最长回文子串)、ED(最小编辑距离,也叫 “Levenshtein 距离”)、 KMP(一种字符串匹配的高效算法)。上面列举的经典问题,在 Leetcode 中都有对应题型,这些也是笔试面试经常会遇到的基本题型。上面列举的三个经典匹配算法中,KM.
前言The years teach much which the days never knew.Time:2017/2/19Name:Willam1、介绍对于文本程序来说,找出一个子串在文本中的位置是特别重要的,我们称那个子串为模式串(pattern),然后我们称寻找的过程为:模式匹配(string match)。2、实现算法(1)—朴素字符串匹配算法原理:从
题目链接:HDU5763Another MeaningTime Limit: 2000/1000 MS (Java/Others) Memory Limit: 65536/65536 K (Java/Others)Total Submission(s): 843 Accepted Submission(s): 391Problem Descripti
KMP算法是一种字符串匹配算法用于在一个文本串中查找某个子串出现的位置。KMP算法的原理是根据模式串的特点,在匹配过程中避免重复匹配已经匹配过的部分。
给定长度分别为 $n,m$ 的整数序列 $A,B$ 和常数 $W,d$,序列从 $1$ 开始标号,保证 $A_i,B_i \in [1,W]$。容易发现,我们有 $\binom{W}{d}$ 种方案选择 $[1,W]$ 中的 $d$ 个互不相同的整数。对于每一种选择的方案,我们删去 $A$ 中出现的对应的 $d$ 种整数,令此时序列 $B$ 在序列 $A$ 中的出现次数为这次选择方案的权值。你需要
王道408数据结构第四章,串的模式匹配。考试中不大可能考察KMP的算法代码,也不会考察KMP的优化,需要掌握手动求KMP的next数组,以及掌握朴素模式匹配算法及KMP算法的时间复杂度。一、朴素模式匹配算法最坏时间复杂度为O(mn),即每次都在最后一个字符时匹配失败。最好时间复杂度为O(m),即一次就匹配成功,也有说法是O(1),因为一般模式串的长度都为常数级。其中m表示模式串的长度,n表示主串的
目录概念简述KMP算法原理代码计算next数组KMP算法测试概念简述从s中匹配t串,在BF算法中,通过指针回溯不断进行匹配,其思想是穷举。效率很低,但有些串有一定的规律,不需要回溯s串的指针,这就是KMP算法。比如 s:aaaaaabt: aaab在进行比较时,如果按照BF算法,需要进行最后一次才能匹配成功。但是我们发现s和t串前几位是相同的,不需要重复比较。当然,计算机不会像人这么敏感,但是能否
暴力匹配复杂度最高的串匹配算法,串暴力匹配算法。复杂度为O(mn);思路很简单,在S串上挨个儿匹配T串。代码如下:#include <iostream>#include <string>#include<bits/stdc++.h>using namespace std;#define maxlin 55int Index(string S,string T){
计算机上的非数值处理的对象大部分是字符串数据, 字符串一般简称为串。串是一种特殊的线性表, 其特殊性体现在数据元素是一个字符, 也就是说, 串是一种内容受限的线性表。
给定一个非空的字符串,判断它是否可以由它的一个子串重复多次构成。给定的字符串只含有小写英文字母,并且长度不超过10000。
一、暴力匹配算法(BF)BF全称为Brute-Force,最简单直观的模式匹配算法。1.算法思想两个字符串进行匹配时,一个主串和一个模式串,就是按照我们最容易想到的算法来进行匹配。用两个变量i,j分别记录主串和模式串的匹配位置,如果两者在某个字符不匹配,则将记录主串匹配位置的变量i回退到匹配前i的位置的后一个位置,将j回头到模式串的第一个字符位置;如果i和j指向的主串和模式串字符匹配,...
一、串的定义串(string)是由零个或多个字符组成的有限序列,又名叫字符串。一般记为s=”a1a2……an”(n≥0),其中s是字符串的名称,用双引号括起来的字符序列是串的值,引号不属于串的内容。ai(1 ≤ i ≤ n)可以是字母、数字或其他字符,i就是该字符在串中位置。串中的字符数目n称为串的长度,定义中谈到“有限”是指长度n是一个有限的数值。两个字符的串称为空串(null string),
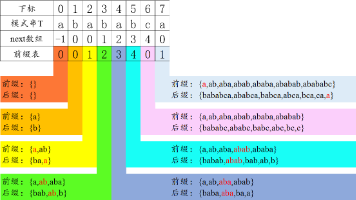
● 基于字符串下标从 1 计算这个前提,next[] 数组的涵义为:next[i] 表示字符串前 i 个字符的最长公共前后缀长度。
KMP算法相比于朴素的模式匹配算法,其改进之处在于:利用已经得到的“部分匹配”结果将模式串向右“滑动”尽可能远的距离。该算法的关键在于next函数的计算,next函数的定义如下:我们介绍两种方法来计算模式串的next函数方法一:传统方法方法二:简便方法...
KMP主要应用在字符串匹配上的算法,该算法是由和Pratt三位学者发明的,故称之为KMP算法KMP的主要思想是当出现字符串不匹配时,可以知道一部分之前已经匹配的文本内容,可以利用这些信息避免从头再去做匹配了。现在有两个字符串分别为aabaabaafa和aabaaf,现在我们要用后者去匹配前者,在没有用KMP算法之前,只能一个一个枚举进行匹配,这时我们不难发现到会有一些公共的前缀被频繁使用,但是暴力
串的模式匹配,运用算法KMP算法详解,求next数组,KMP算法的模式匹配过程,每一步都配图解和文字描述,都有源码,源码都经过调试,可以放心使用,最后有给出一道leetcode例题练手。
此外,在所有可接受的变体中,Asterix选择了最长的一个(因为Asterix喜欢长字符串)。当Asterix大声读出子串t的时候,神庙的门就打开了。然后,Asterix认为密码是字符串s的某个子串t。而Obelix认为t应该位于字符串s的某个地方,也就是说,t既不是它的开头,也不是它的结尾。然而,它的门被牢牢地锁住了,即使是Obelix也没能打开它们。如果不存在合适的t字符串,则打印 "Just
KMP算法 next数组解析本文很多词汇为 个人创造,如:最长匹配真前后缀、 次级最长匹配真前后缀 等。如有表述不清,请联系我。 接上篇:next 数组 主要记录 子串 的 每一个前缀(按顺序)的 最长匹配真前后缀 的长度。这里讲一下 求解原理。数组从零开始,第一个数 “-1” ,代表不存在;(有的以 “0”,为起点代表空,这不矛盾,全加1 ,即为此格式)此数...
一、简介在进行字符串匹配时,KMP算法与朴素算法最大的区别就在于KMP算法省去了主串与子串不必要的回溯,这也是KMP算法(在主串有较多重复时)更加高效的关键。例如:主串:a b c d e f g a b ...子串:a b c d e x若用朴素算法进行匹配:第一次循环:0 1 2 3 4 5 6 7 8a b c d e f g a b ......
OulipoTime Limit:1000MSMemory Limit:65536KB64bit IO Format:%lld & %lluSubmitStatusPracticePOJ 3461Appoint description:DescriptionThe French author Georges Perec (1936–1982) once wr
KMP算法是一种改进的字符串匹配算法,由D.E.Knuth,J.H.Morris和V.R.Pratt同时发现,因此人们称它为克努特——莫里斯——普拉特操作(简称KMP算法)。KMP算法的关键是利用匹配失败后的信息,尽量减少模式串(待搜索词)与文本串的匹配次数以达到快速匹配的目的。具体实现就是实现一个next()函数,该函数本身包含了模式串的局部匹配信息。
题意:给出一个字符串,求出最大的前缀和后缀且它能在串的中部找到,若存在则输出,否则输出Just a legend思路:KMPnext数组的应用,一些细节要非常注意!
KMP
——KMP
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 开源鸿蒙跨平台开发者社区


 EazyDevelop社区


 乐奇 Rokid 开放社区



 天工造物局




 DAMO开发者矩阵