登录社区云,与社区用户共同成长
邀请您加入社区
Linux内核中红黑树的使用方法可以参考:linux/Documentation/rbtree.txt文件。本文的Linux内核以4.1.15版本为例。 红黑树是一种自平衡二叉搜索树,用于存储可排序的键/值数据对。 这与根树不同是用来有效地存储稀疏数组,从而使用长整数索引插入/访问/删除节点)和哈希表(它们没有被排序容易按顺序遍历,并且必须针对特定的大小和哈希函数,rbtrees可以优雅地扩
RS485接线要盯准A/B端子,施耐德变频器标注的+/-对应西门子的B/A(反常识警告!西门子1200plc与施耐德变频器modbus通讯程序,可以控制变频启停,设定频率,读取变频器电压、电流、运行频率,博图V14版本程序。西门子1200plc与施耐德变频器modbus通讯程序,可以控制变频启停,设定频率,读取变频器电压、电流、运行频率,博图V14版本程序。数据解析时记得处理高低字节,西门子默认的
c语言实现b树
最近学习了树和二叉树的知识,所以今天写了一个关于树的创建和遍历的代码。树的三种遍历方式,分别是,先序遍历:根左右,中序遍历:左根右,后序遍历:左右根。然后需要创建链表,存放根结点和左右孩子。递归遍历:#include<stdio.h>#include<stdlib.h>struct bitnode{char Date;//根结点struct bitnode* Lchild;
业务场景优化手段预期收益指标超高并发点查缩短键长度+增大填充因子QPS提升30%~50%海量数据范围查询冷热分离+压缩叶子节点查询延迟降低60%+混合读写负载使用FPGA加速B+树遍历吞吐量提升3倍SSD环境调整innodb_io_capacity参数IOPS利用率提高40%阿里内部数据:在双11大促中,经过B+树优化的订单库可支撑峰值58万次/秒的查询请求,平均延迟<5ms。-- 检查页利用率。
MySQL主要使用B+树索引(如InnoDB引擎),它与B树在结构和性能上有显著差异。B树数据存储在所有节点,而B+树仅叶子节点存储数据,非叶子节点为索引;B+树的叶子节点通过链表连接,使其范围查询效率更高(只需遍历链表)。B+树的优势包括:更稳定的索引结构、更高的磁盘IO性能、更好的范围查询支持。MySQL选择B+树因其更适合数据库场景,特别是InnoDB引擎的高效排序和范围查询需求。相比之下,
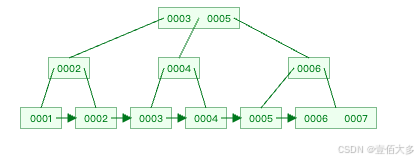
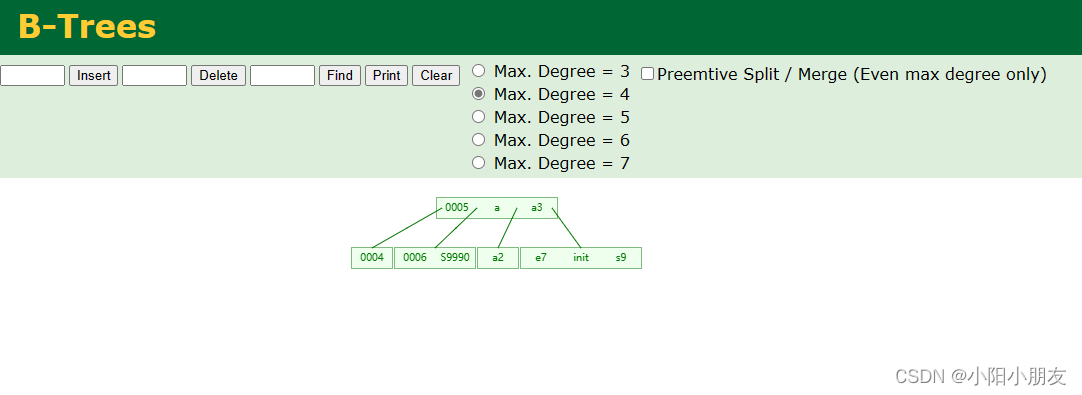
B树是一种自平衡的多路搜索树,用于数据库索引和文件系统。多路搜索:每个内部节点可以有多个子节点。键值分布:键值分布在内部节点和叶子节点,每个节点的键值将子节点分隔开。平衡性:B树在插入和删除操作中自动保持平衡。适用性:适用于读写操作,尤其是随机访问。B+树是B树的变体,专为数据库索引设计。所有数据在叶子节点:所有记录数据仅存储在叶子节点。非叶子节点仅存储键值:非叶子节点不存储实际的数据记录,只存储
5 | 11 ]5、11就是两个关键字。[5 | 11]/ | \k个关键字→ k+1棵子树2个关键字→ 3棵子树。
摘要 B树和B+树是针对大数据量存储优化的多路平衡查找树。B树通过每个节点存储多个数据减少磁盘I/O次数,降低树高度(如9阶B树高度仅为AVL树的1/3),但存在空间浪费(节点存储索引和地址)、区间查询效率低等缺点。B+树改进为终端节点存储数据地址,非终端节点仅作索引,进一步降低高度并支持高效区间查询。B树适合数据库管理和磁盘存储,而B+树更适合需要频繁范围查询的场景。两种树均通过节点分裂/合并保
业务场景优化手段预期收益高并发OLTP保持默认RR+合理索引吞吐量提升30%+混合分析查询会话级降级到RC查询延迟降低60%热点数据冲突应用层乐观锁+重试机制死锁减少90%分布式事务使用Seata的AT模式兼容RR语义,性能损失<5%阿里内部实践:通过将订单查询系统性能提升40%,同时通过关键操作维持一致性。
的意义它是一个零开销的占位符,标记结构体末尾动态数据的起始地址,使能直接访问连续内存。的原因编译器将零长度数组视为 0 字节成员,不参与结构体大小计算。适用场景高效管理网络数据包、二进制流等变长结构(如 Linux 内核的sk_buff结构)。本章主要讲解了 Linux 内核和 Linux 内核编程的基础知识,为读者在进行 Linux 驱动开发打下软件基础。
B+ 树是一种 自平衡的多叉搜索树,常用于 数据库索引(如 MySQL)和文件系统。它是 B-树(B-tree)的变种,具有更高的磁盘读写效率和范围查询性能。特点:1 所有数据存储在叶子节点,非叶子节点仅存储索引键,不存数据。2 叶子节点之间有指针相连,支持高效的区间查询。3 多路平衡树(非二叉树),每个节点最多有 M 个子节点(M 阶 B+ 树)。4 根节点到叶子节点的路径长度相同,保持树的平衡
1.这是一个正常的,没有碰到极端情况的二叉搜索树。如果数据是有序的或者在删除,插入操作下,那么可能会退化成一条链。严重影响性能。
题目:完全二叉树的层序遍历一个二叉树,如果每一个层的结点数都达到最大值,则这个二叉树就是。对于深度为 D 的,有 N 个结点的二叉树,若其结点对应于相同深度完美二叉树的层序遍历的前 N 个结点,这样的树就是。给定一棵完全二叉树的后序遍历,请你给出这棵树的层序遍历结果。
看不懂红黑树,就看这一篇吧,介绍的红黑树的概念和使用,有红包哦
1. 前序遍历二叉树的传统访问分为:前序、中序、后序、层序。其中前三者是递归访问,但是递归是有缺陷的,树太深就会栈溢出。因此本文我们思考如何使用非递归的方法来完成遍历。1. 前序遍历要迭代⾮递归实现⼆叉树前序遍历,⾸先还是要借助递归的类似的思想,只是需要把结点存在栈中。
JavaOlogn−On)On)1Ologn)Ologn)MMM−1keyvaluekeyvaluekeyvaluekeyvaluekeyvaluevalueOlogn)keyvalue。
learning note
数据结构基础
B树和B+树
在计算机科学和数据结构领域,二叉树是一种基本的数据结构,常用于实现各种算法和数据处理。在二叉树的概念中,有两个重要的子类:完全二叉树和满二叉树。本文将详细介绍这两种类型的二叉树,探讨它们的特点、区别以及应用场景。
与传统的B树相比,B-link中的每个节点都是一个链表,而不是单个元素。B-link的安防显著的特点是高效。与传统的B树相比,B-link在进行插入和删除操作时也非常高效。在这些系统中,B+-tree和B-link是常用的索引方式。B-link的具体应用可能有所不同,但它的基本原理是相似的,可以简单地概括为“链表+索引”。B-link的高效性和空间利用率高成为了它应用广泛的关键所在。B-link是
B 树的阶在学习 B 树之前,我们先了解一下 B 树是为了解决什么问题的吧,在我们之前学习的数据结构中,处理的数据都是在内存中操作,因此考虑的都是内存的时间复杂度,但是如果我们要操作的数据集非常大,大到内存没办法处理了怎么办?
数据结构二叉树
数据结构学习-B树删除示例
1970年,R.Bayer和E.mccreight提出了一种适合外查找的树,它是一种平衡的多叉树,称为B树。外查找即在不在内存当中查找,通常是在磁盘,磁盘数据通常挨着挨着存,所以只能通过建立索引的方式去找到对应的数据地址。由于AVL,红黑树的高度过高,采用这类数据结构会导致IO次数过多,所以我们通常选择层数更低的B树或者B+树。原理即是让每一层更多。并且B树天然平衡,呈现向右向上增长的趋势。B树的
c语言实现层次遍历二叉树完整代码
树形结构指的是数据元素之间存在着“一对多”的树形关系的数据结构,是一类重要的非线性数据结构,本篇重点讲解它。
树是n(n≥0)个结点的有效集合,n=0时,称为空树,这是一种特殊情况。在任意一颗非空树中应该满足:5.6 二叉树的层序遍历先序遍历森林:若森林为非空,则按如下规则进行遍历:若森林为非空,则按如下规则进行遍历:
索引是存储引擎中一种用于快速找到数据的存储结构,他就像《新华字典》的目录,可以使我们查每个字的速度大大提升。下面将结合计算机的存储带大家深入理解索引的优点。下图左边使一个磁盘,在这个磁盘中存放数据是随机的,如果要查找某条数据,需要在整个磁盘空间进行扫描,十分耗时。下图右边(表格部分)改进了这一做法,在磁盘中开辟了一块连续的存储空间,数据也是连续存储,如果我们需要找第六条数据,只需要进行顺序访问,时
数据结构之二叉树
二叉排序树(BST)二叉排序树:BST(Binary Sort(Search) Tree),对于BST中任何一个非叶子结点,要求左子节点的值比当前结点的值小,右子节点的值比当前结点的值大。对于相同的值,可以将该结点放在左子节点或者右子节点代码实现添加结点:根据结点的值,将值小的结点放在左边,值大的结点放在右边遍历结点:与一般树的前中后序遍历无异删除结点:删除叶子结点:找到需要删除的结点的父结点,然
一.堆的相关概念什么是堆?堆本质上是一种完全二叉树,它分为两个类型:1.大根堆。2.小根堆。什么是大根堆?什么是小根堆?性质:每个结点的值都大于其左孩子和右孩子结点的值,称之为大根堆;每个结点的值都小于其左孩子和右孩子结点的值,称之为小根堆。如下图:...
HashMap为什么要使用红黑树
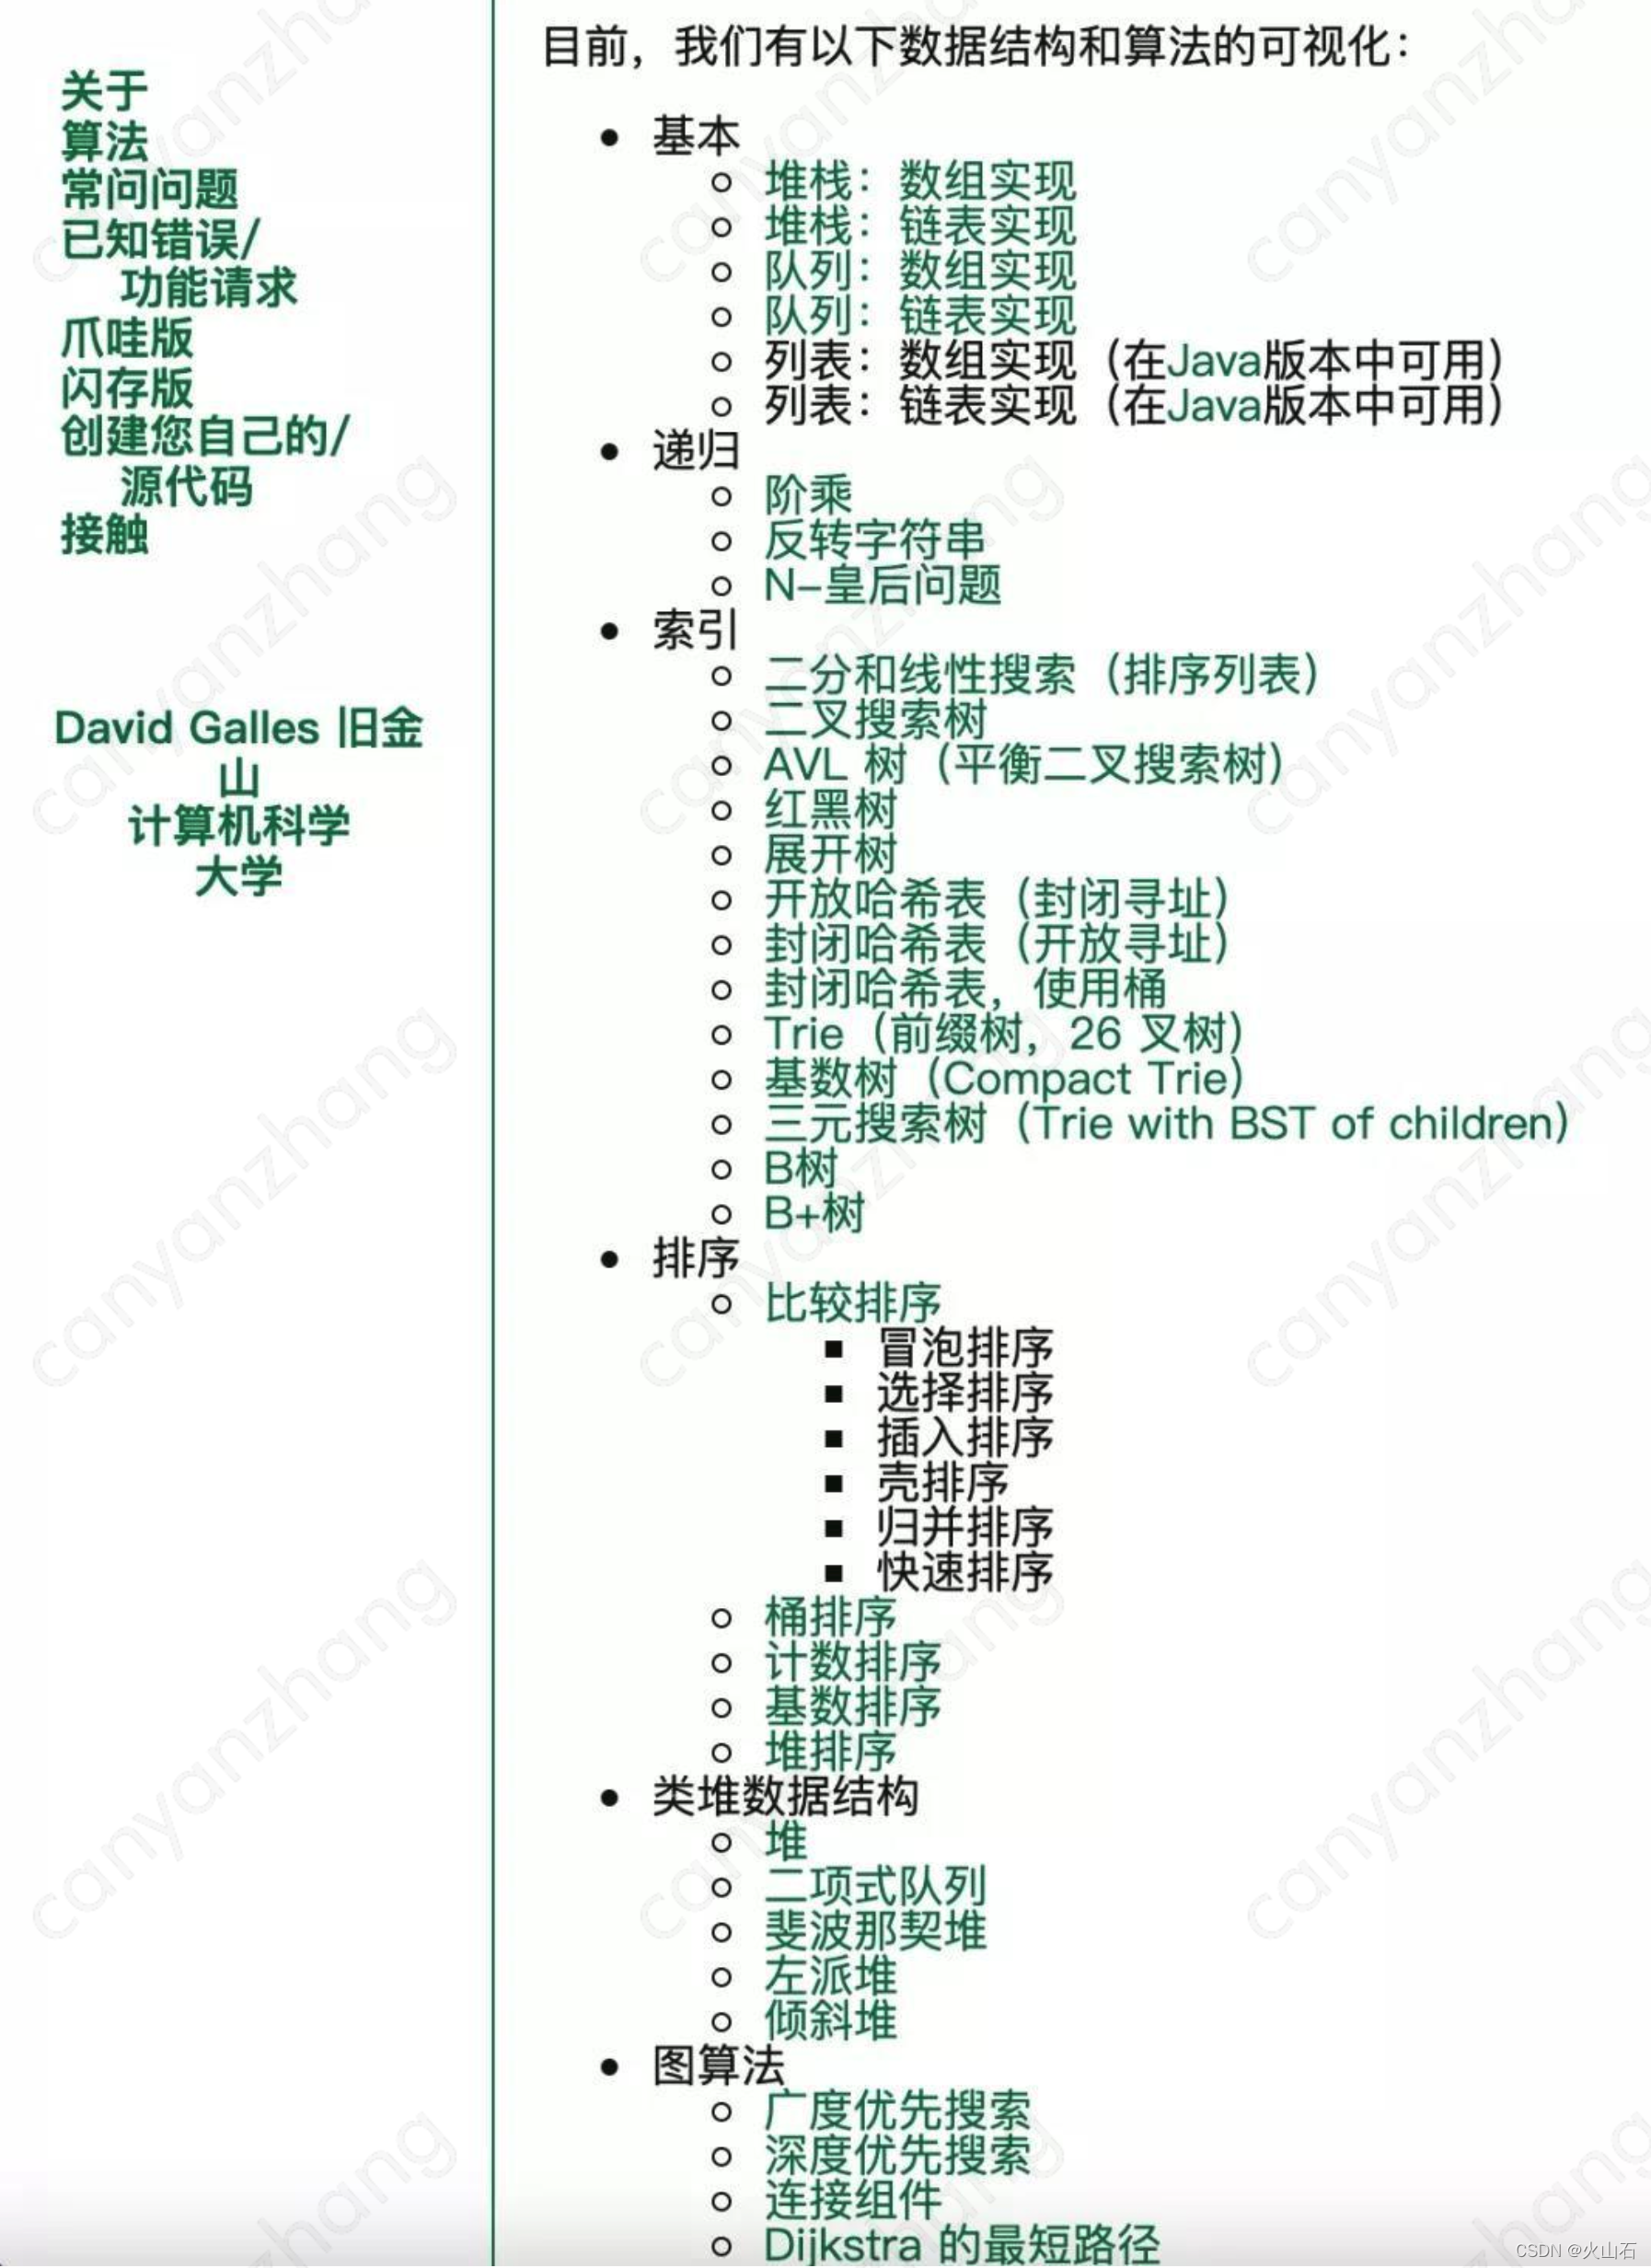
网上有很多这类数据结构与算法可视化的网站,能够自己输入数据,然后看对应的数据结构/算法的动图,能够很好地帮助我们理解数据结构与算法。所以,今天我就把自己在学数据结构与算法时,用到可视化网站分享出来。Structure Visualization我之前那篇文章就是在 Data Structure Visualization 网站做的动图,这个网站支持很多种数据结构的动图演示。地址如下:https:/
文章目录前言一、红黑树是什么?二、代码实现1.构建存放键值对的节点类2.构建树节点类3. 插入方法4.红黑树平衡5.左旋、右旋和交换颜色8.测试验证总结前言java8的HashMap中,使用了红黑树,本文主要是通过手写红黑树插入和查找代码来理解其特性和作用。一、红黑树是什么?红黑树是一种数据结构,如果学过数据结构的同学,应该会比较了解,红黑树是一种平衡二叉树,是有234树转变而来。没学过的同学,只
Mysql索引数据结构下面列举了常见的数据结构二叉树红黑树Hash表B-Tree(B树)Select * from t where t.col=51我们在执行一条查询的Sql语句时候,在数据量比较大又不加索引的情况下,逐行查询并进行比对,每次需要从磁盘上查找,每行数据可能在磁盘不同的位置,数据比较靠后的话,一千万数据可能要比对几百万,很耗费资源。Mysql衡量查询效率的就是磁盘IO次数,那么Mys
二叉树1. 树形结构1.1 概念树是一种非线性的数据结构,它是由n(n>=0)个有限结点组成一个具有层次关系的集合。把它叫做树是因为它看起来像一棵倒挂的树,也就是说它是根朝上,而叶朝下的。它具有以下的特点:有一个特殊的节点,称为根节点,根节点没有前驱节点除根节点外,其余节点被分成M(M > 0)个互不相交的集合T1、T2、…Tm,其中每一个集合 Ti (1 <= i<= m
正则二叉树:此二叉树不存在度为1的结点public static int IsTree(Node s){if(s==null){return 1;}if(s.getLchild()==null&&s.getRchild()==null){return 1;}else if(s.getRchild()!=null&&s.getR
【问题描述】以二叉链表为存储结构,实现二叉树的创建、遍历实验要求:在程序中定义下述函数,并实现要求的函数功能:CreateTree():按从键盘输入的扩展前序序列,创建二叉树PreOrderTree():前序遍历树(递归)InOrderTree():中序(非递归)遍历树LaOrderTree(): 后序遍历树(递归)【输入形式】以扩展二叉树的前序遍历序列作为输入,创建二叉树。【输出形式】输出前、中
1.树1.1树的定义树(Tree)是n(n≥0)个结点的有限集,它或为空树(n=0);或为非空树,对于非空树T:(1)有且仅有一个称之为根的结点;(2)除根结点以外的其余结点可分为m (m>0)个互不相交的有限集T1, T2,…,Tm,其中每一个集合本身又是一棵树,并且称为根的子树( SubTree )。1.2树的基本术语1.结点: 树中的一个独立单元。包含一个数据元素及若干指向其子树的分支
树是一种非线性的数据结构,它是由n(n>=0)个有限结点组成一个具有层次关系的集合。树是递归定义的,把它叫做树是因为它看起来像一棵倒挂的树,也就是说它是根朝上,而叶朝下的。一棵二叉树是结点的一个有限集合,该集合或者为空,或者是由一个根节点加上两棵别称为左子树和右子树的二叉树组成。二叉树的几种形态:空,一个节点,树的度数为1,树的度数为2。
本文介绍了B树和B+树的基本原理及其在数据库索引中的应用。B树是一种平衡多路查找树,其特点是每个节点包含多个关键字,且所有叶节点位于同一层次。B树的插入和删除操作需保持平衡性,可能涉及节点分裂或合并。B+树是B树的优化版本,主要改进包括:非叶节点仅存储索引信息、叶节点形成有序链表存储完整数据。这种结构使B+树更适合数据库索引,具有更高存储效率、更低磁盘I/O次数(通常3次即可查询千万级数据)和更优
因此,跳表在时间复杂度相当的前提下,以更低的实现成本和更优的系统级特性,成为Redis Zset的理想选择。
/ 以结点P为根的子树中序线索化// 中序遍历二叉线索树T的非递归算法,对每个数据元素直接输出。
B+树的孩子与关键字的数量相等所有数据都存储在叶子节点上,方便遍历查找所有值通过对三种树的了解,做一个总结:B树:有序数组+平衡多叉树;B+树:有序数组链表+平衡多叉树;B*树:一棵更丰满的,空间利用率更高的B+树。InnoDB 存储引擎要求每个表必须有一个 唯一的主键,并且主键索引是 B+树结构,保证数据行的唯一性、顺序存储和高效查询。MyISAM 存储引擎并不强制要求每个表必须有主键。MyIS
MySQL 选择 B+树作为索引数据结构的原因与其设计特性息息相关。B+树不仅能很好地支持数据库常见的查询操作,还能高效处理大规模数据并优化磁盘IO操作。
【代码】【数据结构6】AVL树、AVL树的旋转-左旋和右旋、二叉搜索树的扩展应用-B树(B-Tree)、B+树。
(2)构造一个新结点,从F中选取两棵根结点权值最小的树作为新结点的左右子树,并且将新结点的权值置为左右子树上根结点的权值之和;1.每个初始结点最终都会成为叶结点,且权值越小的结点到根结点的路径长度越大;(1)将这n个结点分别作为n棵仅含一个结点的二叉树,构成森林F;从树的根到该结点的路径长度(经过的边数)与该结点上权值的乘积。(3)从F中删除刚才选出的两棵树,同时将新得到的树加入F中。有某种现实含
平衡二叉树的构建、删除、调整算法分析及java实现
b树
——b树
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 openEuler 社区

 乐奇 Rokid 开放社区