登录社区云,与社区用户共同成长
邀请您加入社区
您好!寒露到了!天气变冷,注意保暖!寒露有四候:一候:鸿雁来宾;二候:雀入大水为蛤;三候:菊有黄华。四候:卿临京城议边缘。第四候是我们添加的,诚邀您一起见证一场关于边缘计算的顶级盛宴!1...
大家好!关注鲜枣课堂的朋友可能知道,我们之前有推荐过边缘计算社区的刊物。边缘计算社区成立三年了,是一家专注5G边缘计算领域内容传播的专业媒体。今年11月7日,边缘计算社区打算在北京举办全...
今年二月份,中央提出加快新基建建设,推动5G等新技术快速发展。随之而来的是一系列5G扶持政策出台,5G商用也随之加速。受益于5G商用加速、物联网市场翻倍增长等原因,边缘计算作为5G和物联...
基于centos7安装cdh6.3.2,附带百度云盘安装包,100%可成功
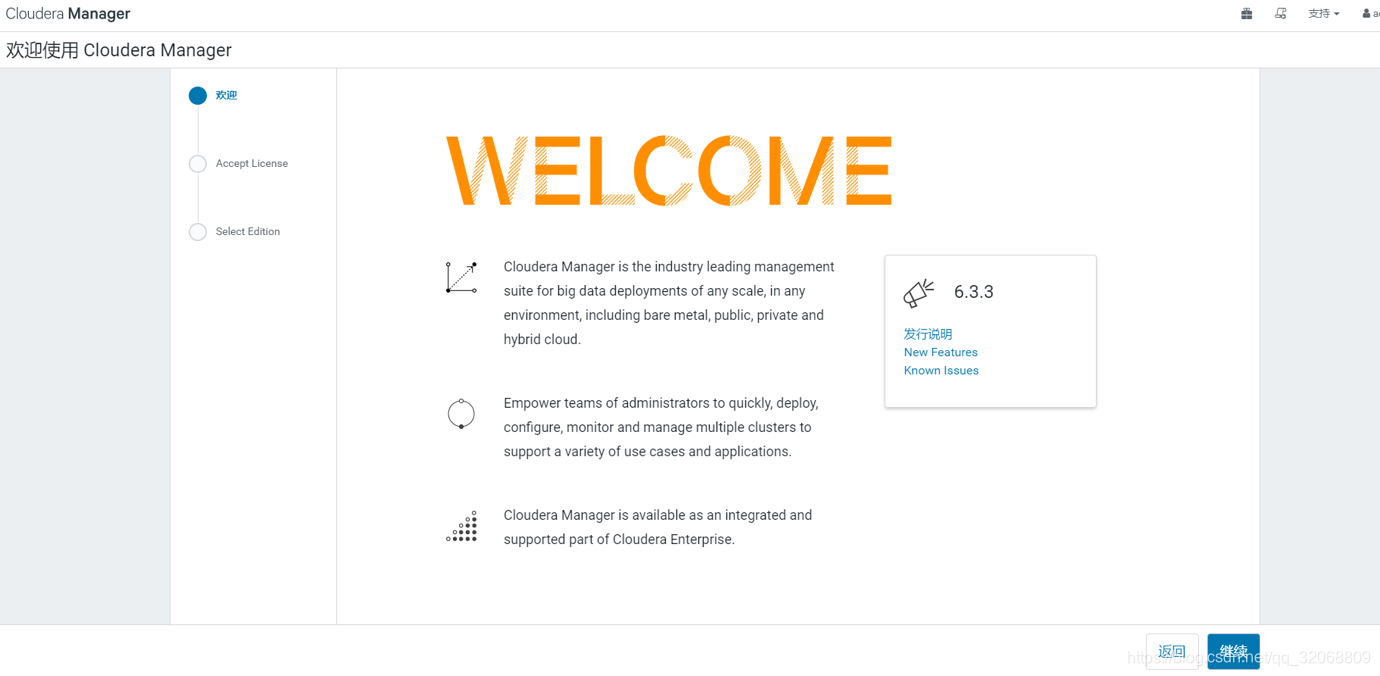
点击完成后选择自定义安装点击hdfs继续进入安装教程还需要安装其他程序可在安装完成之后继续安装就ok了开启Cloudera Management Service服务之后会显示对应的图表
找资源实在是太麻烦了。我用阿里云盘分享了「CDH 6.3.2」,你可以不限速下载???? 复制这段内容打开「阿里云盘」App 即可获取 链接:https://www.aliyundrive.com/s/MXdocsLsNuT
由于cloudera官网从2021年2月1日起全面移除的非订阅用户的下载链接,我将安装包传到百度网盘了,供大家下载使用)直接上图:下载方式:微信搜索关键字“五分钟学大数据”或扫描下方二维码关注微信公众号,回复“cdh” 可获取完整的百度网盘下载连接地址...
跑起来之后会发现个有趣现象:虽然观测噪声在距离方向上很大(R(1)=0.5),但角度测量精度较高(R(2)=0.02),EKF能巧妙融合这两种信息源。试试看,这会是个不错的进阶练习。基于matlab的扩展卡尔曼滤波(Extended Kalman Filter,EKF),通过卡尔曼滤波算法近似计算系统的状态估计值和方差估计值,对信号进行滤波。基于matlab的扩展卡尔曼滤波(Extended Ka
这通常意味着另一个进程已经在监听相同的IP地址和端口号,导致。在启动时无法创建HTTP服务器的套接字,原因是地址。
如图:参考网上解决方案:https://www.136.la/shida/show-38853.html删除/var/lib/cloudera-scm-agent/uuid重启:systemctl restartcloudera-scm-aget得到解决。
问题现象:不良 : Cloudera Manager Agent 的日志目录位于可用空间小于 1.0 吉字节 的文件系统上。 /var/log/cloudera-scm-agent(可用:434.8 兆字节 (0.86%),容量:49.1 吉字节)解决:挂载问题可以参考,这篇博客做思考调整“/dev/mapper/VolGroup-lv_root”目录的大小:...
Issue : cloudera-scm-agent failed to restart, saying agent dead but pid file exist. Sometimes it starts good but it`ll die after few min.Solution : Try 1Delete the pid file and restart
前面的话:目前maven仓库中没有支持cdh的相关依赖。cloudera自己建立了一个相关的仓库。要想利用maven添加相关依赖,则必须单独添加cloudera仓库。一、项目pom.xml, 添加仓库配置<repositories><repository><id>cloudera</id><url>https://repository.cloud
hue入口:http://hue服务器地址:8888/(默认端口为8888)hue web页面如下选择Data Browser下的Hbase,进入Hbase页面选择Hbase的一个表,点击进入,可查看此表的数据格式Hbase表的数据查询窗口如下,查询语句格式如图主键查询输入主键rowkey,rowkey2说明:查询对应主键rowkey的数据记录例如:查询主键100_1233,100_1237对应记
[b][/b]运行基于HBASE的时间较长的M/R任务时,Region Server报错如下: 早上4点01:46.222 INFO org.apache.hadoop.hbase.regionserver.HRegionServer Scanner -1644657804377547036 lease expired 网上有帖子说是因为scanner没有关闭导致(http://grokbase.
Ssh 同步时间同步 关闭seLinux #vi /etc/selinux/config (将SELINUX改为disabled) 关闭防火墙 #service iptables stop /status 关闭iptables启动级别# chkconfigiptables off chkconfig --listipt
TKT,即票据授予票据,可以形象地比喻为一把“万能钥匙”。在Kerberos认证系统中,当你(作为客户端)想要访问某个服务(如服务器上的某个文件或数据库)时,你首先需要向Kerberos认证中心(Key Distribution Center, KDC)证明你的身份。这个属性对于Kerberos认证过程尤为重要,因为它决定了在AD环境中,哪些加密类型可以被用于票据(ticket)的加密和会话密钥的
cdh升级zookeeper3.6.3以及集成parcels包
在 spark的conf下 创建 hive-site.xml不过在CDH中,hive是默认为hive on spark的,而不是mr新增下面内容:<configuration><property><name>hive.metastore.client.connect.retry.delay</name><value>5</value
前言记得以前用过这个函数,这次开发怎么都找不到了,不常用的原因,也是笔记没做好方法一GROUP_CONCAT(distinct id ORDER BY id DESC SEPARATOR ‘_’)好像是用过的这个报错:Invalid function GROUP_CONCAT可能是版本问题:当前hive版本:hive-common-2.1.1-cdh6.2.0apache-hive-1.2.1-也
1 查卡我的hadoop支撑的压缩方式hdfs 配置控制台收索:io.compression.codecs可见没有LzopCodec方式2LzoCodec和LzopCodec区别LzoCodec和LzopCodec区别两种压缩编码LzoCodec和LzopCodec区别:1. LzoCodec比LzopCodec更快, LzopCodec为了兼容LZOP程序添加了如 bytes signature
安装错误:查看日志文件显示:flink/bin/flink-yarn.sh: line 17: rotateLogFilesWithPrefix: command not found。审核更改,将这两项配置security.kerberos.login.keytab、security.kerberos.login.principal设置为空字符串,点击继续.检测parcel,检测到flink的pa
rotateLogFilesWithPrefix: command not found
CDH6.0.1 hive orc导致内存增长问题解决
持续输出 敬请关注大数据架构 湖仓一体化 流批一体 离线+实时数仓各种大数据解决方案 各种大数据新技术实践持续输出 敬请关注
Flink on Yarn -CDH5部署1.1 Flink模式Flink有开发模式,Local-cluster模式,Standalone模式,Yarn模式这里我们搭建在CDH集群上,我们采Flink on Yarn,由Yarn统一管理集群资源1.2 Yarn模式部署独立部署(Standalone)模式由Flink自身提供计算资源,无需其他框架提供资源,这种方式降低了和其他第三方资源框架的耦合性
hadoop生产环境数据块损坏修复方法问题描述:生产环境,早上报红 hdfs丢失块不良命令:hdfs fsck -list-corruptfileblocks检查出丢失快的文件好多人都说删除文件,但是生产环境怎么能随便删除文件解决方案:然后执行修复命令:hdfs debug recoverLease [-path ] [-retries ]例:hdfs debug recoverLease -pa
1、安装kudu点击继续就可以了,2、安装hive配置数据库:库名: hivedb 用户: hive 密码:123456为hive添加连接mysql的驱动包chmod 777 mysql-connector-java.jarcp mysql-connector-java.jar /opt/cloudera/parcels/CDH-6.2.0-1.cdh6.2.0.p0.967373/lib/hiv
1.6新特性Flink 1.6-有状态流处理的下一步在Flink 1.6.0中,我们继续在较早版本中进行的基础工作:使Flink用户能够无缝地运行快速数据处理并毫不费力地构建数据驱动的数据密集型应用程序。Flink的状态支持是使Flink在实现各种用例时如此通用和强大的关键功能之一。为了使其更容易,社区增加了对状态TTL的本地支持(FLINK-9510,FLINK-9938)。此功能允许在状态过期
12:50:44,201 WARNorg.apache.flink.configuration.GlobalConfiguration- Error while trying to split key and value in configuration file /yarn/nm/usercache/root/appcache/application_1602660926640_0023/con
idea的database tools 中配置hive起因在开发hive sql的时候需要到hue中运行、查看hive sql的语法错误很麻烦,hive能不能像mysql一样集成在idea开发工具中呢?答案是可以的。jdbc driver 下载由于我使用的CDH-6.3.2-1.cdh6.3.2这个版本的平台,所以要使用对应得jar包下载链接:cloudera cdh6 hive jdbc配置1.
编译Impala时遇到了一个maven错误,准确地说是编译testdata模块时报的错。我用的指令是 “./buildall.sh -skiptests -format -testdata”,遇到的错误如下:========================================================================Running mvn-U packag...
开门见山的说,hive中有两个函数percentile和percentile_approx,可以用来计算分位数。而中位数即2分位数,那么同样可以使用该函数计算。具体使用方如下:percentile:percentile(col, p) col是要计算的列(值必须为int类型),p的取值为0-1,若为0.5,那么就是2分位数,即中位数。percentile_approx:percentile_app
一、系统配置1.hostname在所有机器进行操作1)规划主机名servercmserver.ifoton.com.cnagentagent1.ifoton.com.cnagent2.ifoton.com.cn2)设置主机名hostname cmserver.ifoton.com.cnhostnamectl set-hostname cmserver.ifoton.com.cnhostnamect
一、安装前准备设置HOSTvi /etc/hosts关闭防火墙sudo systemctl disable firewalldsudo systemctl stop firewalld设置SELinuxvi /etc/selinux/config将SELINUX=enforcing 改为SELINUX=permissive,然后重启服务器,或者执行下面命令:setenforce 0开启NTP服务#
第3章 Hadoop运行环境搭建(开发重点)完整hadoop课程:https://item.taobao.com/item.htm?ft=t&id=6232861141013.1 虚拟机环境准备克隆虚拟机修改克隆虚拟机的静态IP修改主机名关闭防火墙创建atguigu用户配置atguigu用户具有root权限(详见《尚硅谷大数据技术之Linux》)7.在/opt目录下创建文件夹(1)在/op
一、准备工作:1、绑定IP192.168.197.129 ,192.168.197.130 ,192.168.197.1312、更改主机名 /etc/hosts192.168.197.129 hd01192.168.197.130 hd02192.168.197.131 hd033、配置免密登录:1、各台虚拟机执行:ssh-keygen -t rsa;2、cd .ssh cat
1.java代码,结构如下入1.pom.xml文件<?xml version="1.0" encoding="UTF-8"?><project xmlns="http://maven.apache.org/POM/4.0.0"xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"xsi:schemaLocation="http:
概念介绍CDH 概览CDH是Apache Hadoop和相关项目的最完整、最受测试和最流行的发行版。CDH提供Hadoop的核心元素-可伸缩存储和分布式计算-以及基于web的用户界面和重要的企业功能。CDH是Apache许可的开放源码,是唯一提供统一批处理、交互式SQL和交互式搜索以及基于角色的访问控制的Hadoop解决方案。CDH 提供以下特性:灵活性:存储任何类型的数据并使用各种不同的计算框架
CDH6.2离线安装流程1 安装准备1.1 cdh6.2下载方式一:官网下载https://archive.cloudera.com/cm6/6.2.0/redhat7/yum/RPMS/x86_64/都下载下来https://archive.cloudera.com/cdh6/6.2.0/parcels/只要el7.parcel 和 el7.parcel.sha1下载式二:...
Cloudera以Hadoop为基础,开发了企业级Hadoop发行版CDH(Cloudera Distribution Including Apache Hadoop),使Hadoop更易于在生产环境中进行安装、配置和管理,推动了Hadoop在企业大数据方面的应用。最后,需要确保服务器的硬件配置满足Cloudera的要求,如内存、CPU和磁盘空间等。Cloudera的核心团队由来自Facebook
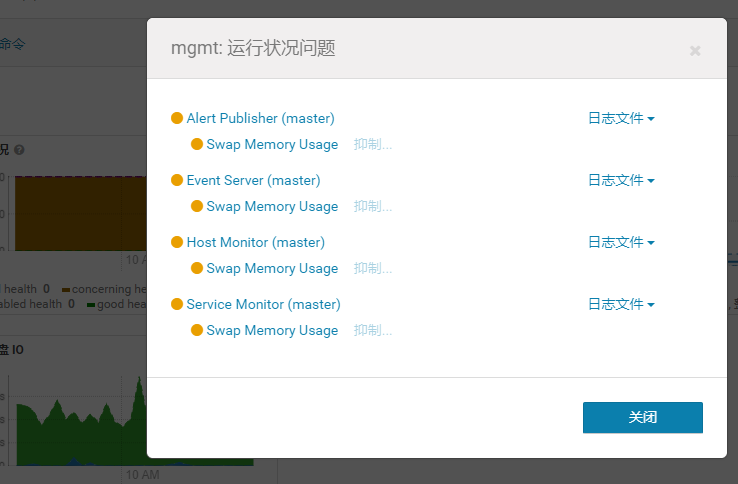
cdh交换内存问题
回顾从前,已经在大数据领域混了5年了,经手了不少大数据集群搭建方案,自己也做过许多大数据平台的运维工作,在这里进行阶段性的总结,主要是 原生Hadoop、CDH、Ambari集群搭建对比。
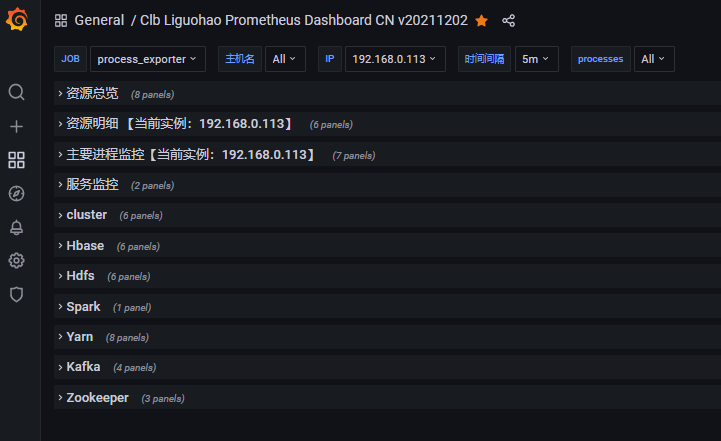
Prometheus + node_exporter +Grafana 监控安装部署一、node_exporter安装与配置node_exporter是Prometheus的一个插件,部署该插件,可以将本地机器的系统资源信息筹集并发送给Prometheus。在需要监控的机器上面都要安装该插件。这里我只演示监控我的两台机器192.168.0.113,192.168.0.114进入到http://pr
荣伟 发自 凹非寺量子位 报道 | 公众号 QbitAI脑机接口到底是商业噱头?还是重大突破?这个东西大公司才能搞?普通人和小公司还有没有机会?想知道答案,快跟着看一下这份《脑机接口深度产...
目录一、CDH介绍二、为什么选择CDH?三、CDH的版本选择 四、安装准备1.节点准备2.节点规划3.下载parcels文件4.tarball下载5.准备以下内容:五、系统初始化1.关闭防火墙(3个节点)2.配置主机名(3个节点)3.修改hosts文件(3个节点)4.配置免密登录(3个节点)5.安装JDK(3个节点)6.检查Python版本(3个节点)7.检查服务器之间的时间是否同步(3个节点)
cloudera
——cloudera
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 地瓜机器人开发者社区


 乐奇 Rokid 开放社区





 天工造物局




 DAMO开发者矩阵