- @2502_93987700


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
基准WildVideo针对多模态模型在视频问答中的「幻觉」问题,首次系统定义了9类幻觉任务,构建了涵盖双重视角、支持中英双语的大规模高质量视频对话数据集,采用多轮开放问答形式,贴近真实交互场景,全面评估模型能力。近年来,大模型在多模态理解领域进展显著,已能够在开放世界中处理图文甚至视频内容。然而,一个普遍且严重的问题「幻觉」始终制约着其实际应用。尤其在动态、连续的视觉场景中,模型可能生成与视频内容

其集代码大模型、IDE、自主开发模式为一体,覆盖代码生成、研发知识问答、单元测试用例生成、专家技能Skills、Codebase代码库索引、规范驱动开发等AI Coding技术,同时接入开源模型GLM-5.0、DeepSeek-V3.2以及华为自研模型,并提供鸿蒙的专属模型,可为开发者提高研发效率,提供极致的智能化编码体验。在质量保障方面,华为云码道将多年的研发工程经验总结提炼,形成可以被AI智能
Dia浏览器是由The Browser Company开发的一款基于AI的浏览器,旨在将AI直接融入到你的日常工作流程中,让你可以与标签页互动、更快地规划、用自己的声音撰写内容,并在保持强大隐私控制的同时提高工作效率。ChatGPT Atlas是OpenAI的基于AI的网络浏览器,它将ChatGPT置于浏览体验的核心,让该助理可以跟随你浏览网页,理解你的操作,摘要页面内容,甚至直接在你所浏览的网站
Ouro的探索确立了循环深度作为继模型大小和数据规模之后的第三个扩展轴,为人工智能的未来发展提供了新的思路。你没听错,让模型在预训练阶段就开始思考。字节,加州大学,普林斯顿大学,蒙特利尔大学,北京大学,卡内基梅隆大学等等一众顶尖学府、研究机构联合发布了一种语言模型的全新范式:Ouro模型。Ouro模型用14亿参数实现了百亿级模型的推理能力,核心在于它在预训练阶段就学会了循环思考。
随着人工智能技术的发展,智能对话系统在各个行业中的应用越来越广泛。本项目旨在基于SpringAI Alibaba快速构建一个基于大模型的智能对话助手,通过提供多种工作模式,满足用户在不同场景下的需求,例如通俗解释、要点总结、风险分析等。基础版本:构建具备专业领域知识的固定角色智能体进阶版本:实现多模式切换的智能对话系统接下来,我们一起完成这个SpringAI Alibaba项目。创建统一响应格式。
Ilya认为,目前主流的「预训练 + Scaling」路线已经明显遇到瓶颈。与其盲目上大规模,不如把注意力放回到「研究范式本身」的重构上。AI正从「规模时代」,重新走向「科研时代」。这是Ilya大神在最新采访中发表的观点。这一次,Ilya一顿输出近2万字,信息量爆炸,几乎把当下最热门的AI话题都聊了个遍:AI为什么总在泛化上输给人类?如何保证安全与对齐?预训练范式有什么问题?Ilya认为,目前主流
与AGI太过遥远的炒作相比,我非常喜欢这种 3 到 5 年的时间窗口。”“AI 现在最大的问题,已经不是不够聪明,而是太难真正落地。这些非常务实的观点,并不是出自AI怀疑论者。相反,它出自硅谷圈内那位“工程与学术”的双修神话:上周末,很少露面公开演讲的大神 Jeff 接受了一场播客邀约。在这场对谈中,Jeff 并没有讨论参数规模、模型排名,甚至很少谈“下一个突破”。。他心中的“登月级”AI项目,不
唐杰认为,在 AGI 尚未实现之前,领域模型会长期存在,其背后更多是应用企业的战略选择——不愿意在 AI 企业面前完全失去主导权,希望通过领域 know-how 构建护城河,把 AI 驯化为工具。最近,清华大学教授、智谱AI首席科学家唐杰发了一条长微博,总结了自己2025年对大模型进展的感悟。从预训练到中后训练、长尾场景的对齐能力,再到Agent、多模态和具身智能的发展,其中有不少亮点。
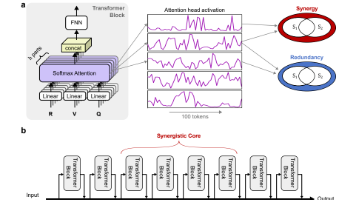
这项研究为大模型的可解释性开辟了新路径。它表明,我们可以从「自上而下」的信息论视角来理解模型,而不仅仅是「自下而上」地寻找特定的电路。对于 AI 领域,识别协同核心有助于设计更高效的压缩算法,或者通过更有针对性的参数更新来加速训练。对于神经科学,这提供了一种计算上的验证,预示着协同回路在强化学习和知识迁移中可能扮演着至关重要的角色。大模型虽然基于硅基芯片和反向传播算法,但在追求智能的过程中,它们似
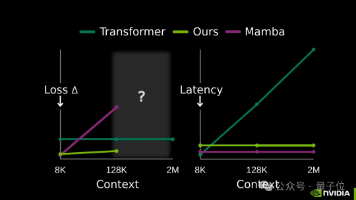
联合Astera研究所、斯坦福大学、UC伯克利、加州大学圣地亚哥分校等机构推出了TTT-E2E方法。提高大模型记忆这块儿,美国大模型开源王者——英伟达也出招了。联合Astera研究所、斯坦福大学、UC伯克利、加州大学圣地亚哥分校等机构推出了方法。在128K超长文本上处理速度比全注意力模型快2.7倍,处理2M上下文时提速达35倍,性能还不打折。这项技术与前几天大火的DeepSeek条件记忆模块有所不