


- @IT_YQG_


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
本文提供200个AI时代计算机专业毕业设计选题,涵盖智能系统、AI小程序、大数据与AI模型三大方向,助力学生避开“题目难选”困境。选题结合大模型、AI问答、智能推荐等热点,兼具实用性与创新性,适合不同技术栈(Java/SpringBoot、Python、微信小程序等)学生参考,可直接用于开题与开发,提升毕设效率与通过率。
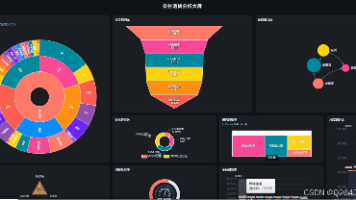
本系统基于Spark与Hadoop构建,结合Django、Vue和Echarts实现全球电商订单交付与退货数据的多维分析。通过文件上传、预处理与Spark分析模块,完成15项核心分析任务,涵盖国家延误率、承运商准时率、退货原因分布、履约聚类等,支持可视化大屏展示。系统具备高扩展性与实用性,助力企业优化物流策略。如需完整源码、定制开发或文档支持,欢迎咨询交流。

本项目基于Spark与Hadoop构建多平台电商消费行为分析系统,整合淘宝、京东等六大平台数据,实现数据清洗、多维统计与价值挖掘。通过K-Means、FP-Growth、Isolation Forest等算法,完成用户分群、关联规则与异常检测,支持平台对比、用户画像、商品偏好、地域差异及时间趋势分析,并以Django+Vue+Echarts实现可视化大屏展示。系统具备可扩展性与复用性,助力电商运营

2027届计算机毕设应聚焦大模型、多模态、生成式AI、多模型协同与大数据智能预测等前沿方向。推荐100个高含金量选题,涵盖系统类、小程序类、深度学习与大数据四大类别,强调技术亮点、场景落地与数据可得性。避坑普通传统系统,优先选择融合AI创新的课题,确保论文有内容、答辩有亮点,助力一次通过、斩获优秀。
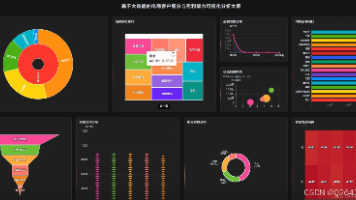
该系统集成了客群细分分析、消费行为分析、盈利能力分析、客户数据管理及综合数据大屏五大核心功能。客群细分分析通过年龄性别结构、收入教育画像、忠诚等级构成与客群分层构成等图表,精准刻画不同客户群体的多维特征;消费行为分析利用品类偏好排名、购物渠道占比、支付方式分布、购频客单对比及品类共现挖掘,深入揭示客户的消费习惯与关联规律
基于Hadoop与Spark的全球电商交付体验与退货归因可视化分析系统构建了一套基于 Hadoop + Spark 的大数据预处理与分析流水线:先将原始订单数据集上传至 HDFS,通过 pandas 完成缺失值校验、类型规范化与多字段中英文语义映射(覆盖国家、城市、品类、承运商、配送方式、退货原因等 17 类核心字段),再借助 Spark SQL、K-Means 聚类与 FP-Growth 频繁项
开发一个基于UniApp的共享图书微信小程序的背景源自于人们对知识共享和资源高效利用的日益关注。在数字化时代,尽管电子书和在线阅读逐渐成为主流,纸质书籍依然具有不可替代的价值,它们不仅是一种文化载体,更是一种精神的寄托。传统的购书模式导致了大量书籍的闲置和浪费,而图书馆等公共资源的获取存在地域和时间的限制。在这种背景下,共享图书的理念应运而生,旨在通过信息技术手段,建立一个方便的线上平台,使用户能
cmd查看maven版本小技巧① 键盘按下 windows + Q② 输入 cmd③ 右击 cmd 以管理员身份运行④ 输入 mvn -v 或者 mvn -version
基于Spark的生成式AI用户行为分析与算力异常检测研究是基于 Hadoop/HDFS 与 Spark 构建,实现用户行为与算力消耗数据的上传、清洗、预处理和分布式统计分析,围绕用户套餐、近30天活跃天数、会话时长、提示词数量、输入/输出 Token、重新生成率、采纳输出率、点赞点踩、配额使用率和付费墙触发次数等指标生成多维分析结果,并通过 K-Means 用户行为分群、FP-Growth 关联规
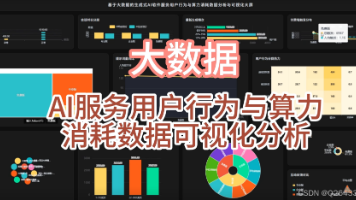
基于Spark的生成式AI用户行为分析与算力异常检测研究是基于 Hadoop/HDFS 与 Spark 构建,实现用户行为与算力消耗数据的上传、清洗、预处理和分布式统计分析,围绕用户套餐、近30天活跃天数、会话时长、提示词数量、输入/输出 Token、重新生成率、采纳输出率、点赞点踩、配额使用率和付费墙触发次数等指标生成多维分析结果,并通过 K-Means 用户行为分群、FP-Growth 关联规