


- @2401_84182906


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
分别对应 jobmamager taskmanager taskslot 由 taskslot 执行任务 每个。时间为 0-10分钟这个窗口内的数据 第二次 为 1-11分钟这个窗口内的数据 以此类推。比如如下为 10分钟一个窗口 然后间隔时间为 1分钟那么 第一次计算的窗口。根据数据条数触发计算 比如如下就是 每来五条计算一次 并且并行度 等于1。根据固定时间确定一个窗口 然后间隔一定的时间触发

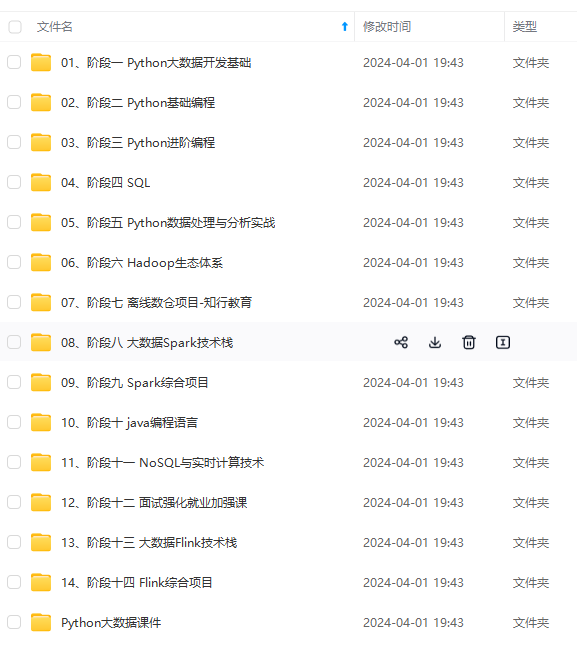
部分目录大纲截图出来,每个节点里面都包含大厂面经、学习笔记、源码讲义、实战项目、讲解视频,并且后续会持续更新**
通过爬取景点数据、进行数据清洗和预处理、利用数据可视化技术展示景点情况,并结合协同过滤和基于内容的推荐算法构建景点推荐系统,为游客提供个性化的旅游体验。本研究将为旅游领域的数据可视化和景点推荐提供新的思路和方法,推动相关技术的发展和应用。本研究基于python爬虫技术获取景点信息数据,数据可视化技术将数据进行展示,景点推荐算法根据用户的历史行为数据进行个性化推荐,并使用django框架搭建系统。同
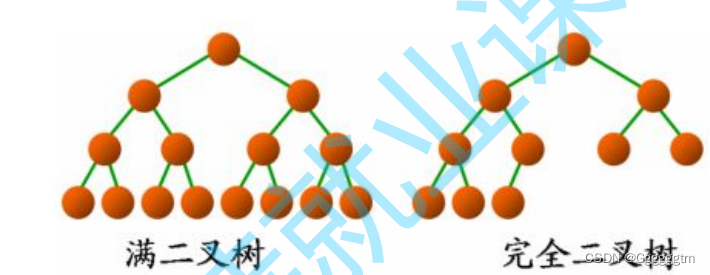
定义结构体时,由上面的链式存储结构我们直到该结构体应该包含一个存储数据的变量,和指向左右分支节点的指针;我们看代码实现。}BTNode;首先我们自己要有一个二叉树,简单的二叉树即可。因为下面的操作都是在二叉树上进行的。
从6月到10月,经过4个月努力和坚持,自己有幸拿到了网易雷火、京东、去哪儿等10家互联网公司的校招Offer。6、7月主要是做系统复习、项目复盘、LeetCode与牛客刷题等准备工作,并且投了字节跳动、拼多多、猿辅导在内的几家公司的提前批,当然还是挂在了简历,因为毕竟自己的学校、学历、项目经验肯定比不过牛客网上那些大厂实习的大佬了。8月开始海投,真的是海投,至少不下60家吧,8月份主要是各大公司的

打开之后,输入以下指令:此时出现的结果就是电脑里没有安装OpenSSH的情况:如果已经安装了OpenSSH那么跳过这一步,没有安装的话则输入以下指令最终结果为如下,则代表着OpenSSH安装成功:显示OpenSSH安装成功后,在打开本地cmd进入之后输入命令ssh如果显示的是这样结果的话,则说明正确:在windows上安装vscode,安装成功后并打开。点击左侧工具栏中的扩展,搜索“ssh”,选择

nvl(t22.spu_bid_cnt_30d,0)asspu_bid_cnt_30d– 近30天_出价spu数。,t22.spu_inv_num_30dasspu_inv_num_30d– 近30天_在售商品数。,nvl(t22.spu_inv_num_7d,0)asspu_inv_num_7d– 近七天_在售商品数。,t1.xxx_rate AS xx率。
在生产环境中,高可用性(HA)是至关重要的,以确保数据处理和分析任务不受中断。在大数据领域,Hadoop和Spark是两个常见的框架,需要HA环境来 保障其正常运行。测试Hadoop的HA配置,模拟不同类型的故障,例如NameNode故障或ResourceManager故障,以确 保HA配置正常运行。与Hadoop类似,您需要准备一个Spark集群,确保各个组件正常运行,包括Spark Maste
单线程顺序消费已经解决了顺序消费的问题,但是它的扩展能力很差。为了提升消费者的处理速度,但又要保证顺序性,我们只能横向扩展分区数,增加消费者。我们可以模仿一下kafka的分区思想操作。将接收到的kafka数据进行hash取模(注意注意,你kafka分区接受消息已经是取模的了,这里一定要对id做一次hash再取模)发送到不同的队列,然后我们开启多个线程去消费对应队列里面的数据。
修改localhost为你的opensearch虚拟机ip, 代码中新建了一个index添加了一条数据又将其删掉了 index也删掉了 自己可以注释掉后面的删除代码通过dashboard的dev-tools(下面介绍) 执行dql查看数据是否写入opensearch。管理员身份打开win系统的cmd命令行 找到自己的java环境变量路径 不知道的可以电脑设置里查看高级系统设置。可以将索引(inde
