登录社区云,与社区用户共同成长
邀请您加入社区
第1章。
煤炭行业是我国能源产业极为重要的一部分,这个行业一直把安全生产当作最核心的发展诉求,供电系统就像是煤矿生产的“动力心脏”,负责给矿井变电站,主要通风机,井下排水泵以及提升机这些关键设备供电。该系统的设备一旦出现运行异常情况,就很可能造成生产停止,设备损坏,还可能会产生安全事故,所以,国家矿山安全监察局和财政部共同出台的《煤矿及重点非煤矿山重大灾害风险防控创建工程总体方案》专门提出,要给重点煤矿里的
现有的Agent技能自进化方法在迭代更新时,往往因为缺乏对历史经验的积累和对修改幅度的控制,导致优化过程不稳定且效率低下,如何像深度学习中的梯度下降一样稳定、高效地自动优化离散的技能文档?论文提出了SKILLADAM框架,借鉴Adam优化器的思想,通过引入“优化记忆”和“波动驱动的编辑预算”,实现了更稳定、更少迭代次数且更低成本的Agent技能自进化
强化学习(RL)研究智能体在与环境交互中通过奖励信号学习最优策略。其框架是马尔可夫决策过程(MDP):智能体在状态sss采取动作aaa,环境返回奖励rrr和新状态s′s's′,智能体学习策略πa∣sπa∣s以最大化累积奖励。虽然预训练主要用自监督学习,但对齐阶段(RLHF,第13章)会用到强化学习:把语言模型视为策略,把人类偏好转化为奖励,用策略梯度方法优化模型。因此,理解强化学习的基本概念对第四
摘要(≤150字): 标准化流通过可逆变换将简单分布(如标准正态)逐步转化为复杂数据分布,利用变量替换公式精确计算似然,实现稳定的最大似然训练。核心在于设计可逆且雅可比行列式易计算的网络层,如加性与仿射耦合层。通过堆叠多层变换,模型具备强大表达能力,广泛应用于生成建模、密度估计与图像生成,兼具训练稳定性与可解释性。
本章系统讲解生成式对抗网络(GAN)的核心思想与关键技术。通过“判别作为信号”的对抗机制,生成器与判别器在极小极大博弈中协同优化,实现高质量数据生成。针对训练不稳定性问题,引入WGAN、WGAN-GP、谱归一化等方法提升收敛性。通过渐进式增长、自注意力机制与大规模模型设计(如ProGAN、SAGAN、BigGAN),显著提升图像生成质量。条件GAN则拓展了生成能力,支持基于标签或文本的可控生成。尽
一句话概括:无监督学习从无标注数据中学习,生成模型学习数据分布并生成新样本,好的生成模型需要在保真度和多样性之间取得平衡,FID和IS是最常用的量化评估指标。生成模型评估指标清单指标全称核心思想方向优点缺点FIDInception特征空间中的Frechet距离越低越好同时评估质量和多样性,稳定可靠假设高斯分布,依赖InceptionIS类别预测的置信度×多样性越高越好简单直观只评估类别层面,对模式
一句话概括:残差网络通过跳跃连接让网络学习残差而非直接学习目标,解决了深层网络的梯度消失和退化问题,使训练上百层网络成为可能,是深度学习发展史上的里程碑。残差网络核心公式清单概念公式残差块输出yσFxxyσFxx主路径变换FxW2⋅σW1xb1b2FxW2⋅σW1xb1b2维度不匹配时yσFxWsxyσFxWsxBN归一化xx−μBσB2ϵxx−μBσ。
一句话概括:卷积网络通过局部连接和权值共享大幅减少参数量,利用卷积操作提取层次化特征,配合池化下采样,在计算机视觉任务中取得革命性成功。卷积网络核心公式清单概念公式2D卷积输出Yij∑mnWmn⋅Xim−1jn−1Yij∑mnWmn⋅Xim−1jn−1输出尺寸Hout⌊H2P−kHS⌋1Hout⌊(H2P−kHS⌋1参数量Cout×Cin×。
本章系统讲解深度学习中的正则化技术,分为显式与隐式两类。显式正则化通过在损失函数中加入L1、L2惩罚项,限制模型复杂度,其中L1产生稀疏解,L2实现权重衰减。隐式正则化则通过Dropout、数据增强、早停等训练技巧间接提升泛化能力。此外,预训练微调、模型集成等启发式方法也显著提高性能。正则化本质是通过控制模型复杂度,防止过拟合,提升泛化能力。
本文围绕智能学术搜索相关的学术工具应用,介绍四款可显著提升论文写作效率的工具:依托人工智能技术、具备对话式梳理功能、适用于文献检索梳理的切问学术;可检查优化英语写作语法与风格的Grammarly;适合长文写作、便于组织论文结构的Scrivener;能够简化复杂表达、提升论文可读性的Hemingway Editor。这些工具覆盖论文写作全环节,可帮助研究生高效完成高质量学术写作。
本文系统梳理了从零基础到成为AI大模型应用开发工程师的学习路径,涵盖数学与编程基础、机器学习入门、深度学习进阶、大模型原理与实践、高级应用及社区参与六大阶段。强调掌握线性代数、Python、数据结构等核心技能,通过Kaggle项目、Hugging Face微调、开源贡献等实战提升能力。推荐Coursera、Khan Academy、Fast.ai等优质资源,并鼓励持续学习前沿论文与参与AI社区,助
自注意力机制是Transformer的核心,解决了传统序列模型长距离依赖、无法并行的痛点;而BERT依托双向Transformer编码器+MLM预训练任务,实现了通用语言表征学习。预训练+微调的范式,让开发者无需从零训练模型,仅需微调即可在小样本下游任务取得极佳效果,这也是BERT成为NLP工业界、学术界通用 baseline 的根本原因。
本章系统讲解情感分析的核心技术。首先通过情感词典、朴素贝叶斯与大模型零样本三种方法的对比演示建立直观认知;随后介绍概念、技术难点与基础理论,并深入剖析词典规则、传统机器学习、深度学习与大模型四类主流方法的原理与选型。最后是电商评论情感分析系统案例。
本文推荐一本关于 AI 工程的书籍《AI Engineering: Building Applications with Foundation Models》
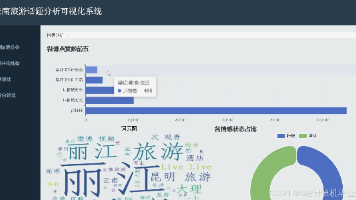
本文综述了Python在旅游评论情感分析中的应用进展。文章从技术演进、方法对比、应用场景和未来挑战四个维度展开:1)技术层面,介绍了从情感词典、机器学习到深度学习的方法迭代;2)对比分析了不同方法在效率与精度上的权衡;3)阐述了情感分析在旅游企业优化、游客决策和市场研究中的应用价值;4)指出了领域适配性、多模态融合等未来研究方向。研究表明,Python生态为旅游评论情感分析提供了完整工具链,深度学
本文介绍了如何在星图GPU平台上自动化部署🧬 SeqGPT-560M镜像,实现自然语言理解任务的快速集成。该镜像支持开箱即用的文本分类和实体抽取,典型应用于电商评论情感分析,帮助开发者高效构建智能文本处理微服务。
如果你的需求是“写一份系统上线方案”,可以在Prompt中加入这样的角色设定:“请你扮演一位拥有十年经验的运维架构师,负责过多个高并发系统的上线工作。就像你请一个厨师做“一道菜”,他可能会给你端上一盘番茄炒蛋——没错,是菜,但未必是你想吃的。同样重要的是,你也要告诉模型“你是谁”;同样是写技术文档,一个“资深架构师”写出来的风格,和一个“刚入行的初级工程师”写出来的,截然不同。精准生成专业技术文档
本文介绍了如何在星图GPU平台自动化部署StructBERT情感分类-中文-通用-base镜像,实现高效的中文文本情感分析。该镜像基于阿里达摩院StructBERT微调,可快速对电商评论、社交媒体内容等进行积极、消极或中性的三分类情感识别,帮助用户自动化处理海量文本并获取情感洞察。
本文介绍了如何在星图GPU平台自动化部署RexUniNLU零样本通用自然语言理解-中文-base镜像,实现中文自然语言处理任务的快速应用。该镜像通过WebUI提供便捷操作,典型应用于从文本中自动化抽取实体、关系和情感分析,大幅提升信息处理效率。
本文介绍了如何在星图GPU平台上自动化部署nli-MiniLM2-L6-H768镜像,快速搭建自然语言推理服务。该轻量级交叉编码器模型专为NLI与零样本分类设计,适用于智能客服中的意图识别、问答系统验证等场景,显著提升语义理解效率。
本文介绍了如何在星图GPU平台上一键自动化部署SiameseAOE通用属性观点抽取-中文-base镜像,实现中文文本情感分析功能。该镜像基于StructBERT-Chinese模型,可自动从用户评论中提取产品属性和情感观点,广泛应用于电商评论分析、客户反馈处理等场景,大幅提升数据挖掘效率。
本文介绍了如何在星图GPU平台上自动化部署微软开源的Phi-3.5-mini-instruct轻量级指令微调大模型。该模型仅需7.6GB显存即可流畅运行,特别适合本地化部署场景,可用于智能客服、文本摘要等自然语言处理任务,显著提升人机交互效率。
本文介绍了如何在星图GPU平台上自动化部署SOONet: 基于自然语言输入的长视频片段时序定位模型。该模型能够根据自然语言描述,快速精准地定位长视频中的特定片段,典型应用场景包括从金融培训视频中自动提取‘风险提示条款’对应的画面段落,极大提升了合规审查效率。
医疗领域大模型LoRA微调示例数据集
本文介绍了AutoGLM-Phone 9B端侧智能体的云端部署与ADB联调方法。主要内容包括:1)产品概述,说明该智能体具备通过自然语言操作手机GUI的能力;2)部署准备,详细指导云服务器配置和Docker环境安装;3)模型下载,提供ModelScope等多种下载方案;4)使用vLLM框架部署高性能推理服务;5)本地ADB连接配置与AutoGLM-Controller应用设置。该指南完整覆盖了从云