
深度学习复试项目-07:NLP核心:自注意力机制与BERT模型解析
前言
在Transformer架构诞生之前,NLP任务主流依赖CNN、RNN、LSTM、GRU等模型。但这类模型存在天然缺陷:CNN只能捕捉局部文本特征,无法建模长距离依赖;RNN系列串行迭代计算,无法并行、长文本梯度衰减严重。
2017年Transformer模型横空出世,完全基于自注意力机制(Self-Attention)搭建,彻底解决了传统序列模型的痛点。而2018年提出的BERT,基于Transformer编码器构建的预训练语言模型,凭借双向预训练、迁移学习的优势,成为所有现代中文文本分类、情感分析、实体识别任务的 baseline。
本文将从零拆解自注意力核心原理、多头注意力机制,再系统讲解BERT模型架构、预训练任务、核心特性,附带全套高频面试问答,适合零基础学习与面试复盘。
一、自注意力机制(Self-Attention)详解
1.核心思想
自注意力机制的核心:让序列中每一个字(Token)都能和全局所有字计算关联权重,动态捕捉全局语义依赖。
传统RNN是逐词遍历,只能依赖前文信息;而自注意力直接计算任意两个Token的相关性,无论是近距离词语,还是长距离相隔的语义关联,都能精准捕捉,同时支持全局并行计算。
2.核心计算流程
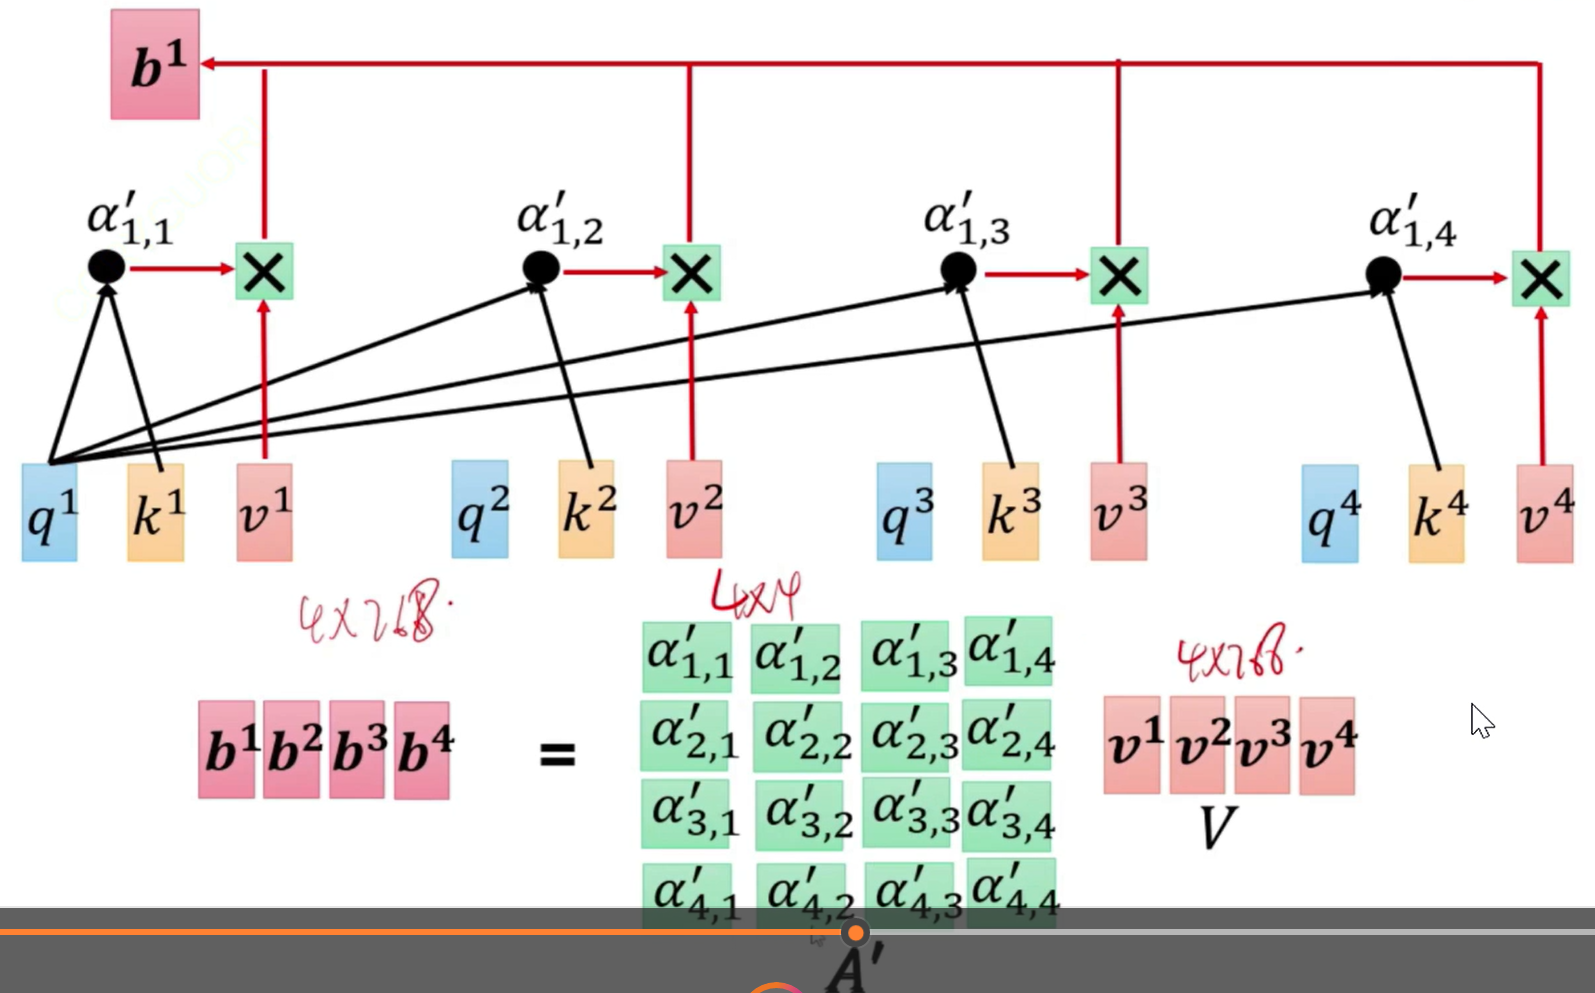
自注意力通过Q、K、V三个向量完成全局相关性计算,所有输入Token共享权重矩阵,流程统一分为四步:
步骤1:生成Q、K、V向量
对输入的每个词嵌入向量,通过三个可学习的权重矩阵,分别映射得到:
-
Q(Query 查询向量):当前Token要“查找什么信息”
-
K(Key 键向量):全局Token“包含什么信息”
-
V(Value 值向量):全局Token的“真实语义信息”
步骤2:计算注意力得分(相关性)
用当前Token的Q和全局所有Token的K做矩阵点积,得到注意力分数矩阵。分数越高,代表两个词语的语义关联越强。
步骤3:维度缩放(核心细节)
将点积结果除以 根号Dk(dk为Q/K向量维度)。
作用:高维向量点积后数值方差极大,会导致softmax函数进入饱和区、梯度消失。缩放后将数值方差约束为1,保证梯度稳定可更新。
步骤4:掩码 + Softmax归一化
通过Attention Mask掩码屏蔽无效位置(如padding填充位),将无效位置分数置为负无穷;再通过Softmax将分数归一化为0-1的权重分布。
步骤5:加权求和输出
用归一化后的注意力权重,对全局V向量加权求和,得到当前Token融合全局语义的最终输出向量。
3. 多头自注意力(Multi-Head Attention)
单头自注意力只能捕捉单一维度的语义关联,多头注意力将QKV均分为多组,每组独立计算自注意力:
-
不同头捕捉不同语义特征:语法结构、语义关联、语序依赖、上下文逻辑等
-
所有头计算结果拼接融合,通过线性层降维输出
核心优势:多视角、多维度挖掘文本全局特征,大幅提升模型语义理解能力。BERT默认使用12头注意力机制
4. Attention Mask掩码机制
掩码是自注意力的关键工程细节,主要分为两类:
-
Padding Mask:屏蔽句子补零的padding位置,防止无效占位符参与注意力计算,干扰语义特征
-
Look-Ahead Mask:解码器专用,屏蔽未来时刻Token,防止模型看到后文信息
BERT作为编码器模型,仅使用Padding Mask。
5. 自注意力机制优缺点
优点:
-
全局建模:直接捕捉长距离语义依赖,彻底解决RNN梯度衰减问题
-
全局并行:所有Token同时计算,训练速度远快于串行RNN
-
动态权重:根据上下文动态调整词语关联权重,语义适配性更强
缺点:
-
时间复杂度为 $$O(n^2)$$,句子长度越长,计算量、显存消耗呈平方级增长
-
对短文本存在一定的计算冗余
二、BERT模型完整原理详解
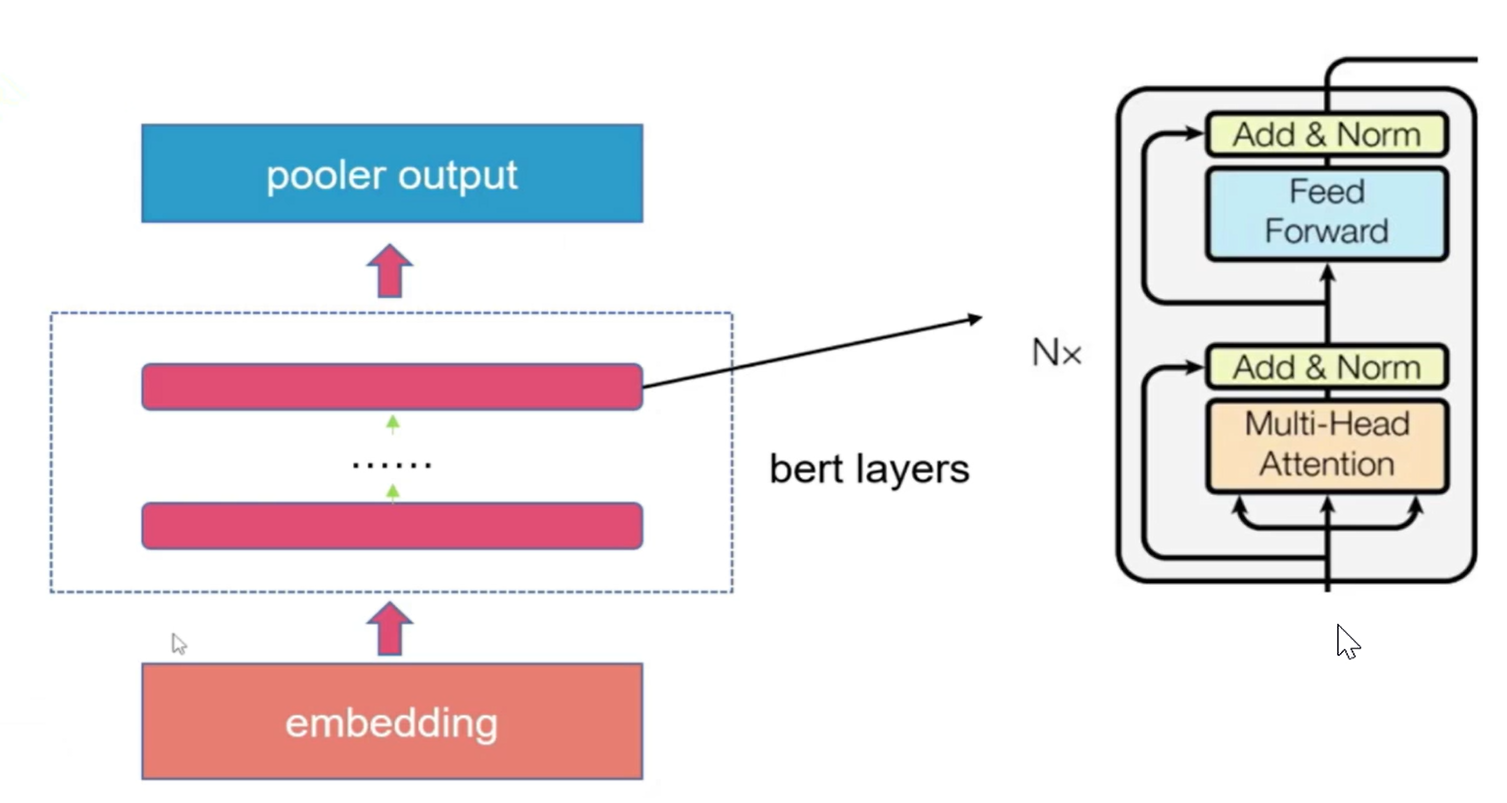
1. BERT整体架构
BERT(Bidirectional Encoder Representations from Transformers),即基于Transformer双向编码器的预训练语言模型。
核心特性:只使用Transformer编码器、全程双向语义建模、预训练+微调两阶段范式。
常用版本:
-
BERT-base:12层编码器、12头注意力、768维向量、1.1亿参数
-
BERT-large:24层编码器、16头注意力、1024维向量
2. BERT输入构成(三大核心输入)
BERT的输入是经过特殊处理的结构化序列,包含三部分,缺一不可:
(1)input_ids
文本经过WordPiece分词后,每个Token对应的数字索引ID,是模型的原始输入特征。
(2)attention_mask
0/1掩码矩阵:1代表真实文本Token,参与注意力计算;0代表padding填充位,被掩码屏蔽。
(3)token_type_ids
句子分段标识,用于区分句子A和句子B:单文本任务全为0,句子对任务分别用0、1区分,实现问答、匹配类任务建模。
3. BERT特殊标记
-
【CLS】:句首特殊标记,聚合全局语义,专门用于句子级任务(分类、情感分析)
-
【SEP】:句子分隔标记,区分两个句子的边界
4. BERT两大预训练任务(核心精髓)
BERT通过海量无标注文本预训练,学习通用语言知识,再迁移到下游小样本任务,核心依靠两个自监督任务:
任务1:MLM 掩码语言模型(核心)
随机将句子中15%的Token替换为【MASK】标记,让模型根据上下文双向语义,预测被遮挡的原始单词。
作用:强制模型学习双向上下文语义,这是BERT优于GPT(单向)的核心原因。
任务2:NSP 下一句预测
输入句子对,判断第二个句子是否是第一个句子的真实后续句子。
作用:学习句子级逻辑关系,适配问答、文本匹配、推理等任务(后续RoBERTa证明NSP收益有限,将其去除)。
5. BERT两大使用范式
(1)特征提取模式(冻结模式)
冻结BERT全部预训练参数,仅训练下游分类/回归头。适合下游数据量极少的场景,避免过拟合。
(2)微调模式(Fine-Tune)
BERT主干参数 + 下游任务头一起反向传播更新参数,适配具体业务场景。数据量充足时效果最优,是绝大多数任务的主流用法。
6. 【CLS】向量与Pooler输出
BERT编码器输出两类结果:
-
sequence_out:所有Token的时序输出,用于词级任务(命名实体识别、分词)
-
pooler_out:取句首【CLS】向量,经过全连接层+tanh激活得到768维全局向量,用于句子级任务(文本分类、情感分析)
三、高频核心面试问答(纯理论版)
1. 自注意力机制相关问答
Q1:自注意力和RNN、CNN相比,核心优势是什么?
答:RNN串行计算、长距离梯度衰减、无法并行;CNN仅能捕捉局部特征。自注意力可全局建模长距离语义依赖,支持全量并行计算,动态适配上下文语义关系,特征表达能力更强。
Q2:自注意力为什么要除以根号dk?
答:高维Q、K向量点积后数值方差极大,会让softmax进入梯度饱和区,导致梯度无法更新。除以根号dk可以将数值方差归一为1,保证梯度稳定,训练收敛正常。
Q3:多头注意力的作用是什么?多头越多越好吗?
答:多头可以从语法、语义、语序等多维度捕捉文本关联,丰富特征表达。并非越多越好,头数过多会增加计算量,同时产生冗余特征,边际收益递减。
Q4:Attention Mask的作用是什么?
答:屏蔽无效padding占位符,避免无意义的填充Token参与注意力计算,防止模型学习到无效噪声特征,保证语义建模的准确性。
2. BERT模型相关问答
Q1:BERT和GPT的核心区别?
答:BERT基于Transformer编码器,双向语义建模,擅长理解类任务(分类、匹配);GPT基于Transformer解码器,单向自回归建模,擅长生成类任务(文本续写、对话)。
Q2:BERT的MLM预训练任务原理和作用?
答:随机遮挡部分Token,让模型通过双向上下文预测遮挡内容。核心作用是让模型学习双向上下文语义关联,是BERT强大语义理解能力的核心来源。
Q3:为什么分类任务用【CLS】向量做表征?可以用均值池化吗?
答:预训练阶段【CLS】专门被训练用于聚合全局句子语义,适配句子级任务。理论上可以用全局均值池化,但【CLS】是BERT原生设计,适配性和效果更优。
Q4:BERT微调为什么学习率不能太大?
答:BERT预训练已经习得海量通用语言特征,大学习率会一次性破坏预训练参数,丢失通用语义知识,导致模型效果暴跌。微调需使用小学习率,轻微适配下游任务。
Q5:BERT特征提取和微调模式的适用场景?
答:数据量极小、防止过拟合时,使用冻结特征提取模式;数据量充足、需要适配专属业务语义时,使用微调模式,效果更好。
Q6:BERT的三个输入分别代表什么?
答:input_ids是分词后的数字索引;attention_mask屏蔽padding无效位;token_type_ids区分句子对,实现双句任务建模。
四、总结
自注意力机制是Transformer的核心,解决了传统序列模型长距离依赖、无法并行的痛点;而BERT依托双向Transformer编码器+MLM预训练任务,实现了通用语言表征学习。
预训练+微调的范式,让开发者无需从零训练模型,仅需微调即可在小样本下游任务取得极佳效果,这也是BERT成为NLP工业界、学术界通用 baseline 的根本原因。
更多推荐

 7
 0
- 0


 已为社区贡献1条内容

所有评论(0)