登录社区云,与社区用户共同成长
邀请您加入社区
Product Hunt 每日热榜 | 2026-09-24 Solid的人工智能代理可以帮你创建应用、自动化工作流程,处理那些你没有时间或专业知识去做的任务。它们能够选择并设置自己的真实机器,创建账户并支付服务费。它们通过API使用你的应用,或者像人一样登录。它们能填补空缺并在过程中解决问题。不要只把目光放在个人助手如Grok Bot和Muse上:Solid旨在为你和你的团队处理复杂且长期的工作
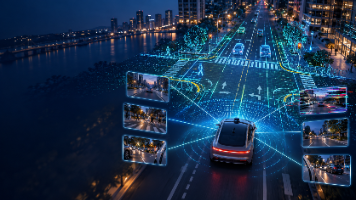
我越来越相信,自动驾驶感知不能建立在“传感器永不失效”的假设上。Uni-Map 用一个模型兼容相机、激光雷达和融合输入,通过共享 BEV 表示与混合训练,让系统在缺帧、雷达异常甚至单传感器缺失时仍能构建道路地图。面对相机缺失,它将 mAP 从 22.5 提升到 61.2。对我而言,真正的智能不是晴天分数更高,而是在信息不完整时依然看得清路。
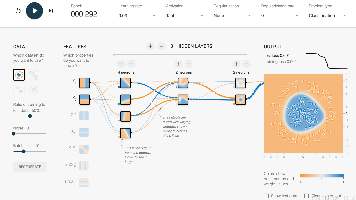
前面几篇文章中,我已经用华为云码道 Agent 完成了一个 OpenCV Vision Lab 项目。从基础图像处理,到 Canny、Harris、SIFT,再到多组参数对比,整个项目已经比较完整。很多算法本身不需要训练模型。只要安装好 OpenCV,就可以直接调用对应算法完成处理。所以这一次,我想继续往前走一步。PyTorch + CNN + 深度学习。Neural Network Playgr
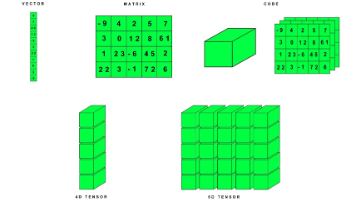
PyTorch 是由 Meta 开发的主流深度学习框架,以其动态计算图、自动求导和丰富的生态著称。本文从张量概念入手,介绍如何创建张量(如 tensor、zeros、randn 等),并演示基本操作:加法、矩阵乘法、索引切片与形状变换。张量作为多维数组,支持 GPU 加速与自动求导,是构建神经网络的核心数据结构,适合快速上手深度学习开发。
AI进入团队,带来的不只是能力增益,也可能改变人的警觉、交流和协作方式。即使“AI队友”实际由高水平人类操控,只要参与者相信它是 AI,团队表现仍会下降;任务越难,差距越明显。对我而言,下一代 AI agent 的关键不是证明自己多聪明,而是让人类更容易形成共同预期、保持适度唤醒,并继续彼此沟通。
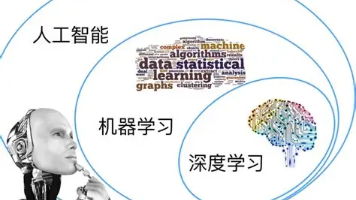
第一次接触 AI 开发,最容易被一串名词绕晕:人工智能、机器学习、深度学习、神经网络、大模型、LLM、生成式 AI、RAG、Agent,看起来都像“AI”,却并不处在同一层级。本文从“目标—方法—模型—能力—系统”五个层次重新梳理它们的关系,用一张总览图、多个对比表和可运行的 Python 示例,讲清传统机器学习如何从数据中学习,深度学习为何依赖神经网络,大模型与 LLM 到底是什么关系,以及今天
本文从神经元原理出发,用NumPy从零手写两层神经网络,实现对螺旋数据的非线性分类。通过前向传播、损失计算与反向传播(链式法则+梯度下降),结合ReLU激活函数与Softmax输出,仅300行代码即达99.5%准确率。关键细节包括He初始化、数值稳定性处理及交叉熵导数优化,完整揭示了神经网络的学习机制,为深度学习实战奠定坚实基础。
本文从链式法则出发,详细推导反向传播(BP)算法原理,揭示多层神经网络中梯度如何通过“反向”传递计算权重更新。结合两层神经网络的数学表达与Python手写实现,完整演示前向传播、损失计算、梯度反传与参数更新全过程,帮助理解PyTorch中loss.backward()的底层机制,掌握深度学习的核心——反向传播。
人工智能(Artificial Intelligence, AI)的本质是对人类智能的模拟。它不是单一的计算机学科,而是涉及统计学、脑神经科学、社会科学等多领域的交叉学科。简单来说,就是让机器变得“聪明”,能够完成原本只有人类才能做到的任务。大语言模型(Large Language Model, LLM)是人工智能领域的核心突破。它是一种通过海量文本训练而成、拥有巨量参数、能够理解和生成人类语言的
强化学习(RL)研究智能体在与环境交互中通过奖励信号学习最优策略。其框架是马尔可夫决策过程(MDP):智能体在状态sss采取动作aaa,环境返回奖励rrr和新状态s′s's′,智能体学习策略πa∣sπa∣s以最大化累积奖励。虽然预训练主要用自监督学习,但对齐阶段(RLHF,第13章)会用到强化学习:把语言模型视为策略,把人类偏好转化为奖励,用策略梯度方法优化模型。因此,理解强化学习的基本概念对第四
一句话概括:无监督学习从无标注数据中学习,生成模型学习数据分布并生成新样本,好的生成模型需要在保真度和多样性之间取得平衡,FID和IS是最常用的量化评估指标。生成模型评估指标清单指标全称核心思想方向优点缺点FIDInception特征空间中的Frechet距离越低越好同时评估质量和多样性,稳定可靠假设高斯分布,依赖InceptionIS类别预测的置信度×多样性越高越好简单直观只评估类别层面,对模式
图(Graph)由**节点(Node/Vertex)和边(Edge)**组成,记为GVEG = (V, E)GVE,其中VVV是节点集合,EEE是边集合。每条边连接两个节点,表示它们之间存在某种关系。无向图(Undirected Graph):边没有方向,节点A和B之间的边表示双向关系。如社交网络中的好友关系。有向图(Directed Graph):边有方向,从A指向B的边不一定有从B指向A的边。
本章系统讲解深度学习中的正则化技术,分为显式与隐式两类。显式正则化通过在损失函数中加入L1、L2惩罚项,限制模型复杂度,其中L1产生稀疏解,L2实现权重衰减。隐式正则化则通过Dropout、数据增强、早停等训练技巧间接提升泛化能力。此外,预训练微调、模型集成等启发式方法也显著提高性能。正则化本质是通过控制模型复杂度,防止过拟合,提升泛化能力。
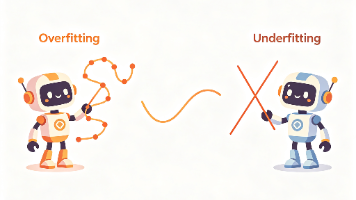
本章系统阐述深度学习模型性能评估的核心方法。通过偏差-方差权衡理论,揭示误差来源:偏差反映模型拟合能力,方差体现对数据的敏感性。结合学习曲线诊断欠拟合与过拟合,提出降低误差的策略——增大数据或正则化降方差,提升模型复杂度降偏差。介绍训练/验证/测试集划分及K折交叉验证,实现超参数高效调优。强调评估指标需匹配任务需求,最终目标是在偏差与方差间找到平衡,实现最优泛化性能。
目录一、模拟前向传播二、编写一个完整的神经网络1)前向传播2)损失函数3)反向传播4)权值更新前面的文章 神经网络基础(一)讲了神经网络和深度学习的概念,神经网络基础(二)讲了神经网络的训练流程并补充了激活函数和损失函数的知识。在这篇内容中,我们要学习的是,如何用代码来实现神经网络的训练过程。大家看下,假如我们有如下的一个神经网络,共分为4层:输入层(第0层)有2个神经元隐藏层1(第1层)有3个神
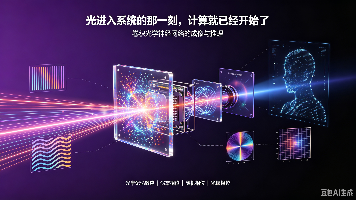
卷积光学神经网络利用傅里叶光学、多级并行卷积核和全光推理,可在光学记忆效应几乎消失的强散射环境中直接从散斑恢复目标图像。系统在多层散射条件下仍保持可观重建性能,有效视场最高扩展约271倍,并展示约1.57 POPS的光学计算能力。其核心价值在于将光从单纯的信息载体转变为计算介质,为高速、低延迟和高能效的光学人工智能提供新的实现路径。
TensorFlow Playground 是 Google 推出的浏览器端交互式神经网络可视化工具。该工具无需安装,支持通过拖拽实时观察隐藏层、神经元数量对决策边界的影响,以及学习率、激活函数等参数的变化效果。界面分为五大功能区:数据区提供内置数据集,特征区控制输入维度,网络区调整拓扑结构,训练区设置超参数,可视化区展示实时训练曲线和决策边界。此外,用户可自定义数据生成、特征工程和网络结构,并通
神经网络是一种受生物神经系统启发的计算模型,由大量相互连接的神经元(节点)组成。每个神经元接收输入信号,经过加权求和和非线性激活后产生输出,传递给下一层神经元。输入层:接收原始数据特征隐藏层:对数据进行加工和特征提取输出层:产生最终预测结果神经网络与深度学习是一个庞大而快速发展的领域。本文从神经元的基本原理出发,介绍了前向传播、反向传播、常见网络结构以及实践流程,为读者搭建了一个完整的知识框架。深
本文针对多层感知机(MLP)在图像识别中丢失空间信息、缺乏平移不变性的缺陷,引入卷积神经网络(CNN)实现手写数字识别。通过卷积层提取局部特征,池化层降维去冗余,结合全连接层分类,有效保留图像二维结构,提升模型精度。实验表明,该CNN模型测试准确率达99.41%,显著优于MLP,验证了CNN在图像任务中的优越性。
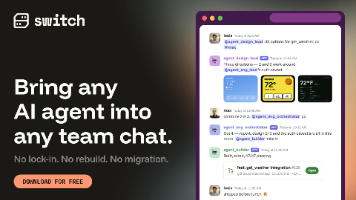
Product Hunt 每日热榜 | 2026-09-09 Switch将人工智能代理引入您团队已经使用的协作工具中。代理可以作为命名参与者加入您的Slack、Teams、Discord或Telegram频道,和您的团队共享相同的上下文和历史。只需连接一次代理,就可以在多个项目中使用。每个频道都有自己独特的上下文、参与者和规则。它支持Claude Code、OpenAI、Google ADK、L
训练神经网络时,我们每天都在写 loss.backward(),但这行代码背后发生了什么?前向传播负责把输入一步步变成预测,损失函数衡量预测和目标的差距,反向传播用链式法则把误差信号从 loss 传回每个参数,优化器再根据梯度更新参数。
在人工智能、深度学习爆火的今天,很多研究人员投身人工智能应用。这就导致很多想入行的人往往忽略了人工智能、深度学习最本真的底层原理。殊不知我们所用的大模型起源于小小的神经网络。生物神经元(神经细胞)通过树突接收生物电信号,细胞体负责将树突接收的信号进行整合,然后将新的动作电位由轴突传导到突触,而突触又与下一个神经细胞的树突相连接,也就是将信号传递给了下一个神经细胞,下一个神经细胞又重复上述过程。生物
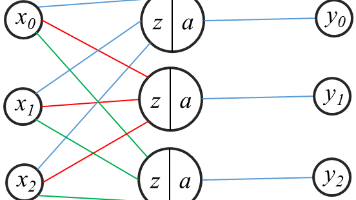
本文从 代码搭建、网络结构演示 两个方面展示ANN神经网络重点看 网络结构演示,这部分通过一个实实在在的数据打通了隐藏层到输出层的整个计算过程
深度学习作为机器学习的一个分支,专注于使用多层神经网络(深度神经网络)来建模和解决问题。人脑中有很多相互连接的神经元,当大脑处理信息时,这些神经元之间通过电信号和化学物质相互作用,在大脑的不同区域之间传递信息。神经网络使用人工神经元模仿这种生物现象,这些人工神经元由称为节点的软件模块构成,使用数值计算来进行通信和传递信息。适合处理非结构化数据,如图像、音频、文本等依赖大量数据和计算资源,训练时间较
if stride!return out本文从 ResNet 的残差思想出发,完整实现了一个基于 CIFAR-10 的图像分类实战项目。残差连接让深层网络训练成为可能BasicBlock 与 Bottleneck 分别适用于浅层与深层网络数据增强与学习率调度对最终精度影响显著预训练权重迁移是提升小数据集性能的有效手段ResNet 作为计算机视觉的基石模型,理解它的原理与实现,对后续学习 Dense
当然, 也可以直接点击文章下方的链接, 这是一套完整的机器学习+深度学习教程,用于降低图像矩阵的维度,减少计算量和防止过拟合, 可以将高维度的图像矩阵转化为低维度的图像矩阵, 使我们可以在保留输入特征图中的主要信息,同时减少网络的参数数量和计算量。个人感觉类似于卷积运算, 看个计算视频就全都明白, 也可以直接点击文章下方的链接, 这是一套完整的机器学习+深度学习教程,根据样本图片矩阵, 设置合适的
专门设计用来处理序列数据的神经网络。
从零搞懂 CNN 卷积神经网络!本文用大白话解释深度学习、CNN、RNN 的区别,配合生活实例(人脸识别、自动驾驶)和可视化图解,帮你理解卷积层、池化层、全连接层如何工作。零基础也能看懂的 AI 入门指南
随着人工智能技术的快速发展,深度学习模型在图像识别、时间序列预测等领域展现出卓越性能。卷积神经网络(CNN)通过局部连接与权重共享机制,成为图像特征提取的核心工具;循环神经网络(RNN)及其变体LSTM(长短期记忆网络)则通过门控机制解决了传统RNN的梯度消失问题,成为处理时序数据的首选模型。本研究聚焦三个典型应用场景:基于CNN的天气识别、基于VGG-16的海贼王角色识别,以及基于LSTM的股票
deeplearning
本文全面解析了深度学习中的归一化技术,从经典的Batch Normalization (BN)到Layer Normalization (LN)、Instance Normalization (IN)、Group Normalization (GN)以及Switchable Normalization (SN)。文章深入探讨了各类归一化方法的核心原理、演进过程及其在不同应用场景(如CV、NLP)中
本文以吴恩达机器学习课程为蓝本,提供从线性回归到神经网络的实战指南。文章深入浅出地讲解了梯度下降、逻辑回归、正则化及反向传播等核心概念,并附有代码示例,旨在帮助读者理解算法原理,掌握模型诊断与优化技巧,从而从理论迈向实践,构建扎实的机器学习基础。
A1.已知:训练数据(输入和标签),测试数据(对模型来说x已知y不已知),损失函数;未知:神经网路的权重和偏置。学习的目标是让机器从训练数据中总结规律,找到一组权重和偏置,让损失函数的值更小,模型的预测结果更符合真实值。
深度学习实战:GAN模型生成逼真图像实操
本文系统梳理了深度学习在计算机视觉领域的核心知识体系。首先介绍了7个经典视觉数据集,从入门级MNIST到工业级MS COCO;然后详细解析了视觉任务评价指标,包括精确率、召回率、P-R曲线、AP和mAP;接着深入讲解了目标检测任务及YOLO算法的核心思想;最后介绍了语义分割任务及FCN、DeepLab v3等核心算法。文章构建了从数据基础到性能评估再到核心算法的完整视觉应用框架。
大模型+具身机器人量产落地的核心瓶颈
本文介绍了一款基于大数据技术的宠物食品智能推荐系统。该系统采用Django框架和爬虫技术,通过实时抓取和分析宠物食品的多维数据,为用户提供个性化推荐。系统包含用户端和管理端两大模块:用户端具备食品浏览、资讯获取、个人管理等功能;管理端则提供用户管理、食品管理、系统配置等后台功能。系统采用模块化设计,运用机器学习算法实现精准推荐,并注重用户体验与界面友好性,为宠物主人提供科学便捷的食品选购决策支持,
主要内容:免费开题报告、任务书、全bao定制+中期检查PPT、代码编写、🚢文编写和辅导、🚢文降重、长期答辩答疑辅导、一对一专业代码讲解辅导答辩、模拟答辩演练、和理解代码逻辑思路。