
《理解深度学习》第9章 正则化 读书笔记
《理解深度学习》第9章 正则化 读书笔记
目录
开篇导语
上一章我们学习了性能评估,知道了过拟合是深度学习中的一个核心问题——模型在训练集上表现很好,但在新数据上表现很差。怎么防止过拟合?答案就是正则化(Regularization)。
正则化的思想非常朴素:在损失函数中加入对模型复杂度的惩罚,让模型倾向于选择更简单的解。就像修剪园林一样,把多余的枝叶剪掉,让树形更美观、更健康。正则化就是深度学习中的"修剪工具"。
本章我们将系统学习各种正则化方法。首先是显式正则化——在损失函数中明确加入惩罚项,包括L1正则化(产生稀疏权重)、L2正则化(权重衰减)。然后是隐式正则化——不直接修改损失函数,而是通过训练过程中的技巧间接达到正则化效果,包括Dropout、数据增强、早停等。最后我们会讨论一些提高模型性能的启发式方法。
9.1 显式正则化
显式正则化(Explicit Regularization) 是指在损失函数中明确加入一个惩罚项,限制模型参数的大小或复杂度。一般形式为:
L ~ ( θ ) = L ( θ ) + λ Ω ( θ ) \tilde{\mathcal{L}}(\theta) = \mathcal{L}(\theta) + \lambda \Omega(\theta) L~(θ)=L(θ)+λΩ(θ)
其中 L ( θ ) \mathcal{L}(\theta) L(θ) 是原始损失函数, Ω ( θ ) \Omega(\theta) Ω(θ) 是正则化项(惩罚项), λ > 0 \lambda > 0 λ>0 是正则化系数,控制惩罚的强度。 λ \lambda λ 越大,对参数的惩罚越强,模型越简单; λ = 0 \lambda=0 λ=0 时没有正则化。
L2正则化(权重衰减)
L2正则化,也叫权重衰减(Weight Decay),是最常用的正则化方法之一。它的惩罚项是参数的平方和:
Ω ( θ ) = 1 2 ∥ θ ∥ 2 2 = 1 2 ∑ i θ i 2 \Omega(\theta) = \frac{1}{2} \|\theta\|_2^2 = \frac{1}{2} \sum_i \theta_i^2 Ω(θ)=21∥θ∥22=21i∑θi2
加入L2正则化后,损失函数变为:
L ~ = L + λ 2 ∥ θ ∥ 2 2 \tilde{\mathcal{L}} = \mathcal{L} + \frac{\lambda}{2} \|\theta\|_2^2 L~=L+2λ∥θ∥22
对应的梯度更新规则变为:
θ ← θ − η ( ∇ L + λ θ ) = ( 1 − η λ ) θ − η ∇ L \theta \leftarrow \theta - \eta \left( \nabla \mathcal{L} + \lambda \theta \right) = (1 - \eta\lambda) \theta - \eta \nabla \mathcal{L} θ←θ−η(∇L+λθ)=(1−ηλ)θ−η∇L
可以看到,每次更新时参数都会先乘以 ( 1 − η λ ) (1 - \eta\lambda) (1−ηλ),相当于让参数向零衰减——这就是"权重衰减"名称的由来。
L2正则化的效果是让参数值变小,但不会让参数变成 exactly zero。它的几何意义是:在参数空间中,L2惩罚对应一个球形约束,最优解倾向于落在球面上。
L1正则化
L1正则化的惩罚项是参数的绝对值之和:
Ω ( θ ) = ∥ θ ∥ 1 = ∑ i ∣ θ i ∣ \Omega(\theta) = \|\theta\|_1 = \sum_i |\theta_i| Ω(θ)=∥θ∥1=i∑∣θi∣
加入L1正则化后,损失函数变为:
L ~ = L + λ ∥ θ ∥ 1 \tilde{\mathcal{L}} = \mathcal{L} + \lambda \|\theta\|_1 L~=L+λ∥θ∥1
L1正则化最重要的特性是产生稀疏解——很多参数会变成 exactly zero。这是因为L1惩罚的几何形状是菱形(在二维中),菱形的顶点位于坐标轴上,最优解很容易落在顶点上,导致某些参数为零。
稀疏性有很多好处:
- 特征选择:参数为零意味着对应的输入特征被完全忽略,相当于自动进行了特征选择。
- 模型压缩:稀疏模型更容易压缩和加速推理。
- 可解释性:只有少数非零参数,模型更容易解释。
L1 vs L2 对比
| 特性 | L1正则化 | L2正则化 |
|---|---|---|
| 惩罚项 | ∑ ∣ θ i ∣ \sum|\theta_i| ∑∣θi∣ | 1 2 ∑ θ i 2 \frac{1}{2}\sum\theta_i^2 21∑θi2 |
| 稀疏性 | 产生稀疏解(很多参数为0) | 不产生稀疏解(参数都很小但非零) |
| 几何形状 | 菱形 | 球形 |
| 特征选择 | 自动特征选择 | 不做特征选择 |
| 鲁棒性 | 对异常值更鲁棒 | 对异常值敏感 |
| 计算效率 | 次梯度,稍慢 | 光滑可导,快 |
9.2 隐式正则化
隐式正则化(Implicit Regularization) 是指不直接修改损失函数,而是通过训练过程中的技巧间接达到正则化效果。这些方法虽然没有明确的惩罚项,但同样能降低模型的泛化误差。
Dropout
Dropout 是Hinton在2012年提出的一种非常有效的正则化方法。它的思想很简单:在训练过程中,随机地"丢弃"一部分神经元,让它们暂时不参与前向传播和反向传播。
具体来说,在每次训练迭代中:
- 对隐藏层的每个神经元,以概率 p p p(通常0.5)随机决定是否保留。
- 被丢弃的神经元输出设为0,不参与前向传播。
- 保留的神经元输出除以 ( 1 − p ) (1-p) (1−p) 进行缩放(称为反向缩放 inverted dropout),保证期望输出不变。
- 反向传播只通过保留的神经元进行。
在测试时,不使用Dropout,所有神经元都参与计算。
Dropout为什么能正则化?有几种解释:
- 集成学习视角:每次Dropout相当于训练了一个不同的子网络,最终的完整网络相当于对这些子网络做了平均(集成)。集成学习通常能提高泛化性能。
- 减少神经元共适应:Dropout迫使每个神经元不能依赖其他特定神经元,因为其他神经元可能随时被"丢弃"。这鼓励神经元学习更鲁棒、更独立的特征。
- 数据增强视角:每次Dropout相当于在不同的网络结构上训练,增加了训练的多样性。
数据增强
数据增强(Data Augmentation) 是指通过对训练数据进行各种变换,人为增加训练数据量。这是计算机视觉中最常用的正则化方法之一。
常见的数据增强方法包括:
- 几何变换:旋转、翻转、裁剪、缩放、平移
- 颜色变换:亮度、对比度、饱和度、色调的随机调整
- 噪声注入:添加高斯噪声、随机擦除(Random Erasing)
- 混合增强:MixUp(两张图片线性混合)、CutMix(两张图片裁剪拼接)
数据增强的正则化效果来自于:
- 增加数据多样性:让模型看到更多样的训练样本,减少过拟合。
- 不变性先验:比如翻转图片不改变类别,数据增强把这种先验知识注入到训练中。
- 减少对特定特征的依赖:随机擦除等方法迫使模型不能依赖某个特定特征,必须学习更鲁棒的表示。
早停
早停(Early Stopping) 是最简单也最常用的正则化方法之一。它的思想是:在训练过程中监控验证集性能,当验证集性能不再提升时,提前停止训练。
为什么早停能正则化?因为在训练初期,模型学习的是数据中的真实规律(欠拟合阶段),训练误差和验证误差都在下降。但训练到一定程度后,模型开始记忆训练数据中的噪声(过拟合阶段),训练误差继续下降但验证误差开始上升。早停就是在验证误差开始上升之前停止训练,相当于限制了模型的训练时间,间接限制了模型的复杂度。
早停的实现很简单:
- 每隔一定轮次(如每轮)在验证集上评估性能。
- 记录最佳验证性能和对应的模型参数。
- 如果连续若干轮(如patience=10)验证性能没有提升,就停止训练。
- 使用最佳验证性能对应的模型参数。
批量归一化的隐式正则化效果
批量归一化(Batch Normalization) 主要是为了解决内部协变量偏移问题,加速训练。但它也有一定的隐式正则化效果,因为每个批次的均值和方差都有噪声,这种噪声类似于Dropout,能提高泛化性能。不过批量归一化的正则化效果通常不如Dropout明显。
9.3 提高性能的启发式算法
除了上述正则化方法,还有一些启发式的技巧能提高模型性能,虽然它们不一定严格属于正则化范畴,但在实践中非常有效。
预训练与微调
预训练(Pre-training) 是指先在大规模数据集(如ImageNet)上训练模型,然后在目标任务上微调(Fine-tuning)。这是迁移学习的核心思想。
预训练的正则化效果来自于:
- 先验知识:预训练模型已经学到了通用的特征表示(如边缘、纹理、形状),微调时不需要从头学起,减少了过拟合的风险。
- 参数初始化更好:预训练提供了一个好的参数初始化点,比随机初始化更接近最优解。
- 减少有效参数:微调时通常只更新部分层(如最后几层),有效参数减少,相当于一种正则化。
模型集成
模型集成(Model Ensembling) 是指训练多个不同的模型,然后将它们的预测结果平均或投票。集成学习通常能显著提高性能,因为不同模型的错误可能相互抵消。
常见的集成方法包括:
- 简单平均:多个模型的预测结果取平均。
- 加权平均:根据验证集性能给不同模型分配权重。
- 投票:分类任务中,多个模型投票决定最终类别。
- 堆叠(Stacking):用另一个模型学习如何组合多个模型的预测。
集成的代价是计算成本高(需要训练和推理多个模型),但在竞赛和对性能要求高的场景中非常常用。
测试时增强
测试时增强(Test Time Augmentation,TTA) 是指在测试时对输入图片进行多种变换(如翻转、裁剪),然后将所有变换的预测结果平均。这相当于在测试时做了一个小型的模型集成,通常能提高1-2个百分点的准确率。
标签平滑
标签平滑(Label Smoothing) 是指在训练分类模型时,不使用硬标签(如[0, 0, 1, 0]),而是使用软标签(如[0.01, 0.01, 0.97, 0.01]),将一小部分概率均匀分配给其他类别。
标签平滑能防止模型对预测过于自信,提高泛化性能。它的数学形式很简单:
y s m o o t h = ( 1 − ϵ ) y h a r d + ϵ K y_{smooth} = (1 - \epsilon) y_{hard} + \frac{\epsilon}{K} ysmooth=(1−ϵ)yhard+Kϵ
其中 ϵ \epsilon ϵ 是平滑系数(通常0.1), K K K 是类别数。
9.4 本章小结
本章我们系统学习了正则化方法。核心要点如下:
-
正则化的本质是限制模型复杂度:通过显式惩罚或隐式技巧,让模型倾向于更简单的解,从而减少过拟合、提高泛化性能。
-
L2正则化(权重衰减)最常用:在损失中加入参数平方和,让参数值变小但不为零。计算简单、光滑可导,是深度学习中的默认正则化方法。
-
L1正则化产生稀疏解:在损失中加入参数绝对值和,让很多参数变成 exactly zero。适合特征选择和模型压缩,但计算稍慢(次梯度)。
-
Dropout是强大的隐式正则化:训练时随机丢弃神经元,相当于训练了大量子网络的集成。测试时使用完整网络。通常配合L2正则化使用,效果更好。
-
数据增强在视觉任务中至关重要:通过旋转、翻转、裁剪、颜色变换等方式增加数据多样性。是计算机视觉中最有效的正则化方法之一。
-
早停简单有效:监控验证集性能,在性能不再提升时停止训练。实现简单,几乎总是应该使用。
-
其他技巧:预训练与微调、模型集成、测试时增强、标签平滑等,都能在实践中提高模型性能。
-
正则化不是越多越好:过强的正则化会导致欠拟合。正则化强度(如 λ \lambda λ、Dropout概率)需要通过验证集调优。
代码实验结果
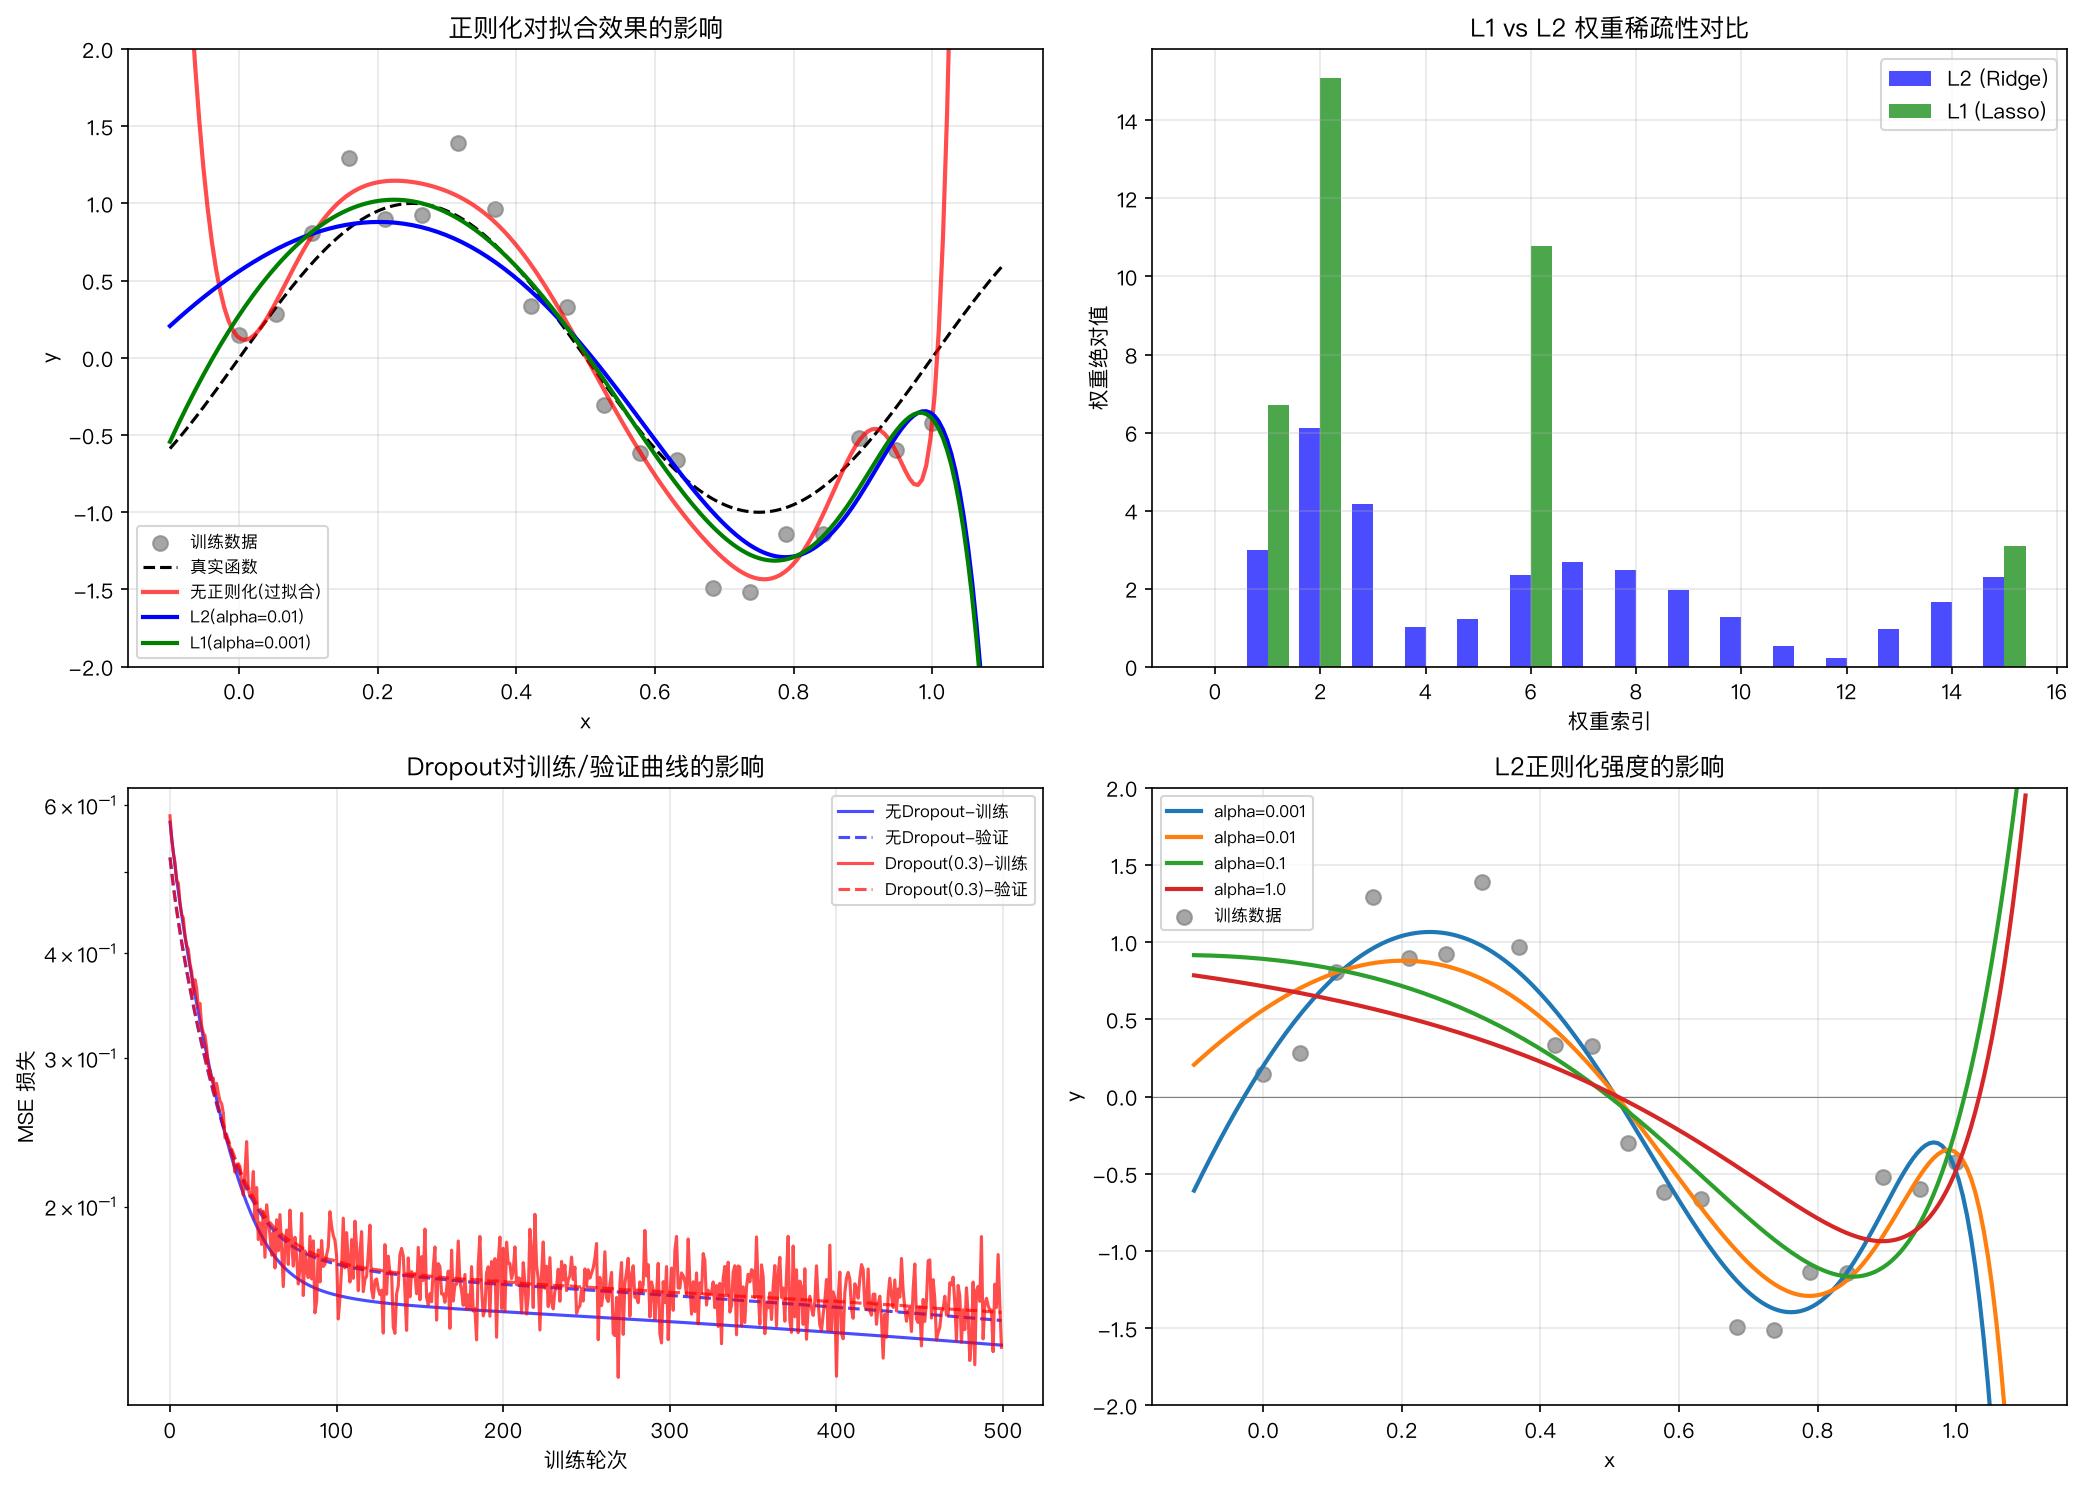
我们编写了完整的Python代码,对比了L1/L2正则化的效果,以及Dropout对训练曲线的影响。以下是真实运行结果。
实验1:L1 vs L2 正则化对比
- 数据:20个样本,真实函数 y = sin ( 2 π x ) + 噪声 y = \sin(2\pi x) + \text{噪声} y=sin(2πx)+噪声,容易过拟合
- 模型:15阶多项式回归
- 对比:无正则化、L2(Ridge)、L1(Lasso)
无正则化: 训练MSE=0.030764

L2 (alpha=0.001): 训练MSE=0.0416, 权重范数=326.64, 非零权重=15
L2 (alpha=0.010): 训练MSE=0.0839, 权重范数=99.84,  非零权重=15
L2 (alpha=0.100): 训练MSE=0.2005, 权重范数=8.11,   非零权重=15
L2 (alpha=1.000): 训练MSE=0.2879, 权重范数=2.00,   非零权重=15

L1 (alpha=0.001): 训练MSE=0.0502, 权重范数=398.00, 非零权重=4
L1 (alpha=0.010): 训练MSE=0.2042, 权重范数=16.33,  非零权重=2
L1 (alpha=0.100): 训练MSE=0.4626, 权重范数=0.87,   非零权重=2
L1 (alpha=1.000): 训练MSE=0.7977, 权重范数=0.00,   非零权重=0
实验2:Dropout效果对比
- 模型:2层神经网络(1输入→128隐藏→1输出,ReLU)
- 数据:50训练+50验证, y = sin ( 3 x ) + 噪声 y = \sin(3x) + \text{噪声} y=sin(3x)+噪声
无Dropout:     最终训练MSE=0.1368, 最终验证MSE=0.1464
Dropout(0.3):  最终训练MSE=0.1360, 最终验证MSE=0.1497
结果可视化
结果分析
-
L1的稀疏性完美验证:L2正则化在所有alpha下都保持15个非零权重(所有权重都很小但非零);而L1正则化在alpha=0.001时就只有4个非零权重,alpha=0.01时只有2个,alpha=1.0时全部为零。这完美验证了L1产生稀疏解、L2不产生稀疏解的理论。
-
正则化强度的权衡:随着alpha增大,L2的权重范数从326降到2,训练MSE从0.04升到0.29;L1的非零权重从4降到0,训练MSE从0.05升到0.80。这说明正则化强度越大,模型越简单(欠拟合风险越高),需要通过验证集选择合适的alpha。
-
无正则化过拟合:无正则化的15阶多项式训练MSE仅0.0308,但从拟合图可以看到曲线剧烈震荡,明显过拟合了训练数据的噪声。加入正则化后曲线变得平滑,更接近真实的正弦函数。
-
Dropout的效果:在这个简单的回归任务上,Dropout(0.3)的验证MSE(0.1497)略高于无Dropout(0.1464)。这是因为数据量较大(50训练样本)且模型不算太复杂,过拟合不严重,Dropout的正则化效果不明显。在更复杂的模型和更小的数据集上,Dropout通常会有更明显的效果。
-
L1的特征选择意义:L1正则化让大部分权重变为零,相当于自动选择了最重要的多项式项。这在高维特征空间中特别有用——可以自动忽略不重要的特征,提高模型的可解释性。
本章核心总结
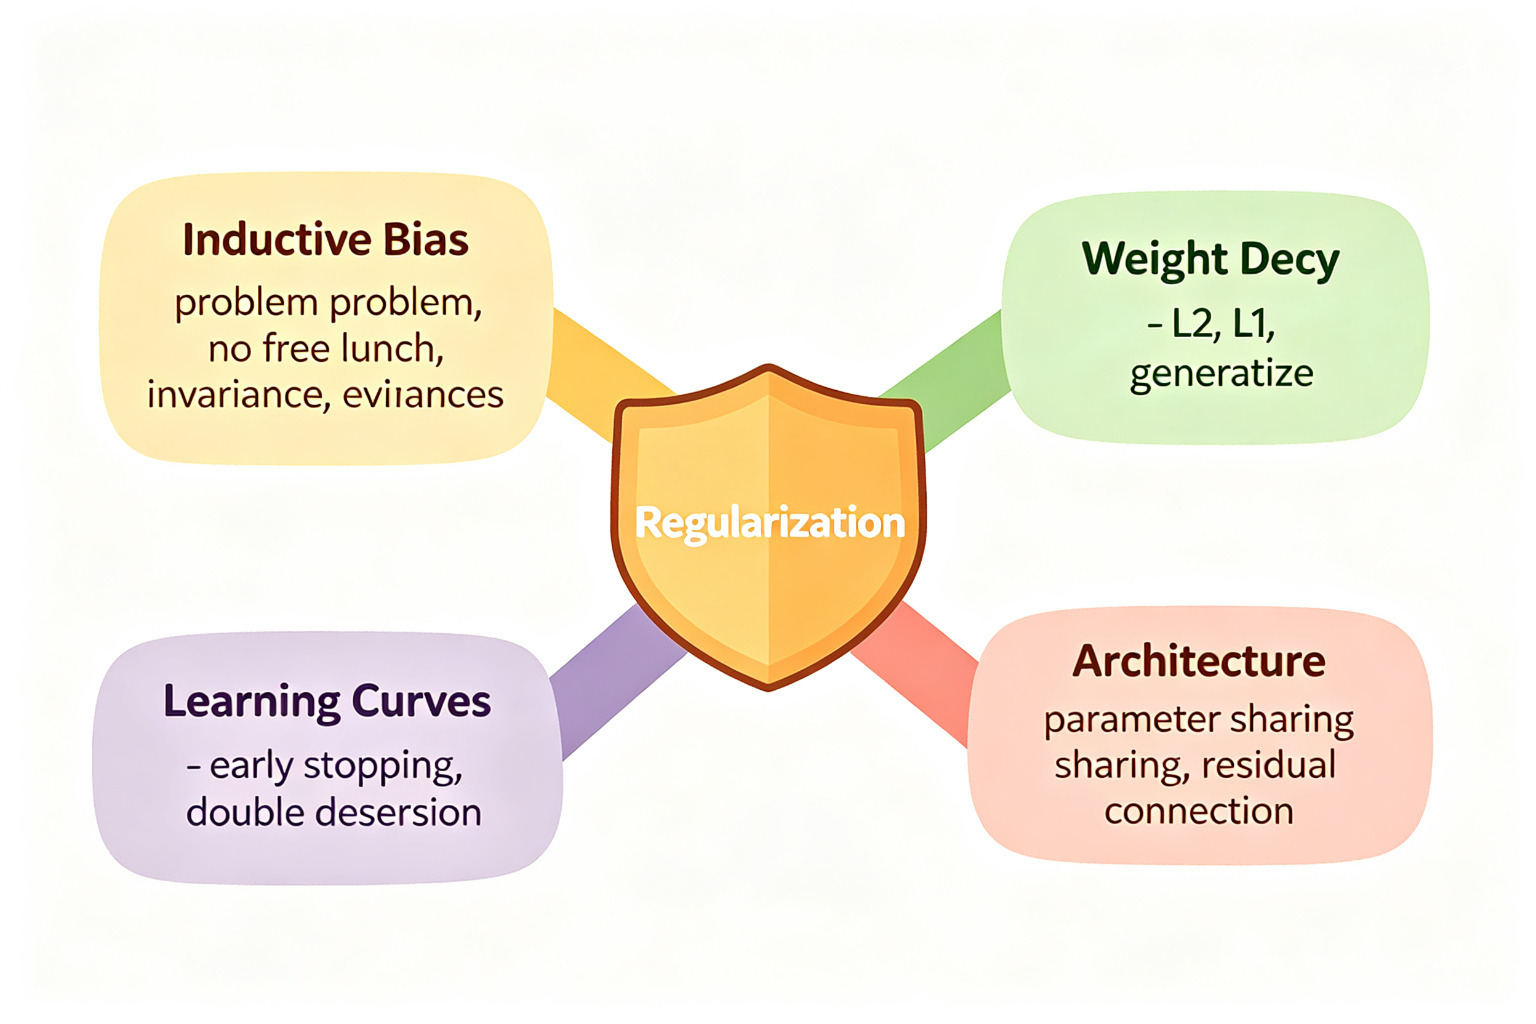
一句话概括:正则化通过限制模型复杂度防止过拟合,显式正则化包括L1(稀疏)和L2(权重衰减),隐式正则化包括Dropout、数据增强、早停等,实践中通常组合使用。
正则化方法清单:
| 方法 | 类型 | 核心思想 | 适用场景 |
|---|---|---|---|
| L2正则化 | 显式 | 权重平方和惩罚,权重衰减 | 大多数任务的默认选择 |
| L1正则化 | 显式 | 权重绝对值惩罚,产生稀疏 | 特征选择、模型压缩 |
| Dropout | 隐式 | 训练时随机丢弃神经元 | 全连接网络、复杂模型 |
| 数据增强 | 隐式 | 变换训练数据增加多样性 | 计算机视觉任务 |
| 早停 | 隐式 | 验证性能不升时停止训练 | 几乎总是应该使用 |
| 预训练微调 | 隐式 | 大数据预训练,小数据微调 | 数据量小、有预训练模型 |
| 模型集成 | 隐式 | 多个模型预测平均 | 竞赛、高性能要求 |
| 标签平滑 | 隐式 | 软标签代替硬标签 | 分类任务、防止过度自信 |
结语
本章我们彻底搞懂了正则化。从显式的L1/L2惩罚,到隐式的Dropout、数据增强、早停,每一种方法都是从不同角度限制模型复杂度、防止过拟合。理解了这些方法,你就不会再被过拟合困扰了。
正则化是深度学习实践中的核心技能之一。在实际项目中,通常会组合使用多种正则化方法:L2权重衰减 + Dropout + 数据增强 + 早停,再加上预训练微调和模型集成,就能得到一个泛化性能很好的模型。
到目前为止,我们已经学习了全连接神经网络的全部核心内容:网络结构、损失函数、优化算法、反向传播、性能评估、正则化。接下来,我们将进入更专业的网络结构领域。下一章的主题是卷积网络(Convolutional Networks)——一种专门为图像数据设计的神经网络,它利用了图像的空间局部性和平移不变性,在计算机视觉任务中取得了革命性的成功。
下一章见!
更多推荐

 1
 0
- 0


 已为社区贡献43条内容

所有评论(0)