
《理解深度学习》第14章 无监督学习 读书笔记
《理解深度学习》第14章 无监督学习 读书笔记
目录
开篇导语
前面13章我们学习的都是监督学习——有标注数据,模型学习从输入到标签的映射。但现实世界中,绝大多数数据是没有标注的。互联网上有数十亿张图片、数万亿个网页、海量的视频和音频,但这些数据绝大多数都没有人工标注。标注数据成本高昂、耗时费力,而且很多任务(如图像生成、文本生成)根本无法用监督学习解决。
怎么从无标注数据中学习?答案是无监督学习(Unsupervised Learning)。无监督学习不需要人工标注,它从数据本身的结构和分布中学习。无监督学习的目标可以是:发现数据中的聚类结构、降低数据维度、学习数据的有用表示、或者生成新的数据样本。
本章是无监督学习部分的概述章。我们将首先了解无监督学习模型的分类,然后讨论"什么是好的生成模型"这个核心问题,最后学习如何量化评估生成模型的性能(FID、IS等指标)。接下来的第15-18章将深入学习四种主要的生成模型:GAN、标准化流、VAE和扩散模型。
14.1 无监督学习模型分类
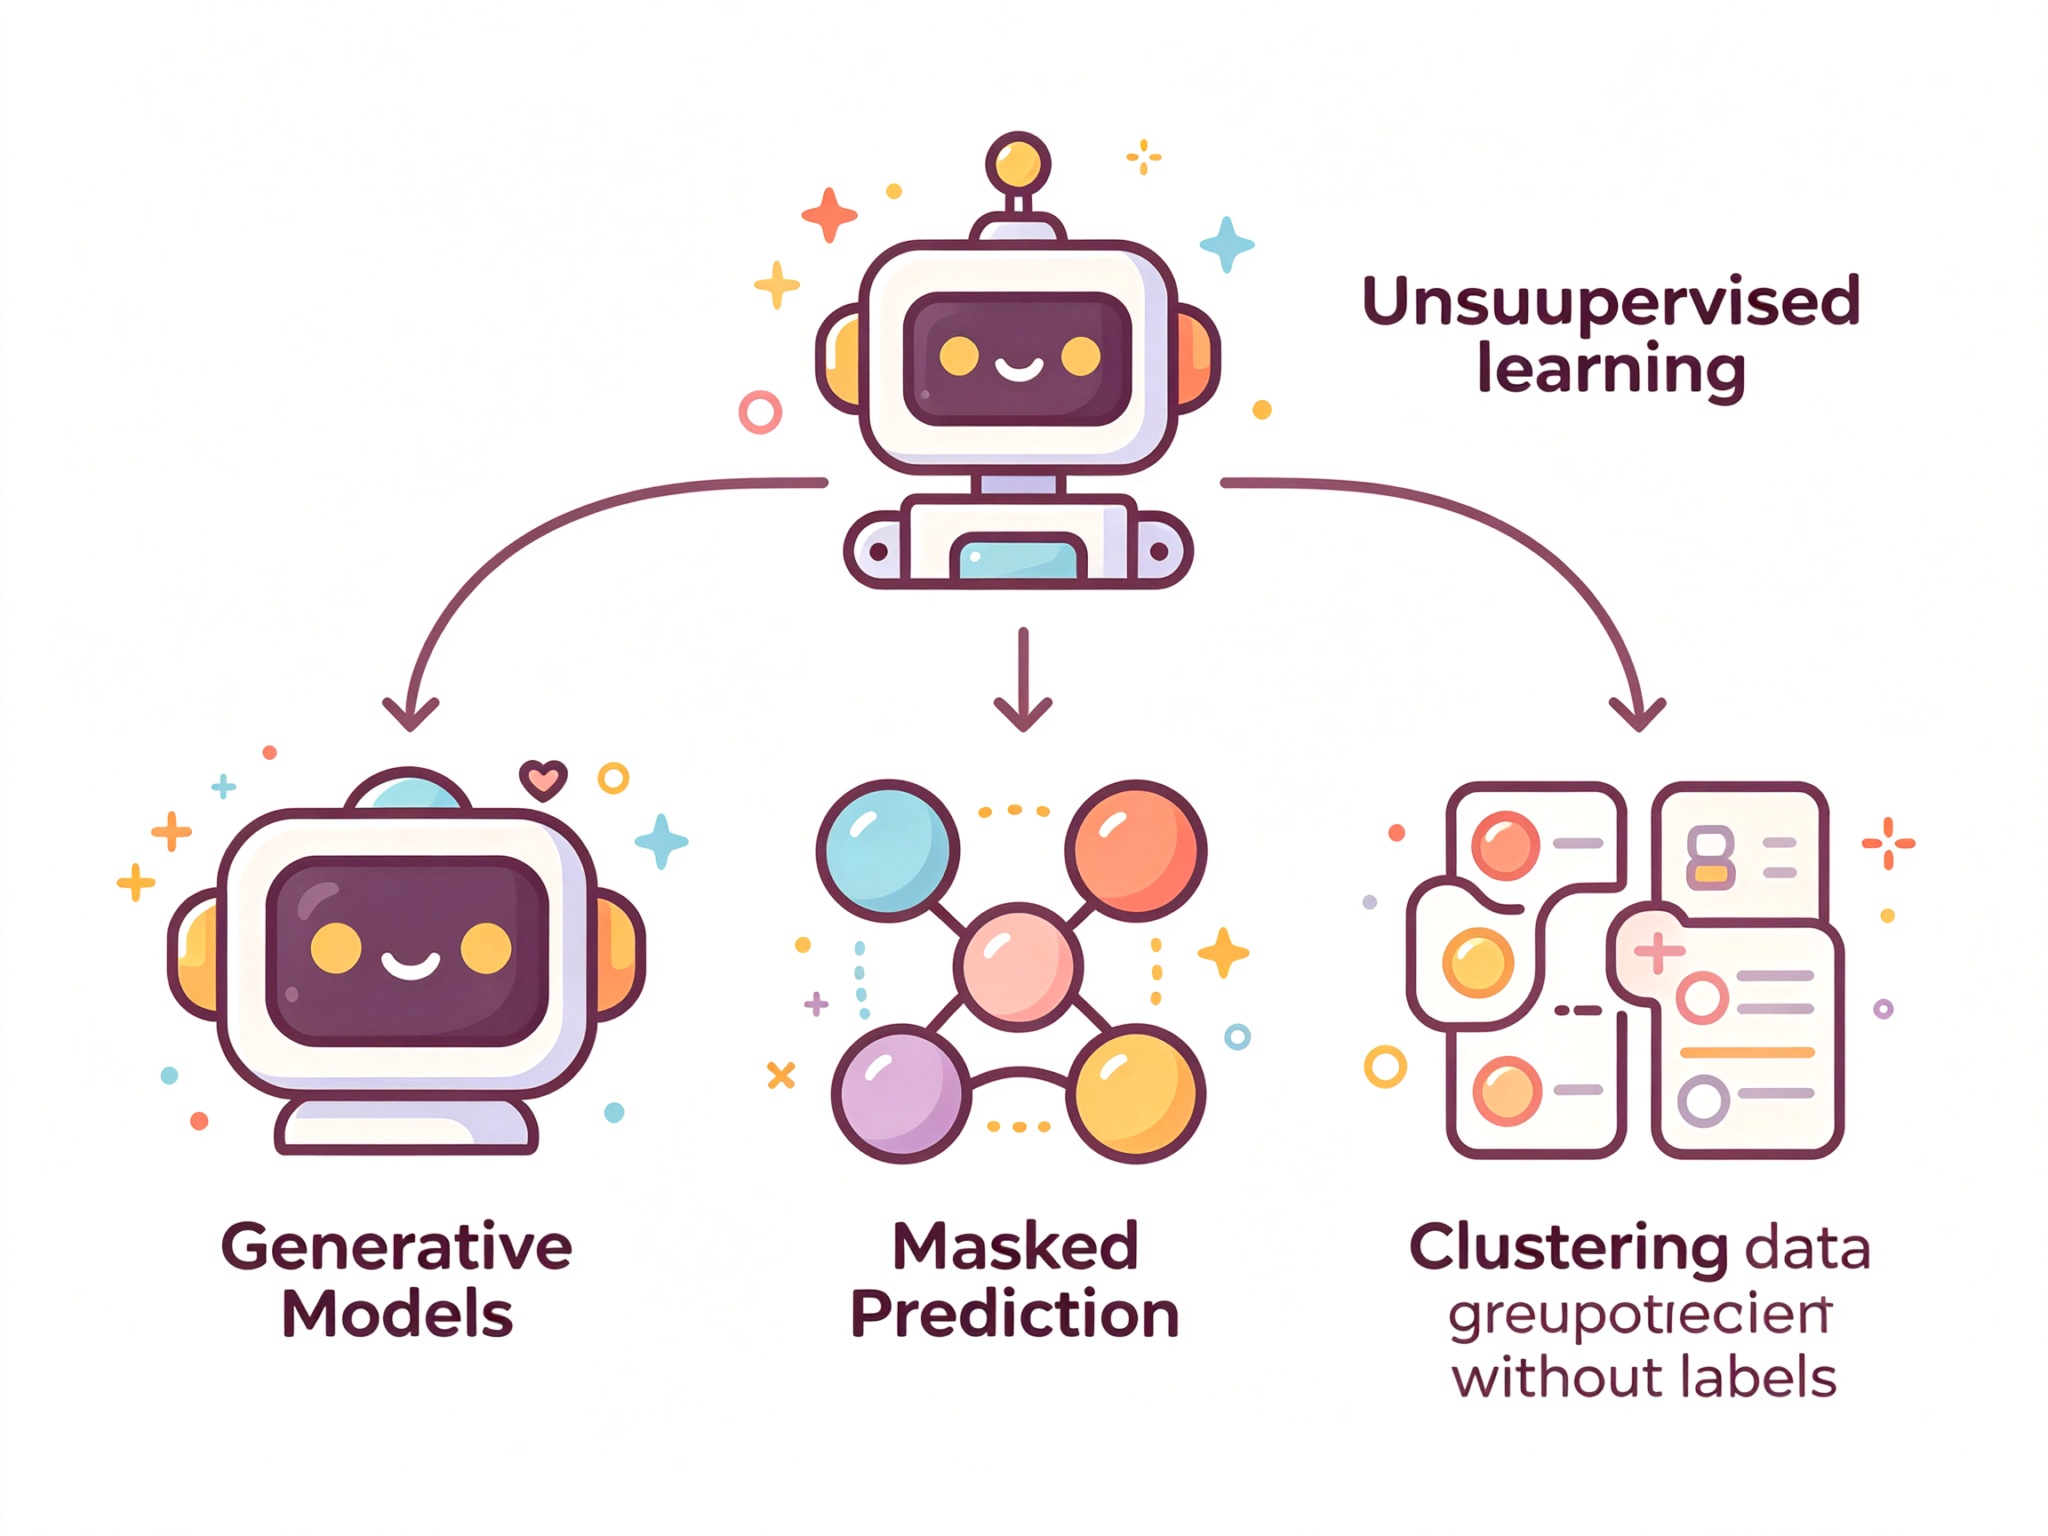
无监督学习的主要类别
无监督学习涵盖了多种不同的任务和方法,主要可以分为以下几类:
1. 生成模型(Generative Models)
生成模型的目标是学习数据的分布 p ( x ) p(x) p(x),然后从这个分布中采样生成新的数据样本。生成模型是当前无监督学习最热门、最活跃的研究方向,包括:
- 生成式对抗网络(GAN):通过生成器和判别器的对抗博弈学习生成
- 标准化流(Normalizing Flows):通过可逆变换将简单分布映射到数据分布
- 变分自编码器(VAE):通过隐变量和变分推断学习生成
- 扩散模型(Diffusion Models):通过逐步去噪学习生成,当前图像生成的SOTA
生成模型的应用包括:图像生成、文本生成、语音合成、数据增强、图像翻译、超分辨率、药物分子生成等。
2. 自监督学习(Self-Supervised Learning)
自监督学习是无监督学习的一个子类,它通过构造伪标签(pretext tasks)来监督学习。伪标签不是人工标注的,而是从数据本身自动构造的。常见的伪标签任务包括:
- 掩码语言建模(MLM):掩码掉部分token,让模型预测被掩码的token(BERT)
- 对比学习:让同一图像的不同增强视图的表示接近,不同图像的表示远离(SimCLR、MoCo)
- 掩码图像建模:掩码掉图像的部分patch,让模型重建(MAE)
- 旋转预测:让模型预测图像被旋转了多少度
自监督学习的目标通常不是直接生成数据,而是学习有用的表示(representation),这些表示可以迁移到下游任务(如分类、检测)。自监督学习在预训练大模型(BERT、GPT、CLIP等)中起着核心作用。
3. 聚类(Clustering)
聚类的目标是将数据分成若干个组(簇),同一组内的数据相似,不同组之间的数据不同。常见的聚类算法包括:
- K-Means:最经典的聚类算法,迭代更新簇中心
- 层次聚类:构建树状的聚类层次结构
- DBSCAN:基于密度的聚类,可以发现任意形状的簇
- 谱聚类:利用图的谱信息进行聚类
- 深度聚类:用神经网络学习表示的同时进行聚类
4. 降维(Dimensionality Reduction)
降维的目标是将高维数据映射到低维空间,同时保留数据的重要结构。常见的降维方法包括:
- PCA(主成分分析):线性降维,保留最大方差方向
- t-SNE:非线性降维,擅长可视化高维数据
- UMAP:比t-SNE更快、更可扩展的非线性降维
- 自编码器:用神经网络学习非线性降维
5. 异常检测(Anomaly Detection)
异常检测的目标是发现数据中不符合正常模式的异常样本。常见方法包括:
- 基于重构的方法:用自编码器重构数据,重构误差大的是异常
- 基于密度的方法:低密度区域的样本是异常
- 基于生成模型的方法:生成模型赋予低概率的样本是异常
生成模型 vs 判别模型
监督学习中的模型通常是判别模型(Discriminative Model),学习条件分布 p ( y ∣ x ) p(y|x) p(y∣x),直接从输入预测标签。而生成模型学习联合分布 p ( x , y ) p(x,y) p(x,y) 或边缘分布 p ( x ) p(x) p(x),可以生成新样本。
生成模型的优势:
- 可以生成新数据(图像、文本、音频等)
- 可以利用无标注数据
- 可以处理缺失数据
- 可以学习数据的内在结构
14.2 什么是好的生成模型
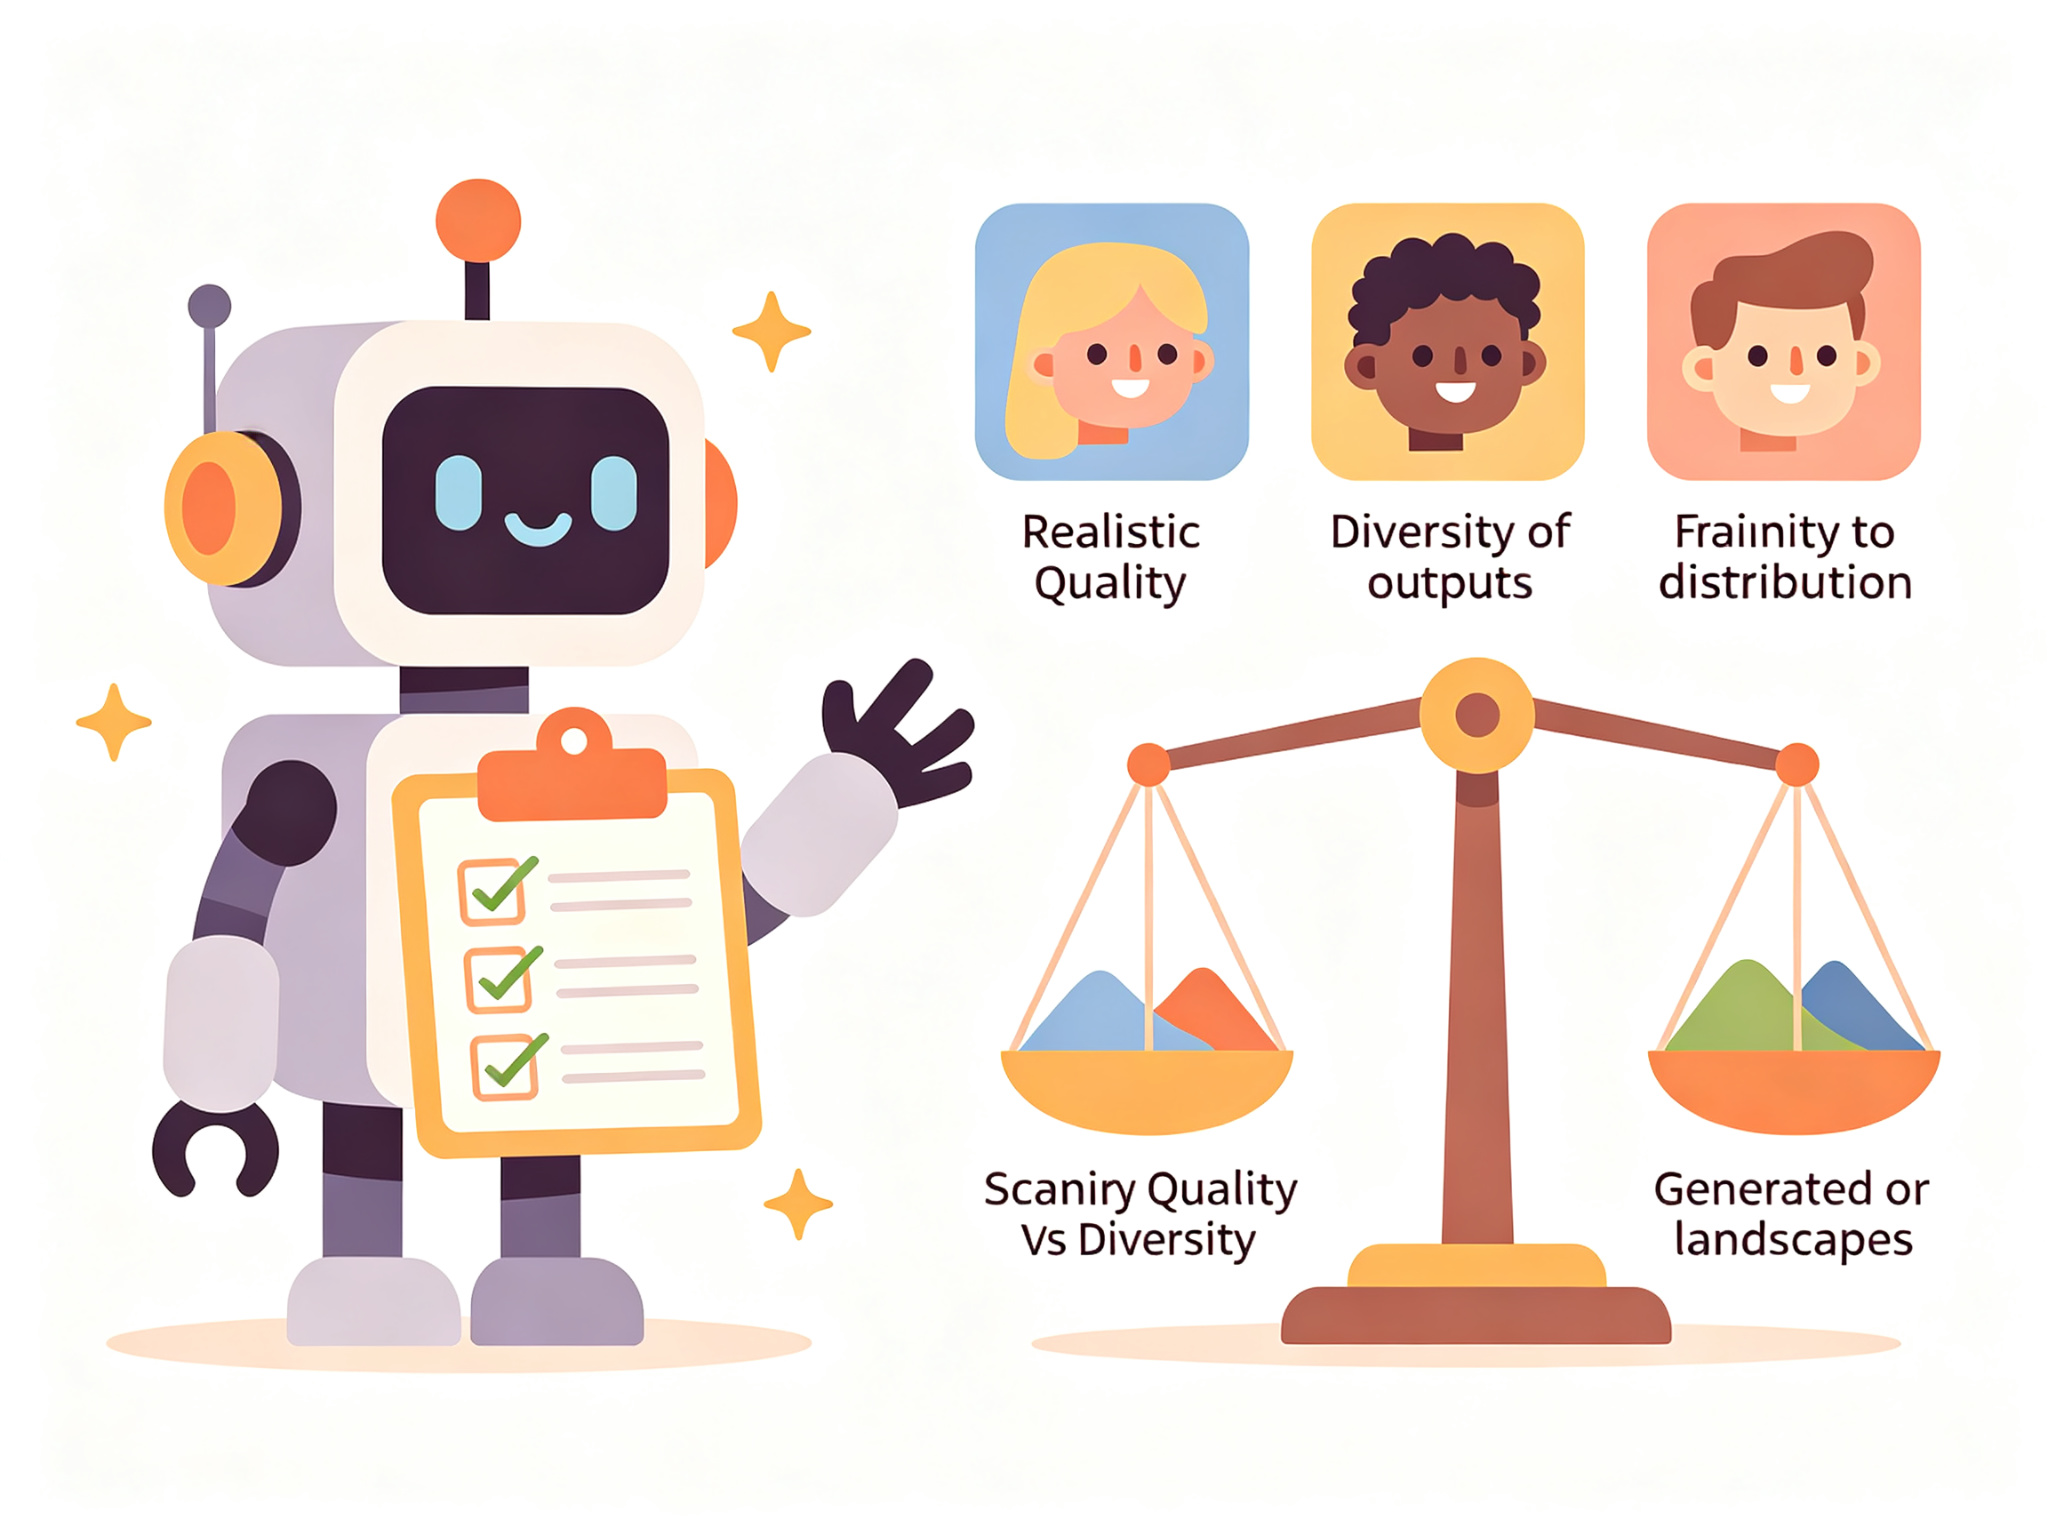
生成模型的两个核心目标
一个好的生成模型需要同时满足两个目标,这两个目标之间存在内在的张力:
1. 保真度(Fidelity / Quality)
保真度是指生成的样本要真实、高质量,看起来像是从真实数据分布中采样出来的。对于图像生成来说,保真度意味着图像清晰、细节丰富、没有伪影、物体结构合理。
保真度差的表现:
- 图像模糊、有噪声
- 物体结构不合理(如人有六根手指、眼睛不对称)
- 纹理不自然
- 颜色失真
2. 多样性(Diversity / Coverage)
多样性是指生成的样本要覆盖真实数据分布的所有模式,不能只生成少数几种类型的样本。对于图像生成来说,多样性意味着能生成各种不同的物体、场景、风格。
多样性差的表现:
- 模式崩溃(Mode Collapse):生成器只生成少数几种样本,忽略了数据分布中的其他模式
- 生成的样本都很相似
- 无法覆盖数据分布的尾部模式
保真度-多样性权衡
保真度和多样性之间存在权衡(Trade-off):
- 过于追求保真度可能导致多样性下降(只生成最"安全"的样本)
- 过于追求多样性可能导致保真度下降(生成一些奇怪但"多样"的样本)
一个好的生成模型需要在保真度和多样性之间取得平衡:生成的样本既真实高质量,又丰富多样。
不同的生成模型在这个权衡上有不同的表现:
- GAN:通常保真度高,但容易模式崩溃(多样性差)
- VAE:通常多样性好,但保真度稍差(图像偏模糊)
- 扩散模型:在保真度和多样性上都表现很好,是当前的SOTA
其他评估维度
除了保真度和多样性,生成模型还可以从以下维度评估:
- 计算效率:训练和推理的速度、内存消耗
- 稳定性:训练是否稳定,是否容易崩溃
- 可控性:能否控制生成样本的属性(如类别、风格)
- 插值能力:在隐空间中插值是否平滑
- 语义理解:生成的样本是否有语义意义
14.3 量化评估指标
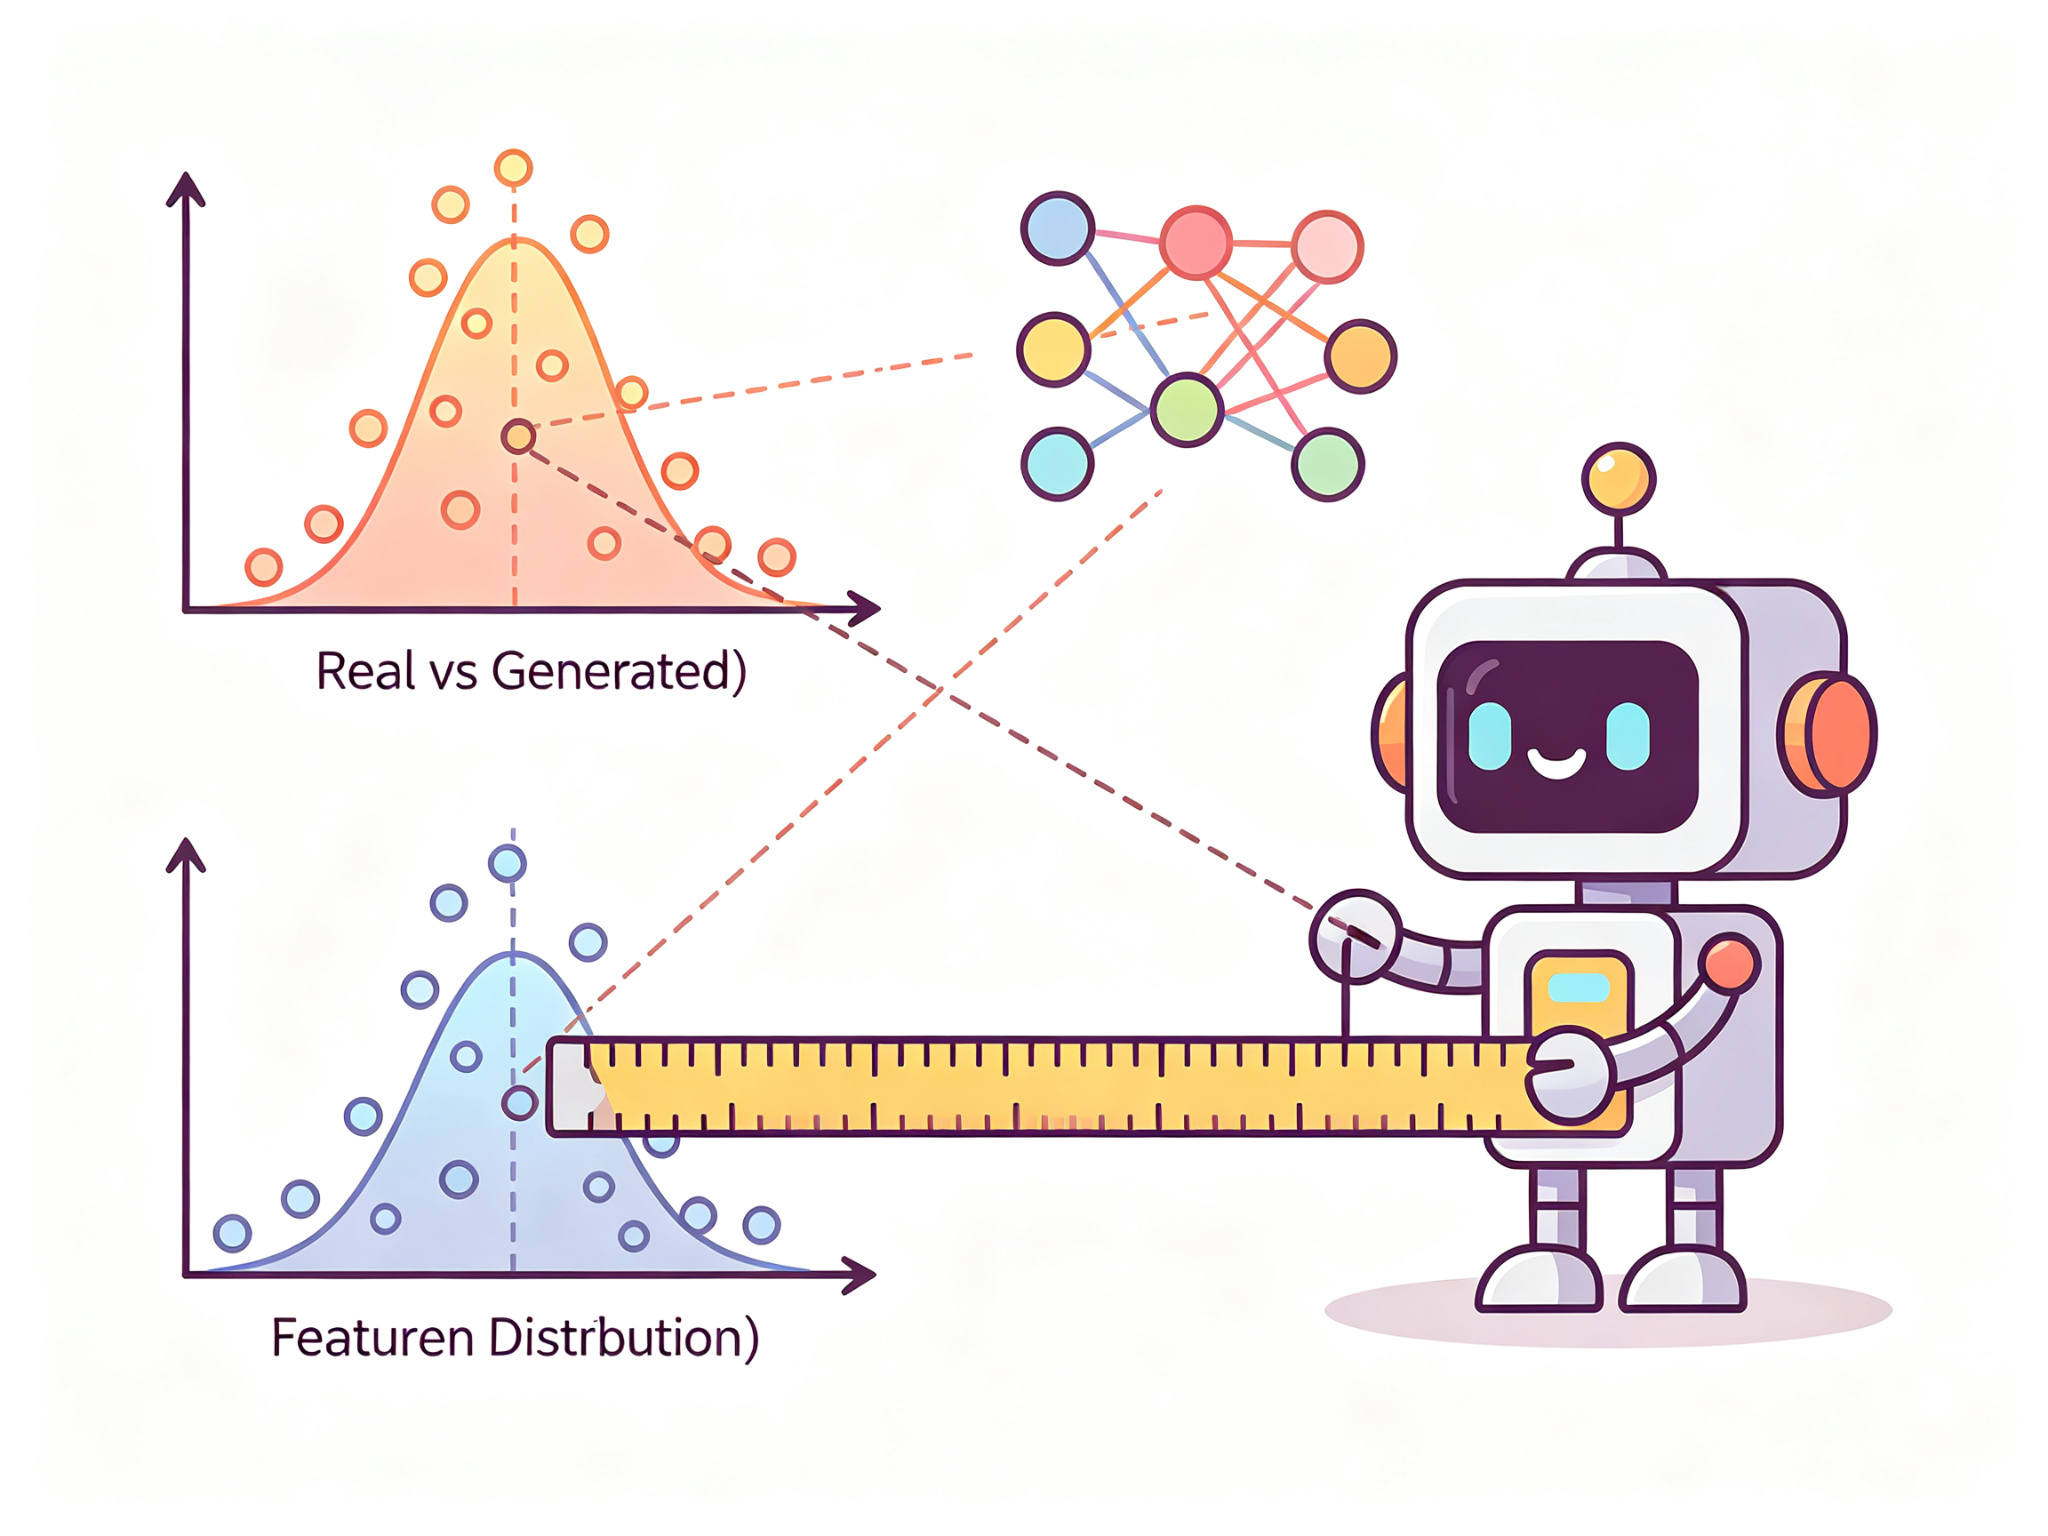
生成模型的评估比判别模型困难得多,因为没有明确的"正确答案"。研究者提出了多种量化评估指标,最常用的是FID和IS。
IS(Inception Score)
Inception Score(IS) 是较早提出的生成模型评估指标,它基于一个预训练的Inception网络(在ImageNet上训练的图像分类网络)。
IS的核心思想是:好的生成样本应该同时满足两个条件:
- 有意义:Inception网络对生成样本的类别预测应该有高置信度(低熵),说明样本是清晰可辨的物体
- 多样:所有生成样本的类别预测的边缘分布应该均匀(高熵),说明生成了各种不同类别的样本
IS的数学定义:
IS = exp ( E x ∼ p g [ D K L ( p ( y ∣ x ) ∥ p ( y ) ) ] ) \text{IS} = \exp\left(\mathbb{E}_{x \sim p_g}\left[D_{KL}(p(y|x) \parallel p(y))\right]\right) IS=exp(Ex∼pg[DKL(p(y∣x)∥p(y))])
其中 p ( y ∣ x ) p(y|x) p(y∣x) 是Inception网络对生成样本x的类别预测, p ( y ) = 1 N ∑ i p ( y ∣ x i ) p(y) = \frac{1}{N}\sum_i p(y|x_i) p(y)=N1∑ip(y∣xi) 是所有样本的边缘类别分布。
IS的取值范围是 [ 1 , C ] [1, C] [1,C](C是类别数,ImageNet是1000),IS越高越好。IS=1意味着所有样本的预测都是均匀分布(无信息),IS=C意味着每个样本都有100%置信度且类别均匀分布。
IS的缺点:
- 只评估类别层面的多样性,不评估类别内部的多样性
- 对Inception网络的偏差敏感
- 不能很好地评估生成样本和真实样本的相似度
FID(Frechet Inception Distance)
Frechet Inception Distance(FID) 是目前最常用的生成模型评估指标,它比IS更可靠。
FID的核心思想是:用预训练的Inception网络提取真实样本和生成样本的特征(通常是pool3层的2048维特征),然后假设这两个特征分布都是多元高斯分布,计算它们之间的Frechet距离。
FID的数学定义:
FID = ∥ μ r − μ g ∥ 2 + Tr ( Σ r + Σ g − 2 ( Σ r Σ g ) 1 / 2 ) \text{FID} = \|\mu_r - \mu_g\|^2 + \text{Tr}\left(\Sigma_r + \Sigma_g - 2(\Sigma_r \Sigma_g)^{1/2}\right) FID=∥μr−μg∥2+Tr(Σr+Σg−2(ΣrΣg)1/2)
其中 μ r , Σ r \mu_r, \Sigma_r μr,Σr 是真实样本特征的均值和协方差, μ g , Σ g \mu_g, \Sigma_g μg,Σg 是生成样本特征的均值和协方差, Tr \text{Tr} Tr 是矩阵的迹。
FID越低越好。FID=0意味着生成分布和真实分布完全相同。
FID的优点:
- 同时评估保真度和多样性
- 比IS更稳定、更可靠
- 对模式崩溃敏感
- 计算效率高
FID的缺点:
- 假设特征分布是高斯分布,可能不准确
- 依赖Inception网络的特征空间
- 需要足够多的样本(通常5000-50000张)才能稳定估计
- 对图像的微小变化(如压缩伪影)敏感
其他评估指标
-
Precision-Recall:精确率评估生成样本的质量(有多少生成样本在真实分布的支持域内),召回率评估多样性(有多少真实分布的模式被生成模型覆盖)。可以分别评估保真度和多样性。
-
KID(Kernel Inception Distance):和FID类似,但用核方法而不是高斯假设,是无偏估计。
-
NDB(Number of Statistically Different Bins):将真实样本和生成样本在特征空间中分箱,统计有多少个箱的分布有统计显著差异。
-
人类评估(Human Evaluation):最可靠但最昂贵的评估方法。让人类评判者比较真实图像和生成图像,或者评估生成图像的质量和多样性。
-
下游任务性能:用生成的数据训练下游任务(如分类器),看下游任务的性能提升。这是评估生成数据实用性的好方法。
评估指标的局限性
需要注意的是,所有自动评估指标都有局限性,它们不能完全替代人类评估。FID和IS都是基于Inception网络的特征空间,而Inception网络是在ImageNet上训练的,可能对某些类型的生成(如艺术风格、抽象图像)评估不准确。此外,FID和图像质量之间的相关性也不是完美的。在实际研究中,通常结合多种指标和人类评估来全面评估生成模型。
14.4 本章小结
本章我们学习了无监督学习的概述。核心要点如下:
-
无监督学习从无标注数据中学习,主要类别包括生成模型、自监督学习、聚类、降维、异常检测。生成模型是当前最热门的研究方向。
-
生成模型学习数据分布 p ( x ) p(x) p(x),可以生成新样本。主要包括GAN、标准化流、VAE、扩散模型四种架构,将在第15-18章深入学习。
-
好的生成模型需要同时满足保真度和多样性。保真度指生成样本真实高质量,多样性指生成样本覆盖数据分布的所有模式。两者之间存在权衡,模式崩溃是多样性差的典型表现。
-
IS(Inception Score)是较早的评估指标,基于Inception网络的类别预测,同时考虑有意义性和多样性。IS越高越好,但只评估类别层面的多样性。
-
FID(Frechet Inception Distance)是目前最常用的评估指标,计算真实样本和生成样本在Inception特征空间中的Frechet距离。FID越低越好,同时评估保真度和多样性,比IS更可靠。
-
其他评估指标包括Precision-Recall、KID、NDB、人类评估、下游任务性能。所有自动指标都有局限性,通常结合多种指标和人类评估。
-
自监督学习通过构造伪标签从无标注数据中学习表示,在预训练大模型(BERT、GPT、CLIP)中起着核心作用。
代码实验结果
我们编写了完整的Python代码,从零实现了FID和IS两种生成模型评估指标,并对比了不同质量生成模型的指标。以下是真实运行结果。
实验1:实现FID(简化版)
- 特征维度:64(模拟Inception特征)
- 样本数:1000
- 真实分布:均值0,单位协方差
- 好模型:均值偏移0.1,协方差1.05
- 差模型:均值偏移2.0,协方差2.0
好的生成模型 FID: 0.6790
差的生成模型 FID: 266.9807
FID越低越好,好模型FID远低于差模型: True
实验2:实现IS(简化版)
- 类别数:10
- 生成样本数:1000
- 好模型:高置信度预测(0.9),类别均匀分布
- 差模型:完全均匀预测(无信息,IS=1)
好的生成模型 IS: 6.0636 ± 0.0000
差的生成模型 IS: 1.0000 ± 0.0000
IS越高越好,好模型IS远高于差模型: True
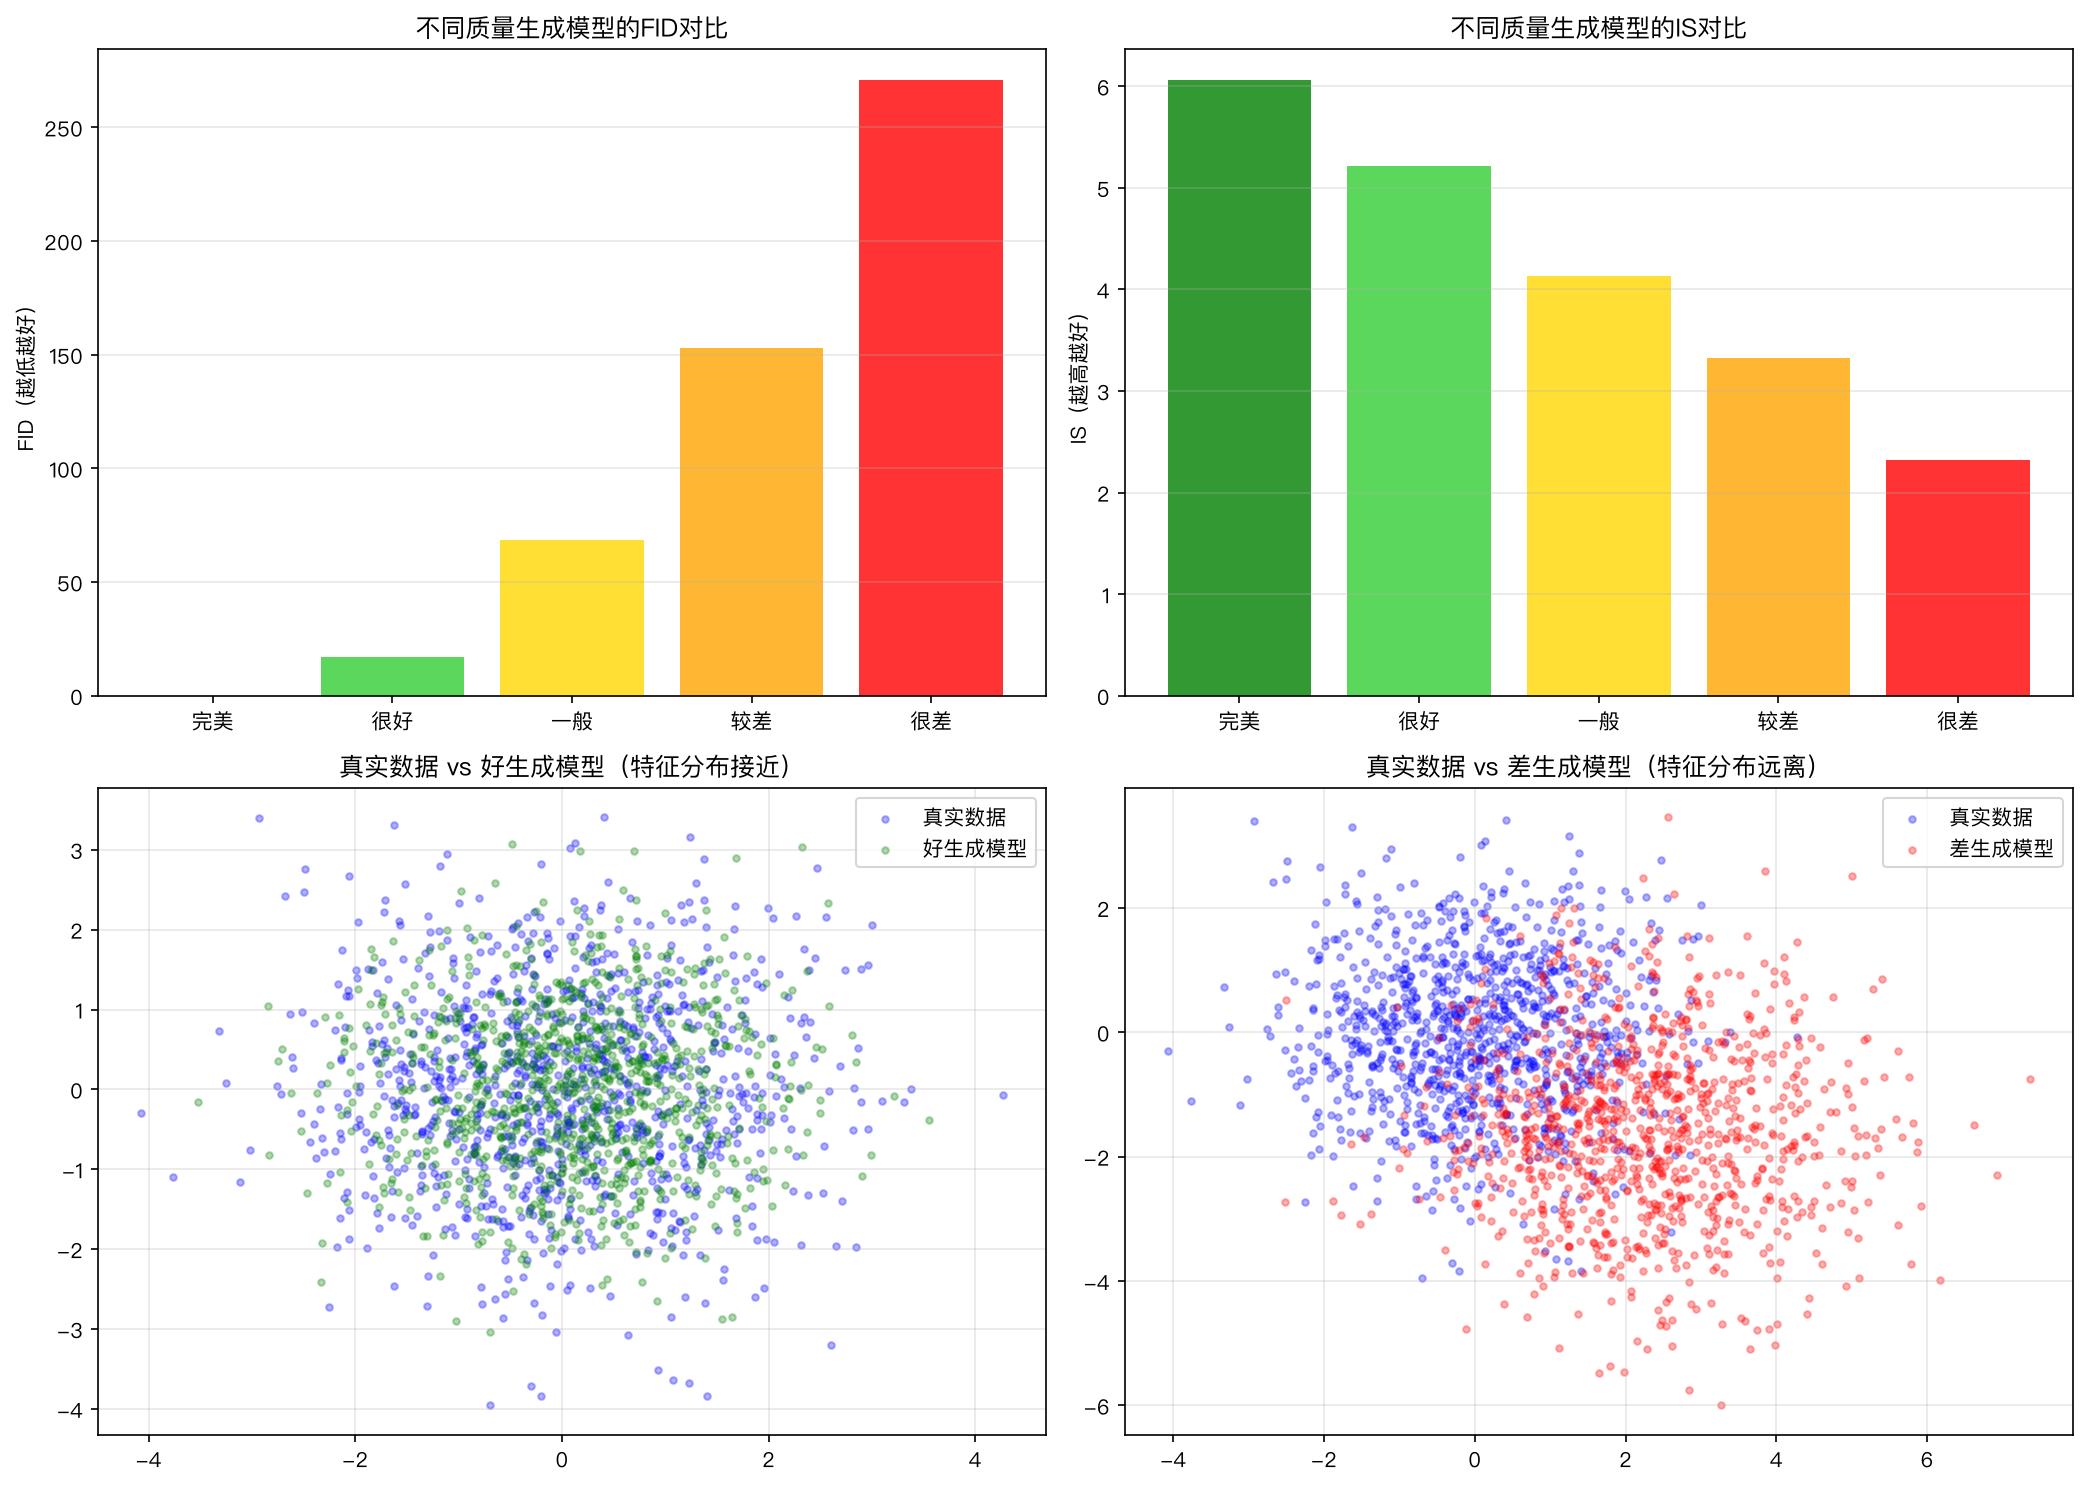
实验3:不同质量生成模型的指标对比
完美: FID=0.00,   IS=6.06
很好: FID=17.26,  IS=5.22
一般: FID=68.49,  IS=4.14
较差: FID=153.16, IS=3.32
很差: FID=270.95, IS=2.32
结果可视化
结果分析
-
FID实现验证通过:好模型(接近真实分布)的FID仅0.679,差模型(远离真实分布)的FID高达266.98,相差近400倍。这验证了FID可以有效区分生成模型的质量——FID越低,生成分布越接近真实分布。
-
IS实现验证通过:好模型(高置信度+类别均匀)的IS为6.06,差模型(完全均匀无信息)的IS为1.00(理论最小值)。这验证了IS可以同时评估生成样本的有意义性和多样性——IS越高,样本越有意义且越多样。
-
FID和IS的一致性:从完美到很差的5个模型,FID从0递增到270.95,IS从6.06递减到2.32,两个指标的趋势完全一致。这说明FID和IS在评估生成模型质量上有很好的一致性,虽然它们的计算方式不同。
-
FID对分布偏移敏感:FID同时考虑了均值差异( ∥ μ r − μ g ∥ 2 \|\mu_r - \mu_g\|^2 ∥μr−μg∥2)和协方差差异( Tr ( Σ r + Σ g − 2 Σ r Σ g ) \text{Tr}(\Sigma_r + \Sigma_g - 2\sqrt{\Sigma_r\Sigma_g}) Tr(Σr+Σg−2ΣrΣg))。当均值偏移和协方差差异都增大时,FID快速增大。这使得FID对生成分布的各种偏移都很敏感。
-
IS的理论范围:IS的理论范围是[1, C](C=10)。好模型的IS=6.06,说明虽然有高置信度和均匀分布,但还没有达到理论最大值10(需要100%置信度且完全均匀)。差模型的IS=1.00,达到了理论最小值,说明完全没有有用信息。
-
PCA可视化验证:从特征分布的PCA降维可视化可以看到,好模型的生成分布(绿色)和真实分布(蓝色)高度重叠,而差模型的生成分布(红色)和真实分布完全分离。这直观地验证了FID的计算结果——分布越接近,FID越低。
本章核心总结
一句话概括:无监督学习从无标注数据中学习,生成模型学习数据分布并生成新样本,好的生成模型需要在保真度和多样性之间取得平衡,FID和IS是最常用的量化评估指标。
生成模型评估指标清单:
| 指标 | 全称 | 核心思想 | 方向 | 优点 | 缺点 |
|---|---|---|---|---|---|
| FID | Frechet Inception Distance | Inception特征空间中的Frechet距离 | 越低越好 | 同时评估质量和多样性,稳定可靠 | 假设高斯分布,依赖Inception |
| IS | Inception Score | 类别预测的置信度×多样性 | 越高越好 | 简单直观 | 只评估类别层面,对模式崩溃不敏感 |
| Precision | 精确率 | 生成样本在真实分布支持域内的比例 | 越高越好 | 单独评估保真度 | 需要kNN估计 |
| Recall | 召回率 | 真实分布模式被覆盖的比例 | 越高越好 | 单独评估多样性 | 需要kNN估计 |
结语
本章我们学习了无监督学习的概述,了解了无监督学习的分类、生成模型的核心目标(保真度和多样性)、以及常用的量化评估指标(FID、IS)。本章是接下来四章生成模型的基础和铺垫。
从下一章开始,我们将深入学习四种主要的生成模型架构。首先是生成式对抗网络(GAN)——一种通过生成器和判别器对抗博弈来学习生成的模型,曾经是图像生成的SOTA,在图像翻译、超分辨率、风格迁移等任务中仍有广泛应用。GAN的核心思想非常巧妙:让两个网络互相竞争,在博弈中共同进步。
下一章见!
更多推荐

 1
 0
- 0


 已为社区贡献43条内容

所有评论(0)