


- @weixin_46739757


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
如何解决传统单体视频字幕中视听信息纠缠导致局部修改困难、身份指代模糊及跨模态对齐弱的问题?论文提出了多流场景脚本(MTSS)范式,通过流分解与关系接地机制,显著提升了视频理解的忠实度、推理能力及多镜头生成的可控性。

如何评估多模态大语言模型(MLLM)在视频理解任务中的后训练有效性?🔸主要贡献:论文提出了SEED-Bench-R1基准,系统评估强化学习(RL)与监督微调(SFT)在视频理解中的表现,展示了RL的优越性和未来研究方向。

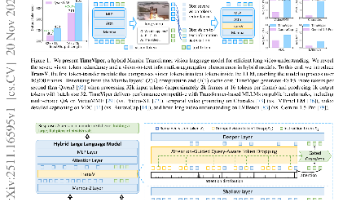
如何在长视频理解中提高效率和减少视觉信息冗余?论文提出了TimeViper,一种混合的Mamba-Transformer模型,通过内部的LLM令牌压缩机制TransV来高效理解长视频。
如何构建一种通用的科学人工智能代理,以提升在复杂科学挑战中的表现,特别是在“人类最后考试”中的表现。论文的贡献在于提出了一种新型的工具增强推理代理X-Master,其在“人类最后考试”中取得了超过30%的新纪录,超过了以往的闭源模型。

如何有效评估深度研究代理(Deep Research Agents)的报告生成质量和信息检索能力?论文提出了DeepResearch Bench,一个针对深度研究代理的综合性基准,以系统评估其能力。

如何进行计算机使用代理(CUA)在混合网络和操作系统环境中的现实对抗性测试,以评估其对间接提示注入的脆弱性?论文提出了REDTEAMCUA框架和RTC-BENCH基准,提供了一种系统化的对抗性分析方法,揭示了CUA在混合环境下的重大安全漏洞。
如何评估人工智能在从头复制机器学习研究论文结果方面的能力?论文提出了一个名为PaperBench的基准,旨在评估AI代理的复制能力,并提供了一套详尽的评估标准和自动化评分流程。

大语言模型(LLM)在博弈论场景中存在理性行为和决策能力不足现象。论文提出了一种基于博弈论的工作流程,旨在增强LLM在战略环境中的理性行为和决策能力。

如何通过多步骤协作生成高质量的长篇故事?论文提出了一个名为AGENTS' ROOM的多代理协作写作框架,并展示了其在长篇故事生成中的有效性。

由于高质量代理数据集的稀缺以及该领域标准协议的缺乏,开源社区在开发代理任务的专用模型方面面临着许多挑战。论文开发并开源了一系列大规模动作模型(xLAM),这些模型在公共代理基准测试中表现出色,同时提供了数据处理和合成技术的关键见解。
