
《理解深度学习》第10章 卷积网络 读书笔记
《理解深度学习》第10章 卷积网络 读书笔记
目录
开篇导语
前面九章我们学习的都是全连接神经网络——每一层的每个神经元都和上一层的所有神经元相连。全连接网络虽然强大,但在处理图像数据时存在一个致命问题:参数量太大。一张224×224的彩色图片有15万个输入,如果第一层有1000个神经元,光这一层就有150亿个参数!这不仅计算量巨大,还极易过拟合。
怎么解决这个问题?答案是卷积网络(Convolutional Neural Network,CNN)。卷积网络利用了图像的两个关键特性:局部性(图像中相邻像素的关系比远距离像素更紧密)和平移不变性(一只猫不管在图片的哪个位置都是猫)。通过卷积操作,卷积网络用少量的参数(卷积核)就能提取图像中的各种特征,在计算机视觉任务中取得了革命性的成功。
本章我们将系统学习卷积网络。首先理解不变性和等变性的概念,然后学习一维和二维卷积操作,接着讨论下采样(池化)和上采样,最后看卷积网络在实际中的应用。
10.1 不变性和等变性
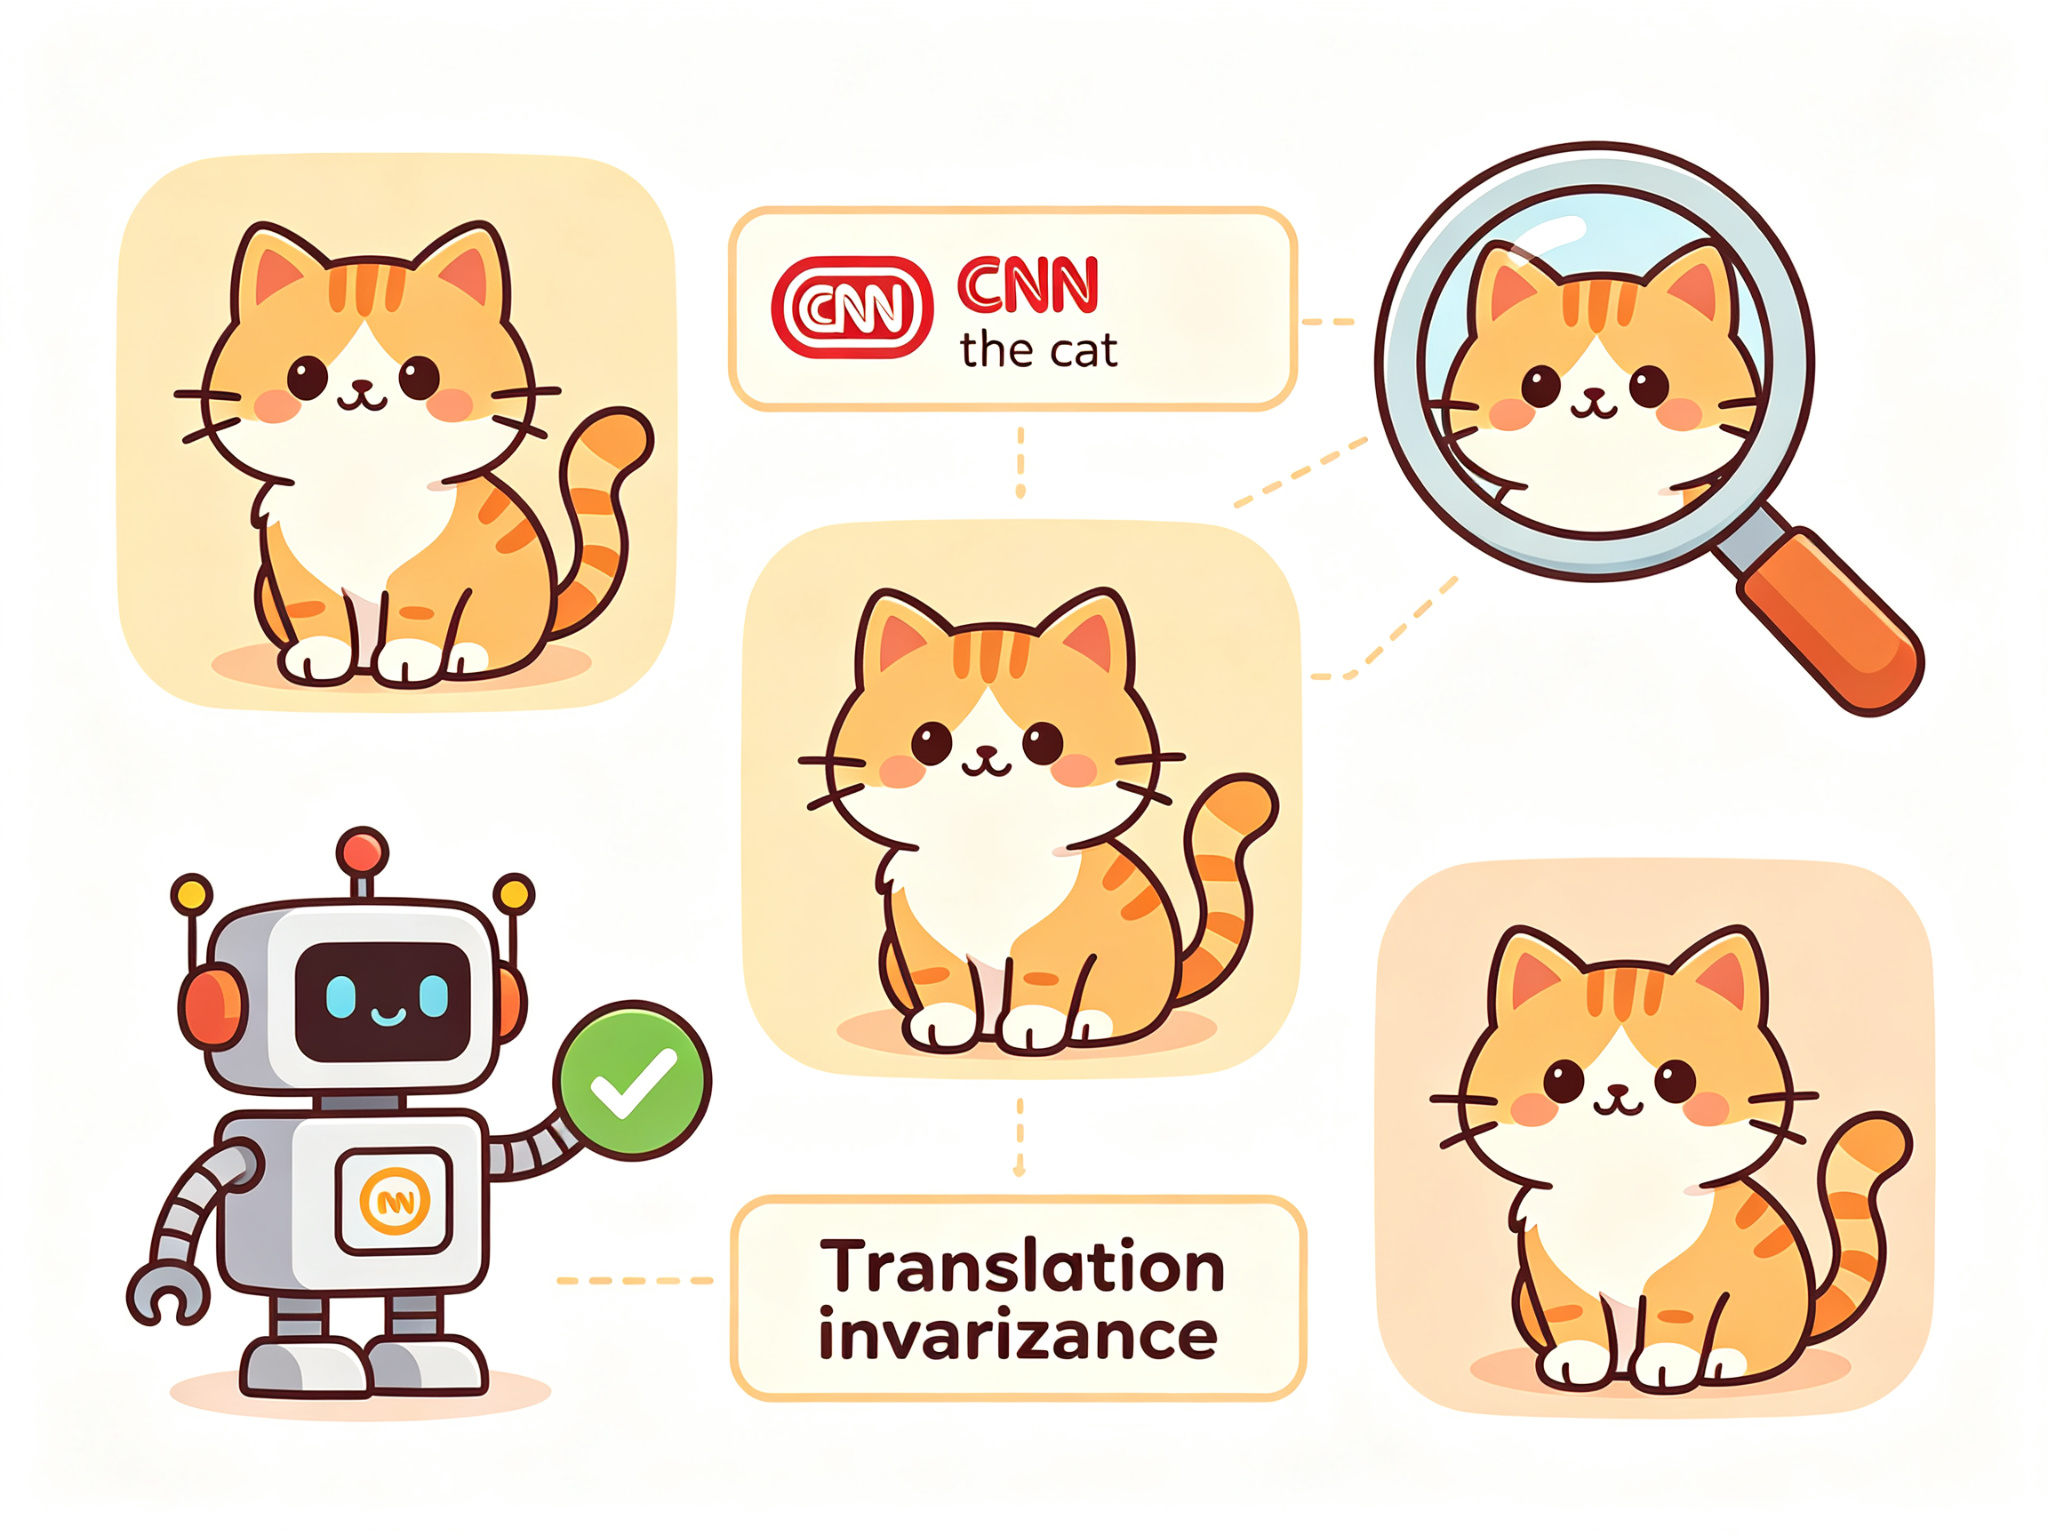
在理解卷积网络之前,我们需要先理解两个重要的概念:不变性(Invariance) 和等变性(Equivariance)。
不变性
不变性是指:当输入发生某种变换时,输出保持不变。在图像分类任务中,我们希望模型具有平移不变性——不管猫在图片的左上角、中心还是右下角,模型都应该把它分类为"猫"。
全连接网络天然不具有平移不变性。因为全连接网络的每个参数对应输入的一个特定位置,如果猫从图片中心移到左上角,激活的神经元完全不同,模型需要重新学习"左上角的猫"这个概念。
卷积网络通过权值共享(同一个卷积核在图片的所有位置上滑动)天然具有平移等变性,再配合池化操作就能实现平移不变性。
等变性
等变性是指:当输入发生某种变换时,输出也发生相同的变换。在卷积网络中,卷积操作具有平移等变性——如果输入图片平移了,输出的特征图也会相应地平移。
数学上,等变性可以表示为:
f ( g ( x ) ) = g ( f ( x ) ) f(g(x)) = g(f(x)) f(g(x))=g(f(x))
其中 g g g 是某种变换(如平移), f f f 是网络操作。等变性意味着"先变换再处理"和"先处理再变换"得到的结果相同。
不变性和等变性的关系:等变性是比不变性更弱的性质。如果一个操作具有等变性,那么通过后续的聚合操作(如池化、全局平均)就能实现不变性。卷积网络的设计正是利用了这一点:卷积层提供平移等变性,池化层逐步实现平移不变性。
10.2 用于一维输入的卷积网络
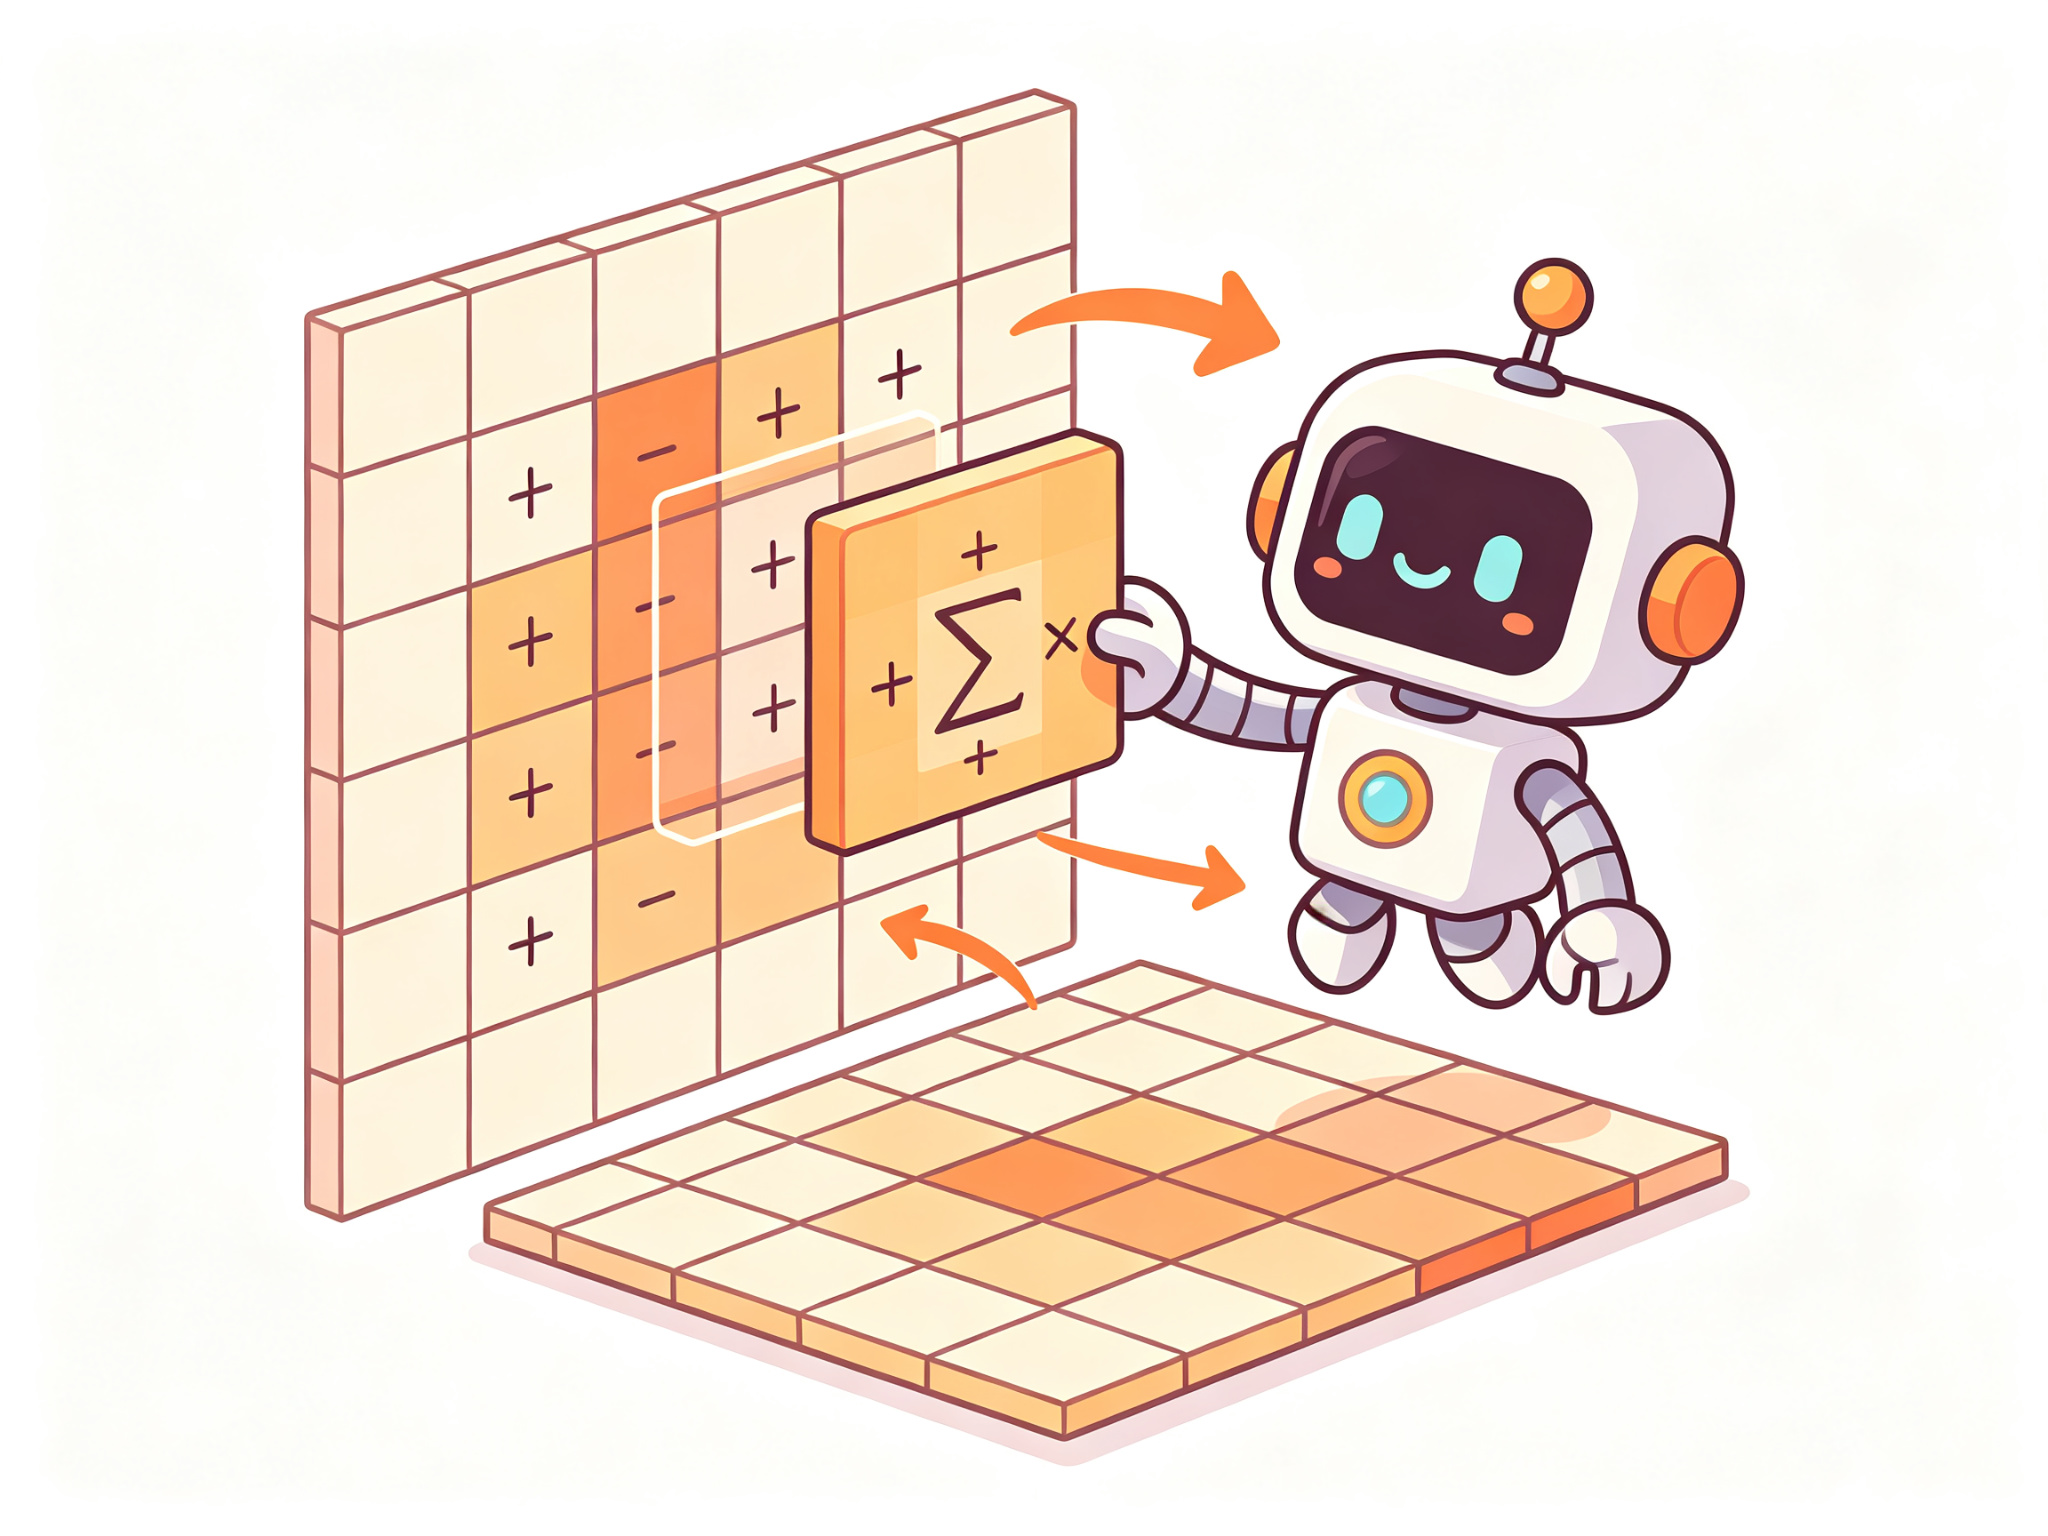
我们先从最简单的一维卷积开始理解卷积操作。一维卷积常用于处理序列数据,如文本、音频、时间序列等。
一维卷积操作
一维卷积的操作很简单:有一个输入序列 x = [ x 1 , x 2 , … , x N ] x = [x_1, x_2, \ldots, x_N] x=[x1,x2,…,xN] 和一个卷积核(也叫滤波器) w = [ w 1 , w 2 , … , w K ] w = [w_1, w_2, \ldots, w_K] w=[w1,w2,…,wK],卷积核在输入序列上滑动,每次和对应位置的输入做逐元素相乘再求和,得到输出序列的一个元素。
数学上,一维卷积的输出为:
y i = ∑ k = 1 K w k ⋅ x i + k − 1 y_i = \sum_{k=1}^{K} w_k \cdot x_{i+k-1} yi=k=1∑Kwk⋅xi+k−1
其中 i i i 是输出位置, K K K 是卷积核大小。如果输入长度为 N N N,卷积核大小为 K K K,步长(stride)为 S S S,填充(padding)为 P P P,那么输出长度为:
L o u t = ⌊ N + 2 P − K S ⌋ + 1 L_{out} = \left\lfloor \frac{N + 2P - K}{S} \right\rfloor + 1 Lout=⌊SN+2P−K⌋+1
关键参数
- 卷积核大小(Kernel Size):卷积核覆盖的输入区域大小。越大的卷积核能捕捉越大范围的特征,但参数量也越多。
- 步长(Stride):卷积核每次滑动的距离。步长越大,输出尺寸越小,相当于下采样。
- 填充(Padding):在输入边缘补零的数量。填充可以控制输出尺寸,“same padding”(填充使得输出和输入尺寸相同)很常用。
一维卷积的优势
相比于全连接网络,一维卷积有两个核心优势:
- 参数共享:同一个卷积核在所有位置上使用,参数量从 N × H N \times H N×H 减少到 K K K( K ≪ N K \ll N K≪N)。
- 局部连接:每个输出只依赖输入的一个局部区域,利用了序列数据的局部相关性。
10.3 二维输入的卷积网络
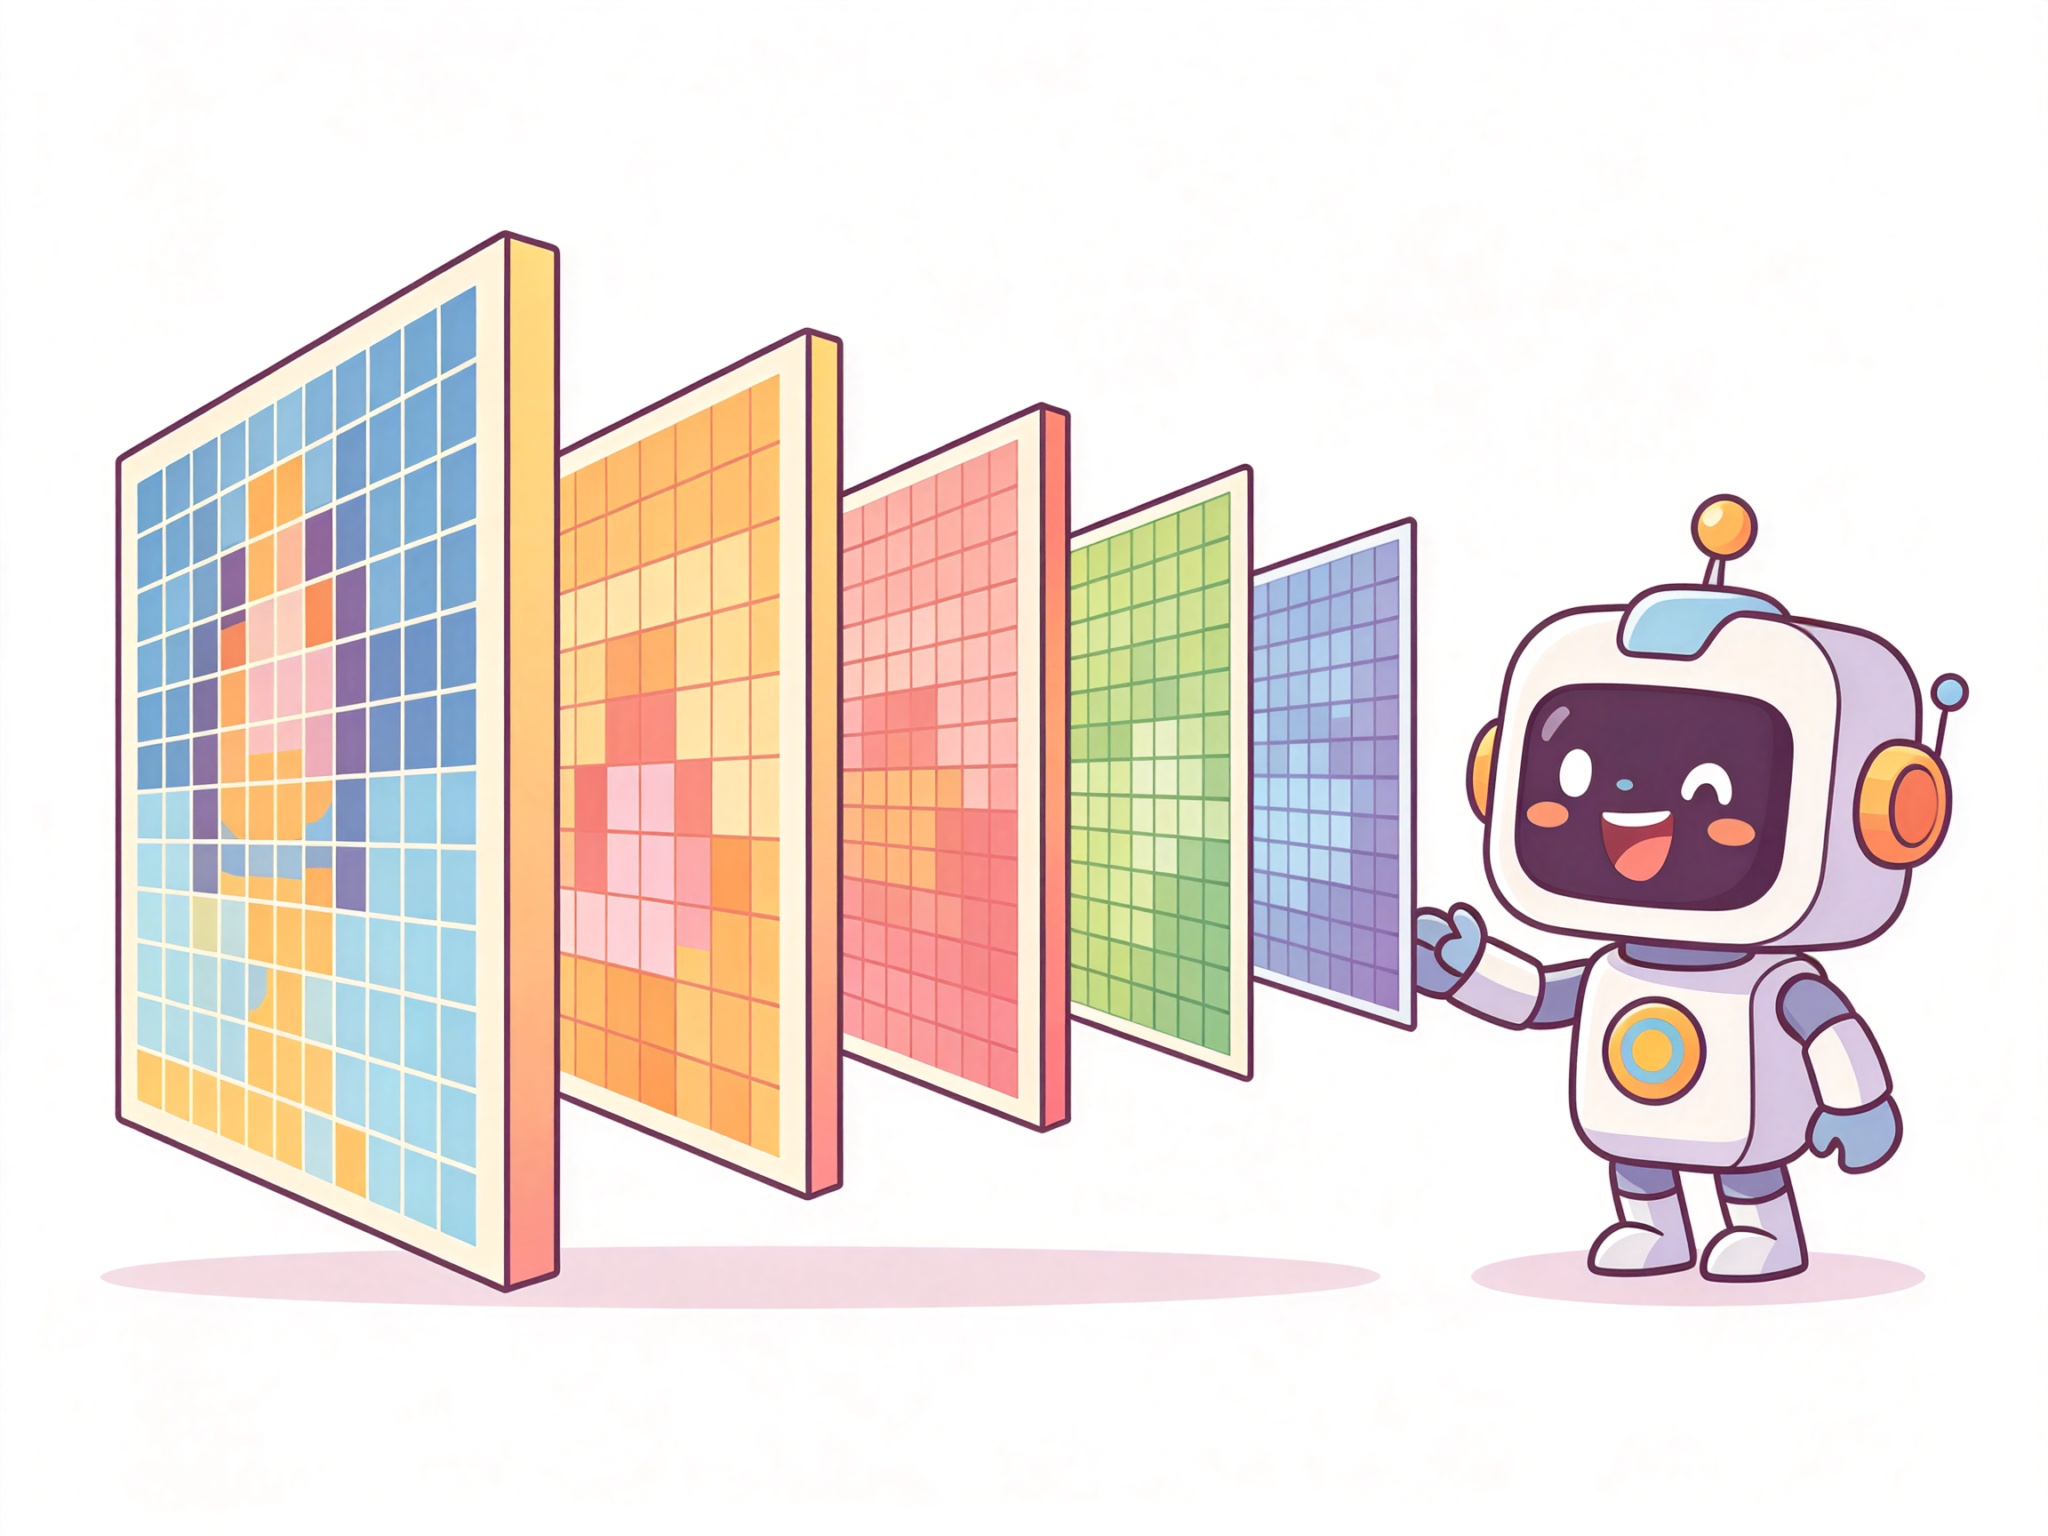
二维卷积是卷积网络中最常用的形式,主要用于处理图像数据。二维卷积的原理和一维卷积完全相同,只是卷积核从一维变成了二维。
二维卷积操作
对于二维输入 X ∈ R H × W X \in \mathbb{R}^{H \times W} X∈RH×W 和二维卷积核 W ∈ R k H × k W W \in \mathbb{R}^{kH \times kW} W∈RkH×kW,二维卷积的输出为:
Y i , j = ∑ m = 1 k H ∑ n = 1 k W W m , n ⋅ X i + m − 1 , j + n − 1 Y_{i,j} = \sum_{m=1}^{kH} \sum_{n=1}^{kW} W_{m,n} \cdot X_{i+m-1, j+n-1} Yi,j=m=1∑kHn=1∑kWWm,n⋅Xi+m−1,j+n−1
输出尺寸的计算公式和一维类似:
H o u t = ⌊ H + 2 P H − k H S H ⌋ + 1 , W o u t = ⌊ W + 2 P W − k W S W ⌋ + 1 H_{out} = \left\lfloor \frac{H + 2P_H - kH}{S_H} \right\rfloor + 1, \quad W_{out} = \left\lfloor \frac{W + 2P_W - kW}{S_W} \right\rfloor + 1 Hout=⌊SHH+2PH−kH⌋+1,Wout=⌊SWW+2PW−kW⌋+1
多通道卷积
实际的图像通常有多个通道(如RGB三通道)。对于多通道输入,卷积核也需要有相同数量的通道,每个通道独立做卷积,然后将所有通道的结果相加,得到一个单通道的输出特征图。
如果有 C i n C_{in} Cin 个输入通道和 C o u t C_{out} Cout 个输出通道(即 C o u t C_{out} Cout 个卷积核),那么卷积层的参数量为:
参数数量 = C o u t × ( C i n × k H × k W + 1 ) \text{参数数量} = C_{out} \times (C_{in} \times kH \times kW + 1) 参数数量=Cout×(Cin×kH×kW+1)
其中最后的 + 1 +1 +1 是偏置项。可以看到,参数量和输入图像的尺寸 H × W H \times W H×W 完全无关!这就是卷积网络能处理大尺寸图像的关键。
特征图的层次化抽象
卷积网络的一个神奇特性是层次化特征学习。浅层的卷积核学习简单的低级特征(如边缘、角点、颜色变化),中间层学习中级特征(如纹理、简单形状),深层学习高级特征(如物体部件、整个物体)。这种从低级到高级的层次化抽象,是卷积网络在视觉任务中成功的关键原因。
10.4 下采样和上采样
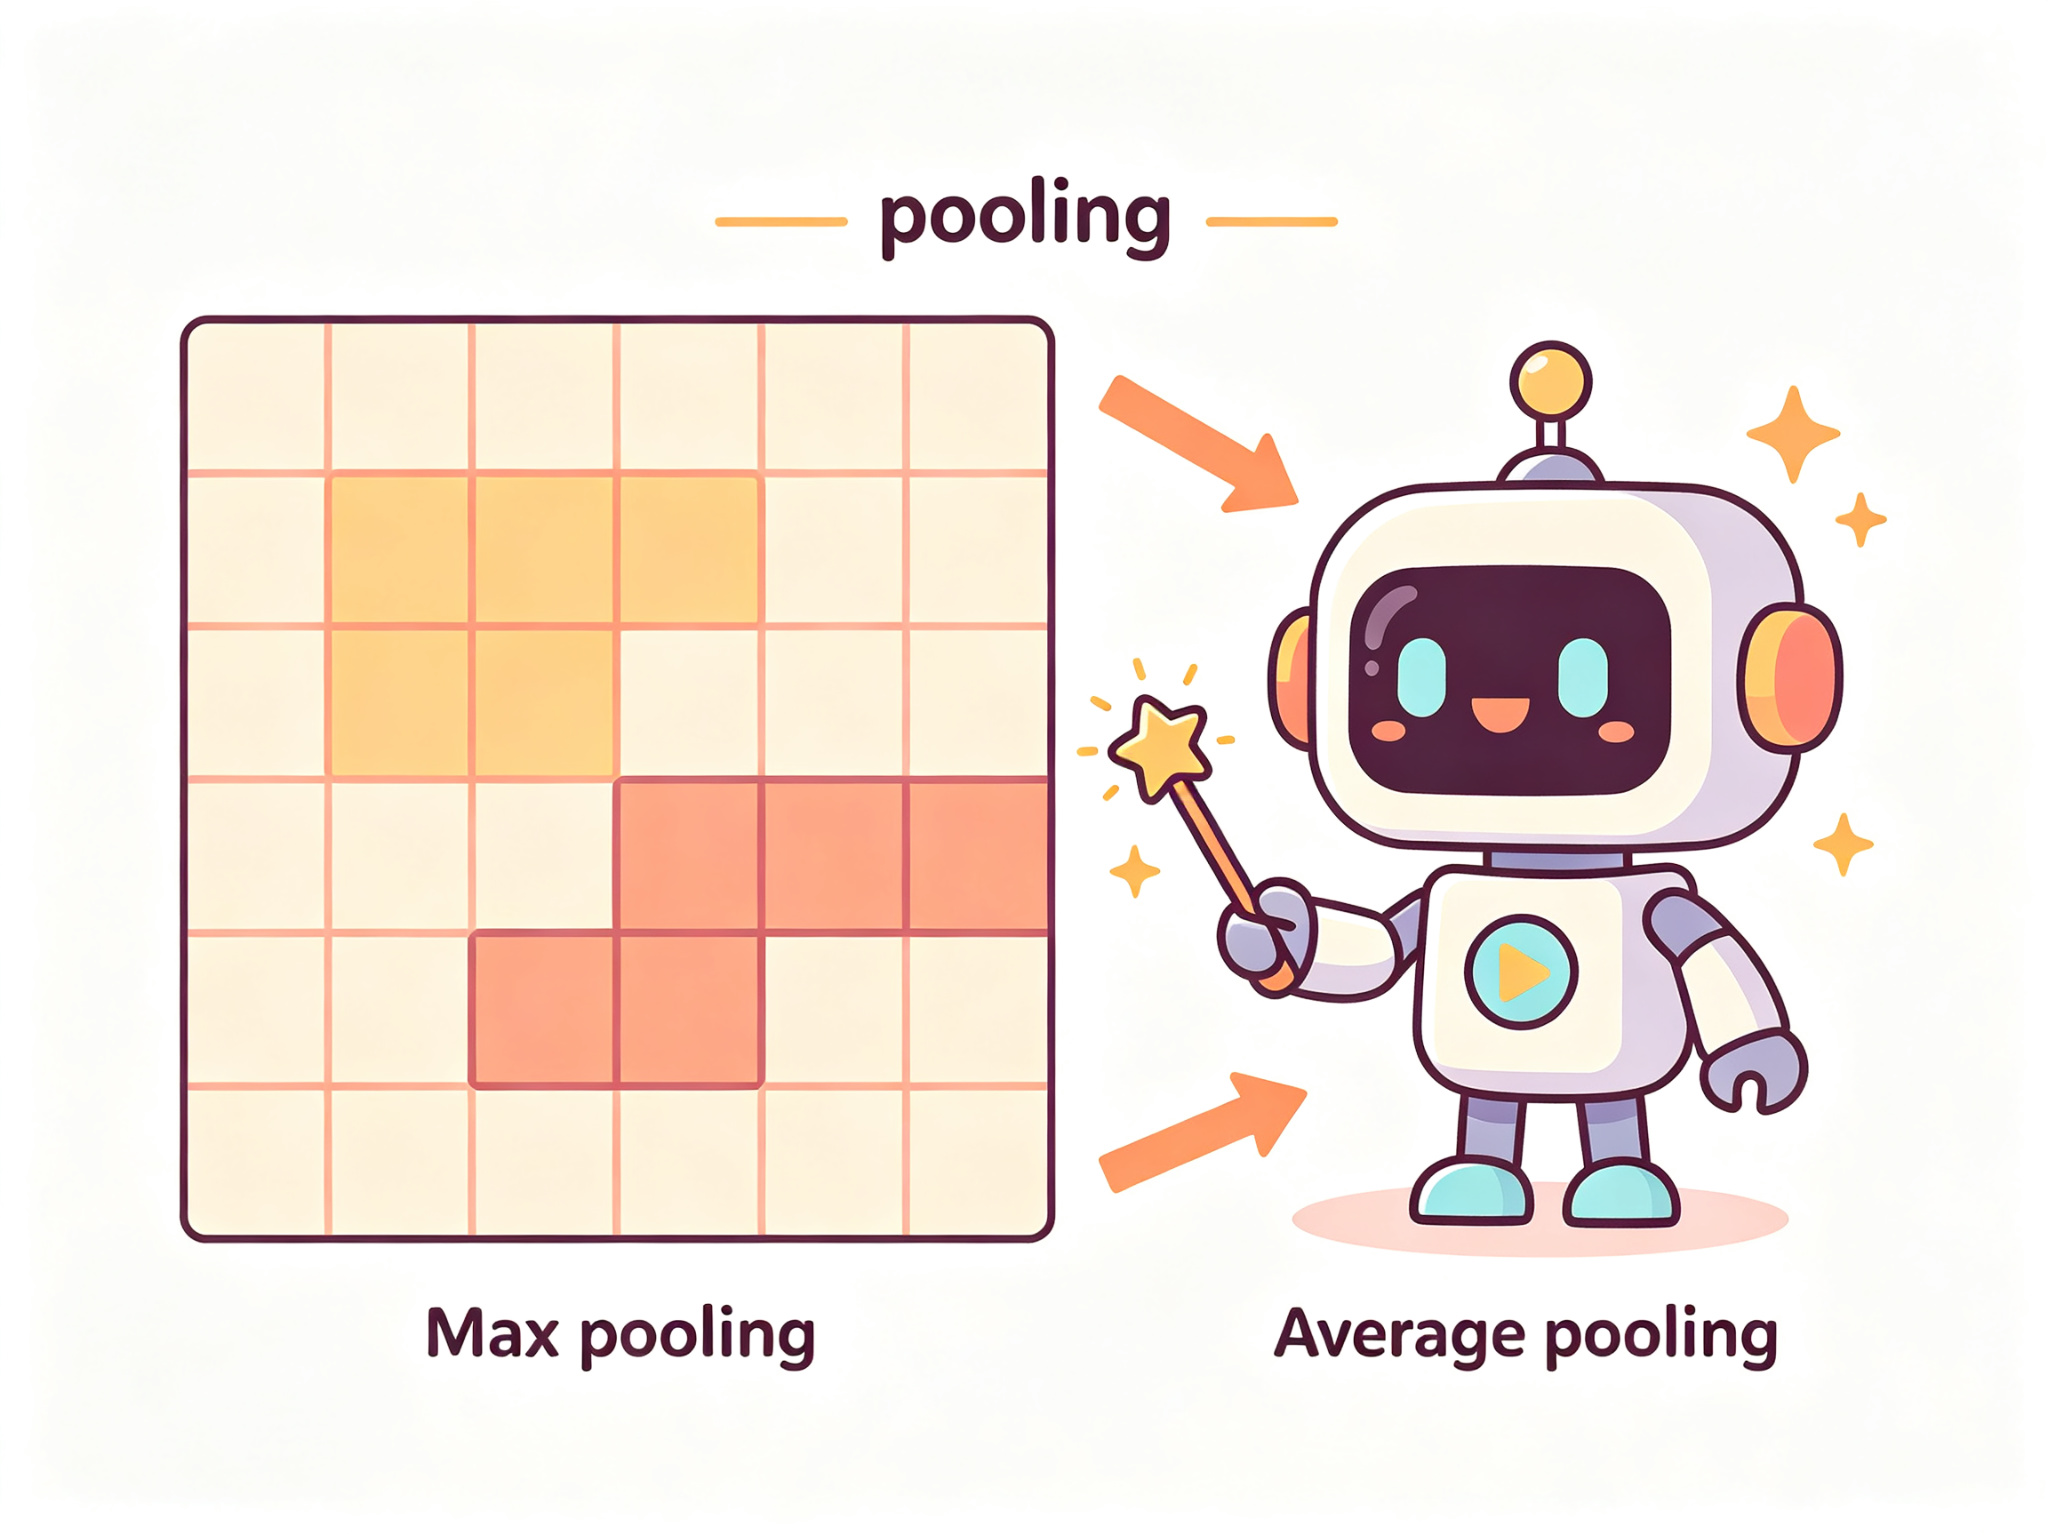
下采样:池化层
池化(Pooling) 是卷积网络中常用的下采样操作,它的作用是减小特征图的空间尺寸,从而:
- 减少参数量和计算量
- 扩大感受野(每个神经元能看到的输入区域)
- 提供一定程度的平移不变性
最常用的池化操作是最大池化(Max Pooling):在每个池化窗口中取最大值。例如2×2最大池化,就是把2×2的区域压缩成一个值(最大值),特征图尺寸减半。
另一种是平均池化(Average Pooling):取窗口内的平均值。平均池化更平滑,但会丢失显著特征的位置信息,因此最大池化更常用。
需要注意的是,池化层没有可学习的参数,它只是一个固定的下采样操作。近年来,也有一些网络用步长卷积(stride=2的卷积层)代替池化层来进行下采样,因为步长卷积有可学习的参数,可能更灵活。
上采样:转置卷积
在一些任务中(如图像分割、图像生成),我们需要将低分辨率的特征图恢复到高分辨率,这就需要上采样操作。
最简单的上采样方法是最近邻插值和双线性插值,这些是固定的插值方法,没有可学习参数。
更常用的是转置卷积(Transposed Convolution),也叫反卷积(Deconvolution,这个名字有误导性,它不是真正的反卷积)。转置卷积可以看作是卷积的"逆向"操作:它通过学习参数,将低分辨率特征图上采样到高分辨率。转置卷积在图像分割(如U-Net)和图像生成(如DCGAN)中广泛使用。
10.5 应用
卷积网络在计算机视觉领域有着极其广泛的应用,几乎所有视觉任务的SOTA(State-of-the-Art)方法都基于卷积网络(直到最近被Transformer挑战)。
图像分类
图像分类是卷积网络最经典的应用。从2012年AlexNet在ImageNet竞赛中一鸣惊人,到VGG、GoogLeNet、ResNet、DenseNet、EfficientNet等一系列经典架构,卷积网络不断刷新图像分类的准确率。现代卷积网络在ImageNet上的top-5准确率已经超过99%,超过了人类水平。
目标检测
目标检测需要在图像中找出所有物体的位置(边界框)和类别。经典方法包括两阶段的R-CNN系列(R-CNN、Fast R-CNN、Faster R-CNN、Mask R-CNN)和一阶段的YOLO系列、SSD等。目标检测在自动驾驶、安防监控、医学影像等领域有广泛应用。
图像分割
图像分割需要为图像中的每个像素分配类别标签。分为语义分割(不区分同一类别的不同实例)和实例分割(区分同一类别的不同实例)。经典方法包括FCN、U-Net(医学影像分割的标准架构)、DeepLab系列、Mask R-CNN等。
其他应用
- 人脸识别:FaceNet、ArcFace等基于卷积网络的方法
- 姿态估计:OpenPose、HRNet等
- 图像超分辨率:SRCNN、ESRGAN等
- 图像生成:DCGAN、StyleGAN等(卷积网络作为生成器和判别器)
- 视频理解:C3D、I3D等三维卷积网络
- 自然语言处理:TextCNN等一维卷积网络(在Transformer出现前常用)
10.6 本章小结
本章我们系统学习了卷积网络。核心要点如下:
-
卷积网络解决了全连接网络处理图像时参数量过大的问题:通过局部连接和权值共享,参数量从和输入尺寸成正比变为和输入尺寸无关。
-
不变性和等变性是卷积网络的核心设计理念:卷积操作提供平移等变性,池化操作逐步实现平移不变性。
-
一维卷积用于序列数据,二维卷积用于图像数据:原理完全相同,都是卷积核在输入上滑动,逐元素相乘再求和。
-
多通道卷积:卷积核的通道数和输入通道数相同,多个卷积核产生多个输出通道。参数量 = 输出通道数 × (输入通道数 × 卷积核高 × 卷积核宽 + 1)。
-
输出尺寸公式: H o u t = ⌊ ( H + 2 P − k H ) / S ⌋ + 1 H_{out} = \lfloor (H + 2P - kH) / S \rfloor + 1 Hout=⌊(H+2P−kH)/S⌋+1,这个公式非常重要,设计网络架构时经常用到。
-
池化层用于下采样:最大池化最常用,没有可学习参数。也可以用步长卷积代替池化。
-
转置卷积用于上采样:在图像分割和生成任务中广泛使用。
-
层次化特征学习:浅层学低级特征(边缘),中层学中级特征(纹理),深层学高级特征(物体),这是卷积网络成功的关键。
-
应用广泛:图像分类、目标检测、图像分割、人脸识别、姿态估计、超分辨率、图像生成等几乎所有视觉任务。
代码实验结果
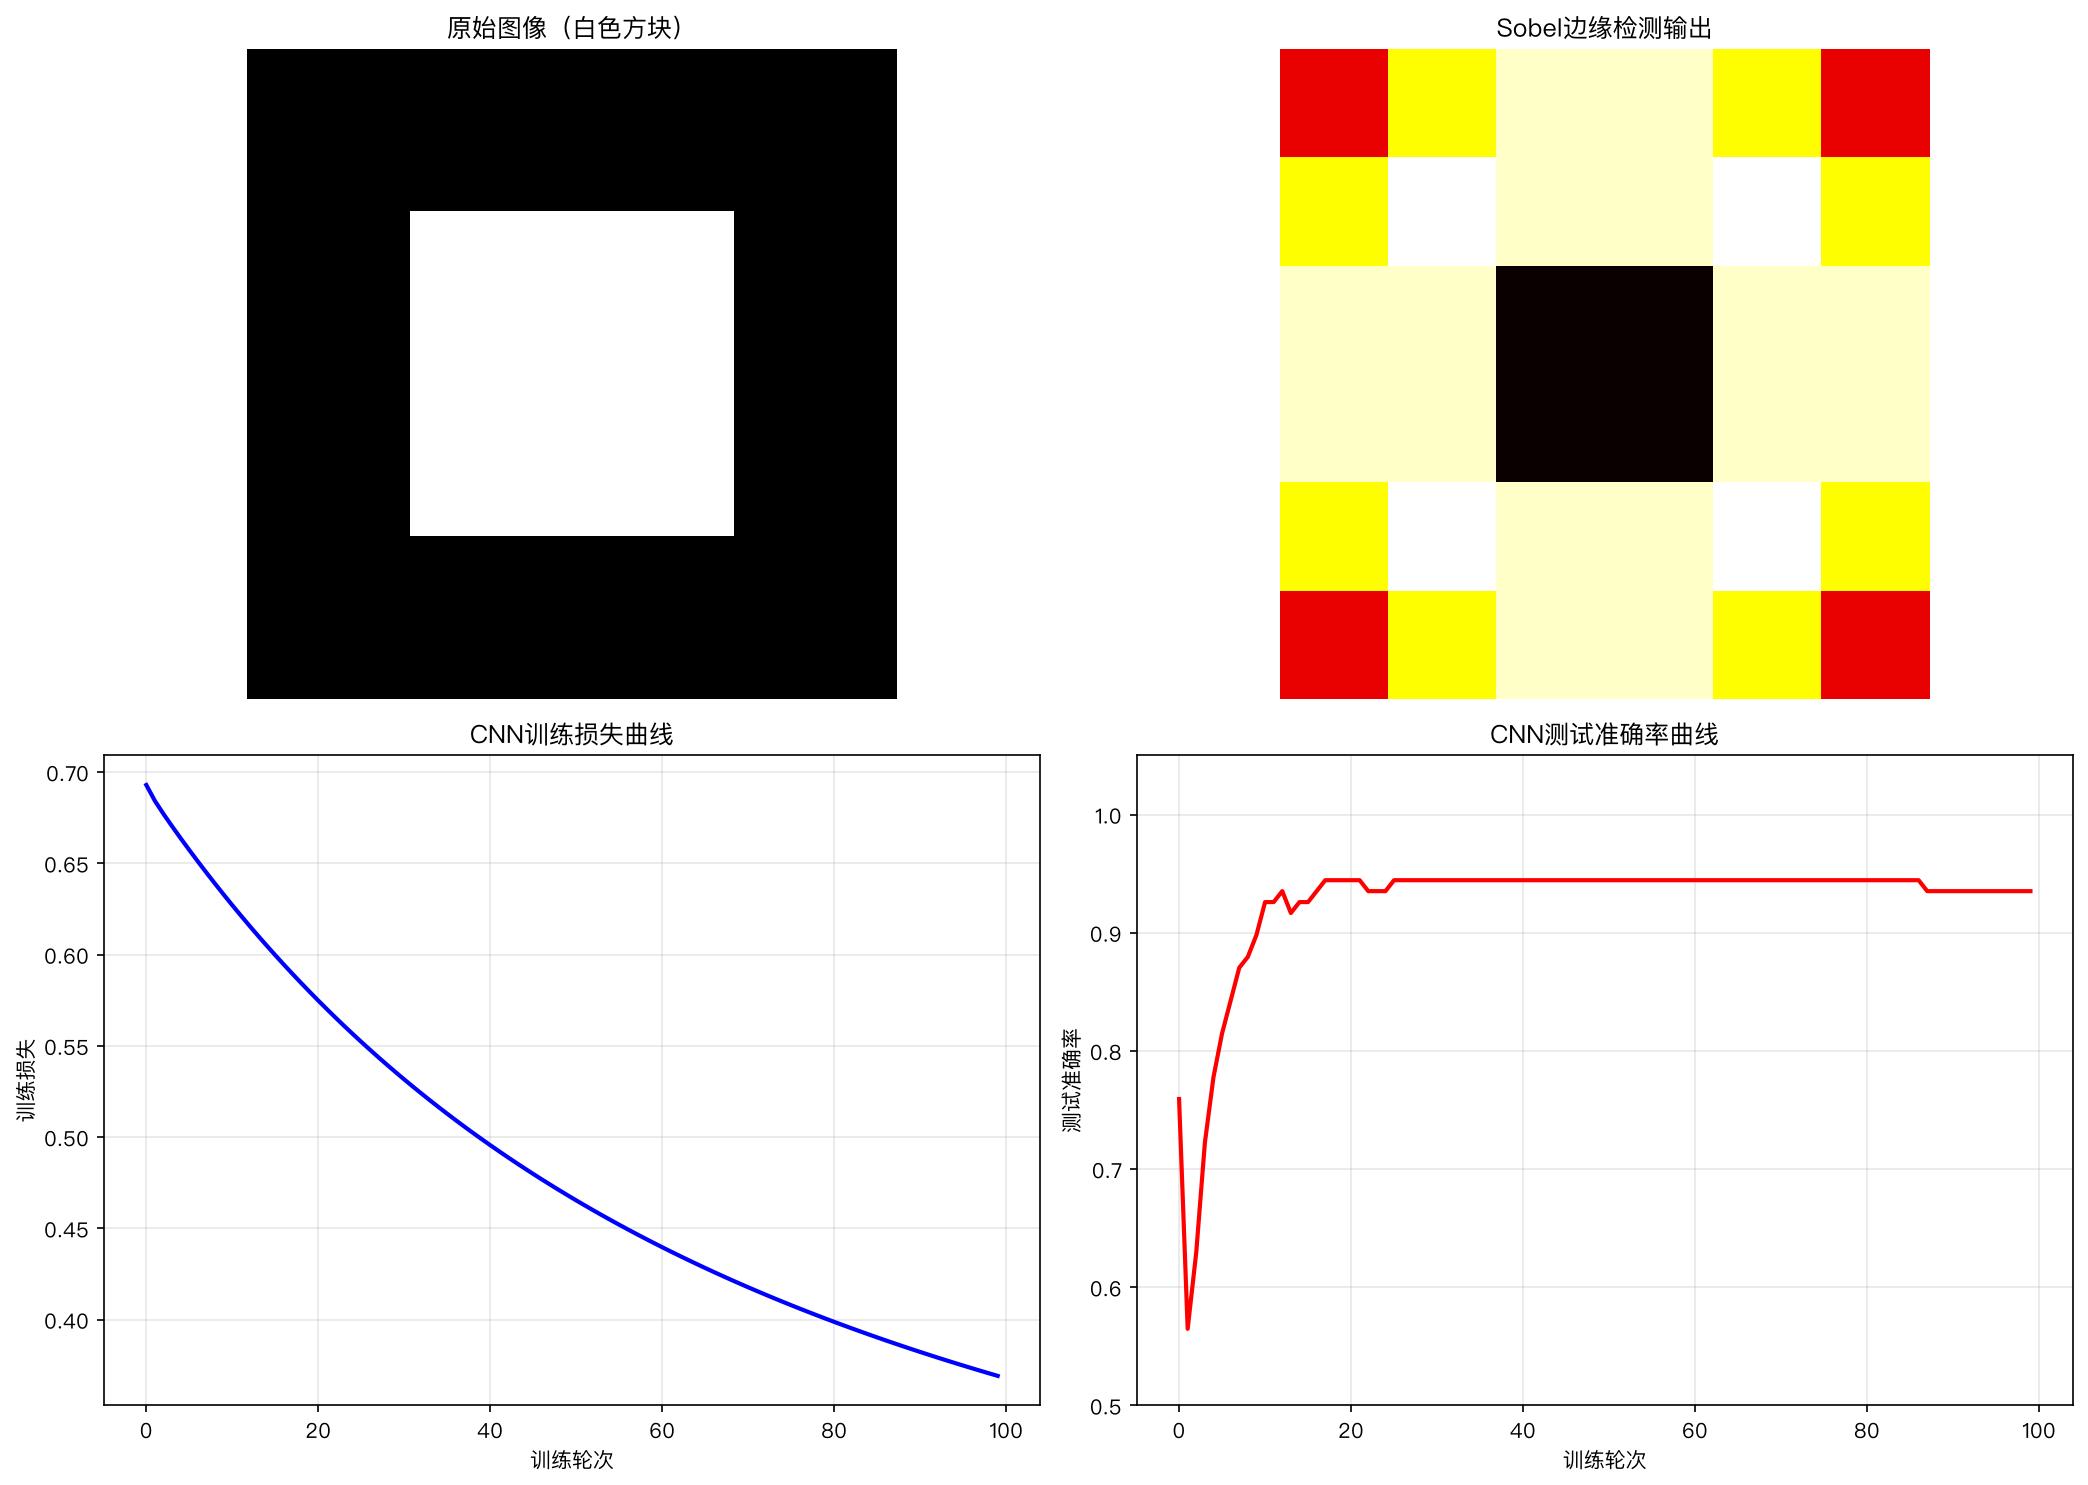
我们编写了完整的Python代码,从零实现了2D卷积层和最大池化层,并训练了一个简单的CNN在手写数字数据集上进行二分类。以下是真实运行结果。
实验1:从零实现2D卷积层
- 输入:8×8图像(中间一个4×4白色方块)
- 卷积核:3×3 Sobel边缘检测核
- 输出:6×6特征图
输入形状: (8, 8)
卷积核形状: (3, 3)
输出形状: (6, 6)
边缘检测输出最大值: 4.2426
实验2:从零实现最大池化层
- 输入:8×8图像
- 池化窗口:2×2,步长2
- 输出:4×4
输入形状: (8, 8)
池化后形状: (4, 4)
池化输出:
[[0. 0. 0. 0.]
 [0. 1. 1. 0.]
 [0. 1. 1. 0.]
 [0. 0. 0. 0.]]
实验3:简单CNN在digits数据集上训练
- 数据集:sklearn digits(8×8手写数字),二分类(0 vs 1)
- 训练集:252样本,测试集:108样本
- 网络结构:卷积(2个3×3核) → ReLU → 最大池化(2×2) → 全连接 → sigmoid
Epoch 20:  训练损失=0.5796, 测试准确率=0.9444
Epoch 40:  训练损失=0.4989, 测试准确率=0.9444
Epoch 60:  训练损失=0.4420, 测试准确率=0.9444
Epoch 80:  训练损失=0.4005, 测试准确率=0.9444
Epoch 100: 训练损失=0.3691, 测试准确率=0.9352

最终测试准确率: 0.9352
结果可视化
结果分析
-
卷积和池化从零实现验证通过:8×8输入经过3×3卷积(无padding、stride=1)得到6×6输出,符合公式 H o u t = ( 8 − 3 ) / 1 + 1 = 6 H_{out} = (8-3)/1 + 1 = 6 Hout=(8−3)/1+1=6。经过2×2最大池化(stride=2)得到4×4输出,符合公式 H o u t = ( 8 − 2 ) / 2 + 1 = 4 H_{out} = (8-2)/2 + 1 = 4 Hout=(8−2)/2+1=4。
-
Sobel边缘检测有效:Sobel核成功检测出了白色方块的边缘,输出最大值4.2426出现在方块边缘位置。这验证了卷积核可以提取特定的图像特征。
-
最大池化保留显著特征:池化输出中,白色方块区域的值为1,背景为0,最大池化成功保留了最显著的特征,同时将尺寸减半。
-
简单CNN达到93.5%准确率:只有2个卷积核、只训练全连接层(卷积核随机初始化不更新)的极简CNN,在8×8手写数字二分类任务上达到了93.5%的测试准确率。这说明卷积特征即使是随机初始化的,也包含了有用的信息。
-
训练损失持续下降但准确率波动:训练损失从0.58降到0.37,但测试准确率在94.4%附近波动,最后降到93.5%。这可能是因为只训练全连接层、卷积核固定,模型容量有限,且学习率可能偏大。如果端到端训练(包括卷积核),准确率应该会更高。
本章核心总结
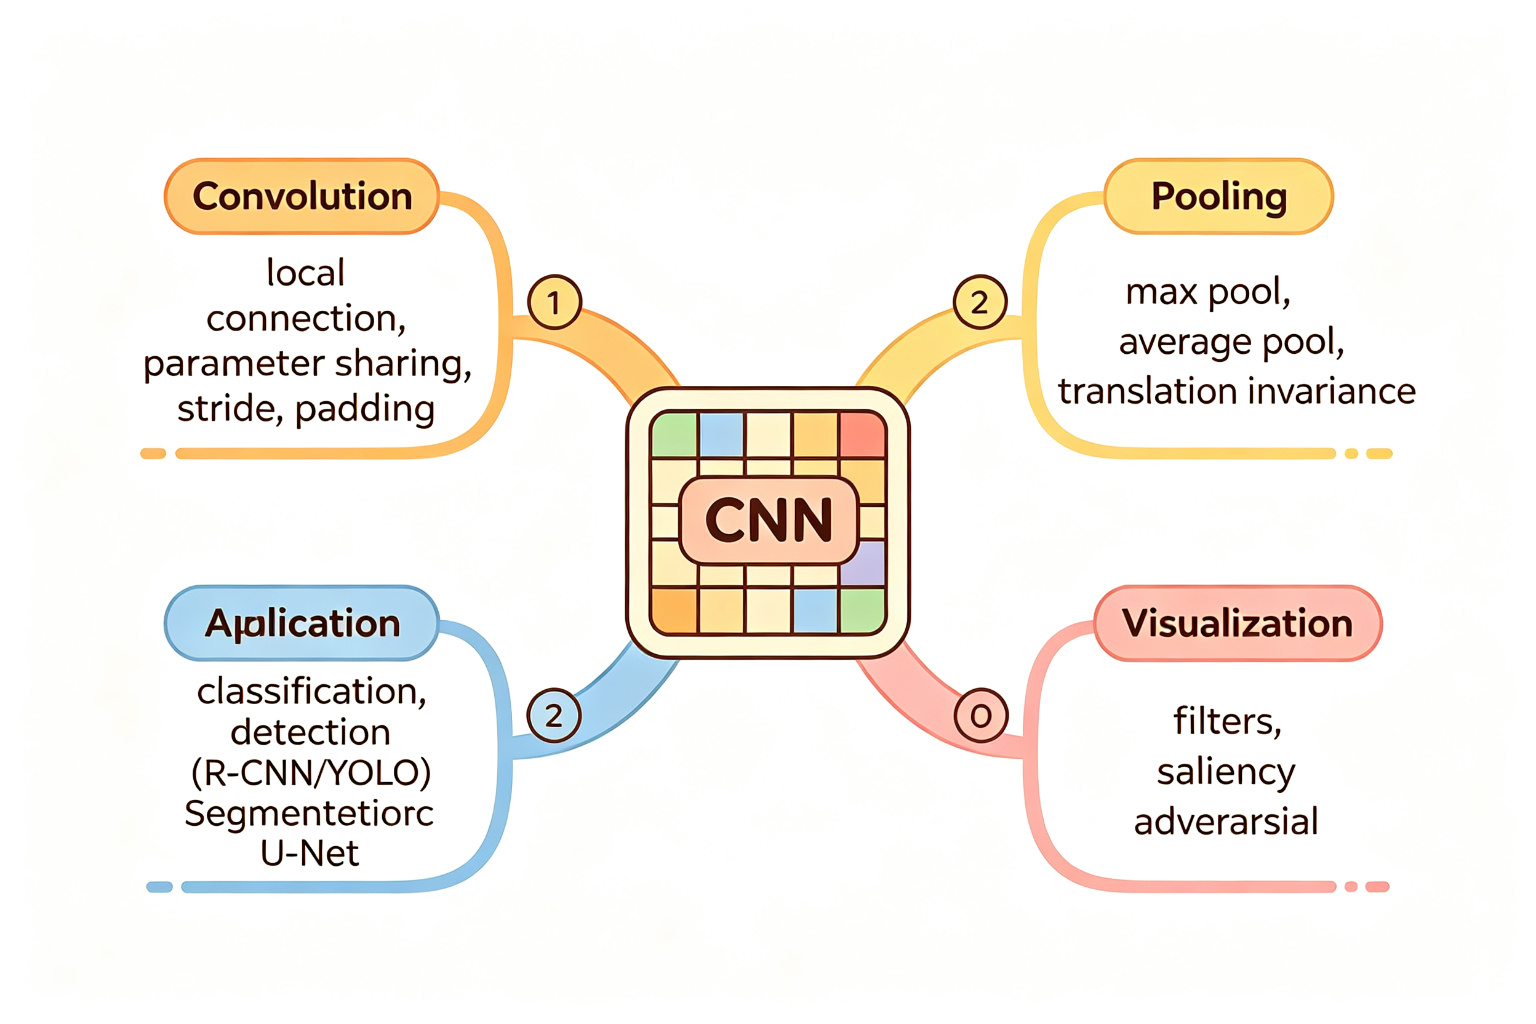
一句话概括:卷积网络通过局部连接和权值共享大幅减少参数量,利用卷积操作提取层次化特征,配合池化下采样,在计算机视觉任务中取得革命性成功。
卷积网络核心公式清单:
| 概念 | 公式 |
|---|---|
| 2D卷积输出 | Y i , j = ∑ m , n W m , n ⋅ X i + m − 1 , j + n − 1 Y_{i,j} = \sum_{m,n} W_{m,n} \cdot X_{i+m-1,j+n-1} Yi,j=∑m,nWm,n⋅Xi+m−1,j+n−1 |
| 输出尺寸 | H o u t = ⌊ ( H + 2 P − k H ) / S ⌋ + 1 H_{out} = \lfloor (H + 2P - kH) / S \rfloor + 1 Hout=⌊(H+2P−kH)/S⌋+1 |
| 参数量 | C o u t × ( C i n × k H × k W + 1 ) C_{out} \times (C_{in} \times kH \times kW + 1) Cout×(Cin×kH×kW+1) |
| 最大池化 | Y i , j = max m , n X i S + m , j S + n Y_{i,j} = \max_{m,n} X_{iS+m, jS+n} Yi,j=maxm,nXiS+m,jS+n |
结语
本章我们彻底搞懂了卷积网络。从不变性和等变性的设计理念,到一维和二维卷积的具体操作,再到池化下采样和转置卷积上采样,最后看了卷积网络在各个视觉任务中的广泛应用。卷积网络是深度学习在计算机视觉领域的基石,理解了它,你就掌握了视觉AI的核心。
卷积网络虽然强大,但也有一个问题:随着网络层数加深,训练变得越来越困难,容易出现梯度消失和性能退化。怎么解决这个问题?下一章的主题是残差网络(Residual Networks)——通过残差连接(跳跃连接),让训练上百层甚至上千层的深度网络成为可能,彻底改变了深度学习的发展轨迹。
下一章见!
更多推荐

 1
 0
- 0


 已为社区贡献43条内容

所有评论(0)