登录社区云,与社区用户共同成长
邀请您加入社区
本文详细指导在Windows环境下搭建深度学习推理环境,涵盖显卡驱动更新、CUDA/cuDNN安装、PyTorch部署及TensorRT配置。关键步骤包括:通过nvidia-smi确认驱动支持的CUDA版本,下载对应CUDAToolkit与cuDNN,使用pip安装匹配CUDA版本的PyTorch,解压TensorRT并将其库文件复制至CUDA路径,配置环境变量后验证nvcc与TensorRT版本
本文通过可复现的计时方法,验证PyTorch中pin_memory与non_blocking对数据传输效率的实际影响。指出GPU利用率低不一定是计算瓶颈,可能是CPU到GPU的数据搬运阻塞。强调需在固定配置下对比基线,结合CUDA Event精准计时与系统监控,避免盲目增加num_workers。实证表明,锁页内存与异步复制仅在合适条件下提升吞吐,优化应基于对照实验,而非参数堆叠。
本篇承接上篇 NLP 数据预处理内容,基于 PyTorch 实现双向多层 LSTM 的 TextRNN 微博情感四分类任务。完整拆解模型网络结构,讲解 Embedding、双向 LSTM、全连接层实现细节;同时剖析训练、验证、测试整套逻辑,包含交叉熵损失、Adam 优化器、梯度反向传播、早停策略、模型保存,使用 sklearn 完成准确率、精确率、召回率、F1 指标评估。结合主程序讲解设备适配、随
模型训练过程中,报错信息铺天盖地,初学者往往束手无策。其实,90%以上的报错都属于少数几类常见问题。本课将系统梳理PyTorch训练中最高频的报错类型,涵盖:维度不匹配(`mat1 and mat2 shapes cannot be multiplied`)、梯度报错(`element 0 of tensors does not require grad`)、显存溢出(`CUDA out of m
本文是微博四分类情感分析实战系列的第一篇——数据预处理。基于 TextRNN(双向LSTM) 模型,从零讲解 NLP 数据预处理全流程。内容涵盖:字符级词表构建(频次统计、低频过滤、<UNK>/<PAD> 特殊标记、pickle 持久化)、数据集加载与预处理(字符转 ID、Padding 截断、8:1:1 划分训练/验证/测试集),以及自定义 DatasetIterater 批量迭代器。词表最终大
PyTorch 是由 Meta 开发的主流深度学习框架,以其动态计算图、自动求导和丰富的生态著称。本文从张量概念入手,介绍如何创建张量(如 tensor、zeros、randn 等),并演示基本操作:加法、矩阵乘法、索引切片与形状变换。张量作为多维数组,支持 GPU 加速与自动求导,是构建神经网络的核心数据结构,适合快速上手深度学习开发。
深度学习模型的训练往往像在“黑盒”中摸索——代码跑起来了,Loss在下降,但模型到底学得怎么样?是否过拟合?参数分布是否合理?梯度是否消失或爆炸?这些问题的答案,都隐藏在训练过程中的海量数据里。本课将系统讲解PyTorch官方可视化工具TensorBoard的完整使用教程:从安装配置到核心API的实战演练,涵盖`add_scalar`记录损失/准确率曲线、`add_image`可视化输入图像和特征
过拟合是深度学习中最常见的陷阱——模型在训练集上表现完美,却在验证集上一败涂地。本课将系统讲解过拟合与欠拟合的判定方法,并提供一整套正则化武器库:Dropout(随机失活)及其变体、BatchNorm与LayerNorm的归一化原理与选型、权重正则化(L1/L2)的数学直觉与效果对比、早停(Early Stopping)的实现与注意事项、数据集扩充(数据增强进阶)、以及模型剪枝(Pruning)的
本文从零讲解词向量的训练与保存全流程。先用 Numpy 演示 .npy / .npz 的保存与读取,这是深度学习中间产物落盘的基本功;再对比 One-hot 编码与分布式词向量,说明为何需要 Word2Vec。随后基于 PyTorch 实现 CBOW 模型:用上下文词预测中心词,经 Embedding 查表、向量平均、全连接与 log_softmax 输出,用 NLLLoss 训练。最后提取 Em
本文基于PyTorch,使用预训练ResNet18模型实现食物分类任务,通过迁移学习技术显著提升小数据集下的分类性能。核心步骤包括:加载ImageNet预训练权重、冻结卷积层参数、替换全连接层为20类输出,并仅训练新层。结合数据增强与学习率调度,实现高效训练。该方法在参数量少、数据有限的情况下仍可获得高准确率,充分体现了迁移学习在图像分类中的优势。
在自然语言处理(NLP)任务中,文字无法直接被计算机识别与运算,词向量(Word Embedding)是连接自然语言与深度学习模型的核心桥梁。CBOW(连续词袋模型)和Skip-Gram模型。通过某个单词的上下文词汇,预测当前中心单词,在训练过程中不断迭代更新权重,最终学习到每一个单词的高维语义向量。本文实现了极简版CBOW词向量训练模型,完整复现了Word2Vec的核心逻辑,帮助理解词嵌入的训练
隐变量模型(Latent Variable Model)假设观测数据xxx是由一些未观测到的隐变量zzz生成的。隐变量代表数据中未直接观测但对生成数据有影响的因素。观测数据xxx:像素值隐变量zzz:可能包括身份、表情、姿态、光照、年龄、性别等从先验分布pzp(z)pz中采样隐变量zzz从条件分布px∣zp(x|z)px∣z中采样观测数据xxxpx∫px∣zpzdzpx∫px∣zpzdz。
摘要(≤150字): 标准化流通过可逆变换将简单分布(如标准正态)逐步转化为复杂数据分布,利用变量替换公式精确计算似然,实现稳定的最大似然训练。核心在于设计可逆且雅可比行列式易计算的网络层,如加性与仿射耦合层。通过堆叠多层变换,模型具备强大表达能力,广泛应用于生成建模、密度估计与图像生成,兼具训练稳定性与可解释性。
优化器(Optimizer)是深度学习训练的核心引擎,它根据反向传播计算出的梯度来更新模型的参数,从而最小化损失函数。本课将深入讲解梯度下降的数学原理,从最朴素的SGD开始,剖析动量(Momentum)如何加速收敛并冲出局部极小点,进而介绍自适应学习率优化器(AdaGrad、RMSprop、Adam、AdamW)的演进逻辑和核心机制。通过PyTorch代码实战,你将学会为不同任务(CV、NLP、生
本章系统讲解生成式对抗网络(GAN)的核心思想与关键技术。通过“判别作为信号”的对抗机制,生成器与判别器在极小极大博弈中协同优化,实现高质量数据生成。针对训练不稳定性问题,引入WGAN、WGAN-GP、谱归一化等方法提升收敛性。通过渐进式增长、自注意力机制与大规模模型设计(如ProGAN、SAGAN、BigGAN),显著提升图像生成质量。条件GAN则拓展了生成能力,支持基于标签或文本的可控生成。尽
图(Graph)由**节点(Node/Vertex)和边(Edge)**组成,记为GVEG = (V, E)GVE,其中VVV是节点集合,EEE是边集合。每条边连接两个节点,表示它们之间存在某种关系。无向图(Undirected Graph):边没有方向,节点A和B之间的边表示双向关系。如社交网络中的好友关系。有向图(Directed Graph):边有方向,从A指向B的边不一定有从B指向A的边。
本章系统讲解变换器(Transformer)架构,核心为自注意力机制与位置编码,突破RNN序列依赖限制,实现并行计算。通过多头注意力捕捉长距离依赖,结合残差连接与层归一化提升训练稳定性。模型分为编码器-解码器结构,广泛应用于BERT(编码器)、GPT(解码器)及机器翻译等任务,并拓展至图像、语音等领域,成为现代AI的基石。
一句话概括:残差网络通过跳跃连接让网络学习残差而非直接学习目标,解决了深层网络的梯度消失和退化问题,使训练上百层网络成为可能,是深度学习发展史上的里程碑。残差网络核心公式清单概念公式残差块输出yσFxxyσFxx主路径变换FxW2⋅σW1xb1b2FxW2⋅σW1xb1b2维度不匹配时yσFxWsxyσFxWsxBN归一化xx−μBσB2ϵxx−μBσ。
一句话概括:卷积网络通过局部连接和权值共享大幅减少参数量,利用卷积操作提取层次化特征,配合池化下采样,在计算机视觉任务中取得革命性成功。卷积网络核心公式清单概念公式2D卷积输出Yij∑mnWmn⋅Xim−1jn−1Yij∑mnWmn⋅Xim−1jn−1输出尺寸Hout⌊H2P−kHS⌋1Hout⌊(H2P−kHS⌋1参数量Cout×Cin×。
本章系统阐述深度学习模型性能评估的核心方法。通过偏差-方差权衡理论,揭示误差来源:偏差反映模型拟合能力,方差体现对数据的敏感性。结合学习曲线诊断欠拟合与过拟合,提出降低误差的策略——增大数据或正则化降方差,提升模型复杂度降偏差。介绍训练/验证/测试集划分及K折交叉验证,实现超参数高效调优。强调评估指标需匹配任务需求,最终目标是在偏差与方差间找到平衡,实现最优泛化性能。
对图像的不同窗口数据和卷积核做内积(逐个元素相乘再求和)的操作,就是所谓的“卷积”操作,这也是卷积神经网络名字的来源。卷积核是一组固定的权重,因为每个神经元的多个权重固定,所以又可以看作一个恒定的滤波器filter。卷积操作可以帮助计算机提取图像中的局部特征,例如边缘、纹理和轮廓。与人眼观看事物相似,卷积神经网络会先关注图片的轮廓和低级特征,再逐层组合成高级语义特征。return x:当某个指标不
损失函数衡量模型预测与真实标签之间的差距,是深度学习的“导航仪”——它告诉模型应该往哪个方向调整。本课将系统讲解回归任务中的MSE、L1、SmoothL1损失,分类任务中的交叉熵、NLLLoss、BCE损失,以及多标签分类、排序损失等特殊场景。通过PyTorch代码实战,你将学会如何为不同任务选择合适的损失函数,如何处理类别不平衡、标签平滑等实际问题。同时讲解自定义损失函数的编写方法(使用`nn.
本文基于 PyTorch 完成一个完整的 20 类食物图像分类实战项目,涵盖自定义 CNN 搭建与训练、学习率调度器(ReduceLROnPlateau / StepLR)调优、ResNet18 迁移学习微调、以及最优模型权重加载推理的全流程。从卷积尺寸计算、自定义 Dataset、数据增强与 ImageNet 归一化等核心知识出发,配套完整可运行代码与常见问题排查指南,帮助深度学习初学者快速打通
本章系统讲解深度学习中的梯度计算与参数初始化。核心内容包括:基于链式法则的反向传播算法,通过计算图实现从输出层逐层回传梯度;推导了误差项传播公式及参数梯度计算方法;并通过代码实验对比不同初始化方式(如Xavier、He)对训练效果的影响。强调合理初始化可避免梯度消失或爆炸,提升收敛速度。反向传播是深度学习优化的基础,其高效性使大规模网络训练成为可能。
本章系统讲解深度学习模型训练的核心算法。从基础的梯度下降法出发,介绍随机梯度下降(SGD)及其小批量变体,提升计算效率并增强跳出局部最优的能力。引入动量机制,通过积累历史梯度方向加速收敛、减少震荡。重点阐述Adam优化器——结合动量与自适应学习率,实现高效稳定的参数更新。最后探讨学习率、批量大小等超参数的选择策略,并通过实验对比不同优化器的收敛性能,揭示其在实际训练中的应用价值。
数据是深度学习的燃料,高效的数据加载与预处理是训练稳定模型的前提。本课将系统讲解PyTorch的数据加载机制:从理解`Dataset`和`DataLoader`的核心概念开始,学习调用内置经典数据集(MNIST、CIFAR-10等),再到构建自定义数据集处理自己的图片、CSV文件。深入掌握批量读取、数据打乱、多线程加速等关键技巧,并完成数据的归一化、标准化以及基础图像增强(旋转、裁剪、翻转)。最后
深度学习的核心是反向传播算法,而PyTorch的Autograd模块让梯度计算变得自动化、透明化。本课将深入浅出地讲解Autograd的工作原理:从标量到张量的自动求导、`requires_grad`标志的作用、`backward()`如何积累梯度、梯度清零的必要性、梯度截断与禁用的实用技巧、自定义梯度运算(`register_hook`)、inplace操作的风险、以及多层网络中的梯度传递实战。
深度学习作为人工智能的核心技术之一,依赖于神经网络模型对复杂数据进行表征学习。掌握其前置知识需要理解线性代数、概率统计和微积分等数学基础,同时熟悉Python编程及常见库(如NumPy)的使用。PyTorch作为当前主流的深度学习框架,以其动态计算图和易用性受到广泛青睐。PyTorch的核心组件包括张量(Tensor)、自动微分(Autograd)和神经网络模块(nn.Module),能够高效支持
Celery、scikit-learn与PyTorch是现代机器学习与工程系统中的核心工具:Celery实现异步任务调度,剥离耗时操作(如发邮件、模型推理);sklearn提供统一接口的传统机器学习算法,适用于中小规模数据建模;PyTorch则聚焦深度学习,支持动态计算图与自动求导,广泛用于图像、NLP及大模型训练。三者常协同使用——通过Celery异步调度sklearn或PyTorch的推理任务
本章作为深度学习“工具箱”,系统讲解PyTorch基础操作:张量创建与运算、广播机制、索引切片、内存优化及类型转换。结合数据预处理流程,演示如何用pandas读取、清洗含缺失值的CSV数据,通过均值填充与one-hot编码处理,并最终转化为张量。强调基础操作的重要性——80%的深度学习问题源于张量维度、索引或梯度管理失误,建议动手实践以夯实编程根基。
在过去几年里 AI 行业最吸引注意力的是模型本身,从参数量从几十亿一路做到几千亿模型能力在不断的提升。但在未来几年里真正产生大量机会的地方,很可能会是逐渐向模型下面转移。推理的引擎、异构计算、云原生调度、Agent Runtime、可观测性、模型服务以及算力抽象层的重要性。这次 PyTorch 的变化其实只是这个趋势的一部分。它正在从一个“深度学习框架”逐步演变成开源 AI 技术栈中起到核心承上启
针对本地食物图像数据集的图像分类任务,本文基于 PyTorch 框架实现一套完整的深度学习训练流程。首先通过脚本遍历文件夹生成图片路径‑标签 txt 索引文件,解决本地分类数据集无法直接被 PyTorch 读取的问题;其次讲解`Dataset`中`__getitem__`、`__len__`魔法方法底层原理,自定义食物数据集类完成图片读取、预处理与标签转换,借助`DataLoader`实现样本批量
本文基于 PyTorch 搭建小型 CNN 卷积神经网络,完成 20 类食物图像分类任务。内容涵盖数据准备(自定义 Dataset 与 DataLoader)、图像预处理与数据增强(Resize、Normalize、随机旋转翻转等)、CNN 模型结构设计与参数详解、训练循环(前向传播→损失计算→反向传播→参数更新)、模型保存与单张图片预测,完整呈现深度学习项目从搭建到应用的全流程,适合 PyTor
本文针对深度学习中大批次训练导致显存溢出、小批次又引发训练不稳的矛盾,基于PyTorch实现一套可复用的训练流程。通过梯度累积模拟有效大批次,结合损失缩放、梯度裁剪、混合精度与正确调度器对齐,有效平衡显存占用与模型收敛性。强调关键细节:损失除以累积步数、更新时解缩放后裁剪、调度器按更新步数调整,并提供常见问题排查方案。适用于单卡验证与算力平台扩展,提升训练稳定性与资源利用率。
本文将厘清 Eager Mode、FX Mode、JIT (TorchScript)、PT2E 以及 NVIDIA ModelOpt 等核心概念的关系,帮助开发者梳理现代深度学习部署的技术选型路线。
在Pytorch中,数据转换(Data Transformation)是一种在加载的样本数据时对数据预处理的机制,将原始数据转换为合适模型训练的格式主要通过torchvision.transforms提供的工具完成。数据转换不仅可以实现基本的数据预处理(如归一化,大小调整等),还能帮助进行数据增强(如随机裁剪、翻转等),提高模型的泛化能力。其作用如下:数据预处理: 将原始图片(PIL Imag
摘要:本文探讨了MoE(混合专家)架构在大模型发展中的关键作用,重点分析了SwitchTransformer论文的创新点。该论文通过简化MoE路由机制,提出仅激活单个专家的top-1路由策略,在保持计算量不变的前提下显著提升了模型性能。实验表明,SwitchTransformer在相同计算资源下可获得7倍预训练加速,并首次实现了万亿参数模型的稳定训练。同时,文章还讨论了DeepSeek最新提出的E
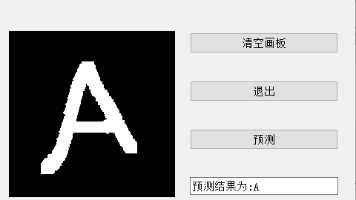
PyTorch框架——基于深度学习神经网络手写字母识别系统源码(带界面和手写画板)