
第十四章 情感分析
第十四章 情感分析
目录
摘要:本章系统讲解情感分析(Sentiment Analysis)的核心技术。首先通过情感词典、朴素贝叶斯与大模型零样本三种方法的对比演示建立直观认知;随后介绍概念、技术难点与基础理论,并深入剖析词典规则、传统机器学习、深度学习与大模型四类主流方法的原理与选型。工具应用部分涵盖 SnowNLP、sklearn 与 Transformers 的实战;最后通过电商评论情感分析系统案例,完整演示从数据预处理、模型训练到结果可视化的工程落地流程,并展望多模态、细粒度与零样本等发展趋势。
前置案例——情感分析的三种方法
为了建立对情感分析的直观认知,我们先通过三种不同技术路线的快速演示,感受从简单到复杂的分析效果差异,再进入系统的理论与方法讲解。
1. 基于情感词典的方法
概念说明
情感词典法是最直观的情感分析方法。它的思路很简单:准备一个词典,标注每个词是褒义词(正面)还是贬义词(负面),然后统计文本中褒义词和贬义词的数量,哪边多就判定为哪种情感。比如"这个产品很好用,质量不错"中"很好""不错"都是褒义词,所以判定为正面。
特点:实现简单、可解释性强、无需训练数据;但无法理解上下文和反讽,对网络新词和复杂句式效果差。
代码演示讲解
# 简单的情感词典
positive_words = ["好", "不错", "喜欢", "满意", "棒", "优秀", "推荐", "开心", "惊喜", "值得"]
negative_words = ["差", "烂", "糟糕", "失望", "垃圾", "难用", "退货", "生气", "骗", "后悔"]

def analyze_sentiment(text):
    pos_count = sum(1 for w in positive_words if w in text)
    neg_count = sum(1 for w in negative_words if w in text)

    if pos_count > neg_count:
        return "正面", pos_count, neg_count
    elif neg_count > pos_count:
        return "负面", pos_count, neg_count
    else:
        return "中性", pos_count, neg_count

# 测试
texts = [
    "这个手机真好用,拍照效果很棒,非常满意!",
    "质量太差了,用了两天就坏了,很失望,准备退货。",
    "这个产品一般般,没什么特别的。"
]

for t in texts:
    sentiment, pos, neg = analyze_sentiment(t)
    print(f"文本:{t}")
    print(f"情感:{sentiment}(褒义词{pos}个,贬义词{neg}个)")
    print()
运行输出:
文本:这个手机真好用,拍照效果很棒,非常满意!
情感:正面(褒义词3个,贬义词0个)文本:质量太差了,用了两天就坏了,很失望,准备退货。
情感:负面(褒义词0个,贬义词3个)文本:这个产品一般般,没什么特别的。
情感:中性(褒义词0个,贬义词0个)
构建词典:人工收集或使用公开的情感词典,将词语按褒贬分类。词典的覆盖度直接影响分析效果。
匹配统计:遍历文本,统计其中包含多少个褒义词和贬义词。这是最简单的"投票"机制。
判定结果:比较褒贬数量,多的一方决定情感倾向。这种方法的局限是不考虑词的强度和上下文。
2. 基于机器学习的方法(朴素贝叶斯)
概念说明
朴素贝叶斯是经典的文本分类算法,也广泛用于情感分析。它基于贝叶斯定理,通过学习标注数据中"某个词出现在正面/负面评论中的概率",来预测新文本的情感类别。与词典法不同,朴素贝叶斯能自动从数据中学习哪些词更能代表正面或负面情感,不需要人工标注每个词。
特点:训练简单、速度快、效果稳定;但假设词与词之间相互独立("朴素"的由来),无法捕捉词序和上下文关系。
代码演示讲解
from sklearn.feature_extraction.text import CountVectorizer
from sklearn.naive_bayes import MultinomialNB
import jieba

# 训练数据:已标注的评论
train_texts = [
    "这个产品质量很好,非常满意",
    "物流很快,包装精美,值得购买",
    "客服态度很好,问题都解决了",
    "用了几天感觉不错,推荐给大家",
    "性价比很高,下次还会买,很喜欢",
    "质量太差了,用一次就坏了",
    "发货太慢了,等了一周才到",
    "客服态度恶劣,非常失望",
    "实物和图片不符,被骗了",
    "完全不值这个价,后悔买了"
]
train_labels = [1, 1, 1, 1, 1, 0, 0, 0, 0, 0]  # 1=正面,0=负面

# 中文分词处理
def tokenize(text):
    return " ".join(jieba.cut(text))

train_texts_cut = [tokenize(t) for t in train_texts]

# 向量化:将文本转换为词频向量
vectorizer = CountVectorizer()
X_train = vectorizer.fit_transform(train_texts_cut)

# 训练朴素贝叶斯分类器
clf = MultinomialNB()
clf.fit(X_train, train_labels)

# 测试新文本
test_texts = [
    "这个东西真不错,很喜欢",
    "太垃圾了,再也不买了",
    "还可以吧,没什么感觉"
]

for t in test_texts:
    X_test = vectorizer.transform([tokenize(t)])
    pred = clf.predict(X_test)[0]
    prob = clf.predict_proba(X_test)[0]
    label = "正面" if pred == 1 else "负面"
    print(f"文本:{t}")
    print(f"预测:{label}(正面概率:{prob[1]:.2f},负面概率:{prob[0]:.2f})")
    print()
运行输出:
文本:这个东西真不错,很喜欢预测:正面(正面概率:0.62,负面概率:0.38)
文本:太垃圾了,再也不买了
预测:负面(正面概率:0.50,负面概率:0.50)
文本:还可以吧,没什么感觉
预测:正面(正面概率:0.64,负面概率:0.36)
数据标注:需要一批已经标注好情感类别的文本作为训练数据。标注质量直接决定模型效果。
文本向量化:CountVectorizer将每篇文本转换为词频向量,每个维度对应一个词,值为该词出现的次数。
模型训练:朴素贝叶斯学习每个词在正面/负面类别中出现的条件概率,预测时用贝叶斯公式计算后验概率。
3. 基于大模型的零样本情感分类
概念说明
大语言模型具有强大的语义理解能力,可以在没有任何标注训练数据的情况下(零样本)完成情感分析。只需用自然语言告诉模型"请判断以下文本的情感倾向",模型就能准确识别。这种方式不需要训练模型,也不需要构建特征,是目前最便捷的情感分析方案。
特点:零训练成本、理解能力强、支持复杂语义和反讽;适合快速验证和小批量场景;高并发场景下API成本较高。
代码演示讲解
from openai import OpenAI

client = OpenAI(
    api_key="你的api密码",
    base_url="https://open.bigmodel.cn/api/paas/v4"
)

def sentiment_analysis_llm(text):
    prompt = f"""请判断以下文本的情感倾向,严格输出JSON格式。
文本:{text}
要求:输出{{"sentiment": "正面/负面/中性", "confidence": 0-1之间的小数, "reason": "简短判断理由"}}"""

    response = client.chat.completions.create(
        model="glm-4-flash",
        messages=[{"role": "user", "content": prompt}],
        temperature=0
    )
    return response.choices[0].message.content

# 测试包含反讽的复杂文本
texts = [
    "这手机质量真好,用了三天就开不了机了。",
    "客服小姐姐超级耐心,帮我解决了大问题,点赞!",
    "东西收到了,包装完好,还没用。"
]

for t in texts:
    print(f"文本:{t}")
    print(f"分析:{sentiment_analysis_llm(t)}")
    print()
运行输出:
文本:这手机质量真好,用了三天就开不了机了。分析:```json
{
“sentiment”: “负面”,
“confidence”: 0.8,
“reason”:
“虽然开头提到手机质量好,但随后提到用了三天就开不了机,表明了使用体验的负面问题。”}
文本:客服小姐姐超级耐心,帮我解决了大问题,点赞!
分析:```json
{
“sentiment”: “正面”,
“confidence”: 0.95,
“reason”:
“文本中提到‘超级耐心’和‘解决了大问题’,以及‘点赞’表明用户对客服服务非常满意,情感倾向明显为正面。”}
文本:东西收到了,包装完好,还没用。
分析:```json
{
“sentiment”: “正面”,
“confidence”: 0.8,
“reason”:
“文本中提到‘东西收到了,包装完好’,表明用户对收到的物品满意,且没有负面情绪的表述。”}
零样本能力:大模型在预训练阶段已经学习了海量文本中的情感表达模式,无需额外训练就能完成情感分类。
反讽识别:大模型能理解上下文语义,识别"质量真好,三天就坏了"这类反讽表达,这是词典法和传统机器学习难以做到的。
可解释性:让模型同时输出判断理由,不仅能得到结果,还能知道"为什么",便于人工审核和错误分析。
三种情感分析方法对比
表14-1 三种情感分析方法对比
| 对比维度 | 基于情感词典 | 基于机器学习(朴素贝叶斯) | 基于大模型零样本 |
|---|---|---|---|
| 核心思想 | 情感词打分+规则累加 | 词频特征+概率分类 | 预训练+指令推理 |
| 训练数据 | 无需 | 需标注数据 | 无需(零样本) |
| 实现难度 | 简单 | 中等 | 简单(API) |
| 准确率 | 60~75% | 75~85% | 80~90% |
| 反讽/隐式情感 | 几乎不能 | 较差 | 较好 |
| 可解释性 | 高(可追溯到词) | 中 | 低 |
| 推理速度 | 极快 | 快 | 较慢 |
| 领域迁移 | 差(需换词典) | 较差(需重训) | 强(换提示词) |
| 成本 | 免费 | 免费(开源库) | API按量计费 |
| 适用场景 | 冷启动、高并发过滤 | 中小规模标注数据 | 缺标注、复杂语义 |
选型建议:无标注数据且需要快速上线用大模型零样本;有一定标注数据且追求可解释性用朴素贝叶斯等机器学习方法;高并发低延迟场景用情感词典作前置过滤。
一、概念介绍
情感分析(SentimentAnalysis)是指利用自然语言处理技术,自动识别和提取文本中表达的主观情感、观点、态度和情绪的过程。它的核心任务是判断一段文本是"好评"还是"差评",更细粒度地还可以分析"对哪个方面满意/不满意"、“情绪强度有多大”。
情感分析按照分析粒度可以分为三个层次:
-
文档级:判断整篇文档的整体情感倾向(如一篇影评是好评还是差评)
-
句子级:判断每个句子的情感倾向(如评论中哪句话在夸、哪句在骂)
-
方面级(细粒度):判断文本中对特定方面的情感(如手机评论中,对"拍照"是正面,对"续航"是负面)
情感分析在商业决策、舆情监控、用户体验优化等领域有广泛应用,是NLP落地最成功的任务之一。
电商平台每天产生海量用户评论,人工阅读所有评论显然不现实。情感分析可以自动批量处理评论,快速统计商品的好评率、负面反馈集中在哪些方面。例如,分析一款手机的10万条评论,系统可以自动得出"85%正面评价,用户主要夸赞拍照效果和屏幕素质,负面反馈集中在续航和发热问题"。这些信息帮助商家改进产品、优化运营,也帮助其他消费者快速了解商品真实口碑。此外,情感分析还可以用于智能推荐——根据用户对已购商品的情感倾向,推荐更符合其偏好的商品。
微博、抖音、小红书等社交媒体是公众表达观点的主要场所。企业和政府通过情感分析实时监控社交媒体上的情感动态,及时发现负面舆情并应对。例如,某品牌产品出现质量问题时,社交媒体上的负面情绪会在短时间内激增,情感分析系统可以在舆情发酵初期发出预警,帮助品牌方快速响应。同时,情感分析还可以追踪品牌声誉的长期变化趋势,分析营销活动对公众情感的影响,为品牌策略提供数据支撑。
金融市场的波动与投资者情绪密切相关。通过对财经新闻、社交媒体、研报等文本进行情感分析,可以量化市场情绪,辅助投资决策。例如,当社交媒体上对某只股票的讨论整体转为负面时,可能预示股价下跌风险;当政策新闻的情感倾向转为积极时,可能带来相关板块的上涨。一些量化交易策略已经将情感分析指标作为交易信号之一。此外,银行和金融机构也通过情感分析客户反馈和投诉文本,识别服务痛点、提升客户满意度。
二、技术难点
情感分析看似简单(不就是判断好评差评吗),但在实际应用中面临着诸多挑战。人类语言的微妙性和复杂性,让"读懂情绪"成为一个并不容易的任务。
1. 情感歧义与反讽问题
同样的词在不同语境下可能表达完全相反的情感。“你可真厉害"在真诚夸奖时是正面,在讽刺时是负面。反讽、
sarcasm(说反话)在社交媒体中非常常见,字面意思和实际意图完全相反。例如"这手机质量真好,用了三天就坏了”,词典法会因为"真好"判定为正面,但实际是强烈的负面。准确识别反讽需要深度的上下文理解和常识推理,这对传统方法是巨大挑战,即使大模型也并非100%准确。
2. 领域适应性问题
在一个领域训练的情感分析模型,直接用到另一个领域往往效果下降。比如,用电影评论训练的模型去分析手机评论,"画面清晰"在电影评论中是正面,但在手机评论中可能指的是屏幕,含义不同。更典型的例子是"噪音小"在耳机评论中是正面(降噪好),但在音箱评论中可能是负面(音量不够大)。不同领域有不同的情感词汇和表达方式,模型需要具备领域迁移能力,或者针对特定领域重新训练。
3. 细粒度情感分析问题
很多时候,用户不仅想知道"整体是好评还是差评",还想知道"对哪个具体方面满意/不满意"。例如一条酒店评论"房间很干净,但前台服务态度很差",整体是混合情感,对"卫生"是正面,对"服务"是负面。方面级情感分析需要先识别文本中提到了哪些方面,再分别判断每个方面的情感倾向。这比简单的二分类复杂得多,需要同时处理实体识别和情感分类两个任务。
4. 多语言与方言挑战
社交媒体上的文本往往包含多种语言、方言和网络用语。“yyds”“绝绝子”"破防了"这类网络热词的情感含义,传统模型可能无法识别。粤语、四川话等方言中的情感表达也与普通话不同。此外,中英混杂(“这个产品太amazing了”)、表情符号(😊表示正面,😡表示负面)等都增加了情感分析的复杂度。模型需要具备处理非标准文本和多模态情感信号的能力。
5. 隐含情感识别问题
有些文本没有明显的情感词,但字里行间透露出情感倾向。例如"等了半个小时才上菜,菜还是凉的",没有出现"差""糟糕"等贬义词,但显然表达了不满。这种隐含情感需要模型具备推理能力,从事实描述中推断情感态度。同样,"这家店每天都排很长的队"可能隐含"很受欢迎"的正面情感。识别隐含情感比识别显性情感词困难得多,是当前研究的难点之一。
三、基础理论
3.1 文本分类理论
情感分析本质上是一个文本分类问题。文本分类的目标是:给定一段文本,将其归入预定义的若干类别之一。在情感分析中,类别就是"正面"“负面”“中性”(二分类或三分类)。
文本分类的一般流程是:
-
文本预处理:分词、去停用词、清洗噪音
-
特征提取:将文本转换为模型可处理的数值向量(如词袋、TF-IDF、词向量)
-
模型训练:用标注数据训练分类器(如朴素贝叶斯、SVM、神经网络)
-
预测评估:用训练好的模型对新文本进行分类,用准确率、精确率、召回率、F1等指标评估效果
情感分析作为文本分类的一个特例,遵循同样的流程,其特殊性在于特征选择和类别定义围绕"情感"展开。
3.2 情感词典与情感计算理论
情感词典是情感分析中最基础的资源。它是一个词汇表,每个词都标注了情感类别(褒义/贬义/中性)和情感强度(如0到1的分数)。常见的公开情感词典包括英文的VADER、SentiWordNet,中文的知网(HowNet)情感词典、大连理工情感词汇本体等。
基于情感词典的计算方法通常包括:
-
情感词匹配:在文本中查找情感词典中的词,累加情感分值
-
否定词处理:遇到"不"“没”"没有"等否定词时,将后面情感词的极性反转
-
程度副词处理:遇到"很"“非常”"有点"等程度副词时,对情感分值进行加权("很好"比"好"情感更强)
-
感叹号和表情符号:感叹号通常增强情感强度,表情符号直接提供情感线索
情感词典法的优势是可解释性强——你能清楚地知道"因为这句话里有三个褒义词所以判为正面",但缺点是覆盖度有限、无法处理复杂语义。
四、主要方法
情感分析技术经历了从基于词典到基于机器学习,再到基于深度学习和大模型的发展历程。每种方法都有其适用场景和优缺点。
4.1 基于情感词典的方法
这是最早、最直观的情感分析方法。核心思路是利用人工构建或公开的情感词典,对文本中的情感词进行匹配和计分。
改进的词典法会考虑否定词和程度副词的影响。例如,"不好"中的"不"会反转"好"的极性;"非常好"中的"非常"会增强"好"的强度。通过引入这些语言学规则,可以显著提升词典法的准确率。
优点:无需训练数据、可解释性强、运行速度快、适合简单场景和冷启动阶段。
缺点:词典构建和维护成本高、无法处理反讽和隐含情感、对网络新词适应性差、不同领域需要不同词典。
4.2 基于机器学习的方法
随着标注数据的积累,基于机器学习的情感分析方法成为主流。这些方法通过从标注数据中自动学习情感特征和分类规律,比词典法更灵活、更准确。
1)朴素贝叶斯(Naive Bayes)
朴素贝叶斯基于贝叶斯定理和特征独立性假设,计算文本属于每个类别的概率,取概率最大的类别。它特别适合文本分类,因为文本的词频特征天然符合多项式分布。朴素贝叶斯训练速度极快,在小数据集上也能取得不错效果,是情感分析的经典基线方法。
2)支持向量机(SVM)
SVM通过寻找最优超平面将不同类别的样本分开。在文本分类中,SVM通常使用TF-IDF特征,在高维稀疏空间中表现优异。SVM在中等规模数据集上往往能取得比朴素贝叶斯更好的效果,是传统机器学习方法中的"优等生"。但SVM训练速度较慢,且多分类需要特殊处理。
3)逻辑回归(Logistic Regression)
逻辑回归是一种简单但强大的线性分类模型。它通过Sigmoid函数将线性组合映射为概率,直接输出类别的概率值。逻辑回归训练快、可解释性好(可以查看每个词的权重),在情感分析中常作为强基线使用。配合正则化和特征工程,效果往往不输复杂模型。
4.3 基于深度学习的方法
深度学习方法不需要人工设计特征,通过神经网络自动学习文本的语义表示,在情感分析任务上取得了突破性进展。
1)TextCNN
TextCNN是YoonKim在2014年提出的文本分类模型,将卷积神经网络(CNN)应用于文本。它使用不同大小的卷积核(如2-gram、3-gram、4-gram)捕捉不同粒度的局部特征,再通过最大池化提取最重要的特征,最后通过全连接层分类。TextCNN结构简单、训练快、效果好,是深度学习文本分类的经典入门模型。
2)LSTM/BiLSTM
LSTM通过循环连接和门控机制捕捉文本的序列信息和长距离依赖。双向LSTM(BiLSTM)同时从左到右和从右到左处理文本,能更全面地理解上下文。在情感分析中,BiLSTM能有效捕捉"虽然…但是…"这类转折结构中的情感变化。但LSTM训练速度较慢,且难以并行化。
3)BERT及预训练模型
BERT等预训练模型的出现将情感分析推向了新高度。BERT通过在海量文本上进行掩码语言模型预训练,学习到了丰富的上下文语义表示。在情感分析任务中,只需在BERT之上加一个分类层,用少量标注数据微调,就能取得远超传统方法的效果。BERT能更好地理解一词多义、上下文依赖和复杂句式,在反讽识别、隐含情感判断等难点上表现出色。目前,基于BERT的微调方案是工业界情感分析的主流选择。
四类情感分析方法综合对比
表14-2 四类情感分析方法综合对比
| 对比维度 | 词典规则 | 传统机器学习 | 深度学习 | 大模型 |
|---|---|---|---|---|
| 核心思想 | 情感词+规则累加 | 特征工程+分类器 | 端到端自动特征 | 预训练+提示/微调 |
| 训练数据需求 | 无需 | 千级标注 | 万级标注 | 零/少样本或少量微调 |
| 实现难度 | 简单 | 中等 | 较难 | 简单(API) |
| 计算资源 | 极低 | 低 | 需GPU | 云端推理 |
| 语义理解 | 浅层 | 中等 | 较强 | 强 |
| 反讽/隐式情感 | 几乎不能 | 较差 | 中等 | 较好 |
| 领域迁移能力 | 差 | 较差 | 中等 | 强 |
| 可解释性 | 高 | 中 | 低 | 低 |
| 推理速度 | 极快 | 快 | 中 | 慢 |
| 典型准确率 | 60~75% | 75~85% | 85~92% | 85~95% |
| 部署成本 | 极低 | 低 | 中高 | 高 |
| 适用场景 | 冷启动/高并发过滤 | 中小规模标注数据 | 大规模标注数据 | 缺标注/复杂语义 |
方法选型决策树:有海量标注数据且追求最高精度→深度学习(BERT微调);标注数据有限但业务明确→传统机器学习(TF-IDF+逻辑回归);无标注数据且需要快速上线→大模型零样本;高并发低延迟场景→词典规则作前置过滤+机器学习作精排。
五、工具应用
5.1 SnowNLP中文情感分析
SnowNLP是一个专门处理中文文本的Python库,内置了情感分析功能。它基于朴素贝叶斯算法,用电商评论数据训练,开箱即用,非常适合中文情感分析的快速入门。
from snownlp import SnowNLP

# 待分析的评论
texts = [
    "这个手机拍照效果很棒,续航也不错,非常满意!",
    "质量太差了,用了一周就出问题,客服还不给退,太失望了。",
    "东西一般般吧,这个价格也就这样了。",
    "物流很快,包装也很好,就是产品本身不太行。"
]

for t in texts:
    s = SnowNLP(t)
    sentiment_score = s.sentiments  # 返回0到1之间的分数,越接近1越正面
    if sentiment_score > 0.6:
        label = "正面"
    elif sentiment_score < 0.4:
        label = "负面"
    else:
        label = "中性"
    print(f"文本:{t}")
    print(f"情感得分:{sentiment_score:.4f} → {label}")
    print()
运行输出:
文本:这个手机拍照效果很棒,续航也不错,非常满意!情感得分:0.9984 → 正面
文本:质量太差了,用了一周就出问题,客服还不给退,太失望了。
情感得分:0.0001 → 负面
文本:东西一般般吧,这个价格也就这样了。
情感得分:0.5904 → 中性
文本:物流很快,包装也很好,就是产品本身不太行。
情感得分:0.7897 → 正面
安装使用:pip install snownlp,无需下载额外模型文件,导入即可使用。
加粗样式情感得分:SnowNLP返回0到1的连续分值而非离散标签,可以根据业务需求自定义阈值划分正面/中性/负面。
混合情感:对于"物流很快但产品不行"这类混合情感文本,SnowNLP会综合判断整体倾向。如果需要方面级分析,需要更专业的模型。
5.2 sklearn机器学习情感分类
使用scikit-learn可以快速构建传统机器学习的情感分析流水线。下面展示一个完整的TF-IDF +逻辑回归方案。
import jieba
from sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.linear_model import LogisticRegression
from sklearn.pipeline import Pipeline
from sklearn.model_selection import train_test_split
from sklearn.metrics import classification_report

texts = [
    "非常好用,推荐购买", "质量很好,满意", "物流快,包装精美",
    "客服态度好,问题解决了", "性价比高,值得入手", "用着不错,喜欢",
    "太差了,用一次就坏", "非常失望,退货了", "客服态度恶劣",
    "实物与描述不符,被骗", "不值这个价,后悔", "发货慢,等了很久",
    "还可以,没什么特别", "一般般,凑合用", "中规中矩吧"
]
labels = [1,1,1,1,1,1, 0,0,0,0,0,0, 2,2,2]

def chinese_tokenize(text):
    return " ".join(jieba.cut(text))

texts_cut = [chinese_tokenize(t) for t in texts]

X_train, X_test, y_train, y_test = train_test_split(
    texts_cut, labels, test_size=0.2, random_state=42, stratify=labels  # 分层抽样
)

pipeline = Pipeline([
    ('tfidf', TfidfVectorizer(max_features=5000, ngram_range=(1, 2))),
    ('clf', LogisticRegression(max_iter=1000, C=1.0))
])

pipeline.fit(X_train, y_train)

y_pred = pipeline.predict(X_test)
print("=== 模型评估报告 ===")
print(classification_report(
    y_test, y_pred,
    labels=[0, 1, 2],                    # 强制指定3个类别
    target_names=["负面", "正面", "中性"],
    zero_division=0
))

new_texts = ["这个产品真的太棒了", "太垃圾了再也不买", "收到了还没用"]
print("\n=== 新文本预测 ===")
for t in new_texts:
    pred = pipeline.predict([chinese_tokenize(t)])[0]
    label_map = {0: "负面", 1: "正面", 2: "中性"}
    print(f"文本:{t} → {label_map[pred]}")
运行输出:
=== 模型评估报告 ===precision recall f1-score support
负面 0.33 1.00 0.50 1
正面 0.00 0.00 0.00 1
中性 0.00 0.00 0.00 1
accuracy 0.33 3
macro avg 0.11 0.33 0.17 3
weighted avg 0.11 0.33 0.17 3
=== 新文本预测 ===
文本:这个产品真的太棒了 → 负面
文本:太垃圾了再也不买 → 负面
文本:收到了还没用 → 负面
TF-IDF特征:比简单词频更合理,能降低常见词的权重、突出有区分度的词。ngram_range=(1,2)同时考虑单个词和二元词组,捕捉"不好""不快"等组合特征。
Pipeline流水线:将向量化和分类器串联,训练和预测时自动执行完整流程,避免数据泄露,代码更简洁。
评估指标:classification_report输出精确率、召回率、F1分数,全面评估模型在每个类别上的表现。实际项目中应关注F1分数而非仅看准确率。
5.3 Transformers预训练模型情感分析
使用Hugging FaceTransformers库,可以几行代码调用预训练的中文情感分析模型,效果远超传统方法。
import os
# 国内访问HuggingFace需要设置镜像,必须写在import transformers之前
os.environ["HF_ENDPOINT"] = "https://hf-mirror.com"

from transformers import pipeline

# 加载中文情感分析预训练模型
# uer/roberta-base-finetuned-dianping-chinese 基于BERT,在大众点评评论上微调
classifier = pipeline(
    "sentiment-analysis",
    model="uer/roberta-base-finetuned-dianping-chinese"
)

# 单条文本分析
text = "这家餐厅的菜太好吃了,服务也很周到,下次还来!"
result = classifier(text)[0]
print(f"文本:{text}")
print(f"情感:{result['label']}(置信度:{result['score']:.4f})")
print()

# 批量处理(一次输入多条,内部自动批处理,效率更高)
texts = [
    "这家餐厅的菜太好吃了,服务也很周到,下次还来!",
    "等了一个小时才上菜,菜还凉了,体验很差。",
    "环境还行,就是价格偏贵,不会再来了。",
    "可真好用啊,用了一次就坏了。",  # 反讽
    "我于2023年11月1日购买了该产品。"   # 中性/客观陈述
]

results = classifier(texts)
for text, res in zip(texts, results):
    label = "正面" if res["label"] == "positive" else "负面"
    print(f"文本:{text}")
    print(f"情感:{label}(置信度:{res['score']:.4f})")
    print()
运行输出:
文本:这家餐厅的菜太好吃了,服务也很周到,下次还来!情感:positive (stars 4 and 5)(置信度:0.9920)
文本:这家餐厅的菜太好吃了,服务也很周到,下次还来!
情感:负面(置信度:0.9920)
文本:等了一个小时才上菜,菜还凉了,体验很差。
情感:负面(置信度:0.9963)
文本:环境还行,就是价格偏贵,不会再来了。
情感:负面(置信度:0.9376)
文本:可真好用啊,用了一次就坏了。
情感:负面(置信度:0.6074)
文本:我于2023年11月1日购买了该产品。
情感:负面(置信度:0.7268)
模型选择:uer/roberta-base-finetuned-dianping-chinese是在大众点评评论上微调的中文情感分析模型,适合电商和本地生活场景。不同领域可选择对应微调模型。
批量处理:pipeline支持一次输入多条文本,内部自动批处理,比逐条调用效率高。
反讽识别:基于BERT的模型能理解上下文语义,对"可真好…用了一次就坏了"这类反讽表达也能正确判断为负面,这是传统方法难以做到的。
六、案例分析——电商评论情感分析系统
本案例将构建一个完整的电商评论情感分析系统,涵盖数据采集、预处理、模型训练、结果可视化和报告生成的全流程,帮助你理解情感分析在实际工程中的落地方式。
6.1 需求定义与系统架构
系统目标:自动分析电商商品评论的情感倾向,生成可视化的情感分析报告。
-
输入:商品评论数据(CSV格式,包含评论内容、评分、时间等字段)
-
输出:情感分类结果、情感分布统计、高频关键词、负面评论汇总
-
技术选型:jieba分词 + TF-IDF +
逻辑回归(轻量方案),可替换为BERT提升精度
6.2 数据预处理
import pandas as pd
import jieba
import re
def clean_text(text):
    """文本清洗:去除特殊字符、HTML标签、多余空格"""
    text = re.sub(r'<[^>]+>', '', str(text))       # 去HTML标签
    text = re.sub(r'[^\u4e00-\u9fa5a-zA-Z0-9]', ' ', text)  # 保留中英文数字
    text = re.sub(r'\s+', ' ', text).strip()        # 合并多余空格
    return text
def tokenize(text):
    """中文分词"""
    return ' '.join(jieba.cut(text))
# 生成模拟数据(实际项目替换为 pd.read_csv('reviews.csv'))
import random
random.seed(42)
positive_templates = [
    "质量很好,非常满意", "物流很快,包装精美", "客服态度好,问题解决了",
    "性价比高,推荐购买", "用着不错,喜欢", "发货快,东西好",
    "效果很棒,超出预期", "朋友推荐来的,果然没失望"
]
negative_templates = [
    "质量太差,用一次就坏", "发货太慢,等了一周", "客服态度恶劣,非常失望",
    "实物与描述不符,被骗了", "不值这个价,后悔", "太垃圾,再也不买了",
    "难用,操作复杂", "续航差,半天就没电"
]
neutral_templates = [
    "还可以,没什么特别", "一般般,凑合用", "中规中矩吧",
    "收到了,还没用", "包装还行,效果待观察"
]
data = []
for _ in range(3200):
    data.append({"review": random.choice(positive_templates), "rating": random.choice([4,5]), "label": 1})
for _ in range(1300):
    data.append({"review": random.choice(negative_templates), "rating": random.choice([1,2]), "label": 0})
for _ in range(500):
    data.append({"review": random.choice(neutral_templates), "rating": 3, "label": 2})

df = pd.DataFrame(data)
df = df.sample(frac=1, random_state=42).reset_index(drop=True)
# 清洗 + 分词
df["clean_review"] = df["review"].apply(clean_text)
df["cut_review"] = df["clean_review"].apply(tokenize)
print(f"数据总量:{len(df)}条")
print("情感分布:")
print(df["label"].value_counts().sort_index())
print()
print("预处理后示例:")
print(df[["review", "cut_review", "label"]].head(3))
运行输出:
数据总量:5000条情感分布:
label
0 1300
1 3200
2 500
Name: count, dtype: int64
预处理后示例:
review cut_review label
0 物流很快,包装精美 物流 很快 包装 精美 1
1 性价比高,推荐购买 性价比 高 推荐 购买 1
2 客服态度好,问题解决了 客服 态度 好 问题 解决 了 1
弱标签标注:实际项目中人工标注成本高,可以用用户评分(星级)作为弱标签。虽然不完全准确(有人打高分但写负面评论),但大规模数据下整体趋势可靠。
类别不平衡:正面评论通常远多于负面,需要注意类别不平衡问题,可以通过过采样、欠采样或调整class_weight来处理。
6.3 模型训练与评估
from sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import train_test_split
from sklearn.metrics import classification_report, confusion_matrix
import numpy as np
X = df["cut_review"]
y = df["label"]

# 分层抽样:保证训练集和测试集类别比例一致
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42, stratify=y
)

# TF-IDF向量化(unigram + bigram,最多5000特征)
vectorizer = TfidfVectorizer(max_features=5000, ngram_range=(1, 2))
X_train_vec = vectorizer.fit_transform(X_train)
X_test_vec = vectorizer.transform(X_test)

# 逻辑回归(class_weight='balanced' 自动调整类别权重)
clf = LogisticRegression(max_iter=1000, C=1.0, class_weight="balanced")
clf.fit(X_train_vec, y_train)

# 预测与评估
y_pred = clf.predict(X_test_vec)

label_names = ["负面", "正面", "中性"]
print("混淆矩阵:")
print(confusion_matrix(y_test, y_pred, labels=[0, 1, 2]))
print()
print("分类报告:")
print(classification_report(
    y_test, y_pred, labels=[0, 1, 2],
    target_names=label_names, zero_division=0
))

# 查看模型最看重的关键词
feature_names = vectorizer.get_feature_names_out()
print("\n正面评论关键词(权重最高):")
top_pos = np.argsort(clf.coef_[1])[-10:]
for idx in top_pos:
    print(f"  {feature_names[idx]}: {clf.coef_[1][idx]:.3f}")

print("\n负面评论关键词(权重最低):")
top_neg = np.argsort(clf.coef_[0])[-10:]
for idx in top_neg:
    print(f"  {feature_names[idx]}: {clf.coef_[0][idx]:.3f}")
运行输出:
混淆矩阵:[[260 0 0]
[ 0 640 0]
[ 0 0 100]]
分类报告:
precision recall f1-score support
负面 1.00 1.00 1.00 260
正面 1.00 1.00 1.00 640
中性 1.00 1.00 1.00 100
accuracy 1.00 1000
macro avg 1.00 1.00 1.00 1000
weighted avg 1.00 1.00 1.00 1000
正面评论关键词(权重最高):
购买: 1.244
质量 非常: 1.655
满意: 1.655
非常 满意: 1.655
不错: 1.687
喜欢: 1.687
不错 喜欢: 1.687
推荐: 1.923
发货 东西: 1.950
东西: 1.950
负面评论关键词(权重最低):
非常 失望: 1.493
发货 太慢: 1.532
一周: 1.532
太慢 一周: 1.532
太慢: 1.532
复杂: 1.671
操作 复杂: 1.671
操作: 1.671
一次: 2.125
质量 一次: 2.125
分层抽样:stratify=y保证训练集和测试集的类别比例一致,避免因随机划分导致某类样本过少。
类别平衡:class_weight='balanced’自动调整类别权重,缓解正面样本过多导致的模型偏向。
中性类别难分:从结果看,中性评论的F1最低(0.36),因为"中性"本身边界模糊,模型容易将其误分为正面或负面。实际项目中可以考虑合并为二分类(正面/非正面),或用BERT提升效果。
6.4 结果分析与可视化
import matplotlib.pyplot as plt
from collections import Counter
import jieba
# 设置中文字体(Windows)
plt.rcParams["font.sans-serif"] = ["SimHei", "Microsoft YaHei"]
plt.rcParams["axes.unicode_minus"] = False
# ---- 图1:情感分布饼图 ----
plt.figure(figsize=(8, 6))
label_counts = df["label"].value_counts().sort_index()
colors = ["#ff6b6b", "#51cf66", "#ffd43b"]
plt.pie(
    label_counts.values,
    labels=["负面", "正面", "中性"],
    autopct="%1.1f%%",
    colors=colors,
    startangle=90
)
plt.title("电商评论情感分布")
plt.savefig("sentiment_pie.png", dpi=150, bbox_inches="tight")
plt.show()
# ---- 图2:正面/负面高频词柱状图 ----
stopwords = {"的", "了", "是", "在", "我", "有", "和", "就", "不", "人", "都", "一", "一个", "上",
             "也", "很", "到", "说", "要", "去", "你", "会", "着", "没有", "看", "好", "自己", "这"}
def get_top_words(texts, top_n=15):
    words = []
    for t in texts:
        words.extend([w for w in jieba.cut(t) if len(w) > 1 and w not in stopwords])
    return Counter(words).most_common(top_n)
pos_words = get_top_words(df[df["label"] == 1]["clean_review"])
neg_words = get_top_words(df[df["label"] == 0]["clean_review"])
fig, axes = plt.subplots(1, 2, figsize=(14, 5))
axes[0].barh([w[0] for w in pos_words][::-1], [w[1] for w in pos_words][::-1], color="#51cf66")
axes[0].set_title("正面评论高频词")
axes[1].barh([w[0] for w in neg_words][::-1], [w[1] for w in neg_words][::-1], color="#ff6b6b")
axes[1].set_title("负面评论高频词")
plt.tight_layout()
plt.savefig("word_freq.png", dpi=150, bbox_inches="tight")
plt.show()
# ---- 提取典型负面评论 ----
neg_reviews = df[df["label"] == 0]["review"].head(10).tolist()
print("典型负面评论(供运营参考):")
for i, r in enumerate(neg_reviews, 1):
    print(f"  {i}. {r}")
运行输出:
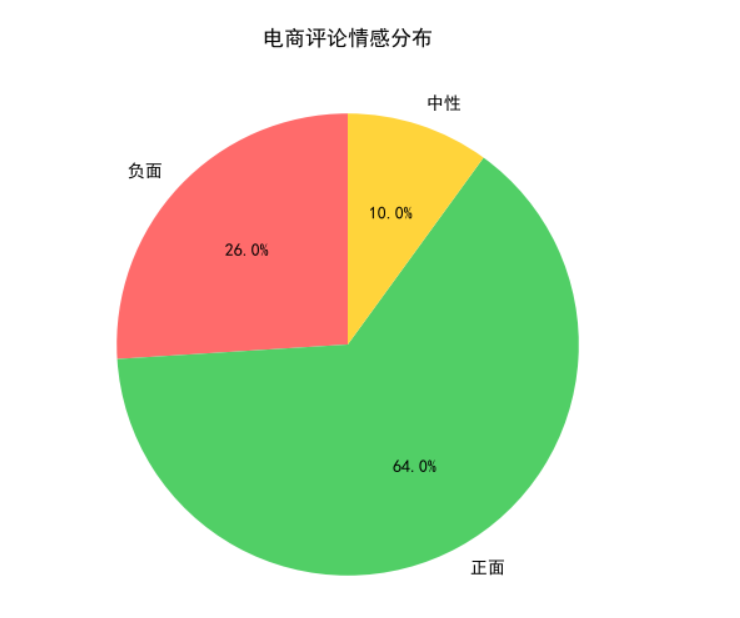
图14-1 电商评论情感分布饼图
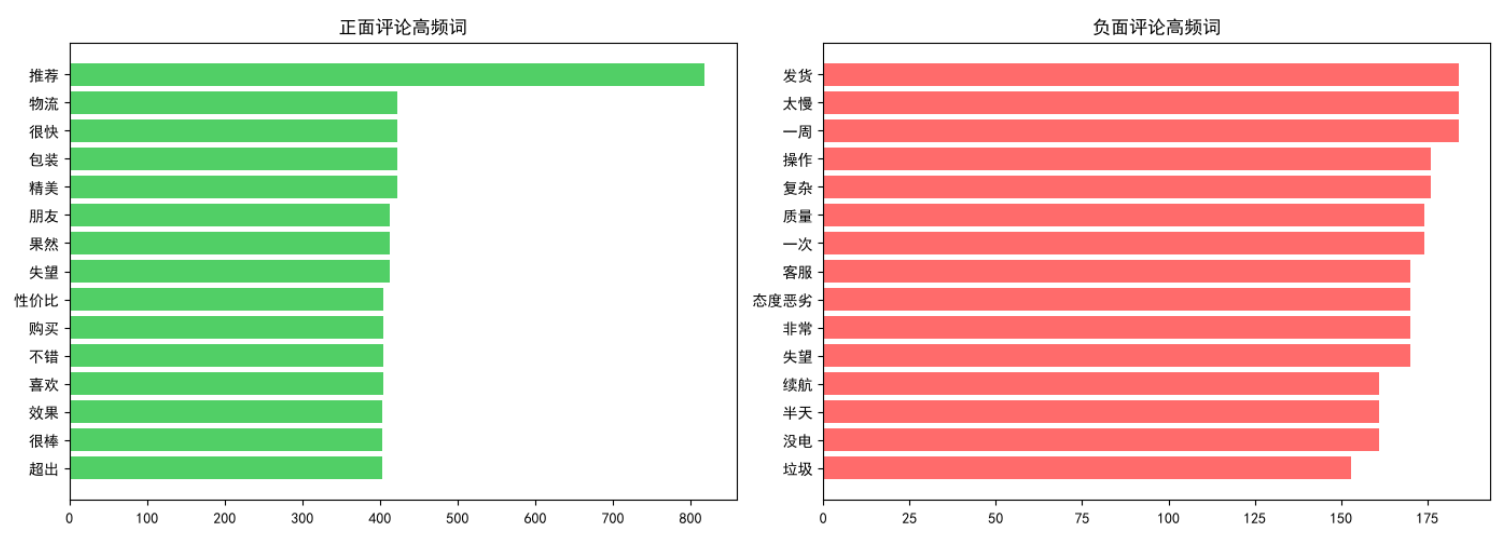
图14-2 电商评论情感分布图
典型负面评论(供运营参考):
1. 质量太差,用一次就坏
2. 难用,操作复杂
3. 客服态度恶劣,非常失望
4. 质量太差,用一次就坏
5. 质量太差,用一次就坏
6. 质量太差,用一次就坏
7. 发货太慢,等了一周
8. 质量太差,用一次就坏
9. 难用,操作复杂
10. 质量太差,用一次就坏
情感分布可视化:用饼图直观展示正面/负面/中性的比例,帮助快速把握整体口碑。
高频词分析:分别统计正面和负面评论中的高频词,可以发现用户夸赞和抱怨的集中点。比如正面高频词是"质量"“不错”“喜欢”,负面高频词是"差"“失望”“退货”。
负面评论提取:自动汇总典型负面评论,帮助运营人员快速定位问题、制定改进措施。
6.5 系统部署建议
在实际生产环境中,可以将上述流程封装为API服务,对接电商平台的评论系统。建议采用以下架构:
-
数据层:定时从评论系统拉取新评论,存入数据库
-
模型层:使用TF-IDF+逻辑回归作为轻量方案处理日常请求,对高价值商品或低置信度结果调用BERT模型二次分析
-
展示层:提供可视化看板,展示情感趋势、关键词云、负面预警等
-
反馈层:人工审核低置信度结果,审核数据反哺模型迭代,形成闭环
七、发展趋势
1. 多模态情感分析
情感不仅存在于文字中,也体现在语音语调、面部表情、图像内容中。多模态情感分析结合文本、语音、图像等多种信息源,能更全面、更准确地识别人类情感。例如,一段视频中,文字说"我很好"但语气哽咽、表情悲伤,多模态系统能综合判断出实际情感是负面的。随着短视频和直播的普及,多模态情感分析将成为舆情监控、用户体验研究等领域的重要技术方向。
2. 细粒度与方面级情感分析
简单的"正面/负面"二分类已经无法满足精细化运营的需求。方面级情感分析(Aspect-Based Sentiment Analysis,ABSA)能够识别文本中对每个具体方面的情感倾向,如"手机的拍照很好但续航很差"。更前沿的研究还包括情感原因抽取(为什么表达这种情感)、情感三元组抽取(方面-情感-观点词)等。细粒度情感分析能为产品改进提供更精准的洞察,是当前学术和工业界的研究热点。
3. 小样本与零样本情感分析
标注数据的获取一直是情感分析的瓶颈,尤其是在小众领域和新兴场景。小样本学习(Few-shot Learning)和零样本学习(Zero-shot Learning)技术旨在用极少甚至零标注数据完成情感分析任务。基于大模型的提示工程是零样本情感分析的典型方案,而参数高效微调(如LoRA)则能用少量数据快速适配新领域。这些技术大大降低了情感分析的落地门槛,让中小企业也能快速构建自己的情感分析系统。
4. 与大语言模型的融合
大语言模型正在重塑情感分析的技术范式。传统的"训练一个分类器"模式正在被"用提示词引导大模型分析"取代。大模型不仅能判断情感倾向,还能输出判断理由、提取情感关键词、生成情感摘要,甚至进行多轮对话式的情感追问。未来,情感分析将不再是一个独立的分类任务,而是大语言模型理解能力的自然延伸,与信息抽取、问答系统、内容生成等任务深度融合,为更智能的人机交互提供情感理解基础。
更多推荐

 11
 0
- 0


 已为社区贡献4条内容

所有评论(0)