
《理解深度学习》第15章 生成式对抗网络 读书笔记
《理解深度学习》第15章 生成式对抗网络 读书笔记
目录
开篇导语
上一章我们学习了无监督学习的概述,知道了生成模型的目标是学习数据分布并生成新样本。从本章开始,我们将深入学习四种主要的生成模型架构。首先是生成式对抗网络(Generative Adversarial Network,GAN)——一种由Ian Goodfellow在2014年提出的革命性生成模型。
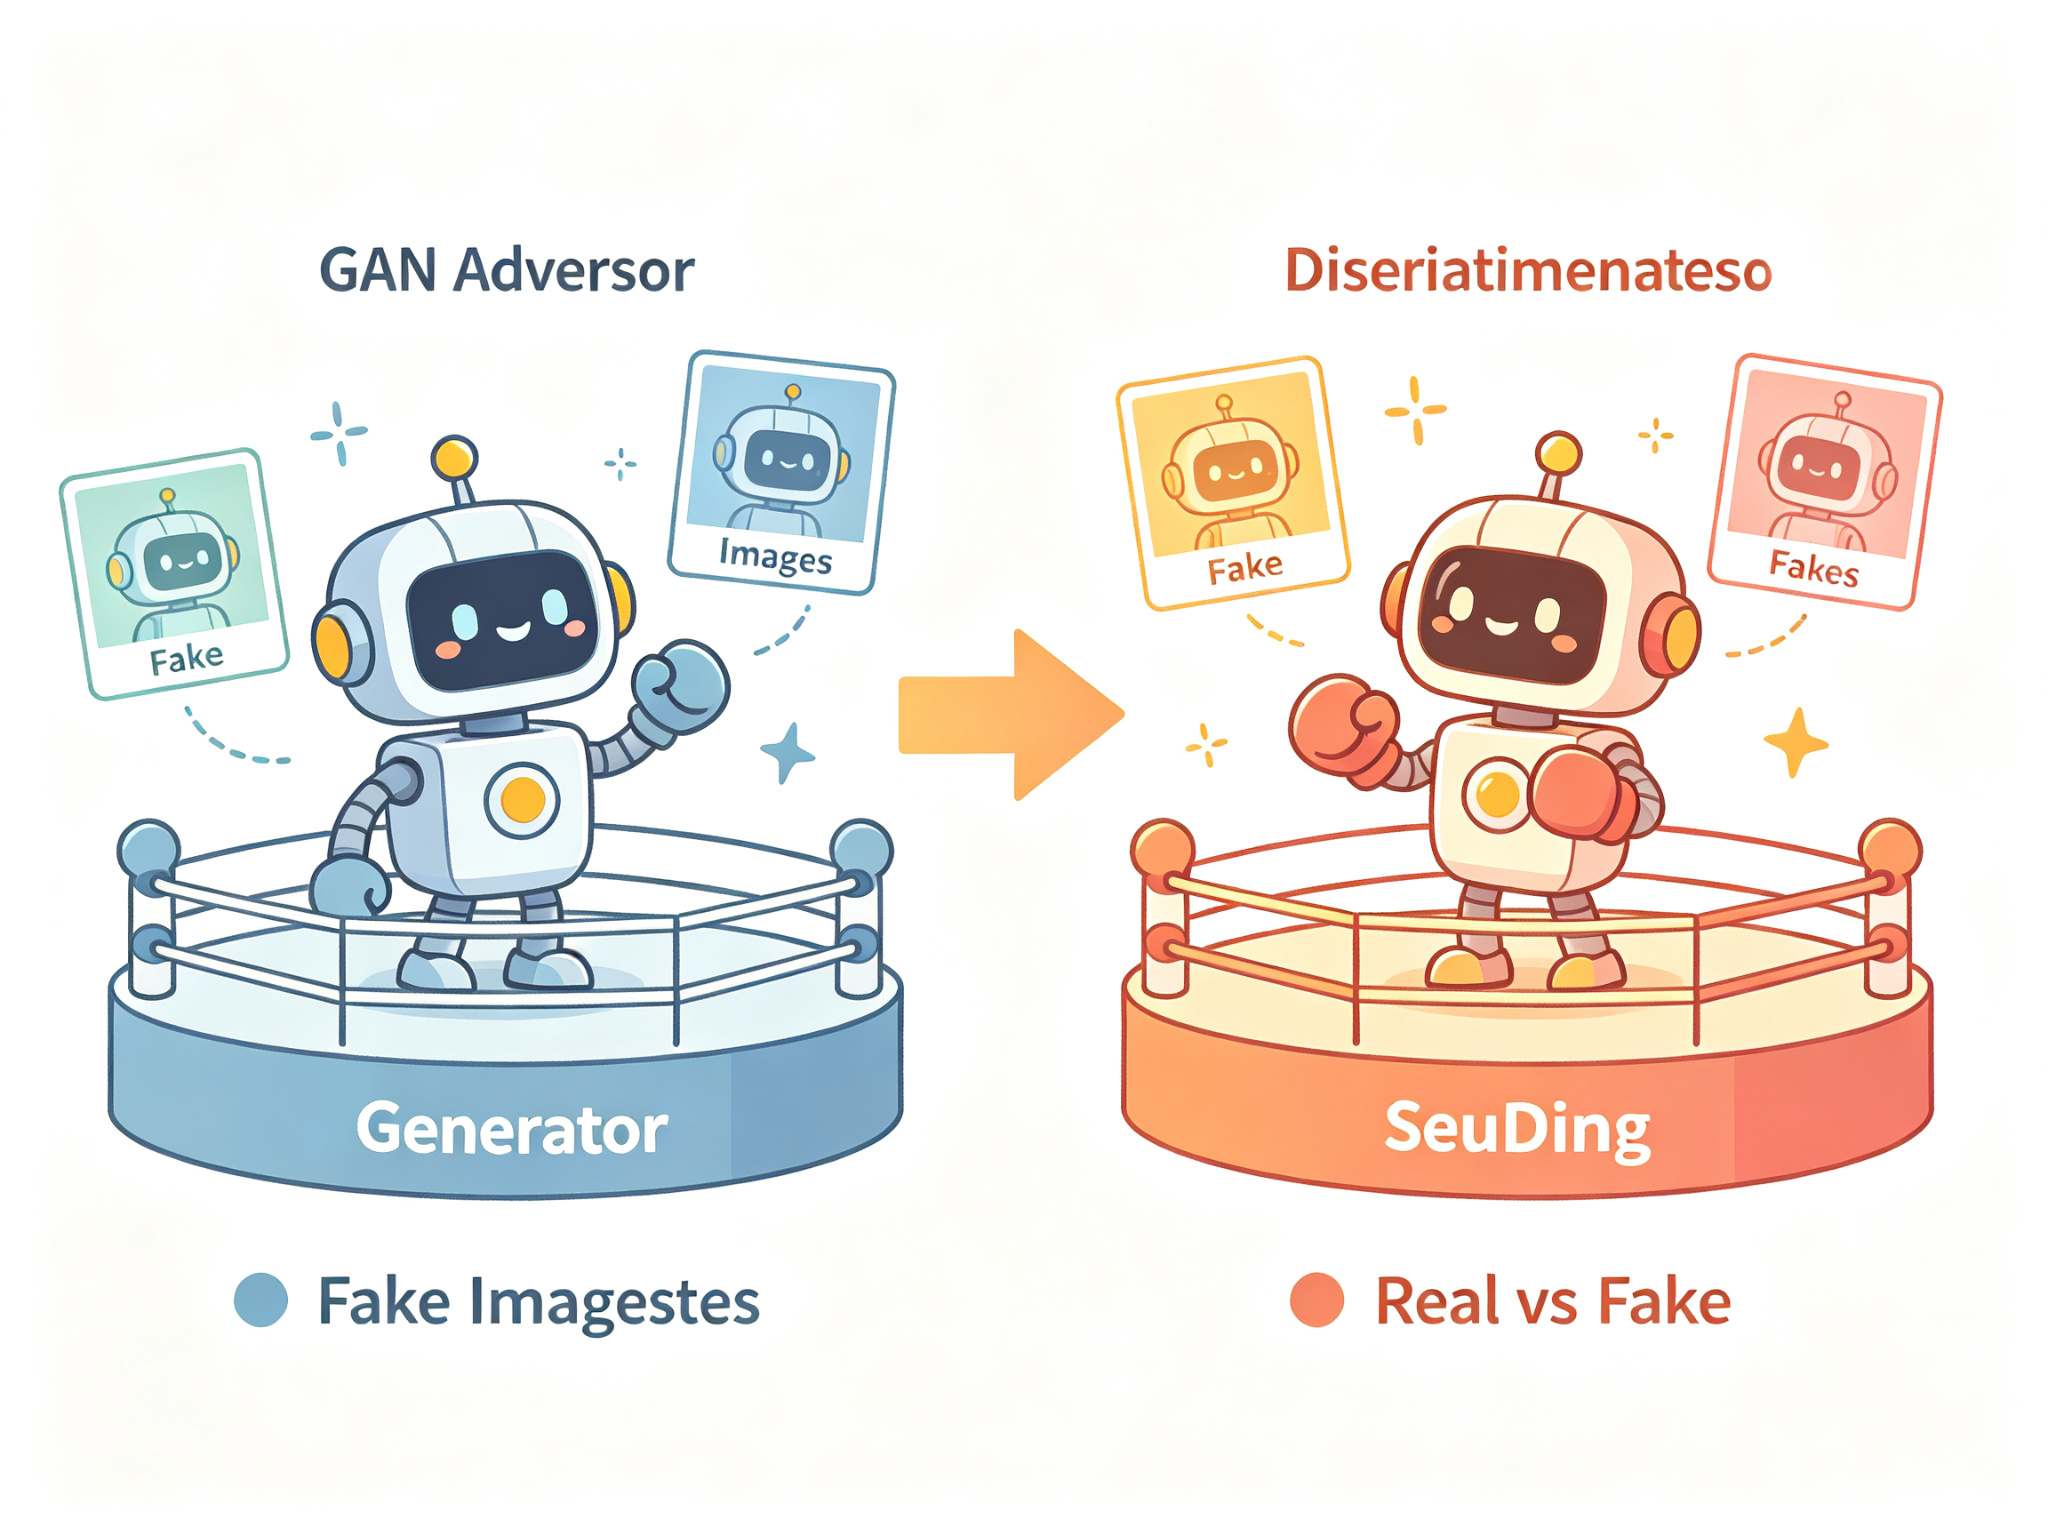
GAN的核心思想非常巧妙:让两个神经网络互相对抗。一个叫生成器(Generator),负责生成以假乱真的样本;另一个叫判别器(Discriminator),负责判断一个样本是真实的还是生成的。两个网络在对抗博弈中共同进步:生成器努力骗过判别器,判别器努力不被骗。最终,生成器能生成和真实数据几乎无法区分的样本,判别器的准确率降到50%(随机猜测)。
GAN曾经是图像生成的SOTA,在图像翻译、超分辨率、风格迁移、人脸生成等任务中取得了惊人的效果。虽然近年来扩散模型在很多任务上超越了GAN,但GAN仍然有其独特优势(推理速度快、不需要逐步去噪),在很多实际应用中仍在使用。
本章我们将系统学习GAN。首先理解"判别作为信号"的核心思想,然后讨论GAN训练的稳定性问题及改进方法,接着看提升生成质量的技术、条件生成、图像翻译,最后学习StyleGAN这一GAN的巅峰之作。
15.1 判别作为信号
GAN的基本框架
GAN由两个网络组成:
- 生成器 G G G:输入随机噪声 z ∼ p z ( z ) z \sim p_z(z) z∼pz(z),输出生成样本 G ( z ) G(z) G(z),目标是让生成样本尽可能接近真实数据分布 p d a t a p_{data} pdata。
- 判别器 D D D:输入样本 x x x,输出 D ( x ) ∈ [ 0 , 1 ] D(x) \in [0,1] D(x)∈[0,1],表示样本来自真实数据的概率。目标是尽可能准确地区分真实样本和生成样本。
两个网络交替训练:
- 固定生成器,训练判别器:让判别器能准确区分真实样本和生成样本。
- 固定判别器,训练生成器:让生成器生成的样本能骗过判别器。
极小极大博弈
GAN的训练可以形式化为一个极小极大博弈(Minimax Game):
min G max D V ( D , G ) = E x ∼ p d a t a [ log D ( x ) ] + E z ∼ p z [ log ( 1 − D ( G ( z ) ) ) ] \min_G \max_D V(D, G) = \mathbb{E}_{x \sim p_{data}}[\log D(x)] + \mathbb{E}_{z \sim p_z}[\log(1 - D(G(z)))] GminDmaxV(D,G)=Ex∼pdata[logD(x)]+Ez∼pz[log(1−D(G(z)))]
其中:
- 判别器 D D D 最大化 V ( D , G ) V(D,G) V(D,G):让 D ( x ) D(x) D(x) 接近1(真实样本判为真),让 D ( G ( z ) ) D(G(z)) D(G(z)) 接近0(生成样本判为假)。
- 生成器 G G G 最小化 V ( D , G ) V(D,G) V(D,G):让 D ( G ( z ) ) D(G(z)) D(G(z)) 接近1(生成样本被判为真,骗过判别器)。
理论最优解
Goodfellow证明了,在最优判别器下,生成器的目标函数等价于最小化真实分布和生成分布之间的JS散度(Jensen-Shannon Divergence):
min G V ( D ∗ , G ) = 2 ⋅ J S ( p d a t a ∥ p g ) − 2 log 2 \min_G V(D^*, G) = 2 \cdot JS(p_{data} \parallel p_g) - 2\log 2 GminV(D∗,G)=2⋅JS(pdata∥pg)−2log2
当且仅当 p g = p d a t a p_g = p_{data} pg=pdata 时,JS散度为0,达到全局最优。此时判别器对任何样本的输出都是 D ( x ) = 0.5 D(x) = 0.5 D(x)=0.5(无法区分真实和生成)。
非饱和损失
原始的生成器损失 log ( 1 − D ( G ( z ) ) ) \log(1 - D(G(z))) log(1−D(G(z))) 在训练初期梯度很小(因为判别器很容易区分真假, D ( G ( z ) ) D(G(z)) D(G(z)) 接近0, log ( 1 − D ( G ( z ) ) ) \log(1-D(G(z))) log(1−D(G(z))) 接近0,梯度也接近0),导致生成器训练缓慢。
为了解决这个问题,通常使用非饱和损失(Non-saturating Loss):
L G = − E z ∼ p z [ log D ( G ( z ) ) ] \mathcal{L}_G = -\mathbb{E}_{z \sim p_z}[\log D(G(z))] LG=−Ez∼pz[logD(G(z))]
这个损失在训练初期梯度更大,生成器训练更快。这是实践中最常用的生成器损失。
"判别作为信号"的含义
GAN和其他生成模型(如VAE、流模型)的一个关键区别是:GAN不直接定义数据的似然函数,而是用判别器提供的判别信号来指导生成器的训练。判别器相当于一个可学习的损失函数,它告诉生成器"生成的样本哪里不像真实数据",生成器据此改进。这种"判别作为信号"的思想是GAN的核心创新。
15.2 提高稳定性
GAN的训练以不稳定著称。理想情况下,生成器和判别器应该平衡发展,但实践中经常出现以下问题:
常见训练问题
- 模式崩溃(Mode Collapse):生成器只生成少数几种类型的样本,忽略了数据分布中的其他模式。例如,在人脸生成中,生成器只生成少数几张脸,所有输出都很相似。
- 判别器过强:判别器太强,生成器的梯度接近0,无法学习。
- 生成器过强:生成器太强,判别器被完全骗过,判别器的梯度消失,两个网络都停止学习。
- 训练震荡:生成器和判别器的损失来回震荡,不收敛。
- 梯度消失/爆炸:深层网络中的梯度问题。
提高稳定性的方法
1. WGAN(Wasserstein GAN)
&ememsp;WGAN用Wasserstein距离(也叫推土机距离,Earth Mover’s Distance)代替JS散度作为训练目标。Wasserstein距离比JS散度更平滑,即使两个分布没有重叠,也有有意义的梯度,解决了原始GAN梯度消失的问题。
WGAN的判别器(叫"评论员"Critic)需要满足1-Lipschitz约束,通常通过**权重裁剪(Weight Clipping)**实现(把权重限制在[-0.01, 0.01]范围内)。
2. WGAN-GP
WGAN的权重裁剪太粗暴,可能导致性能问题。WGAN-GP(Gradient Penalty)用梯度惩罚代替权重裁剪来满足Lipschitz约束:
L G P = λ E x ^ ∼ p x ^ [ ( ∥ ∇ x ^ D ( x ^ ) ∥ 2 − 1 ) 2 ] \mathcal{L}_{GP} = \lambda \mathbb{E}_{\hat{x} \sim p_{\hat{x}}}\left[(\|\nabla_{\hat{x}} D(\hat{x})\|_2 - 1)^2\right] LGP=λEx^∼px^[(∥∇x^D(x^)∥2−1)2]
其中 x ^ \hat{x} x^ 是真实样本和生成样本的随机插值。梯度惩罚比权重裁剪更平滑,训练更稳定,生成质量更高。
3. Spectral Normalization(谱归一化)
谱归一化通过约束判别器每层权重矩阵的谱范数(最大奇异值)来满足Lipschitz约束。这是一种更优雅、更有效的方法,在SAGAN、BigGAN等高质量GAN中广泛使用。
4. 其他技巧
- 交替训练比例:每训练k次判别器,训练1次生成器(通常k=1或5)。
- 学习率调整:使用较小的学习率(如0.0002)和Adam优化器( β 1 = 0.5 \beta_1=0.5 β1=0.5)。
- 批量归一化:在生成器和判别器中使用BatchNorm(判别器中有时用LayerNorm)。
- 梯度惩罚/裁剪:防止梯度爆炸。
- 标签平滑(Label Smoothing):把真实标签从1改为0.9,防止判别器过于自信。
15.3 提升生成图像质量的方法
除了稳定性,提升生成图像的质量也是GAN研究的重点。
渐进式增长(ProGAN)
ProGAN(Progressive Growing of GANs) 的核心思想是:从低分辨率开始训练,逐步增加分辨率。训练初期只生成4×4的图像,训练稳定后逐步增加到8×8、16×16、…、1024×1024。这种渐进式训练大大提高了训练稳定性和生成质量,ProGAN首次生成了高质量的1024×1024人脸图像。
自注意力GAN(SAGAN)
传统GAN的卷积层只能捕捉局部信息,难以建模长距离依赖(如图像左侧和右侧的关系)。SAGAN(Self-Attention GAN) 在GAN中引入自注意力机制,让生成器和判别器能建模长距离依赖,生成全局一致的图像。
BigGAN
BigGAN 证明了规模就是一切:通过增大batch size(2048)、增大模型参数、使用谱归一化和条件批量归一化,BigGAN在ImageNet上取得了前所未有的生成质量(FID=6.49)。BigGAN展示了GAN的巨大潜力。
其他提升质量的方法
- 条件批量归一化(Conditional BatchNorm):用类别标签控制BatchNorm的缩放和平移参数,让生成器能根据类别生成不同的图像。
- 截断技巧(Truncation Trick):在推理时,把噪声 z z z 限制在一定范围内(如截断正态分布),可以提高生成质量但降低多样性。
- 多尺度判别器:使用多个不同分辨率的判别器,同时关注全局结构和局部细节。
15.4 条件生成
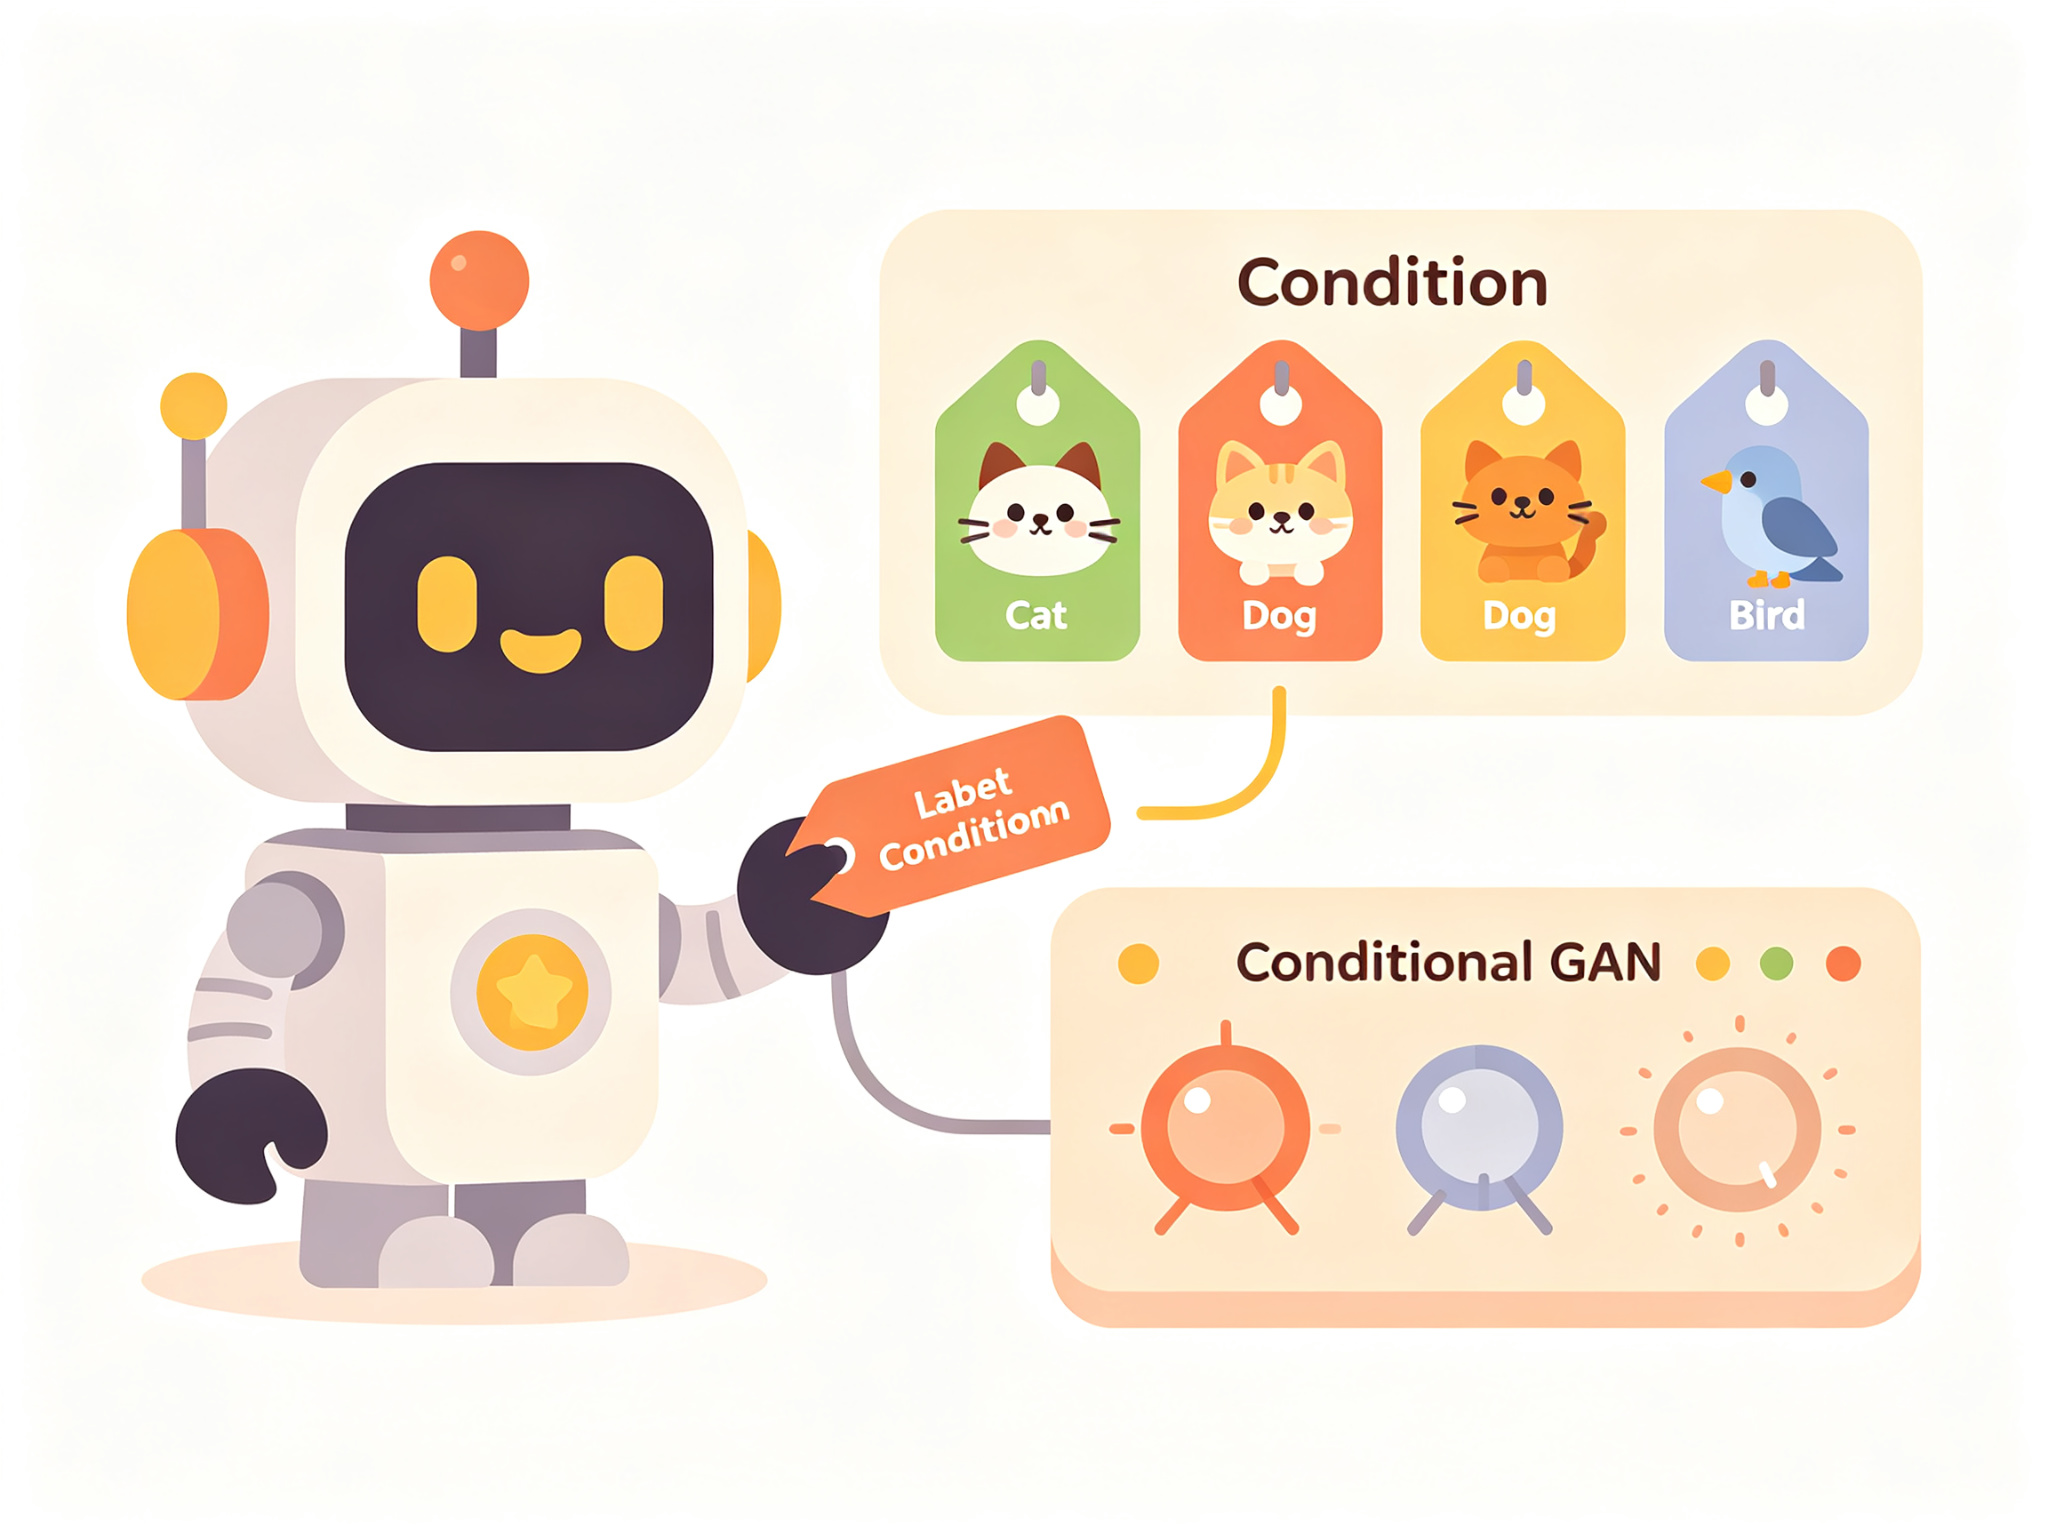
原始GAN是无条件的——只能从噪声生成随机样本,无法控制生成什么。条件GAN(Conditional GAN,cGAN) 通过给生成器和判别器额外输入条件信息(如类别标签、文本描述),让生成器能根据条件生成对应的样本。
条件GAN的框架
条件GAN的极小极大目标变为:
min G max D V ( D , G ) = E x ∼ p d a t a [ log D ( x ∣ y ) ] + E z ∼ p z [ log ( 1 − D ( G ( z ∣ y ) ∣ y ) ) ] \min_G \max_D V(D, G) = \mathbb{E}_{x \sim p_{data}}[\log D(x|y)] + \mathbb{E}_{z \sim p_z}[\log(1 - D(G(z|y)|y))] GminDmaxV(D,G)=Ex∼pdata[logD(x∣y)]+Ez∼pz[log(1−D(G(z∣y)∣y))]
其中 y y y 是条件信息(如类别标签)。生成器输入 ( z , y ) (z, y) (z,y),输出 G ( z ∣ y ) G(z|y) G(z∣y);判别器输入 ( x , y ) (x, y) (x,y),输出 D ( x ∣ y ) D(x|y) D(x∣y)。
条件信息的注入方式
- 拼接(Concatenation):把条件信息和输入拼接在一起,作为网络的输入。这是最简单的方式。
- 条件批量归一化(Conditional BatchNorm):用条件信息控制BatchNorm的缩放和平移参数。这是更有效的方式,在BigGAN、StyleGAN中使用。
- 投影(Projection):把条件信息投影到和判别器特征相同的空间,做点积。这是cGAN中常用的判别器条件注入方式。
条件GAN的应用
- 文本到图像生成:根据文本描述生成图像(如StackGAN、AttnGAN、CLIP+GAN)。
- 类别条件生成:根据类别标签生成对应类别的图像(如BigGAN)。
- 图像到图像翻译:根据输入图像生成输出图像(如Pix2Pix、CycleGAN,见15.5节)。
- 超分辨率:根据低分辨率图像生成高分辨率图像(如SRGAN)。
- 人脸属性编辑:根据属性标签(如年龄、性别、表情)编辑人脸(如StarGAN)。
15.5 图像翻译
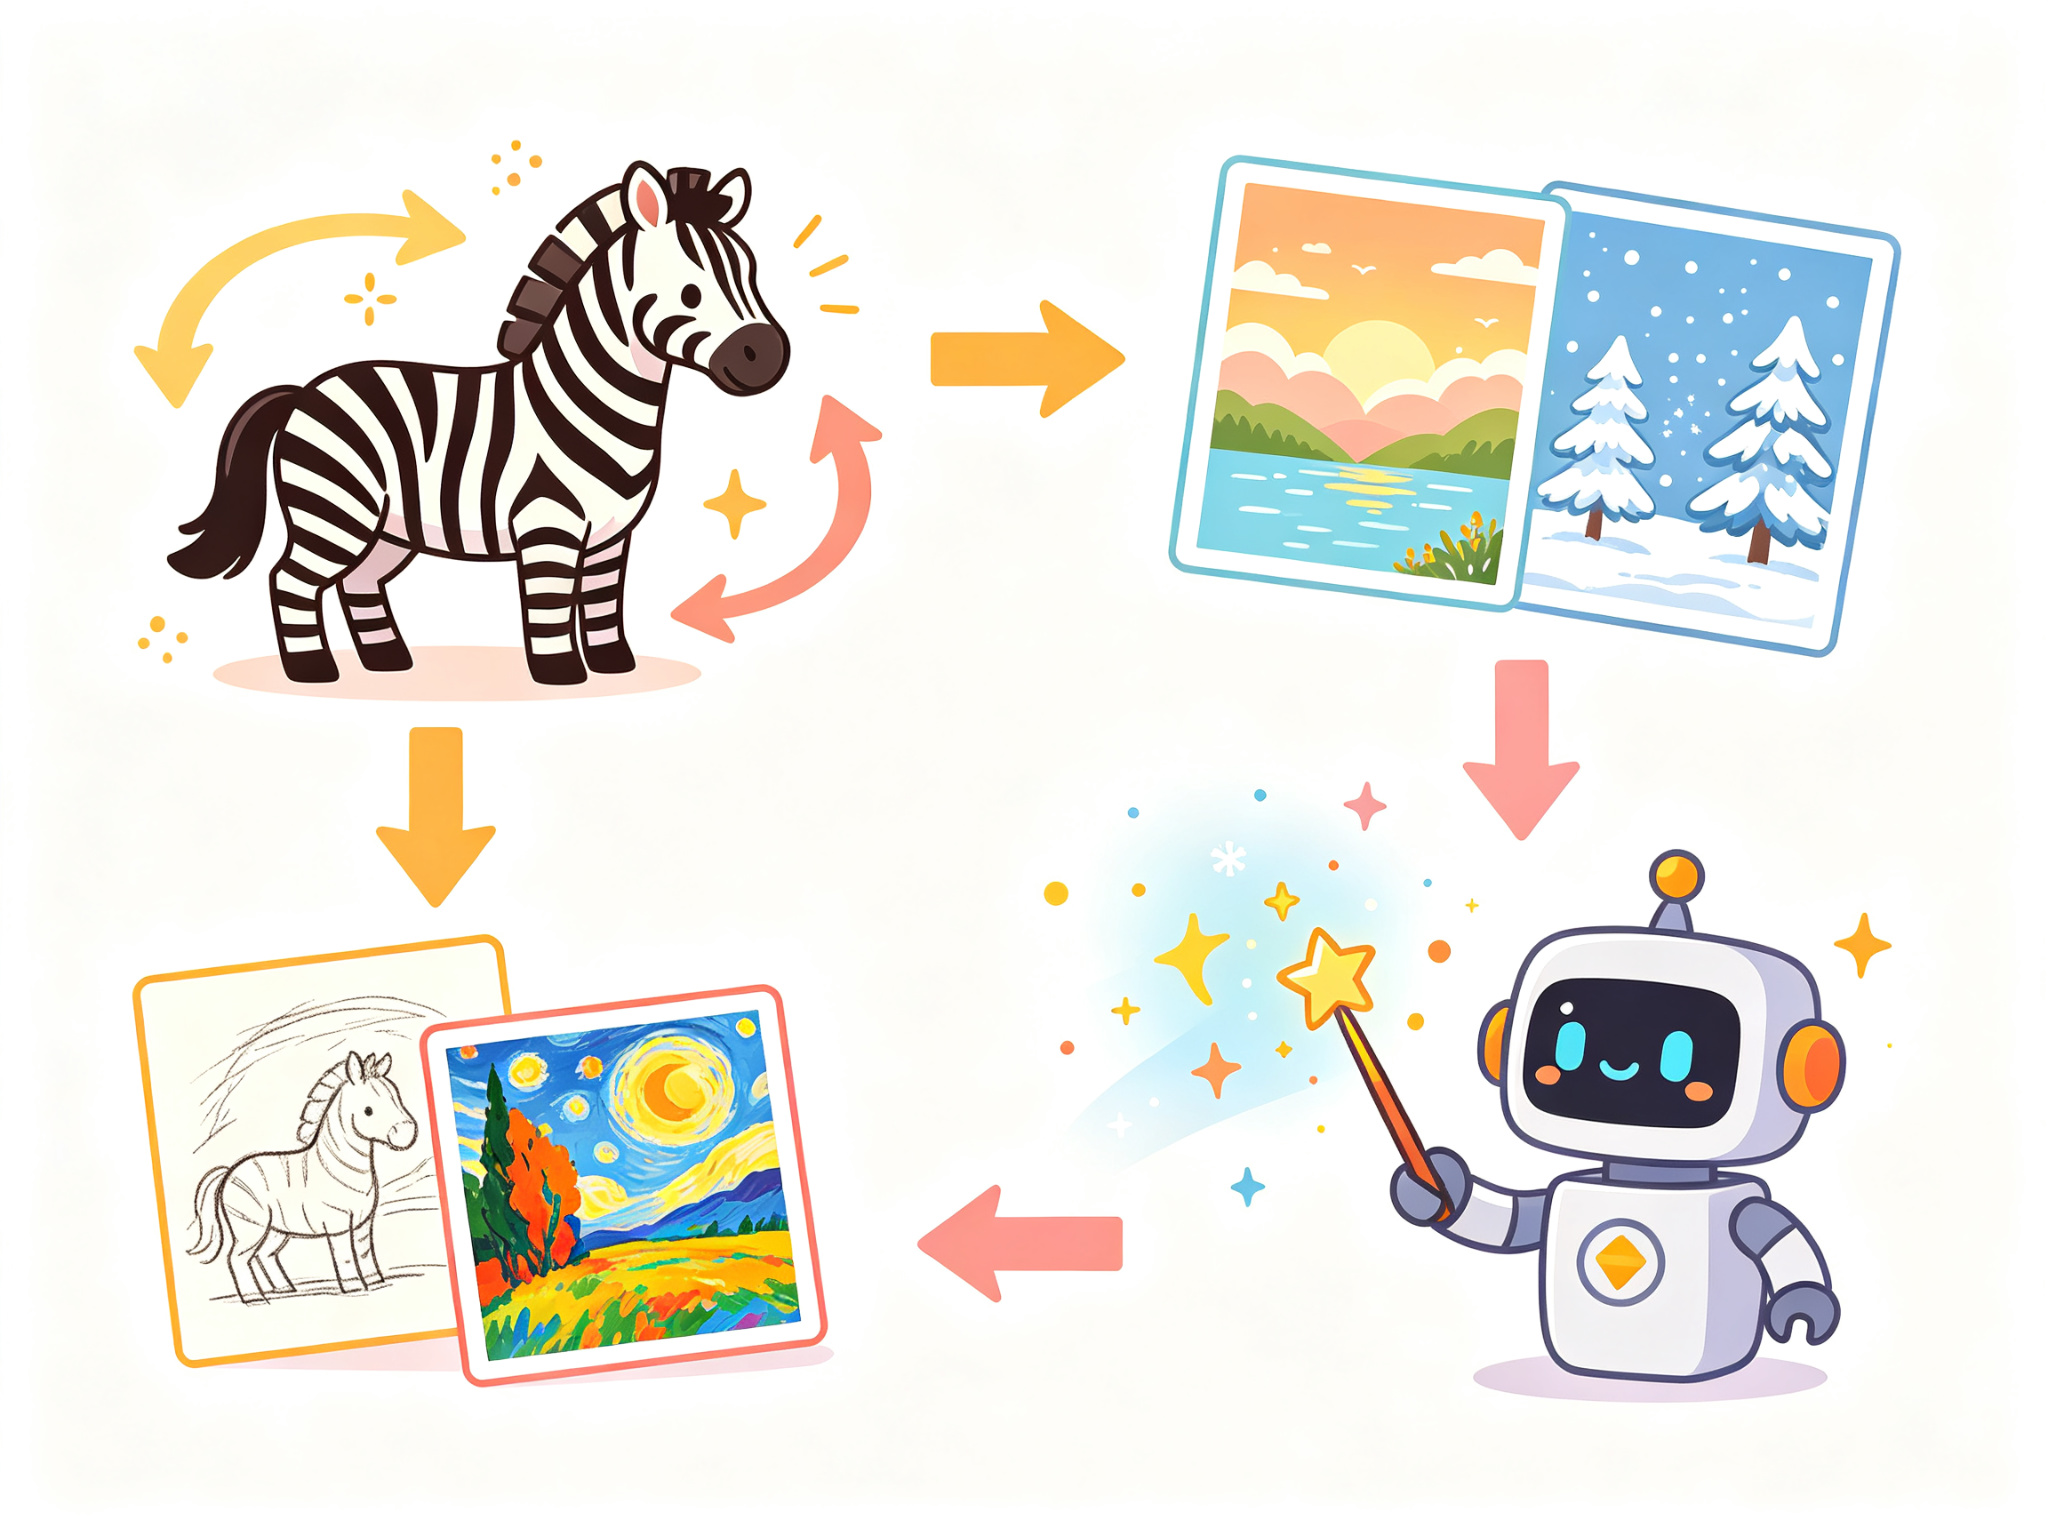
图像翻译(Image-to-Image Translation) 是指将一种域的图像转换为另一种域的图像,例如:
- 草图 → 真实图像
- 白天 → 夜晚
- 马 → 斑马
- 夏天 → 冬天
- 卫星图 → 地图
- 黑白 → 彩色
Pix2Pix:有配对数据的图像翻译
Pix2Pix 假设有配对的训练数据(输入图像和对应的目标图像),使用条件GAN框架:生成器输入源域图像,输出目标域图像;判别器判断(源域图像,目标域图像)对是真实的还是生成的。
Pix2Pix的生成器使用U-Net架构(编码器-解码器+跳跃连接),判别器使用PatchGAN(判断图像局部块的真假,而不是整张图像)。Pix2Pix还使用L1损失作为辅助损失,保证生成图像和目标图像的内容一致。
CycleGAN:无配对数据的图像翻译
很多时候没有配对数据(很难找到完全对应的马和斑马的照片)。CycleGAN 通过**循环一致性损失(Cycle Consistency Loss)**实现无配对图像翻译。
CycleGAN有两个生成器和两个判别器:
- G A → B G_{A\to B} GA→B:将域A的图像转换为域B
- G B → A G_{B\to A} GB→A:将域B的图像转换为域A
- D A D_A DA:判别域A的图像是真实的还是生成的
- D B D_B DB:判别域B的图像是真实的还是生成的
循环一致性损失保证:把域A的图像转换到域B,再转换回域A,应该得到原始图像:
L c y c = E x ∼ A [ ∥ G B → A ( G A → B ( x ) ) − x ∥ 1 ] + E y ∼ B [ ∥ G A → B ( G B → A ( y ) ) − y ∥ 1 ] \mathcal{L}_{cyc} = \mathbb{E}_{x \sim A}[\|G_{B\to A}(G_{A\to B}(x)) - x\|_1] + \mathbb{E}_{y \sim B}[\|G_{A\to B}(G_{B\to A}(y)) - y\|_1] Lcyc=Ex∼A[∥GB→A(GA→B(x))−x∥1]+Ey∼B[∥GA→B(GB→A(y))−y∥1]
CycleGAN在无配对图像翻译上取得了惊人的效果,马→斑马、夏天→冬天、莫奈风格→照片等转换都非常成功。
其他图像翻译方法
- StarGAN:单一模型实现多域图像翻译(如人脸属性编辑)。
- MUNIT / DRIT:解耦内容和风格,实现多样化的图像翻译。
- SPADE:用语义分割图控制生成,实现高分辨率图像翻译。
15.6 StyleGAN
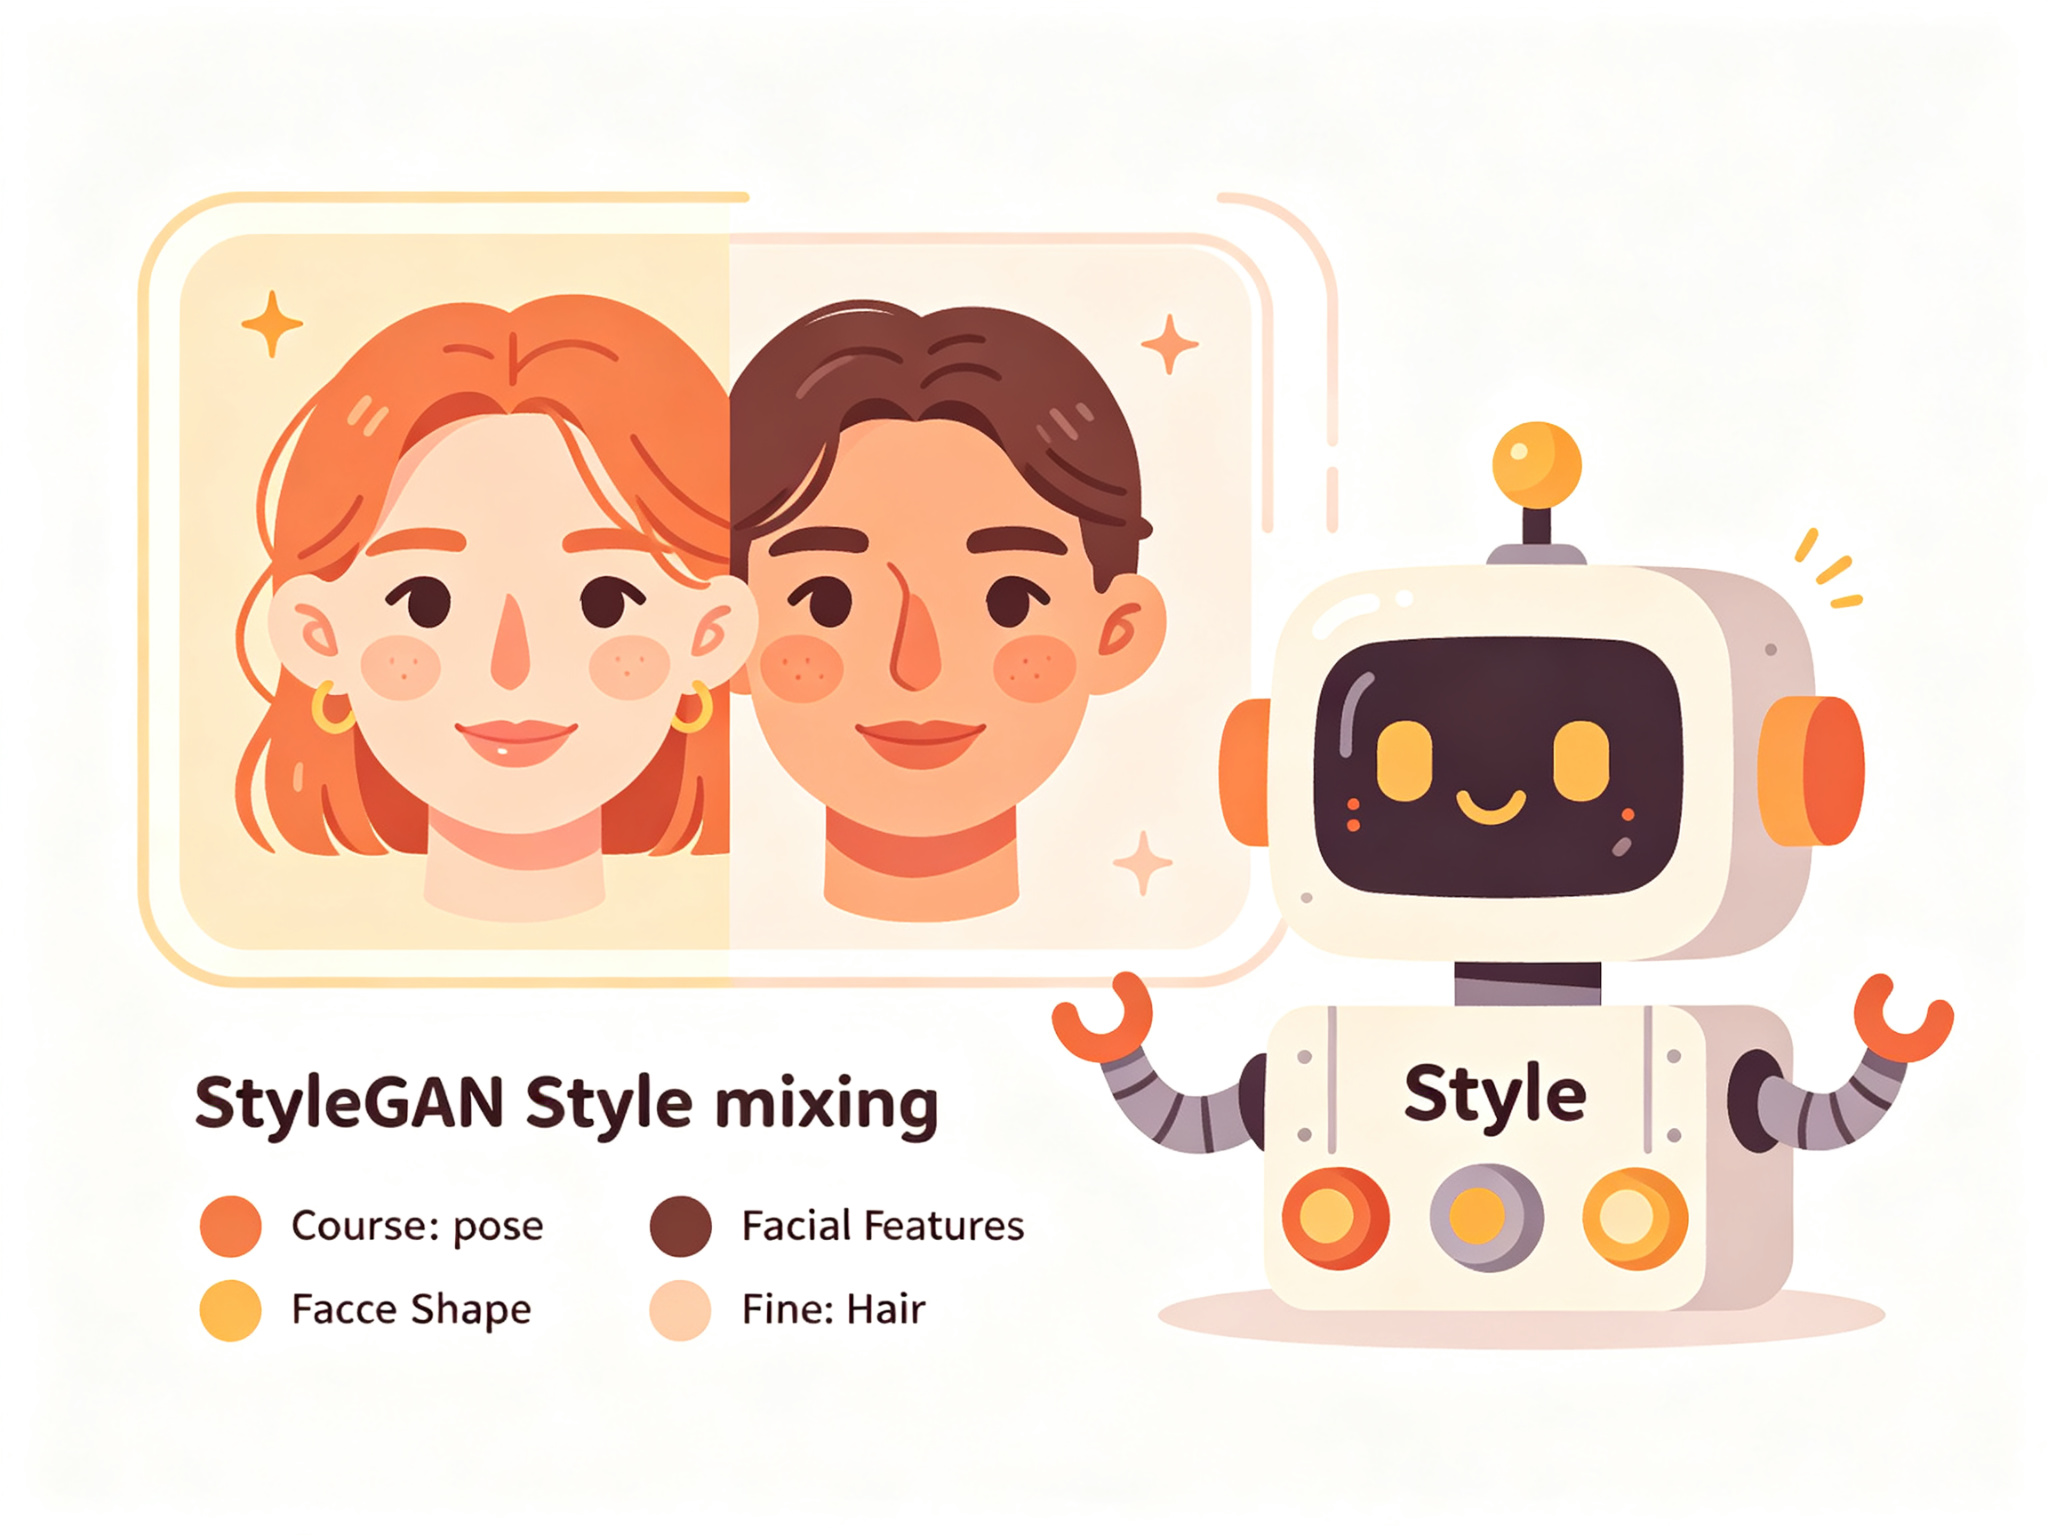
StyleGAN 是NVIDIA在2018年提出的GAN架构,是GAN技术的巅峰之作,能生成极其逼真的高分辨率人脸图像(1024×1024)。StyleGAN引入了多个创新设计:
1. 映射网络(Mapping Network)
传统GAN直接把噪声 z z z 输入生成器。StyleGAN先用一个8层的MLP(映射网络)把 z z z 映射为中间隐向量 w w w,然后用 w w w 控制生成器的风格。映射网络让隐空间更加解耦和线性,使得隐空间中的插值和编辑更有意义。
2. 自适应实例归一化(AdaIN)
StyleGAN用AdaIN(Adaptive Instance Normalization) 代替传统的条件批量归一化,把风格向量 w w w 注入生成器的每一层:
AdaIN ( x i , w ) = y s , i x i − μ ( x i ) σ ( x i ) + y b , i \text{AdaIN}(x_i, w) = y_{s,i} \frac{x_i - \mu(x_i)}{\sigma(x_i)} + y_{b,i} AdaIN(xi,w)=ys,iσ(xi)xi−μ(xi)+yb,i
其中 y s y_s ys 和 y b y_b yb 是从 w w w 学习到的缩放和平移参数。AdaIN让每一层都能独立控制风格,实现了精细的风格控制。
3. 风格混合(Style Mixing)
StyleGAN在训练时随机使用两个不同的噪声 z 1 , z 2 z_1, z_2 z1,z2 生成两个风格向量 w 1 , w 2 w_1, w_2 w1,w2,生成器的低层用 w 1 w_1 w1(控制 coarse 风格:姿态、脸型),高层用 w 2 w_2 w2(控制 fine 风格:发型、肤色)。这种风格混合正则化防止了网络假设所有风格都是相关的,提高了生成的多样性和质量。
4. 噪声输入
StyleGAN在生成器的每一层都注入随机噪声,让生成的图像有随机的细节变化(如头发丝、皮肤纹理、雀斑位置)。噪声只影响细节,不影响整体结构和身份。
5. 渐进式增长
StyleGAN继承了ProGAN的渐进式增长训练,从低分辨率逐步增加到高分辨率,保证训练稳定。
StyleGAN的后续版本
- StyleGAN2:改进了AdaIN(改为weight demodulation),消除了生成图像中的"水滴"伪影,进一步提高了质量和稳定性。
- StyleGAN3:解决了生成图像的纹理粘连问题(视频中人脸特征不随头部运动而移动),实现了真正的平移等变性。
- StyleGAN-XL:将StyleGAN扩展到ImageNet全类别生成,取得了SOTA结果。
StyleGAN的应用
- 高保真人脸生成和编辑
- 虚拟人/数字人创建
- 艺术创作
- 数据增强
- 隐空间编辑(年龄、性别、表情等属性的连续编辑)
15.7 本章小结
本章我们系统学习了生成式对抗网络。核心要点如下:
-
GAN由生成器和判别器组成,通过对抗博弈训练:生成器生成以假乱真的样本,判别器区分真实和生成,两者交替训练,共同进步。
-
GAN的训练目标是极小极大博弈,最优解是生成分布等于真实分布,此时判别器输出0.5。实践中使用非饱和损失加速生成器训练。
-
GAN训练不稳定是核心挑战:常见问题包括模式崩溃、判别器/生成器过强、训练震荡。WGAN用Wasserstein距离代替JS散度,WGAN-GP用梯度惩罚满足Lipschitz约束,谱归一化是更优雅的约束方法。
-
提升生成质量的方法包括:渐进式增长(ProGAN)、自注意力(SAGAN)、大规模训练(BigGAN)、条件批量归一化、截断技巧等。
-
条件GAN通过额外输入条件信息控制生成内容:条件注入方式包括拼接、条件批量归一化、投影。应用包括文本到图像、类别条件生成、图像翻译等。
-
图像翻译将一种域的图像转换为另一种域:Pix2Pix适用于有配对数据,使用U-Net+PatchGAN+L1损失;CycleGAN适用于无配对数据,使用循环一致性损失。
-
StyleGAN是GAN的巅峰之作:引入映射网络、AdaIN风格注入、风格混合正则化、逐层噪声输入、渐进式增长等创新,能生成极其逼真的高分辨率人脸。StyleGAN2/3/XL持续改进。
-
GAN vs 扩散模型:GAN推理速度快(一次前向传播),但训练不稳定、模式崩溃风险;扩散模型训练稳定、生成质量高,但推理慢(需要逐步去噪)。两者各有优势,在不同场景中使用。
代码实验结果
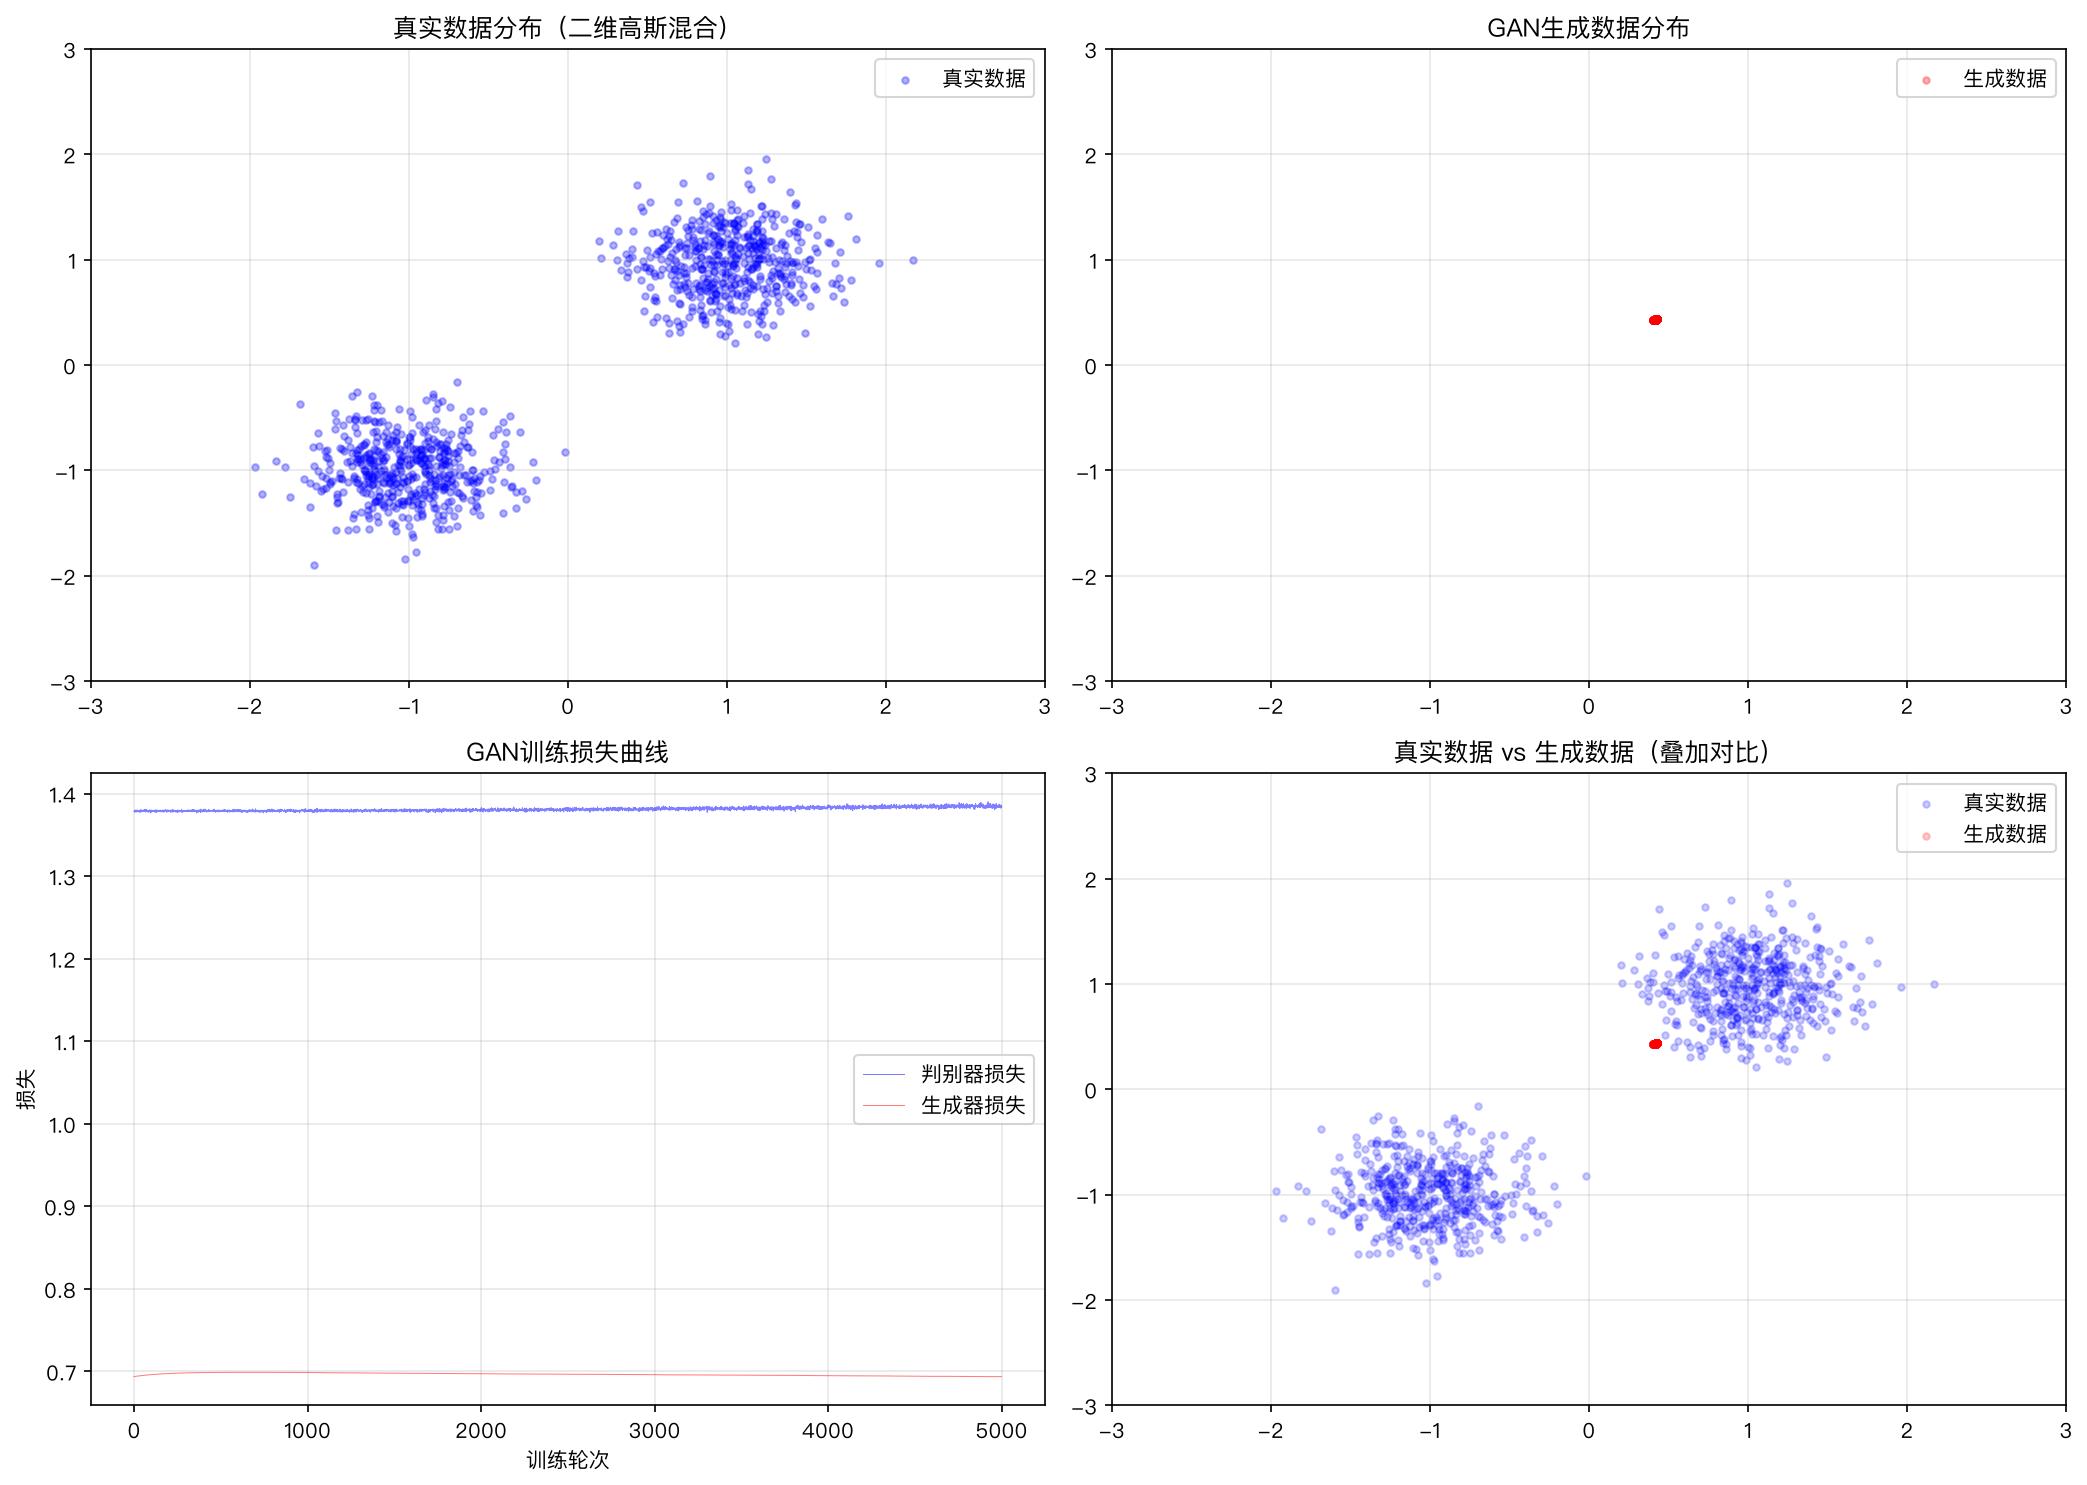
我们编写了完整的Python代码,从零实现了一个简单的GAN(生成器+判别器,都是2层全连接网络),在二维高斯混合分布上训练。以下是真实运行结果。
实验设置
- 生成器:2→16→2(噪声→2D数据)
- 判别器:2→16→1(2D数据→真实/假)
- 真实数据:二维高斯混合(两个分量,分别在(1,1)和(-1,-1))
- 训练轮次:5000,批次大小64
- 学习率:生成器0.01,判别器0.01
训练过程
Epoch 1000: D_loss=1.3795, G_loss=0.6987, D(real)=0.5007, D(fake)=0.4972
Epoch 2000: D_loss=1.3796, G_loss=0.6973, D(real)=0.5015, D(fake)=0.4979
Epoch 3000: D_loss=1.3828, G_loss=0.6961, D(real)=0.5005, D(fake)=0.4985
Epoch 4000: D_loss=1.3829, G_loss=0.6950, D(real)=0.5012, D(fake)=0.4991
Epoch 5000: D_loss=1.3832, G_loss=0.6938, D(real)=0.5016, D(fake)=0.4997
生成结果评估
真实数据均值: [-0.0014, -0.0064]
生成数据均值: [0.4199, 0.4335]
真实数据方差: [1.1213, 1.0488]
生成数据方差: [0.000026, 0.000007]
均值差异: 0.4306
方差差异: 1.0850
结果可视化
结果分析
-
典型的GAN训练失败案例:这个简化的GAN没有成功学到真实分布。判别器输出D(real)≈0.50、D(fake)≈0.50,说明判别器完全没有学到区分真实和生成的能力——两个网络都没有有效学习。
-
模式崩溃(Mode Collapse):生成数据的方差极小(2.6e-5和6.8e-6),说明生成器输出几乎坍缩到一个点——这是典型的模式崩溃。生成器只生成了一种"模式"(一个点),完全没有覆盖真实分布的两个高斯分量。
-
训练不稳定的原因:这个简化GAN训练失败的原因包括:(1)网络太简单(只有2层16个隐藏单元,表达能力不足);(2)学习率可能不合适;(3)没有使用批量归一化、谱归一化等稳定训练的技巧;(4)没有使用WGAN-GP等改进的损失函数。这正好说明了本章讨论的"GAN训练不稳定"问题——原始GAN确实很难训练。
-
判别器和生成器的平衡:理想情况下,判别器应该有一定的判别能力(D(real)高、D(fake)低),为生成器提供有意义的梯度。但在这个实验中,判别器输出接近0.5,说明它没有学到任何东西,生成器也得不到有效的梯度信号,两个网络都停滞了。
-
改进方向:要让这个GAN成功训练,可以:(1)使用更大的网络(更多层、更多隐藏单元);(2)使用批量归一化;(3)使用Adam优化器( β 1 = 0.5 \beta_1=0.5 β1=0.5)和更小的学习率(0.0002);(4)使用WGAN-GP损失;(5)使用谱归一化。这些都是本章讨论的提高GAN稳定性的方法。
-
教育意义:虽然这个实验没有成功生成高质量样本,但它生动地展示了GAN训练的困难性——这正是本章15.2节"提高稳定性"要讨论的核心问题。理解GAN为什么会失败,和理解GAN为什么会成功同样重要。
本章核心总结
一句话概括:GAN通过生成器和判别器的对抗博弈学习生成,训练不稳定是核心挑战,WGAN/谱归一化等方法提高稳定性,StyleGAN是GAN的巅峰之作,能生成极其逼真的高分辨率图像。
GAN核心公式清单:
| 概念 | 公式 |
|---|---|
| 极小极大目标 | min G max D V = E [ log D ( x ) ] + E [ log ( 1 − D ( G ( z ) ) ) ] \min_G \max_D V = \mathbb{E}[\log D(x)] + \mathbb{E}[\log(1-D(G(z)))] minGmaxDV=E[logD(x)]+E[log(1−D(G(z)))] |
| 非饱和生成器损失 | L G = − E [ log D ( G ( z ) ) ] \mathcal{L}_G = -\mathbb{E}[\log D(G(z))] LG=−E[logD(G(z))] |
| WGAN-GP梯度惩罚 | L G P = λ E [ ( ∣ ∇ D ( x ^ ) ∣ 2 − 1 ) 2 ] \mathcal{L}_{GP} = \lambda \mathbb{E}[(|\nabla D(\hat{x})|_2 - 1)^2] LGP=λE[(∣∇D(x^)∣2−1)2] |
| 循环一致性损失 | L c y c = E [ ∣ G B → A ( G A → B ( x ) ) − x ∣ 1 ] + … \mathcal{L}_{cyc} = \mathbb{E}[|G_{B\to A}(G_{A\to B}(x))-x|_1] + \ldots Lcyc=E[∣GB→A(GA→B(x))−x∣1]+… |
| AdaIN | AdaIN ( x , w ) = y s x − μ ( x ) σ ( x ) + y b \text{AdaIN}(x,w) = y_s \frac{x-\mu(x)}{\sigma(x)} + y_b AdaIN(x,w)=ysσ(x)x−μ(x)+yb |
结语
本章我们系统学习了生成式对抗网络。从"判别作为信号"的核心思想,到极小极大博弈的数学框架,再到训练稳定性问题及WGAN/WGAN-GP/谱归一化等改进方法,然后学习了提升生成质量的技术、条件生成、图像翻译(Pix2Pix/CycleGAN),最后深入学习了StyleGAN这一GAN的巅峰之作。GAN虽然训练不稳定,但它开创了生成模型的新时代,在图像生成、图像翻译、人脸编辑等领域取得了惊人的成果。
GAN的一个核心问题是训练不稳定、模式崩溃,而且GAN不显式定义数据的似然函数,难以评估和比较。下一章我们将学习另一种生成模型——标准化流(Normalizing Flows)。标准化流通过可逆变换将简单分布映射到数据分布,可以精确计算似然函数,训练稳定,没有模式崩溃问题。标准化流在密度估计、生成建模等领域有独特优势。
下一章见!
更多推荐

 2
 0
- 0


 已为社区贡献43条内容

所有评论(0)