
人大:像Adam一样自进化Agent技能
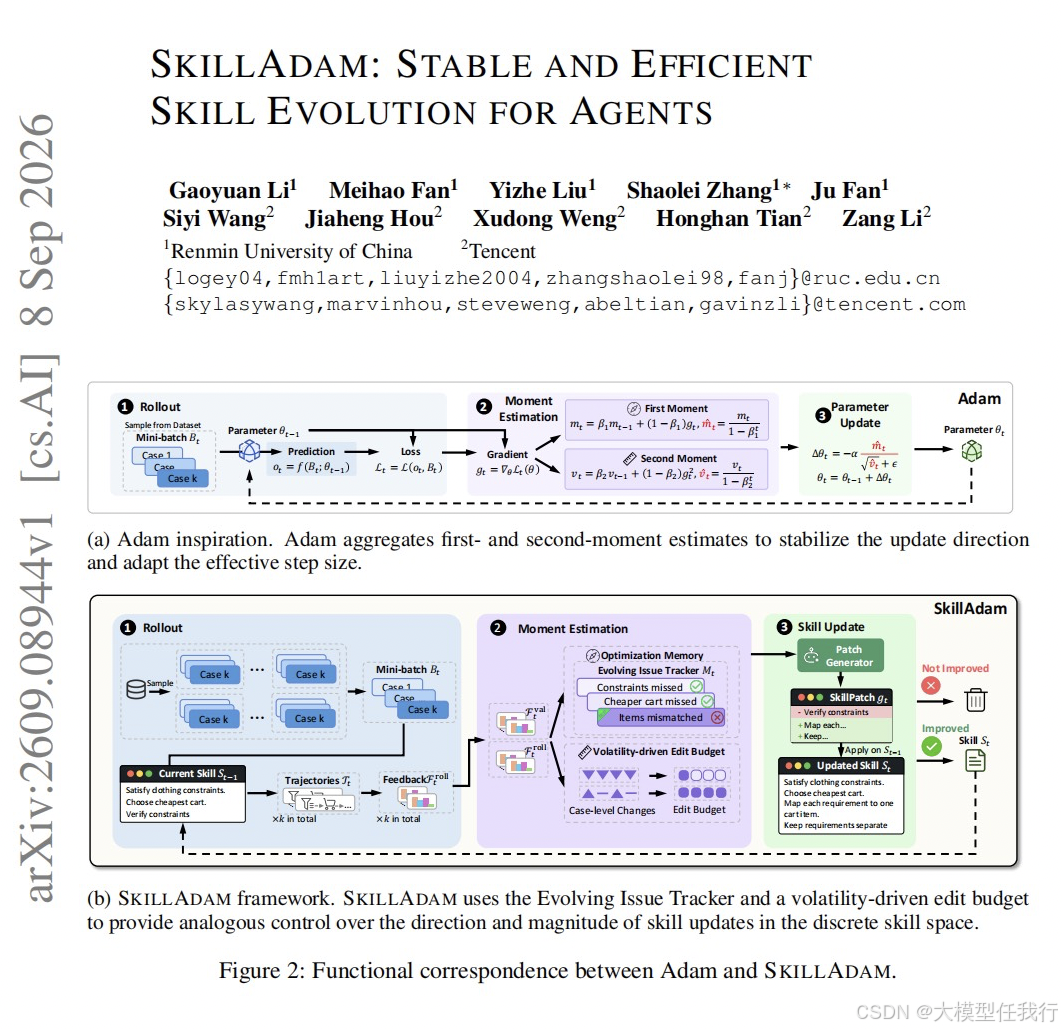
📖标题:SkillAdam: Stable and Efficient Skill Evolution for Agents
🌐来源:arXiv, 2609.08944v1
🛎️文章简介
🔸研究问题:现有的Agent技能自进化方法在迭代更新时,往往因为缺乏对历史经验的积累和对修改幅度的控制,导致优化过程不稳定且效率低下,如何像深度学习中的梯度下降一样稳定、高效地自动优化离散的技能文档?
🔸主要贡献:论文提出了SKILLADAM框架,借鉴Adam优化器的思想,通过引入“优化记忆”和“波动驱动的编辑预算”,实现了更稳定、更少迭代次数且更低成本的Agent技能自进化。
📝重点思路
🔸轨迹感知的初始化:首先利用执行轨迹及其评估反馈构建初始技能,为后续优化提供良好的起点,避免从零开始的盲目探索。
🔸优化记忆(类比Adam一阶矩):设计了一个“演化问题追踪器”,记录识别出的问题、当前状态以及过往解决方案的结果。这使得每次更新都能结合当前反馈和历史证据,防止新修改覆盖之前有效的修正,从而稳定优化方向。
🔸波动驱动的编辑预算(类比Adam二阶矩):通过追踪近期案例级改进的波动情况来动态调整允许修改的范围。如果近期改进不一致(波动大),则限制修改幅度以防破坏已有成果;如果改进一致,则允许更大范围的修改,从而自适应地控制更新步长。
🔸基于LLM的技能更新与接受机制:利用上述两个组件指导LLM生成技能补丁,并通过严格的接受门控决定是否应用新技能,确保只有真正提升性能的修改才会被保留。
🔎分析总结
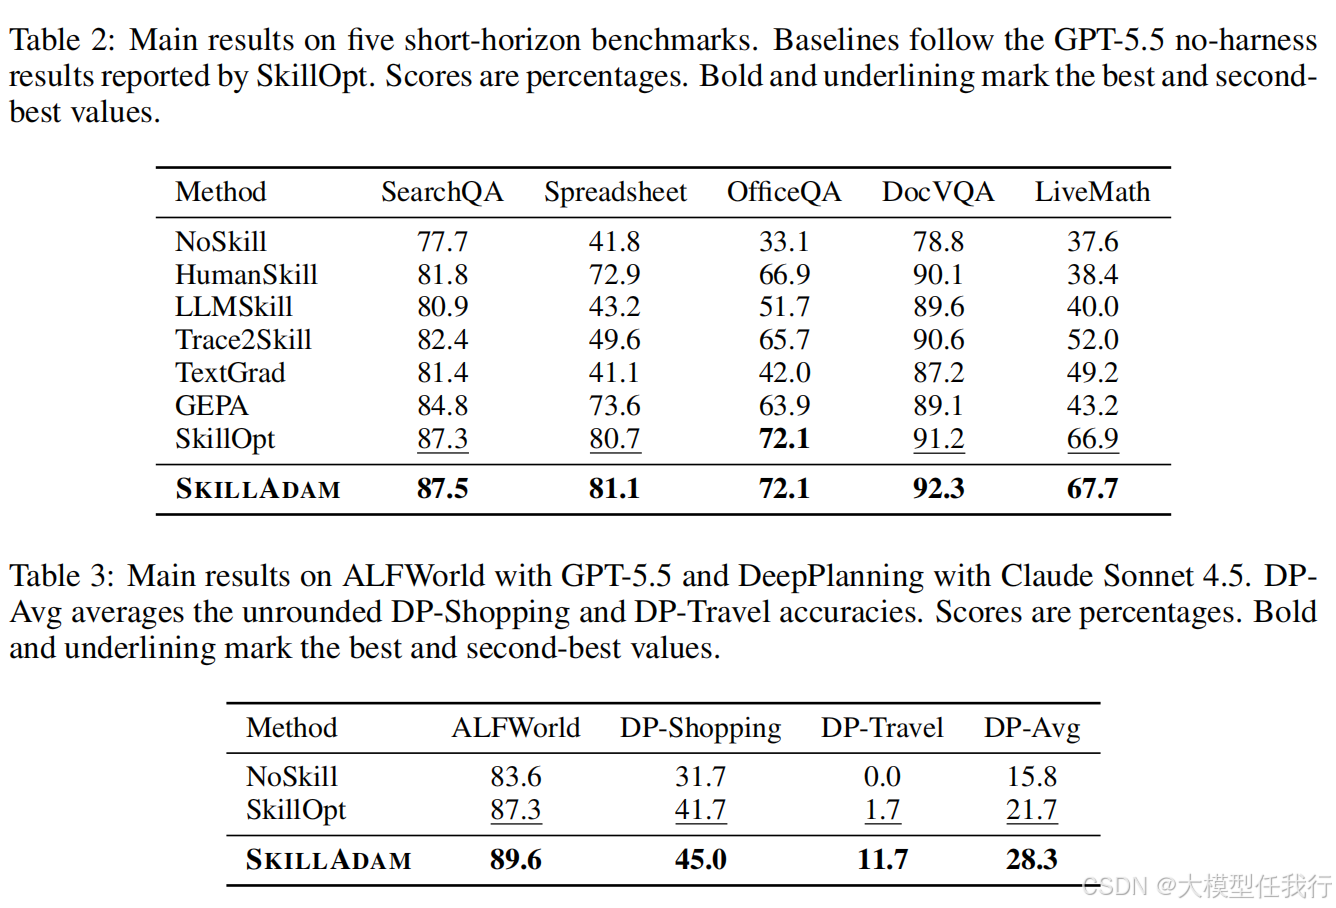
🔸性能优越:在七个涵盖短程和长程任务的基准测试中,SKILLADAM取得了最先进的性能,特别是在复杂的长程规划任务(如DeepPlanning)上,相比基线方法有显著提升。
🔸效率极高:相比现有的SOTA方法SkillOpt,SKILLADAM所需的优化迭代次数大幅减少,总Token消耗降低了约67%,API请求减少了约69%,实现了更高的优化效率。
🔸稳定性强:消融实验证明,移除优化记忆或编辑预算都会导致性能下降,尤其是在长程任务中,这两个组件共同作用保证了优化路径的平稳上升,避免了性能的剧烈波动。
🔸泛化性好:在不同模型骨干之间进行技能迁移时,SKILLADAM生成的技能保留了更多的源模型性能,说明其生成的技能更具通用性和鲁棒性。
💡个人观点
论文将连续空间优化算法(Adam)映射到了离散的自然语言技能优化问题上,引入了“记忆”来维持方向一致性,引入“波动监控”来控制修改节奏。
更多推荐

 3
 0
- 0


 已为社区贡献59条内容

所有评论(0)