一文搞懂RAG调优!保姆级系统实践教程(非常详细)!
RAG(检索增强生成)系统实践与调优
在人工智能领域,检索增强生成(Retrieval Augmented Generation, RAG)是一种结合信息检索和生成式人工智能的技术,它通过从外部数据源中检索相关信息,来辅助大语言模型(Large Language Model, LLM)生成更为准确、上下文相关的答案。
一、 什么是RAG
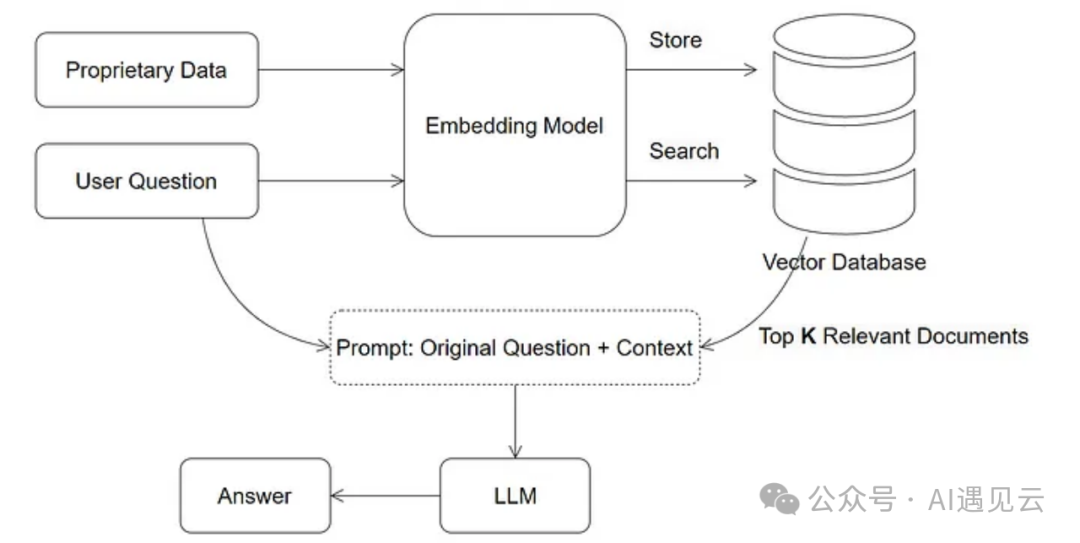
检索增强生成(Retrieval Augmented Generation, RAG)是一种结合信息检索和生成式人工智能的技术,它通过从外部数据源中检索相关信息,来辅助大语言模型(Large Language Model, LLM)生成更为准确、上下文相关的答案。具体来说,RAG 的工作流程包括两个关键步骤:首先,系统会根据用户的查询从预先构建的数据源中检索相关的文档或片段;然后,将这些检索到的内容作为上下文信息,和用户的问题一起输入到大语言模型中,以生成更丰富、更具参考价值的回答。RAG系统结合了搜索技术和大语言模型的生成能力:搜索技术用于找到与问题最相关的事实或数据,而大语言模型则通过处理这些信息,生成连贯、准确且更符合用户需求的自然语言回答。因此,RAG 不仅能够弥补语言模型在训练数据之外的知识盲区,还可以显著提升回答的精准性和可靠性,特别是在需要实时更新或扩展知识的应用场景中。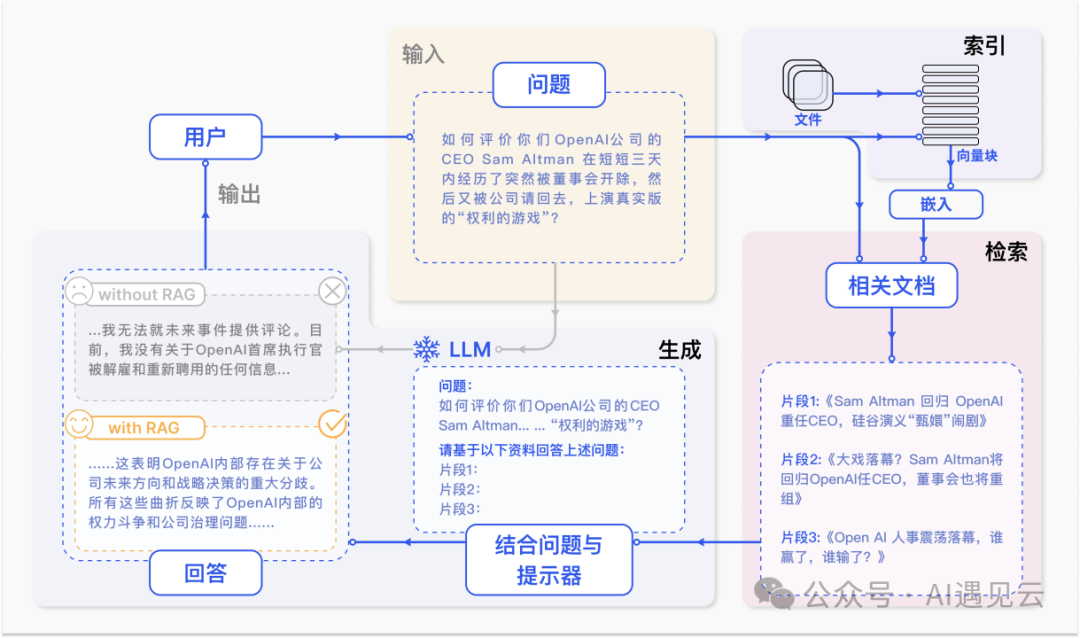
RAG 的工作流程主要包含三个模块:
索引(Indexing):文本索引的构建包括以下步骤:文档解析、文本分块、Embedding 向量化和创建索引。先将不同格式的原始文件解析转换为纯文本,再把文本切分成较小的文本块。通过 Embedding 为每一个文本块生成一个向量表示,用于计算文本向量和问题向量之间的相似度。创建索引将原始文本块和 Embedding 向量以键值对的形式存储,以便将来进行快速和频繁的搜索。
检索(Retrieval):使用 Embedding 模型将用户输入问题转换为向量,计算问题的 Embedding 向量和语料库中文本块 Embedding 向量之间的相似度,选择相似度最高的前 K 个文档块作为当前问题的增强上下文信息。
生成(Generation):将检索得到的前 K 个文本块和用户问题一起送进大模型,让大模型基于给定的文本块来回答用户的问题。
二、 RAG实践
下面是一个使用Xinference 部署bge-embedding 模型并结合Langchain 实现简单的 RAG(检索增强生成)应用的实践步骤:
- 使用 Xinference部署bge-embedding模型
bge-embedding 模型(bge-m3-embedding)可以通过Xinference部署,具体步骤如下:
1.1 安装Xinference
| JSON pip install --upgrade --quiet “xinference[all]” |
1.2 启动bge-embedding模型
| JSON xinference launch --model-name bge-m3 --model-type embedding |
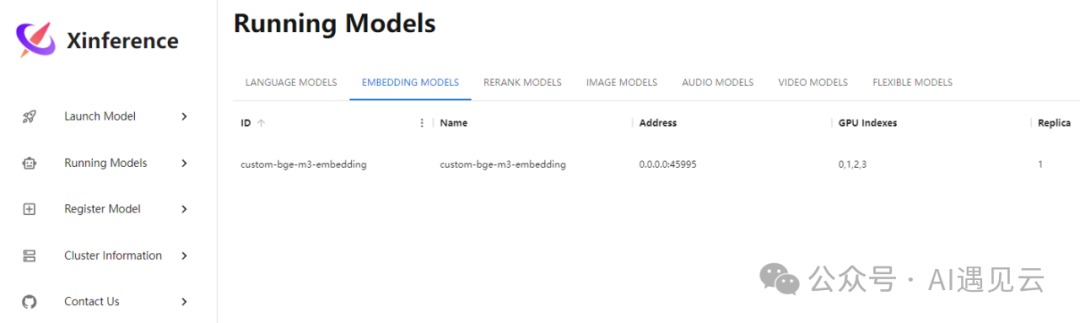
启动后可通过xinference webui查看running model
- 在 LangChain中集成bge-embedding模型和LLM
2.1 安装LangChain
| JSON pip install langchain |
2.2集成远端bge-embedding 模型
LangChain提供了对嵌入模型的抽象,可以创建一个自定义的嵌入模型类来调用远端的bge-embedding 服务。
| Python import requests from langchain.embeddings.base import Embeddings class RemoteBGEEmbedding(Embeddings): def __init__(self, api_url): self.api_url = api_url def embed(self, text: str): response = requests.post(self.api_url, json={“text”: text}) if response.status_code == 200: return response.json()[“embedding”] else: raise Exception(f"Failed to get embedding: {response.content}") |
api_url 在远端部署的bge-embedding 模型的 API地址。
调用POST 请求,将文本传递给远端的bge-embedding 模型,获取对应的嵌入向量。
2.3 调用远端LLM,此处采用QWEN14B
同理,LLM也需要集成
| Python class RemoteQwenLLM: def __init__(self, api_url): self.api_url = api_url def generate(self, prompt: str): response = requests.post(self.api_url, json={“prompt”: prompt}) if response.status_code == 200: return response.json()[“response”] else: raise Exception(f"Failed to get response: {response.content}") |
api_url 是远端 LLM生成API地址。
3.构建 RAG管道
使用 LangChain的RetrievalAugmentedGeneration 类来集成上述两个模型,实现检索增强生成:
| Python from langchain.chains import RetrievalAugmentedGeneration from langchain.vectorstores import FAISS from langchain.document_loaders import TextLoader # 初始化远端的 bge-embedding 嵌入模型 bge_embedding = RemoteBGEEmbedding(api_url=“http://your-bge-embedding-server.com/embedding”) # 加载文档数据并创建向量存储 loader = TextLoader(“path/to/your/data.txt”) # 替换为你的文档路径 documents = loader.load() vector_store = FAISS.from_documents(documents, bge_embedding) # 初始化远端的 Qwen 生成模型 qwen_llm = RemoteQwenLLM(api_url=“http://your-qwen-server.com/generate”) # 创建 RAG 管道 rag_chain = RetrievalAugmentedGeneration( llm=qwen_llm, # 使用远程 Qwen 模型 retriever=vector_store.as_retriever(), input_key=“input”, output_key=“output” ) |
4.执行RAG应用
| Python # 测试 RAG 流程 query = “中国的历史发展是怎样的?” result = rag_chain.run(query) print(result) |
三、 调优和进阶技术
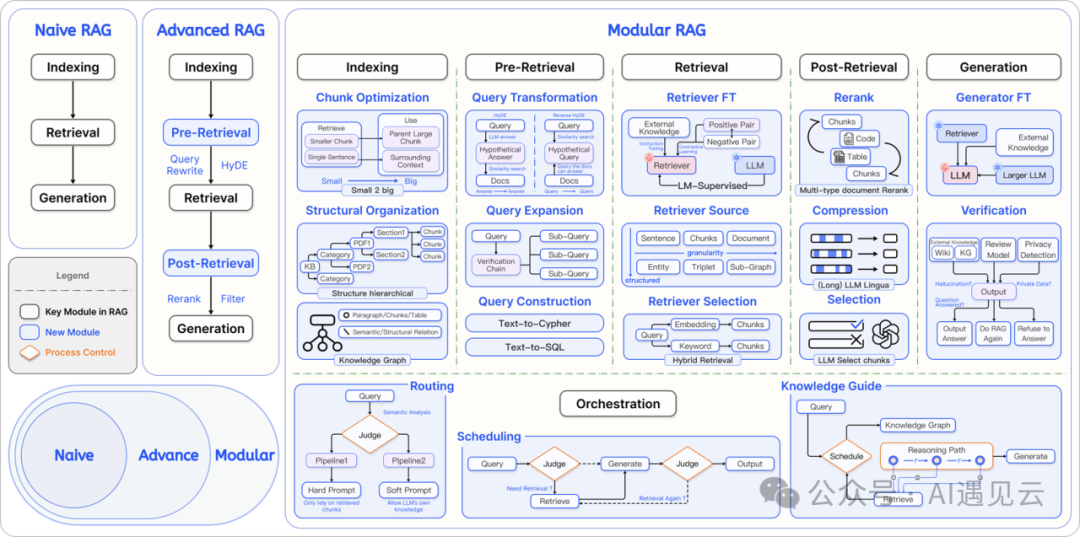
随着技术的发展,RAG系统经历了几个阶段的演变,包括Naive RAG、Advanced RAG和Modular RAG。Naive RAG是最基本的RAG实现,它通常只涉及简单的检索和生成步骤,没有太多复杂的优化。Advanced RAG在Naive RAG的基础上增加了更多的策略和优化,如索引优化、迭代检索和检索后处理,以提高系统的性能。Modular RAG则进一步发展,提供了更高的灵活性和可定制性,允许通过引入不同的模块和调整模块间的流程来适应各种复杂的任务和需求。在Modular RAG中,数据清洗、问题转换、多路召回和重排序和过滤等是一些有效的调优技术模块实现,下面是这些技术的介绍和说明。
1. 数据清洗
在RAG中,数据清洗至关重要,直接关系到了检索召回的效果,常用的数据清洗手段有低质量数据知识增强和非结构化数据处理。
(1)低质量数据知识增强
一般来说,对称召回任务比非对称召回任务要简单,特别在很多垂直领域,向量模型对领域知识的理解有限,对称召回很多时候理解了字面意思就能满足要求。为了方便描述,下文把对称召回称为 QQ(Query-Question)召回,把非对称召回称为QD(Query-Document)召回。
知识增强一般是指,根据上下文重新 Refine原始的文本使得原始的文本信息更完整,自解释性更强。这个过程由于是离线的一次性处理,所以这里可以借助能力更强的商用LLM模型,生成的内容可能会更好。另外由于现在的LLM能支撑的上下文context长度很长,建议在生成的过程中,在prompt中去融入一些该场景的丰富背景信息。具体过程如下图所示:
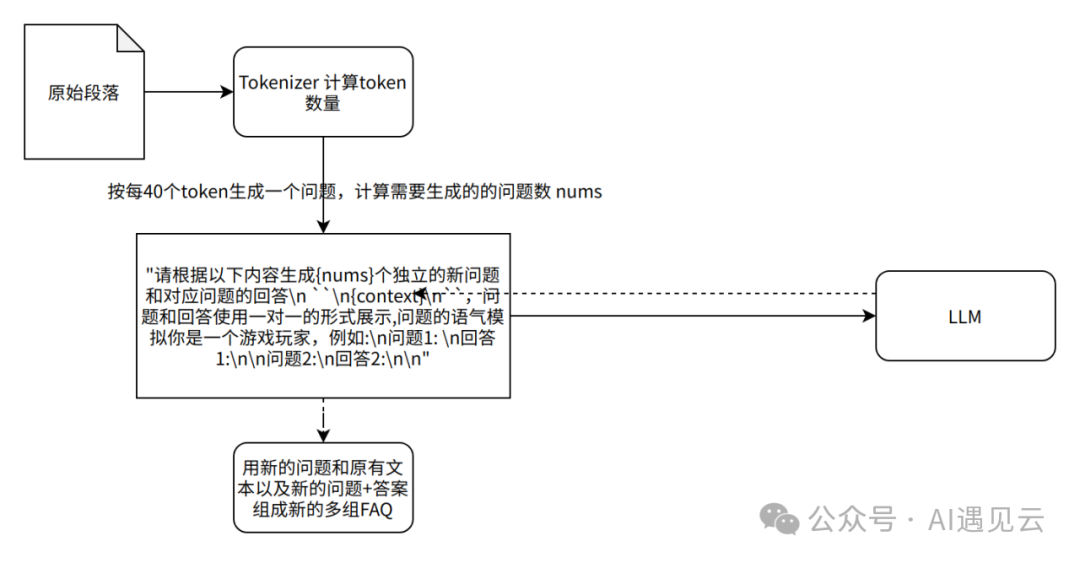
通过知识增强,可以把文本文档也转化成 FAQ的形式,使得对于一般的文档也能够同时进行QQ和QD召回。
(2)非结构化数据处理
在文档数据处理时,一些关键信息以非结构化数据,以下面的社保卡换领流程图为例
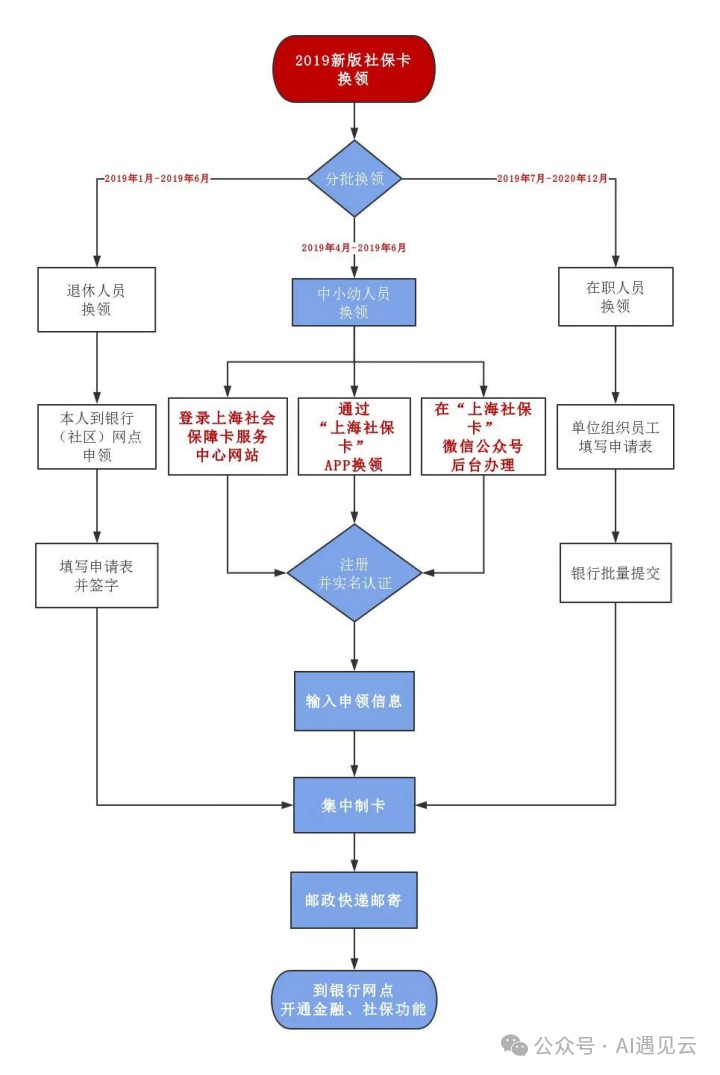
上面的关键信息为流程图,常用的文档解析方式无法处理,从而导致召回时无法检索到响应内容并回答,为了解决该问题,可通过LLM将流程图转markdown代码
| Plain Text graph TD A[2019新版社保卡换领] --> B{分批换领} B --> |
在召回时将上面的markdown代码给到LLM即可完成流程图相关内容的问答。
2. 问题转换
问题转换是 RAG系统中的一个重要步骤,尤其在面对复杂、多样化的用户问题时,能够对检索结果的质量产生深远影响。问题转换的核心思想是将用户输入的问题转化为适合检索的形式,以提高检索效率和准确性。常用方式有:
1.语义转换:很多用户提问时,可能会使用自然语言的表达,而这些表达未必最适合直接进行检索。问题转换模块通过分析问题的语义,将自然语言问题转换为适合关键词匹配或向量检索的形式。例如,将复杂问题分解为简单的子问题,或者提取出问题中的关键信息进行检索。
2.问题重构:对于多轮对话,问题转换模块可以结合之前的上下文,重构当前问题,使其在检索时更具连贯性。比如,如果当前问题是一个不完整的询问,问题转换模块会根据之前的对话历史补充必要的细节,以提升检索的精准度。
3.多模式转换:问题转换还可以针对不同类型的数据源(文本、图像、视频等)进行不同的处理。例如,针对多模态数据源的系统,问题转换模块需要将自然语言问题转化为对应模态的检索形式(如图像特征、视频片段等)。
以历史对话为例,通过输入用户与系统的多轮对话,目标是根据上下文重构问题,使其在检索时更具准确性。
对话上下文:
| JSON 用户:请告诉我任务管理的最佳实践。 系统:任务管理的最佳实践包括任务优先级排序、时间管理、团队协作等。你是否想了解某个具体的方面? 用户:好的,关于任务优先级。 |
原始问题:
用户当前的问题是**“关于任务优先级”**。这是一个不完整的自然语言问题,在没有上下文的情况下,这个问题可能不明确,检索系统可能无法理解用户的具体需求。
问题重写提示词:
| JSON ## 任务:根据用户和AI的历史对话内容进行总结。 ## 要求:- 使用专业且简洁的语言。- 将用户当前的问题重新表述为一个清晰、简洁且自包含的查询,适合信息检索使用。- 如果当前问题已经足够清晰和完整,请保持原样输出。 ## 示例:—### 历史信息:用户咨询了关于 Spring 动态 Bean 管理的技术问题,AI 提供了使用 ConcurrentHashMap 管理 Bean 的建议。### 当前问题:动态管理 Spring 的 Bean?### 总结:如何使用 ConcurrentHashMap 动态管理 Spring Bean? ## 历史信息:{{history_summary}} ## 当前问题:{{question}} |
重写后问题:
| JSON “任务管理的最佳实践中,如何有效进行任务优先级排序?” |
在多轮对话和复杂查询场景中,通过问题重写转换可以显著提升召回率。
3. 多路召回
多路召回(Multi-Channel Retrieval)是RAG系统中用于提升检索结果多样性和覆盖度的关键机制。通过使用不同的检索策略和通道,系统可以最大程度地覆盖问题相关的文档,确保生成的答案基于更全面的上下文信息。其中多路的概念可表示为对多个向量库进行检索,也可表示采用多种召回算法进行混合检索。
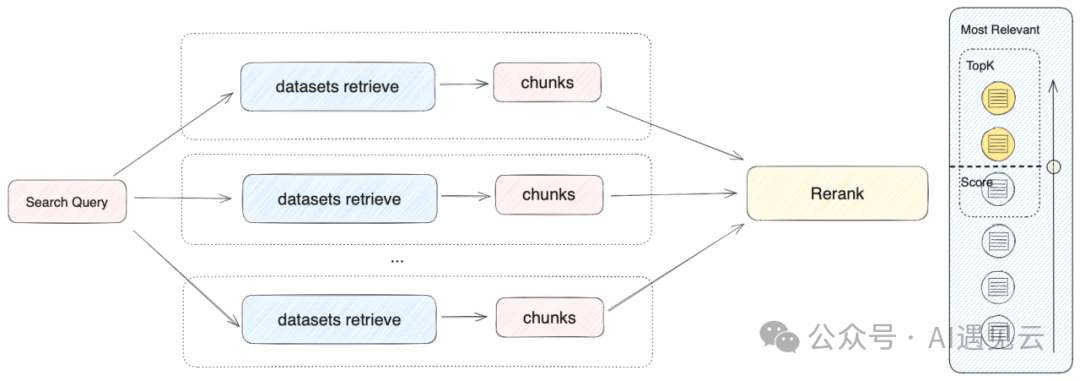
混合检索
向量检索和关键词检索在检索领域各有其优势。向量检索优势:复杂语义的文本查找,相近语义理解,多语言理解,多模态理解,容错性。传统关键词搜索优势:精确匹配,少量字符的匹配,倾向低频词汇的匹配。混合检索结合了向量检索和关键词检索的优势,通过多个检索系统的组合,实现了多个检索技术之间的互补。
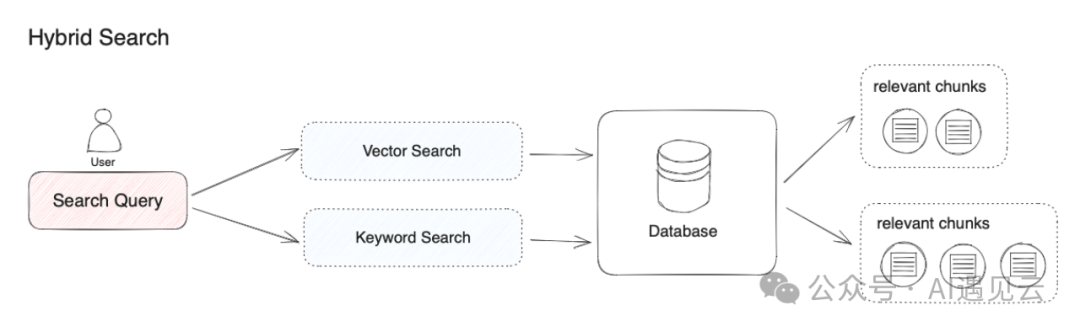
1.倒排召回:倒排索引是一种经典的关键词匹配方式,主要应用于基于传统文本搜索的场景,如使用 BM25等方法。倒排召回速度快,适合处理精确匹配场景。它基于词项的出现频率和文档倒排索引进行匹配,在面对具体的术语或关键词查询时效果尤为显著。
2.向量召回:向量召回基于语义嵌入,通过将文档和查询转换为向量表示,并在向量空间中计算它们的相似度来进行检索。向量召回特别适合处理模糊、语义相关性较强的问题,能够在概念上找到更具相关性的文档,即使这些文档没有包含查询中的具体关键词。
四、重排序和过滤
重排序在RAG过程中起着至关重要的作用。在简单的RAG方法中,可能会检索到大量上下文,但并非所有上下文都与问题相关。重新排序可以对文档进行重新排序和过滤,将相关文档放在最前面,从而提高RAG的效率。
(1)RRF多检索融合
RRF(Ranked Retrieval Fusion)是一种将多个检索系统的排名结果进行融合的方法,它能够综合不同检索方法的优点。将关键词检索(BM25等)和向量检索(基于嵌入的检索)结合在一起,可以提升检索的效果。RRF通常按照检索结果的排名进行分数计算,最终得出一个融合后的排名。
下面通过一个具体的检索结果例子展示关键词检索(BM25)和向量检索的结果如何结合RRF排序来得到最终的排序结果。
假设我们有以下五个文档D1~D5,并且进行两个不同的检索:
| 文档ID | 关键词检索(BM25)排名 | 向量检索(基于嵌入的语义相似度)排名 |
| D1 | 3 | 1 |
| D2 | 1 | 4 |
| D3 | 5 | 2 |
| D4 | 2 | 3 |
| D5 | 4 | 5 |
根据RRF公式分别计算D1~D5文档得分,
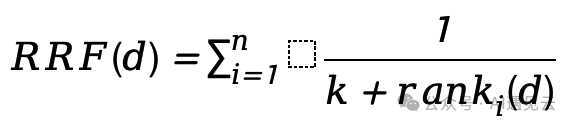
其中,k 为常数,通常选择k = 60,rank_i(d) 表示第 i种检索方法中文档d 的排名。
•文档D1:0.03226
•文档D2:0.03202
•文档D4:0.03200
•文档D3:0.03151
•文档D5:0.03101
根据RRF分数排序,最终的文档排名为:
1.D1(分数:0.03226)
2.D2(分数:0.03202)
3.D4(分数:0.03200)
4.D3(分数:0.03151)
5.D5(分数:0.03101)
(2)语义检索:相似≠相关
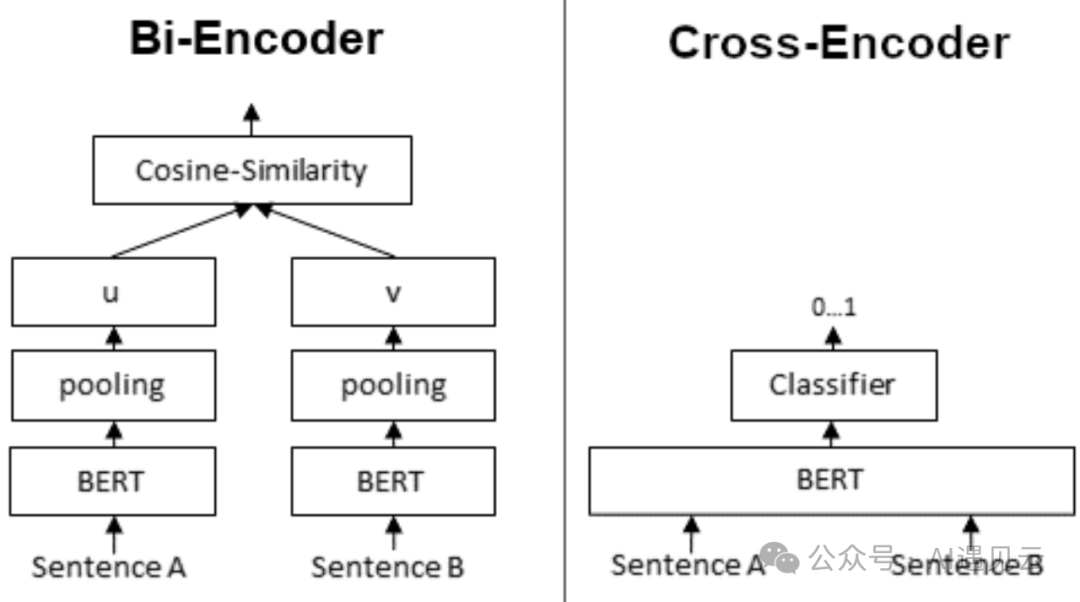
- Embedding(Bi-Encoder)双编码器
•结构:Bi-Encoder使用两个独立的编码器来处理查询(query)和文档(document),分别生成它们的嵌入表示(embeddings)。
Embedding模型根据查询(query)和文档(document)给出相似度得分,但是这个得分描述的更多的是相似性。Embedding本质上是一个双编码器,两个文本在模型内部没有任何信息交互。只在最后计算两个向量的余弦相似度时才进行唯一一次交互。
- Rerank(Cross-Encoder)交叉编码器
•结构:Cross-Encoder将查询和文档拼接在一起,作为一个整体输入到一个单一的编码器中。
Rerank本质是一个Cross-Encoder的模型。Cross-Encoder能让两个文本片段一开始就在BERT模型各层中通过self-attention进行交互。
采用两阶段检索结合可以兼顾效果和效率:
•第一个阶段的目标是尽可能多的召回相似的文本片段,这个阶段的文本得分排序不是特别靠谱,所以候选的 topK可以设置大一些,比如topK=10;
•第二个阶段的目标是对 10个粗排的候选文本片段进行重新排序,用cross-encoder计算10个候选文本和query的相关度得分。
如何学习大模型 AI ?
我国在AI大模型领域面临人才短缺,数量与质量均落后于发达国家。2023年,人才缺口已超百万,凸显培养不足。随着Al技术飞速发展,预计到2025年,这一缺口将急剧扩大至400万,严重制约我国Al产业的创新步伐。加强人才培养,优化教育体系,国际合作并进,是破解困局、推动AI发展的关键。
但是具体到个人,只能说是:
“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。
这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。
我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。
我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
2025最新大模型学习路线
明确的学习路线至关重要。它能指引新人起点、规划学习顺序、明确核心知识点。大模型领域涉及的知识点非常广泛,没有明确的学习路线可能会导致新人感到迷茫,不知道应该专注于哪些内容。
对于从来没有接触过AI大模型的同学,我帮大家准备了从零基础到精通学习成长路线图以及学习规划。可以说是最科学最系统的学习路线。
针对以上大模型的学习路线我们也整理了对应的学习视频教程,和配套的学习资料。
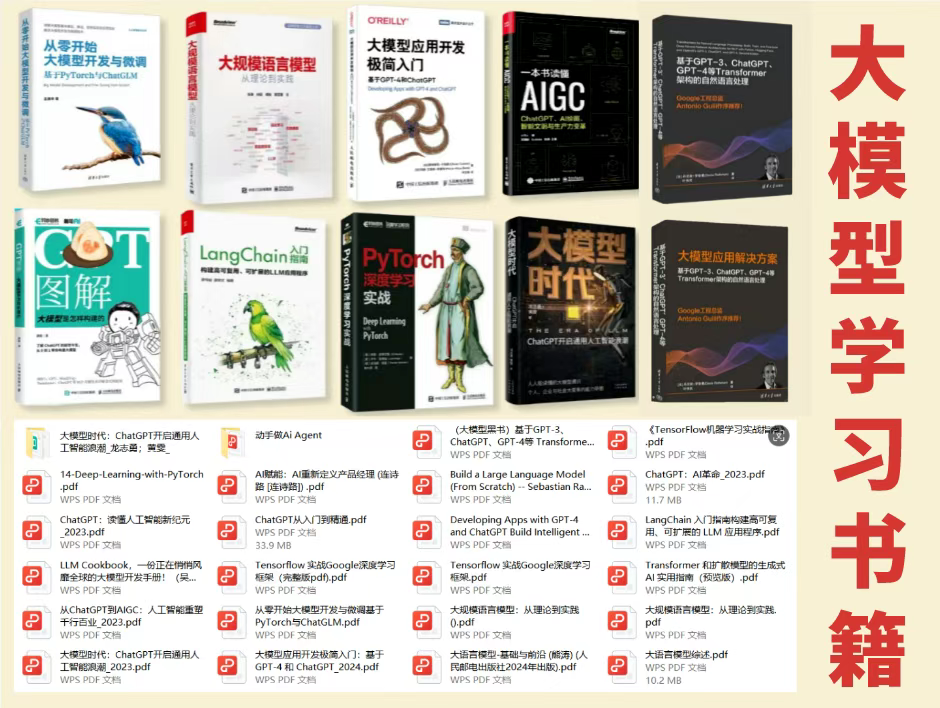
大模型经典PDF书籍
新手必备的大模型学习PDF书单来了!全是硬核知识,帮你少走弯路!
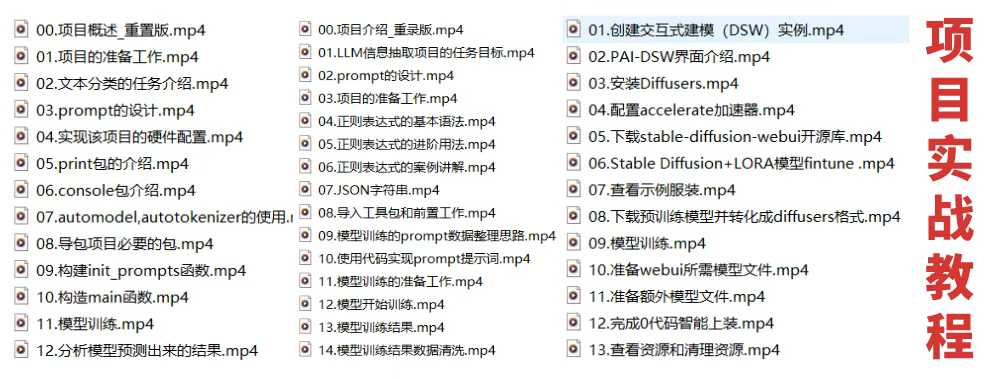
配套大模型项目实战
所有视频教程所涉及的实战项目和项目源码等
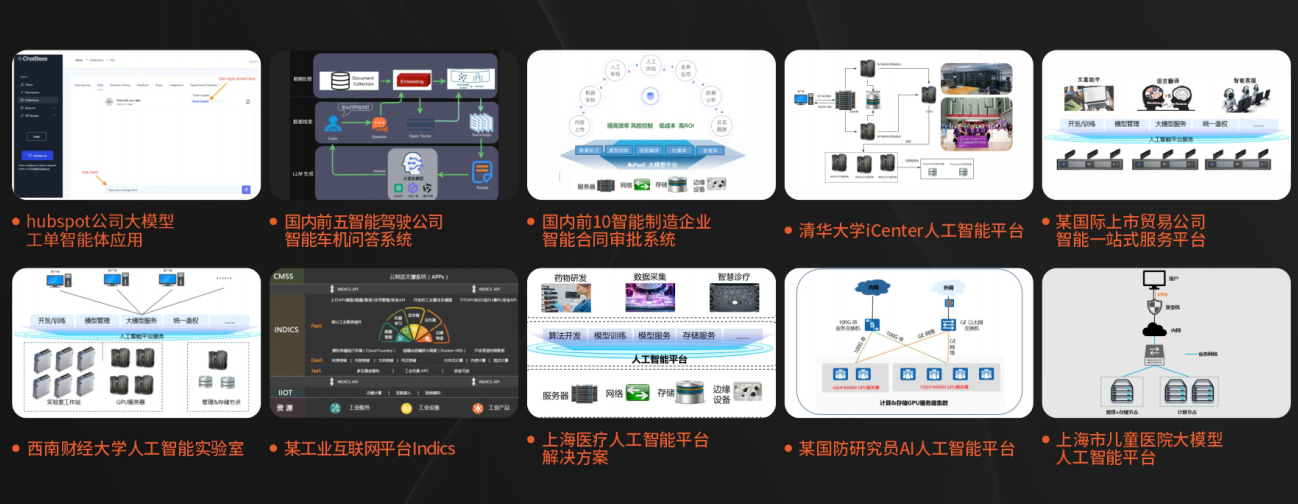
博主介绍+AI项目案例集锦
MoPaaS专注于Al技术能力建设与应用场景开发,与智学优课联合孵化,培养适合未来发展需求的技术性人才和应用型领袖。
这份完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】

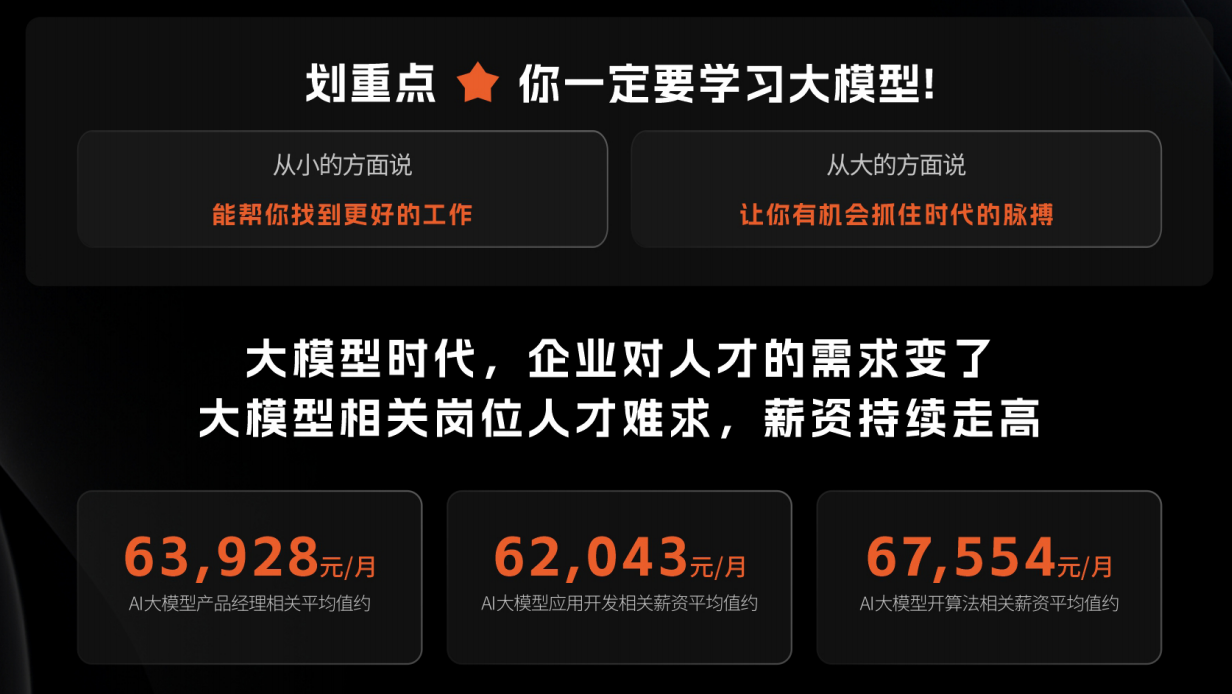
为什么要学习大模型?
2025人工智能大模型的技术岗位与能力培养随着人工智能技术的迅速发展和应用 , 大模型作为其中的重要组成部分 , 正逐渐成为推动人工智能发展的重要引擎 。大模型以其强大的数据处理和模式识别能力, 广泛应用于自然语言处理 、计算机视觉 、 智能推荐等领域 ,为各行各业带来了革命性的改变和机遇 。
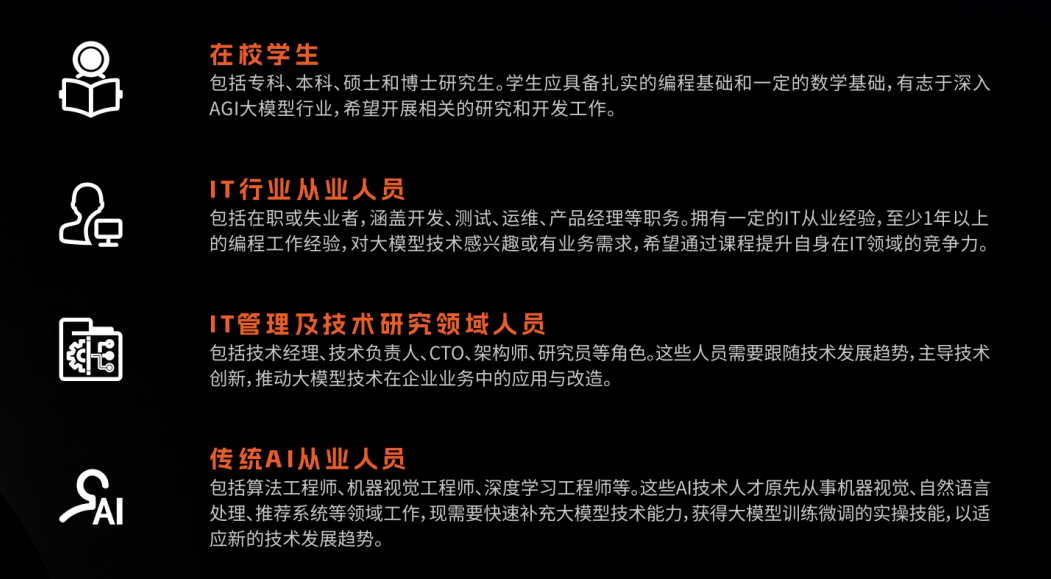
适合人群
- 在校学生:包括专科、本科、硕士和博士研究生。学生应具备扎实的编程基础和一定的数学基础,有志于深入AGI大模型行业,希望开展相关的研究和开发工作。
- IT行业从业人员:包括在职或失业者,涵盖开发、测试、运维、产品经理等职务。拥有一定的IT从业经验,至少1年以上的编程工作经验,对大模型技术感兴趣或有业务需求,希望通过课程提升自身在IT领域的竞争力。
- IT管理及技术研究领域人员:包括技术经理、技术负责人、CTO、架构师、研究员等角色。这些人员需要跟随技术发展趋势,主导技术创新,推动大模型技术在企业业务中的应用与改造。
- 传统AI从业人员:包括算法工程师、机器视觉工程师、深度学习工程师等。这些AI技术人才原先从事机器视觉、自然语言处理、推荐系统等领域工作,现需要快速补充大模型技术能力,获得大模型训练微调的实操技能,以适应新的技术发展趋势。
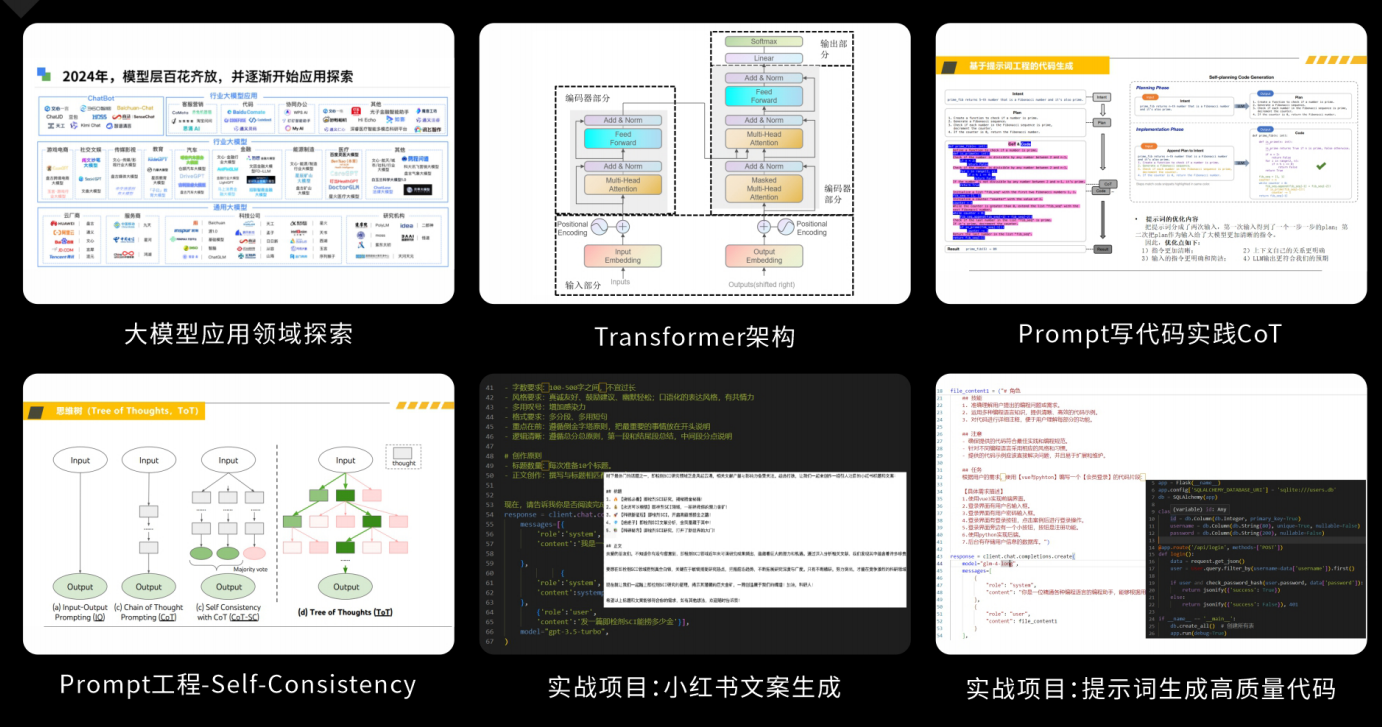
课程精彩瞬间
大模型核心原理与Prompt:掌握大语言模型的核心知识,了解行业应用与趋势;熟练Python编程,提升提示工程技能,为Al应用开发打下坚实基础。
RAG应用开发工程:掌握RAG应用开发全流程,理解前沿技术,提升商业化分析与优化能力,通过实战项目加深理解与应用。 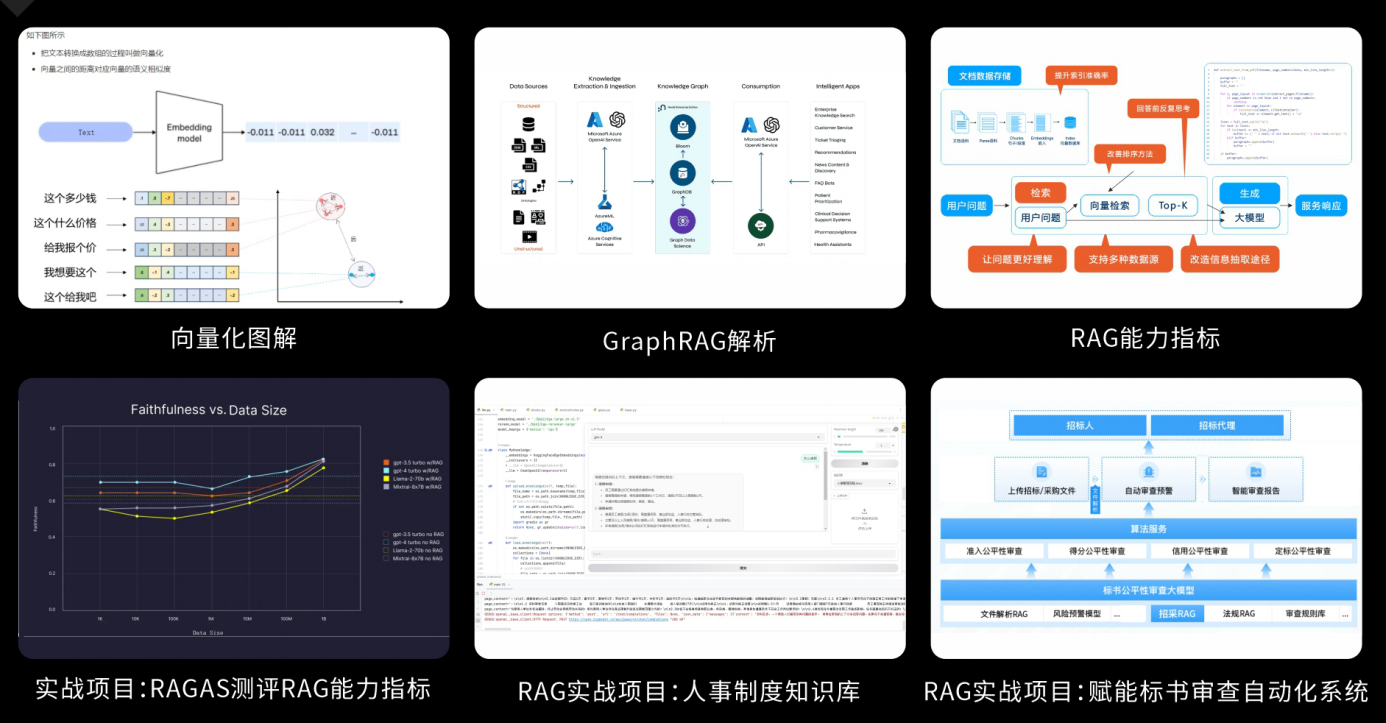
Agent应用架构进阶实践:掌握大模型Agent技术的核心原理与实践应用,能够独立完成Agent系统的设计与开发,提升多智能体协同与复杂任务处理的能力,为AI产品的创新与优化提供有力支持。
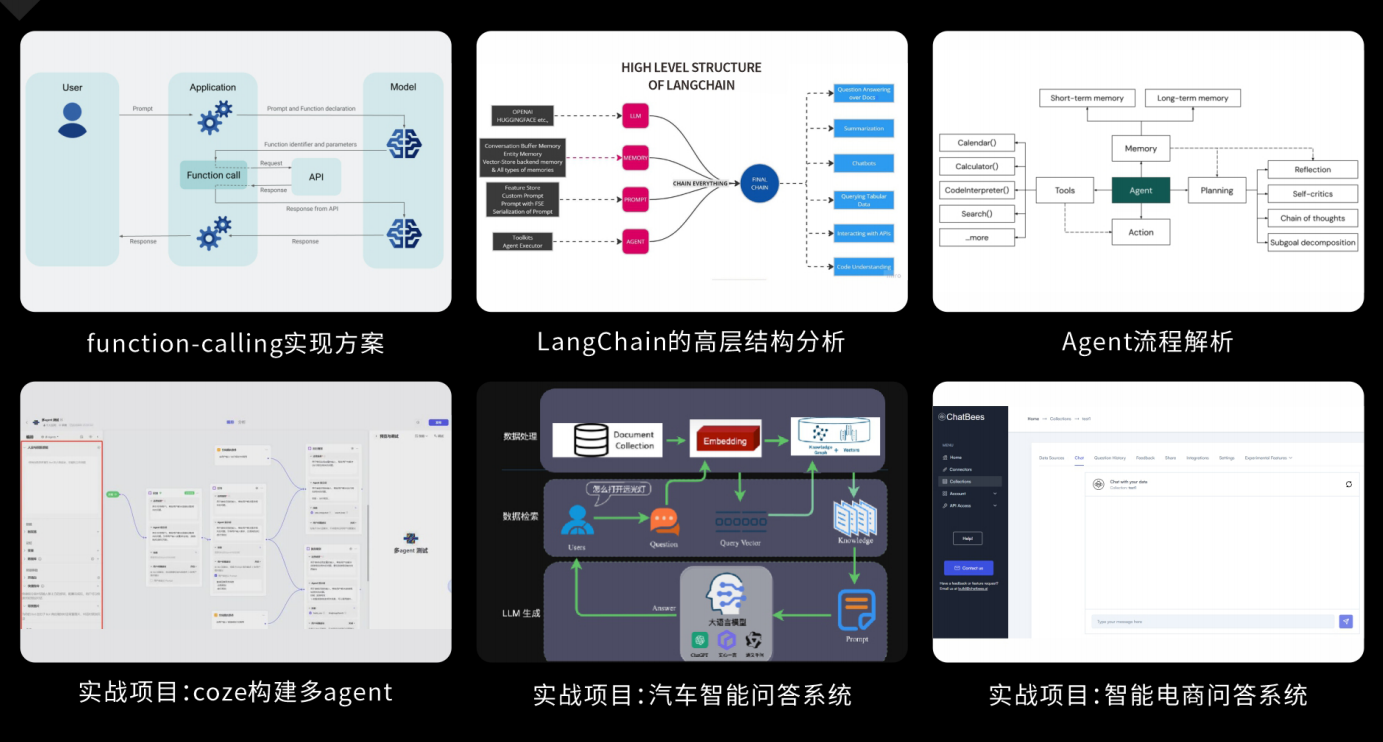
模型微调与私有化大模型:掌握大模型微调与私有化部署技能,提升模型优化与部署能力,为大模型项目落地打下坚实基础。 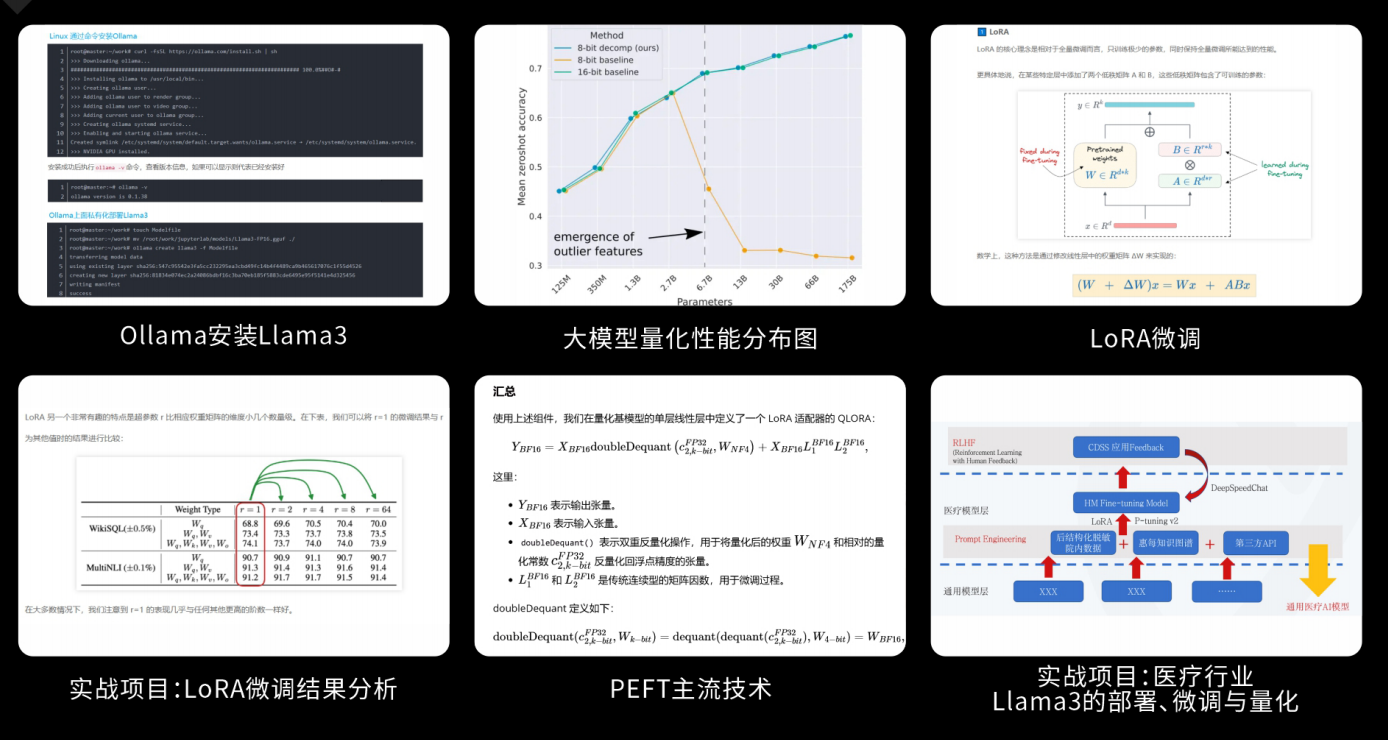
顶尖师资,深耕AI大模型前沿技术
实战专家亲授,让你少走弯路
一对一学习规划,职业生涯指导
- 真实商业项目实训
- 大厂绿色直通车
人才库优秀学员参与真实商业项目实训
以商业交付标准作为学习标准,具备真实大模型项目实践操作经验可写入简历,支持项目背调 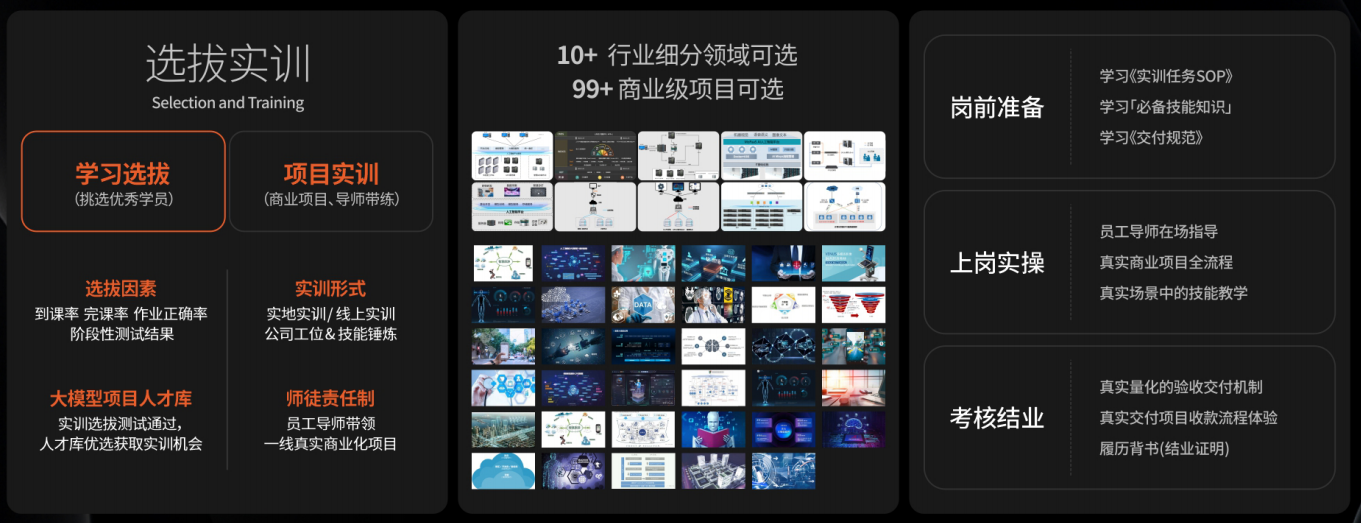
大厂绿色直通车,冲击行业高薪岗位
文中涉及到的完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】
为武汉地区的开发者提供学习、交流和合作的平台。社区聚集了众多技术爱好者和专业人士,涵盖了多个领域,包括人工智能、大数据、云计算、区块链等。社区定期举办技术分享、培训和活动,为开发者提供更多的学习和交流机会。
更多推荐
 10
 0
- 0


 已为社区贡献10条内容

所有评论(0)