小白也能看懂:RAG系统中的相似度召回与重排序,一篇讲透大模型检索优化核心
本文详细介绍了RAG系统中相似度召回和重排序的作用与区别。相似度召回用于快速从海量文档中筛选相关文档,而重排序则对召回结果进行精细排序以提高准确性。作者通过实际开发案例,分析了两种方法如何协同工作,解决了召回率不足的问题,并强调了选择合适相似度计算方式的重要性。文章还对比了Embedding模型和Reranker模型的特点,指出两者结合能实现效率和准确性的平衡。
“ 相似度召回的作用是快速从海量文档中召回相关文档,而rerank重排序的作用是在这些相关文档中找到相关性最高的文档。”
这段时间在完成基于RAG的聊天对话系统之后,开始优化各个环节的功能;这时才真正发现,RAG做出来不难,想做好真的不容易。
这次在优化上下文结构时发现了一个问题,那就是相似度计算和重排序;在刚开始对相似度计算和重排序的理解就是,通过相似度进行数据召回,然以后再通过重排序找到其中最相关的内容。
这样理解虽然不能说有错,但理解的却不够透彻;在系统开发的过程中曾经遇到过一个问题,那就是召回率不足;很多相关的数据无法召回,至于原因么有很多,但主要原因是处理的文档质量不高,导致相似度召回时,其阈值特别低。
因此,为了解决这个问题,暂时就通过降低阈值,并去掉重排序的方式来提高召回率;因为,很多时候即使通过相似度或其它方式召回数据,但最终在重排序时会被过滤掉。也就是说召回的相似度高的数据,和问题关联度并不一定高。
相似度召回和重排序
之所以注意到相似度召回和重排序的原因是,在多个向量库中进行相似度召回的时候发现,明明在这个向量库中并没有与问题相关的数据,但事实上却召回了一部分数据,并且这部分数据的相似度值比原文档所在的向量库中的值更高。
也就是说,在本应该有问题相关文档的库中召回的数据,还没有其它库中无关数据的相似度高;这就是一个很奇怪的问题,到底是因为文档处理的质量太低,还是因为嵌入的时候有问题。
因此,面对这种情况肯定需要对召回的文档进行重排序,以筛掉无关的数据;因此,在使用rerank模型进行排序时发现,那些其它库中相似度高的数据都被筛掉了,而原本库中相似度低的数据反而留了下来;当然这样才属于正常。
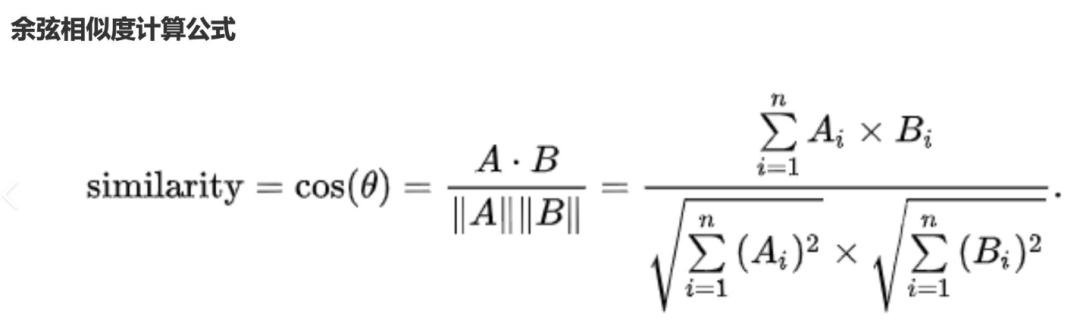
但这个无关数据的相似度更高的问题还是没有被解决;而在相似度召回中,有好几种相识度计算的方式,比如说余弦相似度,内积,欧式距离等多种计算方式。
因此面对不同的业务场景和数据类型,选择合适的相似度计算方式,也能间接增强召回的准确度。
Reranker与embedding模型的区别
尽管Reranker和Embedding模型都用于信息检索系统,它们的定位和功能却是不同的。
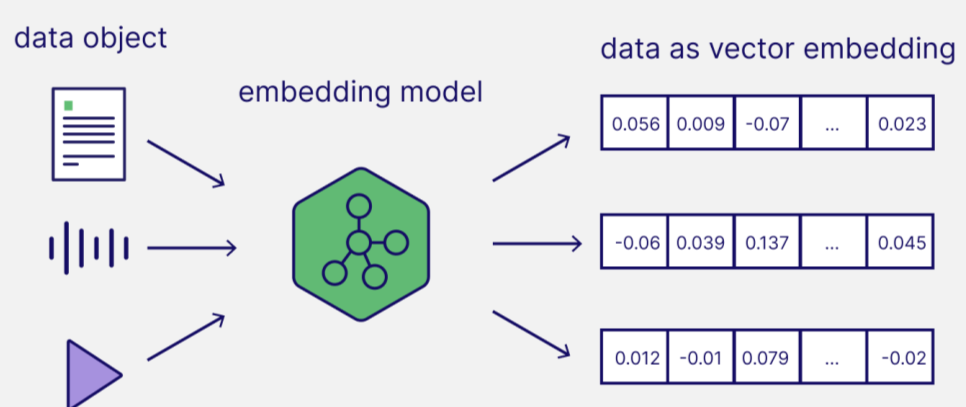
Embedding模型主要用于初步筛选文档。它将文本转换为向量表示,并计算这些向量之间的相似度,从而筛选出一组可能相关的候选文档。Embedding模型的优势在于它的计算效率高,适合处理大规模数据集。
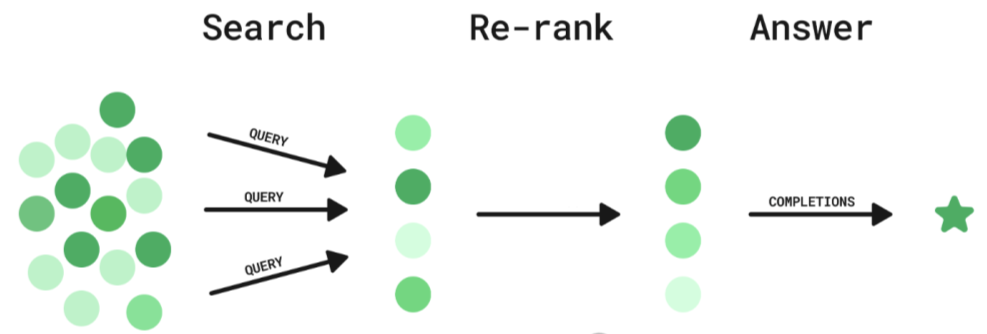
Reranker则用于对Embedding模型筛选出的候选文档进行精细排序。Reranker通常基于复杂的深度神经网络,能够更好地理解文本的上下文和细微差异,从而提供更高的排序精度。
简单来说,Embedding模型负责“找出一批可能相关的候选文档”,而Reranker负责“在这些候选文档中找出最相关的,并将它们按相关性排序”。
Reranker能否直接用于检索?
理论上,Reranker可以直接用于检索,但在实际应用中并不常见。这是因为Reranker的计算复杂度较高,直接使用它对整个数据集进行排序会导致极高的计算成本,难以满足实时性要求。因此,通常我们会先用Embedding模型进行初步筛选,将文档集合缩小到一个合理的范围,然后再使用Reranker进行精细排序。
总结
结合Embedding模型和Reranker的优势,实现了效率和准确性的平衡。Embedding模型负责快速筛选候选文档,而Reranker则通过更细致的分析对这些文档进行精准排序,虽然其计算开销较高,但它在提升排序准确性方面的作用不可忽视。
零基础如何学习大模型
读者福利大放送:如果你对大模型感兴趣,想更加深入的学习大模型**,那么这份精心整理的大模型学习资料,绝对能帮你少走弯路、快速入门**
如果你是零基础小白,别担心——大模型入门真的没那么难,你完全可以学得会!
👉 不用你懂任何算法和数学知识,公式推导、复杂原理这些都不用操心;
👉 也不挑电脑配置,普通家用电脑完全能 hold 住,不用额外花钱升级设备;
👉 更不用你提前学 Python 之类的编程语言,零基础照样能上手。
你要做的特别简单:跟着我的讲解走,照着教程里的步骤一步步操作就行。
包括:大模型学习线路汇总、学习阶段,大模型实战案例,大模型学习视频,人工智能、机器学习、大模型书籍PDF。带你从零基础系统性的学好大模型!
现在这份资料免费分享给大家,有需要的小伙伴,直接VX扫描下方二维码就能领取啦😝↓↓↓
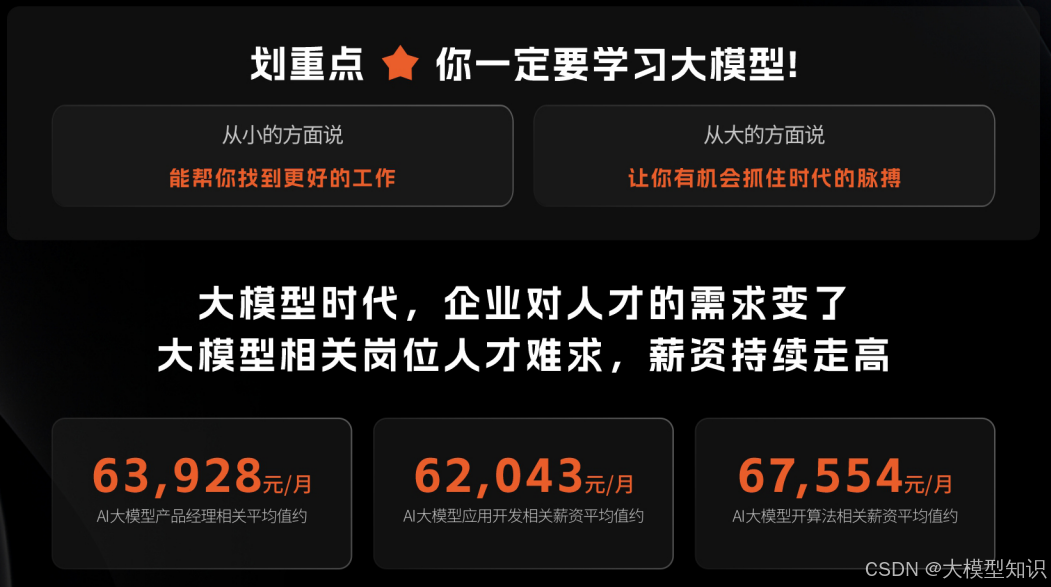
为什么要学习大模型?
数据显示,2023 年我国大模型相关人才缺口已突破百万,这一数字直接暴露了人才培养体系的严重滞后与供给不足。而随着人工智能技术的飞速迭代,产业对专业人才的需求将呈爆发式增长,据预测,到 2025 年这一缺口将急剧扩大至 400 万!!
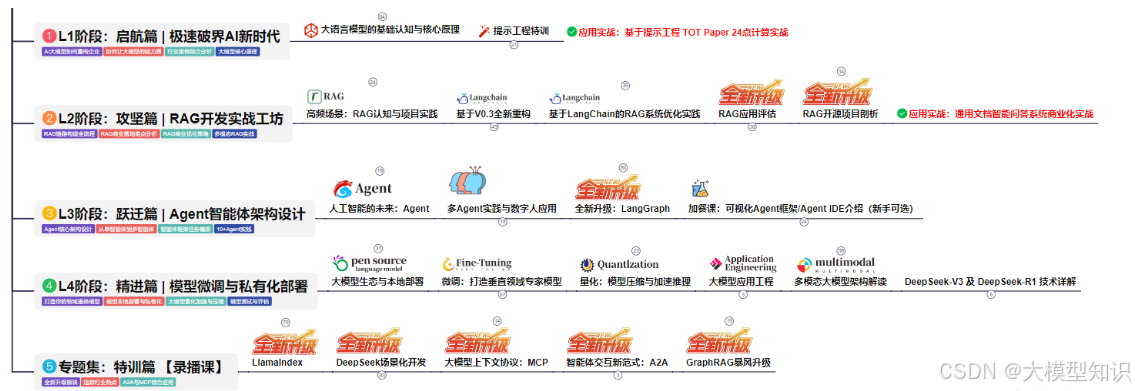
大模型学习路线汇总
整体的学习路线分成L1到L4四个阶段,一步步带你从入门到进阶,从理论到实战,跟着学习路线一步步打卡,小白也能轻松学会!
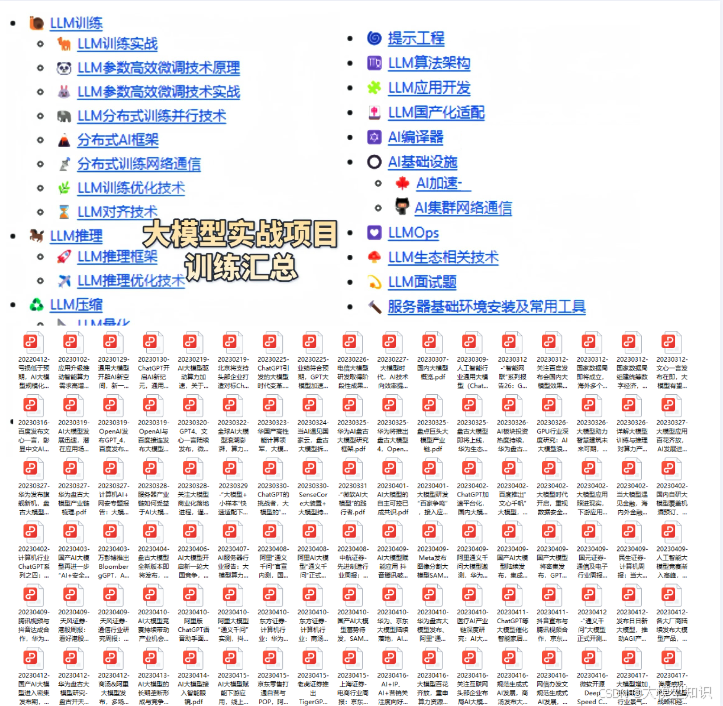
大模型实战项目&配套源码
光学理论可不够,这套学习资料还包含了丰富的实战案例,让你在实战中检验成果巩固所学知识
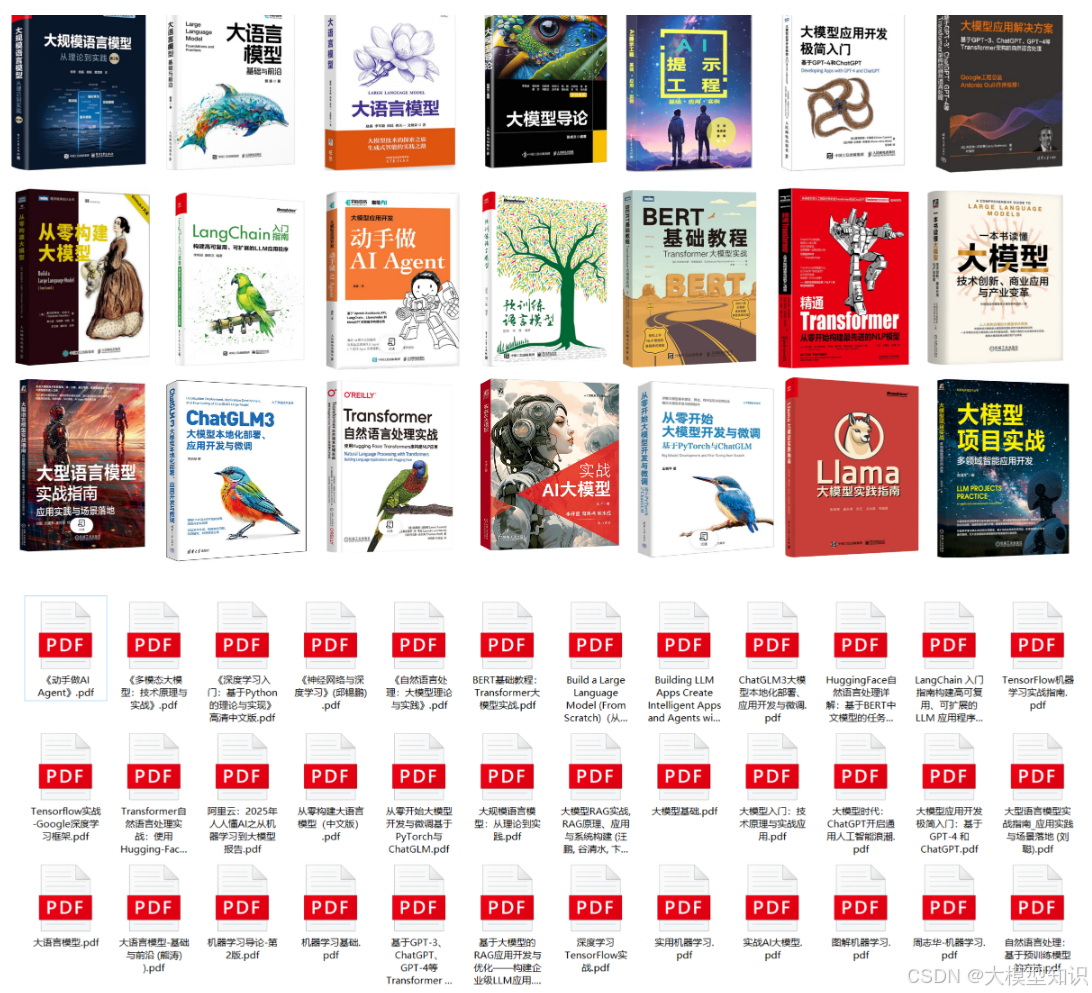
大模型学习必看书籍PDF
我精选了一系列大模型技术的书籍和学习文档(电子版),它们由领域内的顶尖专家撰写,内容全面、深入、详尽,为你学习大模型提供坚实的理论基础。
大模型超全面试题汇总
在面试过程中可能遇到的问题,我都给大家汇总好了,能让你们在面试中游刃有余
这些资料真的有用吗?
这份资料由我和鲁为民博士(北京清华大学学士和美国加州理工学院博士)共同整理,现任上海殷泊信息科技CEO,其创立的MoPaaS云平台获Forrester全球’强劲表现者’认证,服务航天科工、国家电网等1000+企业,以第一作者在IEEE Transactions发表论文50+篇,获NASA JPL火星探测系统强化学习专利等35项中美专利。本套AI大模型课程由清华大学-加州理工双料博士、吴文俊人工智能奖得主鲁为民教授领衔研发。
资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的技术人员,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。
👉获取方式:
😝有需要的小伙伴,可以保存图片到VX扫描下方二维码免费领取【保证100%免费】
相信我,这套大模型系统教程将会是全网最齐全 最适合零基础的!!
为武汉地区的开发者提供学习、交流和合作的平台。社区聚集了众多技术爱好者和专业人士,涵盖了多个领域,包括人工智能、大数据、云计算、区块链等。社区定期举办技术分享、培训和活动,为开发者提供更多的学习和交流机会。
更多推荐
 32
 0
- 0


 已为社区贡献14条内容

所有评论(0)