程序员必看!什么是 RAG?为什么学大模型一定要懂它?
本文介绍RAG技术如何解决LLM的幻觉、知识截止和缺乏领域知识等问题。通过摄取、检索、增强、生成四个核心组件,RAG为模型注入外部知识,提供实时、准确且可追溯的回答。相比资源密集的模型微调,RAG是一种更轻量、灵活的替代方案,为构建高效知识增强系统奠定基础。
1、为什么要使用RAG
基础模型不仅局限于过去的知识,还会刻意生成听起来自然且多样化的回应。这两点都可能导致其输出内容自信满满却不准确,且与问题无关。这种行为被称为 “幻觉”。
虽然有些基于基础模型构建的产品非常出色,但应当充分认识到基础模型有诸多局限性:
| LLM存在的问题 | |
|---|---|
| 知识截止点 | 对于预训练模型,在训练完成后知识就已经固定了 |
| 缺乏领域知识特定的深度 | 基础模型拥有广泛的知识,但在专业领域可能缺乏深度 某个领域的高质量数据集可能不公开存在,这不一定是因为它们是私有的,而是因为它们是高度专业化的 |
| 缺乏私有或专有数据 | 对于通用的公共模型而言,数据(您的数据)不公开存在,在训练期间无法访问。 内部公司流程和政策、人员数据或电子邮件通信,甚至是公司的商业机密 |
| 缺少信任 | 由于基础模型在回答时不会指明出处,缺少佐证 |
| 基础模型的输出是概率性的 | LLM会有幻觉 模型是在多样化的数据集上训练的,这些数据集可能包含矛盾、错误和模糊的数据(除了正确的数据之外) |
基于大模型存在的这些问题,当我们需要在私有数据或专业数据上使用大模型的能力时,需要将这些模型之外的知识提供给大模型时,这样引入了RAG技术。
2、什么是RAG?
RAG,Retrieval-Augmented Generation,是一种利用权威的外部数据来提高模型输出的准确性、相关性和实用性的技术。它通过以下四个核心组件来实现这一点,我们将在本文后面更详细地介绍这些组件:
1. 摄取(Ingestion)
将权威数据(如公司专有数据)加载到数据源中,如向量数据库
2. 检索(Retrieval)
基于用户查询从外部数据源中检索相关数据
3. 增强(Augmentation)
将检索到的数据和用户查询结合成提示,为生成步骤向模型提供上下文
4. 生成(Generation)
模型从增强的提示中生成输出,使用上下文来驱动更准确和相关的回答
整体架构如下图:
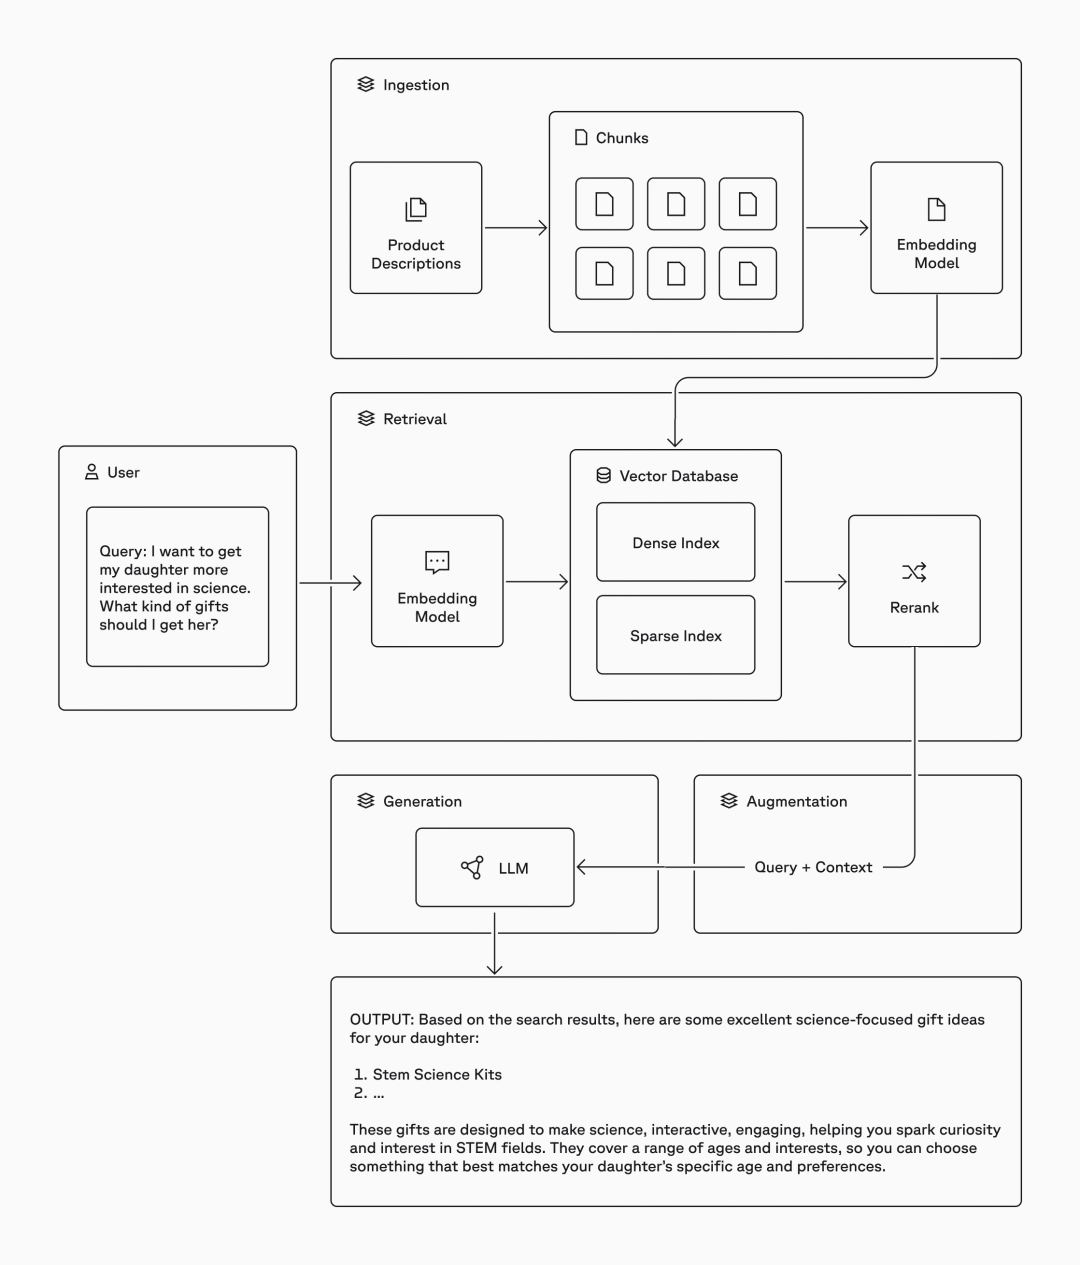
RAG架构,图片引自pinecone.com
3、RAG是如何工作的?
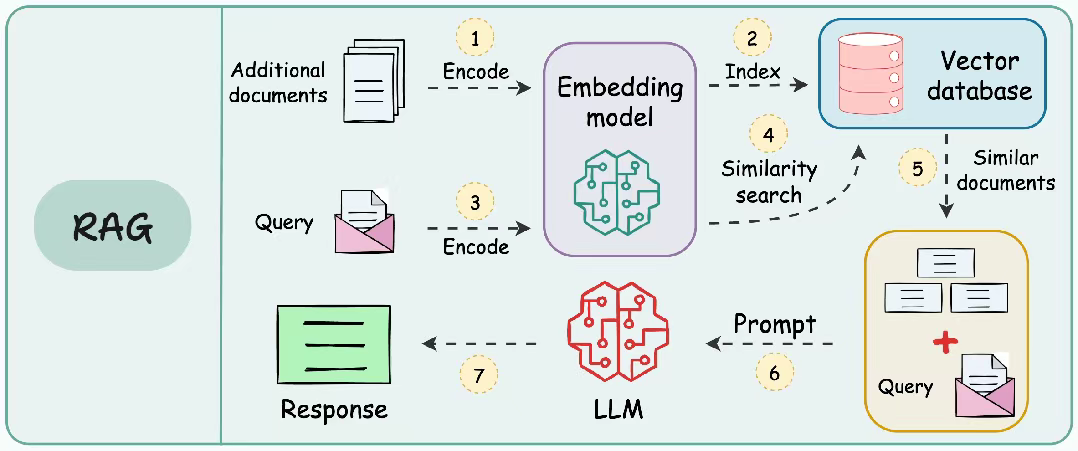
RAG基础工作流程
基础RAG的四个主要组成部分:
1. 数据入库 (Ingestion)
在简单的传统RAG中,会从向量数据库(如milvus、weaviate、pinecone等)中检索数据,使用语义搜索来找到用户查询的真实含义,并检索相关信息,而不仅仅是匹配查询中的关键词。
但在我们检索数据之前,你必须先将数据入库(如上图中的第1步以及第2步)。以下是将数据存入数据库的步骤:
对数据进行分块 (Chunk the data)
在数据入库阶段,需要将你的权威数据或私有数据转化为向量并保存到向量数据库中。
你可能拥有结构化或非结构化的数据,形式包括文本、PDF、电子邮件、内部维基或数据库。在清洗数据后,你可能需要对其进行分块,即将每份数据或文档分割成更小的块。你需要根据你拥有的数据类型、用户的查询类型以及结果将在你的应用中如何使用,来选择一种分块策略。
创建向量嵌入 (Create vector embeddings)
然后,使用一个嵌入模型(embedding model),你会为每个块进行向量化(embedding),并将其加载到向量数据库中。
嵌入模型(Embedding Model)通常是基于大型语言模型技术发展而来的一种特殊模型,它的任务不是生成文本,而是将数据块转换为向量嵌入——一种数据含义的数值表示。这使得计算机能够根据存储数据的向量表示来搜索相似的项目。
将数据加载到向量数据库 (Load data into a vector database)
一旦对文本块进行向量化,就可以将它们加载到向量数据库中。这个入库步骤很可能是在线下、独立于你的应用程序和用户工作流的情况下发生的。但是,如果你的数据发生变化,例如产品库存更新,你可以实时更新索引,以便为你的用户提供最新的信息。
现在你的向量数据库包含了源数据的向量嵌入,下一步就是检索。
2. 检索 (Retrieval)
一个简单的检索方法可能只使用语义搜索(semantic search)。但通过使用混合搜索(hybrid search),结合语义搜索(通常使用密集向量dense vectors)和词汇搜索(如经典的BM25算法或现代的稀疏向量sparse vectors模型),你可以进一步改善检索结果。
当你的用户不总是使用相同的语言来谈论一个主题(语义搜索),并且他们会引用内部的、领域特定的语言(词汇或关键字搜索),如首字母缩略词、产品名或团队名时,这一点就变得尤为重要。
在检索期间,我们会根据用户的查询创建一个向量嵌入(如图第3步),用于在数据库中与向量进行搜索(如上图中的第4步)。在混合搜索中,你要么查询一个单一的混合索引,要么同时查询一个密集索引和一个稀疏索引。然后,我们合并并去重这些结果,并使用一个重排序模型(reranking model) 根据统一的相关性分数对它们进行重新排序,并返回最相关的匹配项。
3. 增强 (Augmentation)
现在你已经从检索步骤中获得了最相关的匹配项,你将创建一个包含搜索结果和用户查询的增强提示(augmented prompt)(如上图中的第5步),并将其发送给LLM。这就是魔法发生的地方。
一个增强提示可能看起来像这样:
问题:
<用户的问题>

上下文:
<用作上下文的搜索结果>

请使用提供的“上下文”,回答“问题”。请让你的答案基于“上下文”中的事实。
如果“上下文”中不包含“问题”的答案,请说你不知道。
通过将搜索结果和用户的问题都作为上下文发送给LLM(如上图中的第6步),你正在鼓励它在接下来的生成步骤中,使用来自搜索结果的更准确、更相关的信息。
4. 生成 (Generation)
使用增强提示,LLM现在可以访问来自你的向量数据库的最相关、最可靠的事实,因此你的应用程序可以为你的用户提供一个准确的答案(如上图中的第7步),从而减少产生幻觉的可能性。
下一步,通过智能体RAG(agentic RAG),它关乎于决定要问什么问题、使用什么工具、何时使用它们,然后聚合结果来为答案提供依据。这代表了RAG技术的未来演进方向,我们将在本系列笔记的第四篇中深入探讨这一激动人心的话题。
4、RAG带来的好处
为大型语言模型(LLM)注入领域知识,通常有两种主流方法:模型微调(Fine-tuning)和检索增强生成(RAG)。
- 模型微调:通过使用专业的领域知识数据集,对预训练的LLM进行“再训练”。这个过程将新知识直接“烙印”进模型的参数中,使其成为模型内在知识的一部分。
- RAG架构:不改变模型本身,而是为LLM外挂一个“知识库”。当遇到问题时,系统会先从这个包含领域知识的知识库中检索相关信息,然后将这些信息作为上下文,提供给LLM来生成答案。
虽然微调能让模型深度掌握特定知识,但它通常是一个资源密集且耗时的过程,需要大量的标注数据和计算能力。相比之下,RAG架构提供了一种更轻量级、更灵活的替代方案。它无需重新训练模型,只需构建和维护一个外部知识库即可。
而利用RAG构建外挂的知识库,可以带来如下的一些好处:
- 访问实时数据和专有或领域特定数据
引入与您情况相关的知识——时事、新闻、社交媒体、客户数据、专有数据 - 建立信任
更相关和准确的结果更可能赢得信任,来源引用允许人工审查 - 更多控制
控制使用哪些来源、实时数据访问、数据授权、防护栏/安全/合规、可追溯性/来源引用、检索策略、成本,独立调整每个组件
然而,要构建一个真正健壮、高效的RAG系统,仅靠上述的基础流程是远远不够的。在实际应用中,从数据入库到最终生成,每一个环节都充满了挑战和优化的空间。在接下来的笔记中,我们将深入探讨如何通过一系列先进的优化方法,将一个“能用”的RAG系统,打造成一个“好用”的生产级应用
5、如何学习大模型 AI ?
由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。
但是具体到个人,只能说是:
“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。
这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。
我在一线科技企业深耕十二载,见证过太多因技术卡位而跃迁的案例。那些率先拥抱 AI 的同事,早已在效率与薪资上形成代际优势,我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在大模型的学习中的很多困惑。我们整理出这套 AI 大模型突围资料包:
- ✅ 从零到一的 AI 学习路径图
- ✅ 大模型调优实战手册(附医疗/金融等大厂真实案例)
- ✅ 百度/阿里专家闭门录播课
- ✅ 大模型当下最新行业报告
- ✅ 真实大厂面试真题
- ✅ 2025 最新岗位需求图谱
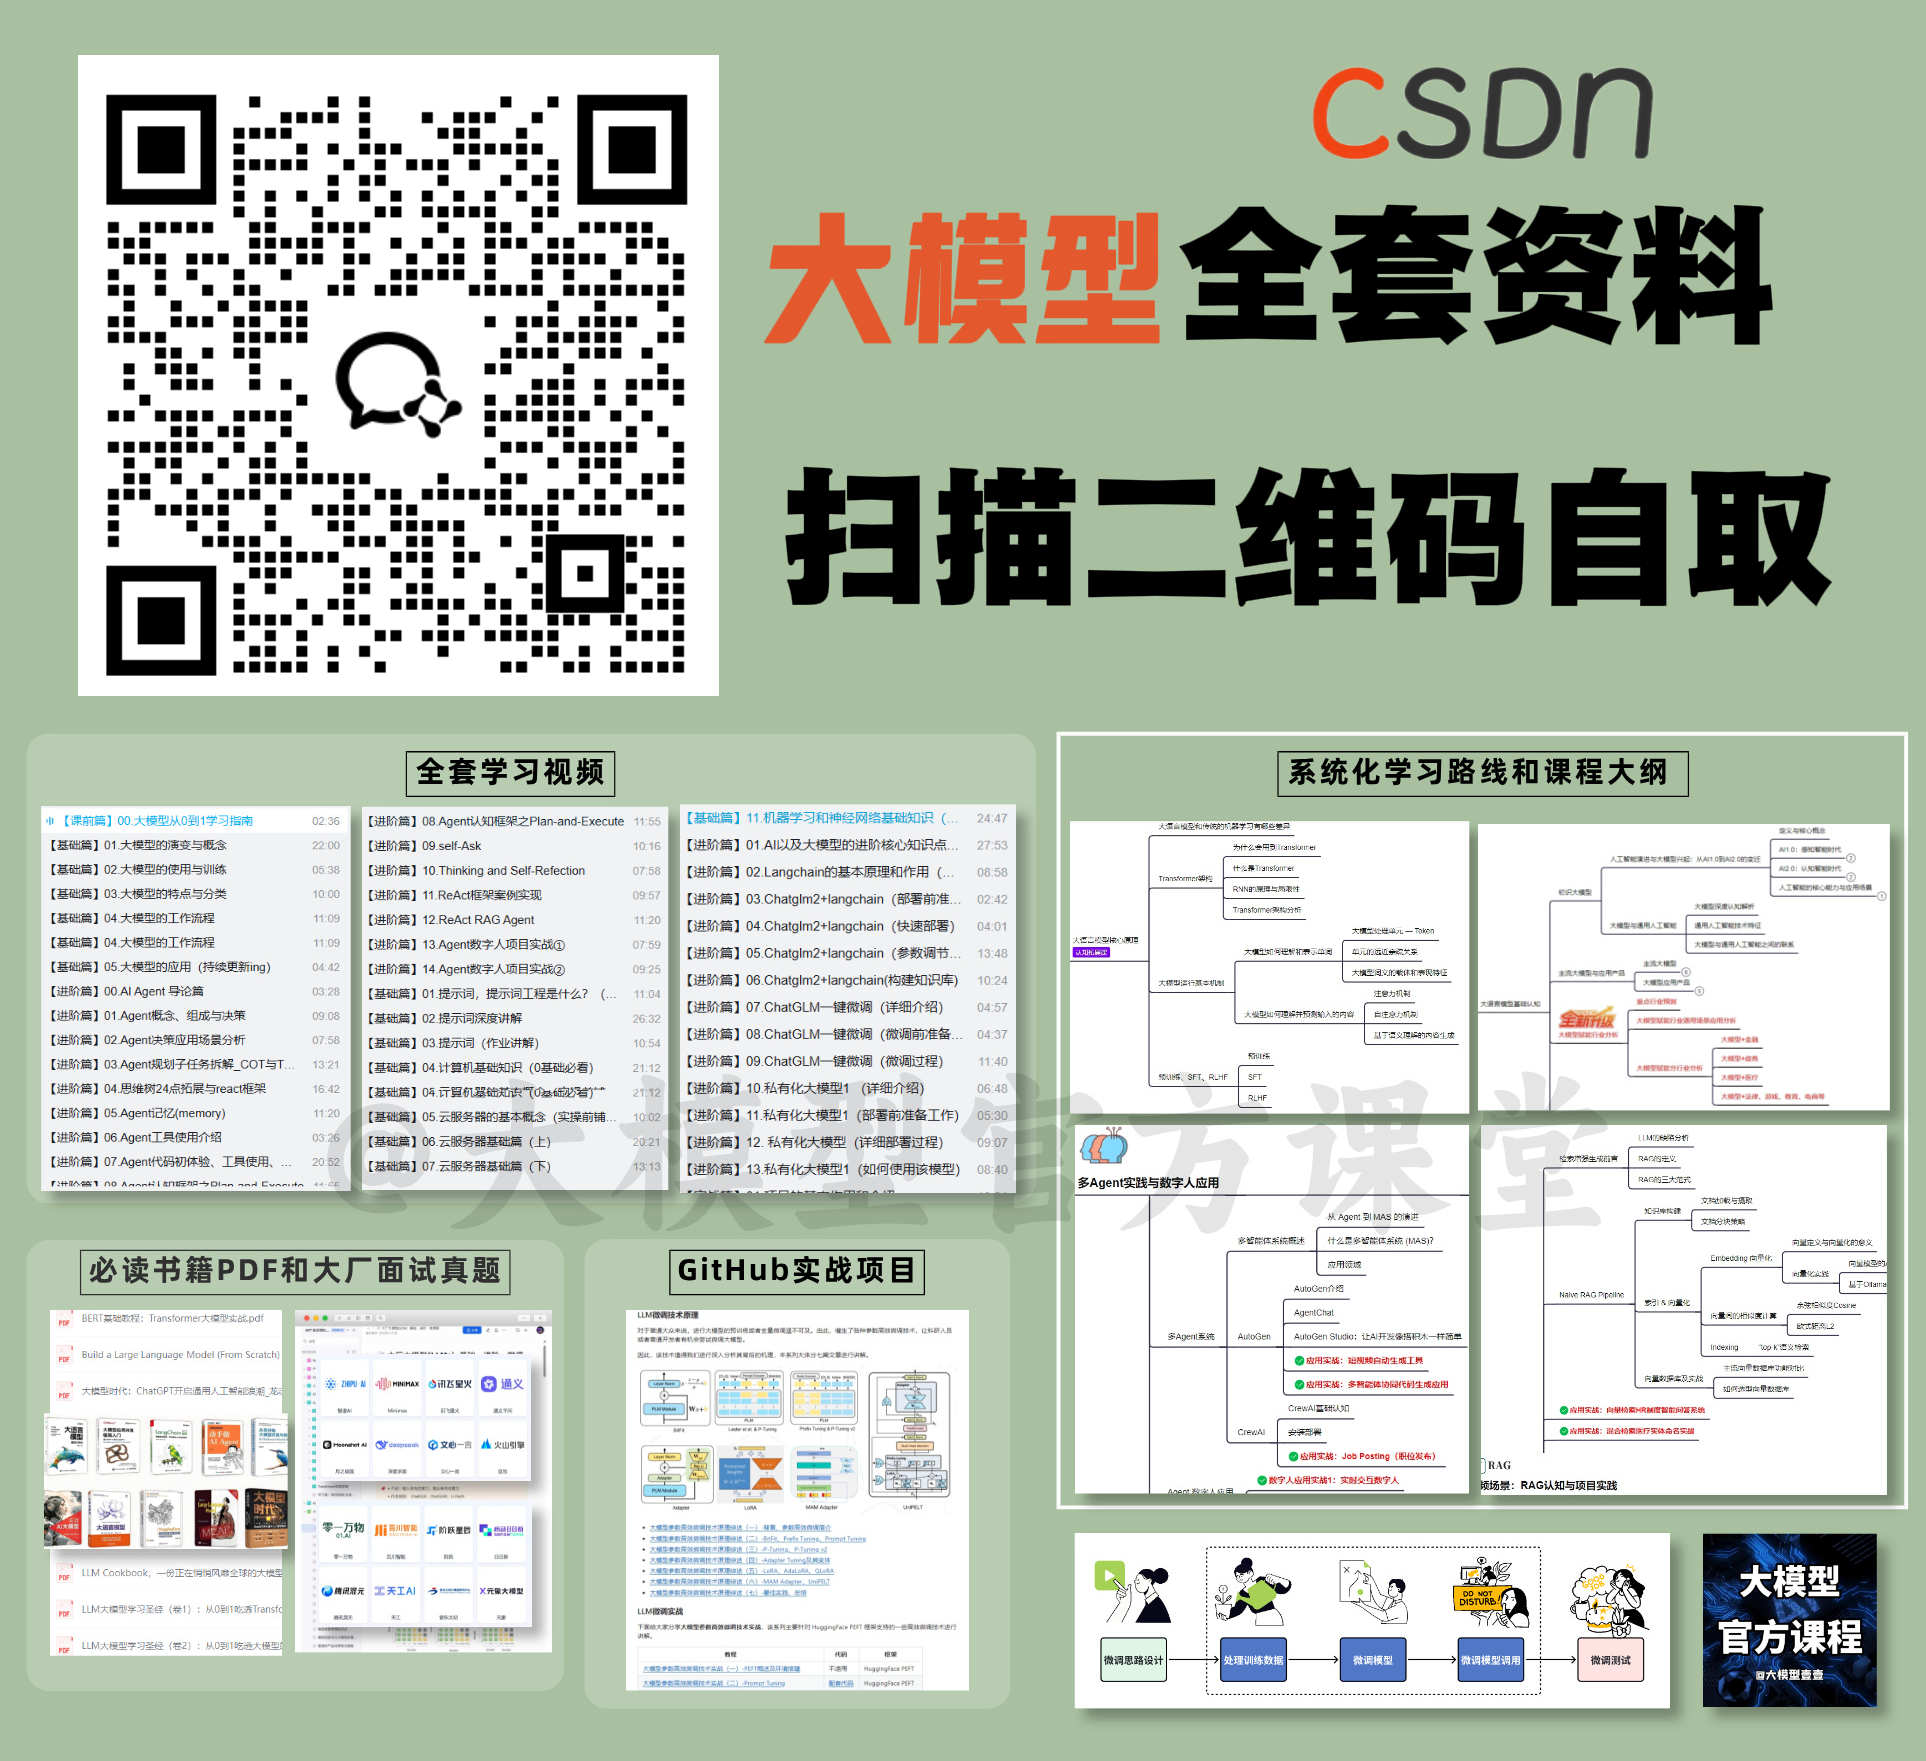
所有资料 ⚡️ ,朋友们如果有需要 《AI大模型入门+进阶学习资源包》,下方扫码获取~
① 全套AI大模型应用开发视频教程
(包含提示工程、RAG、LangChain、Agent、模型微调与部署、DeepSeek等技术点)
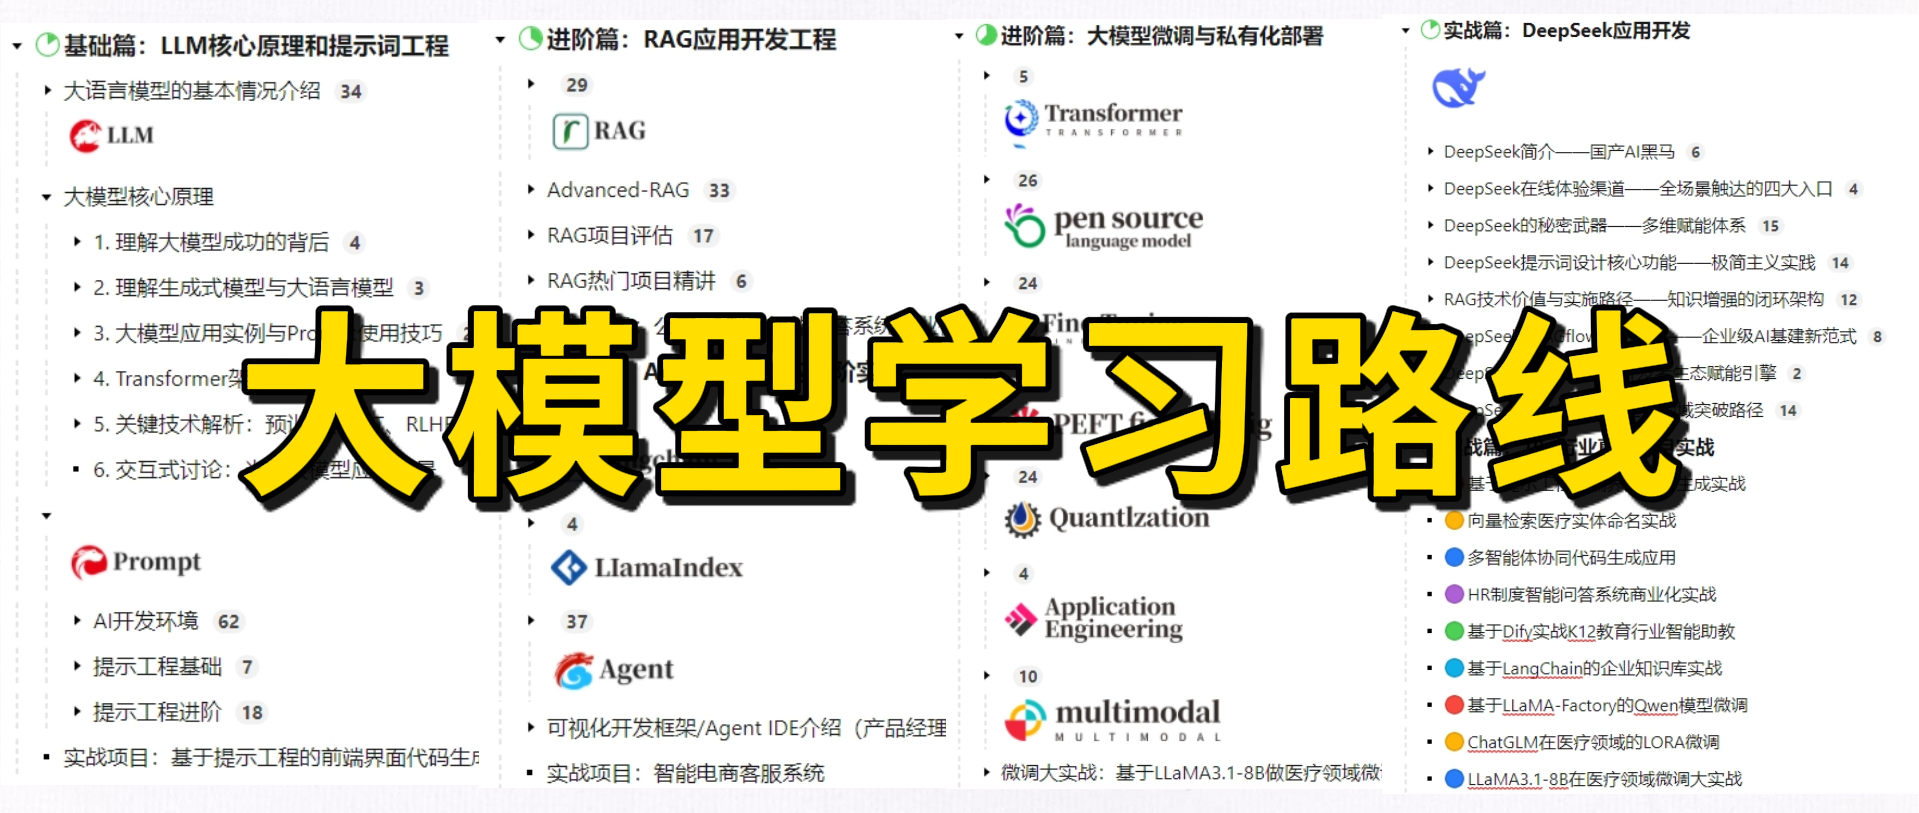
② 大模型系统化学习路线
作为学习AI大模型技术的新手,方向至关重要。 正确的学习路线可以为你节省时间,少走弯路;方向不对,努力白费。这里我给大家准备了一份最科学最系统的学习成长路线图和学习规划,带你从零基础入门到精通!
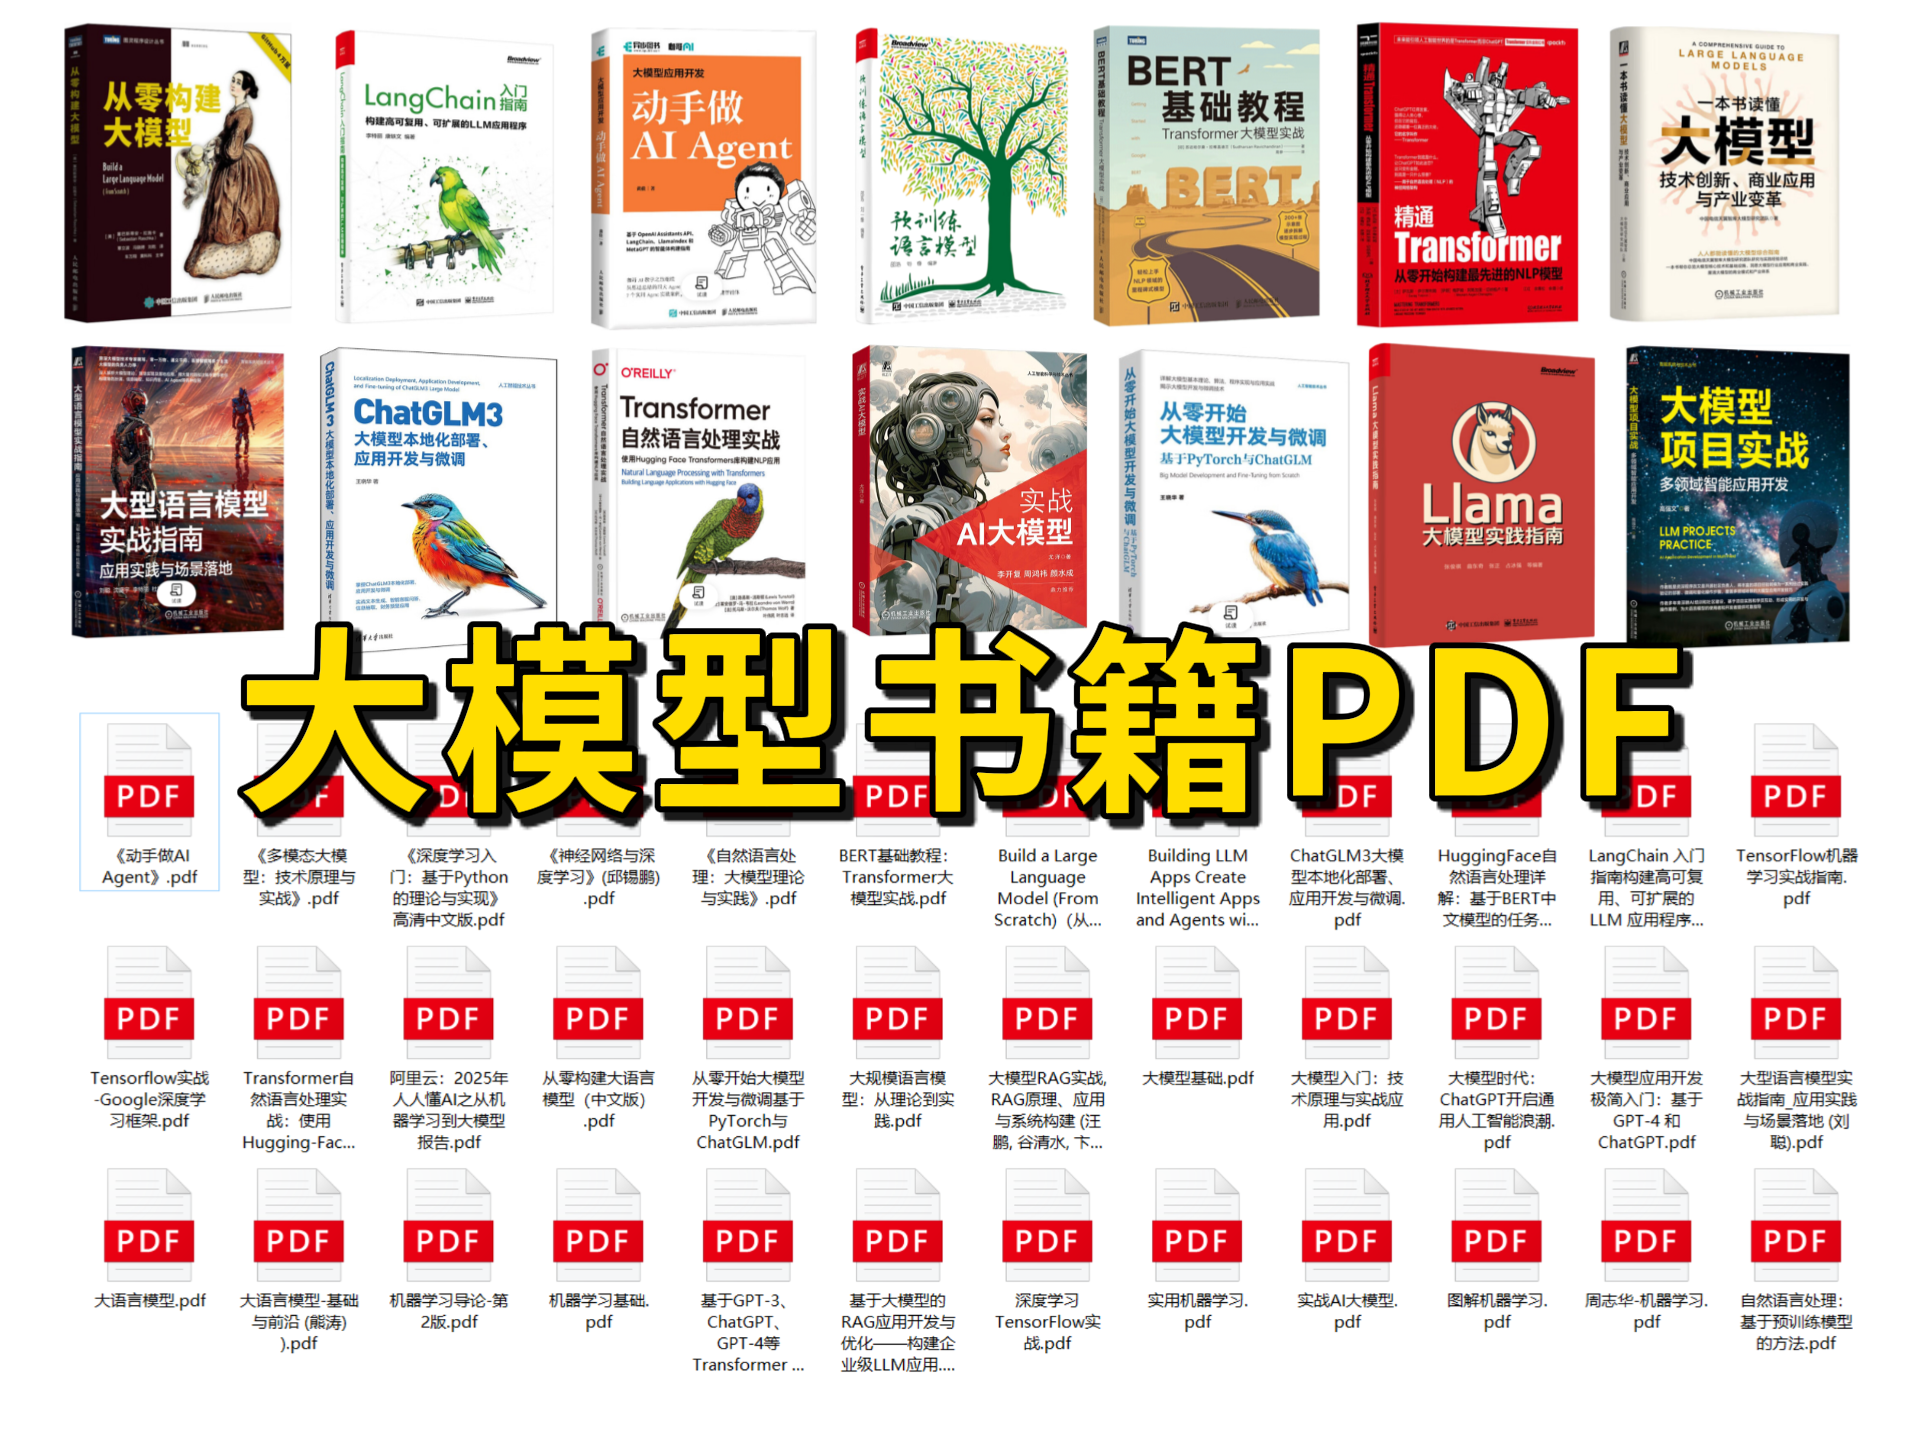
③ 大模型学习书籍&文档
学习AI大模型离不开书籍文档,我精选了一系列大模型技术的书籍和学习文档(电子版),它们由领域内的顶尖专家撰写,内容全面、深入、详尽,为你学习大模型提供坚实的理论基础。
④ AI大模型最新行业报告
2025最新行业报告,针对不同行业的现状、趋势、问题、机会等进行系统地调研和评估,以了解哪些行业更适合引入大模型的技术和应用,以及在哪些方面可以发挥大模型的优势。
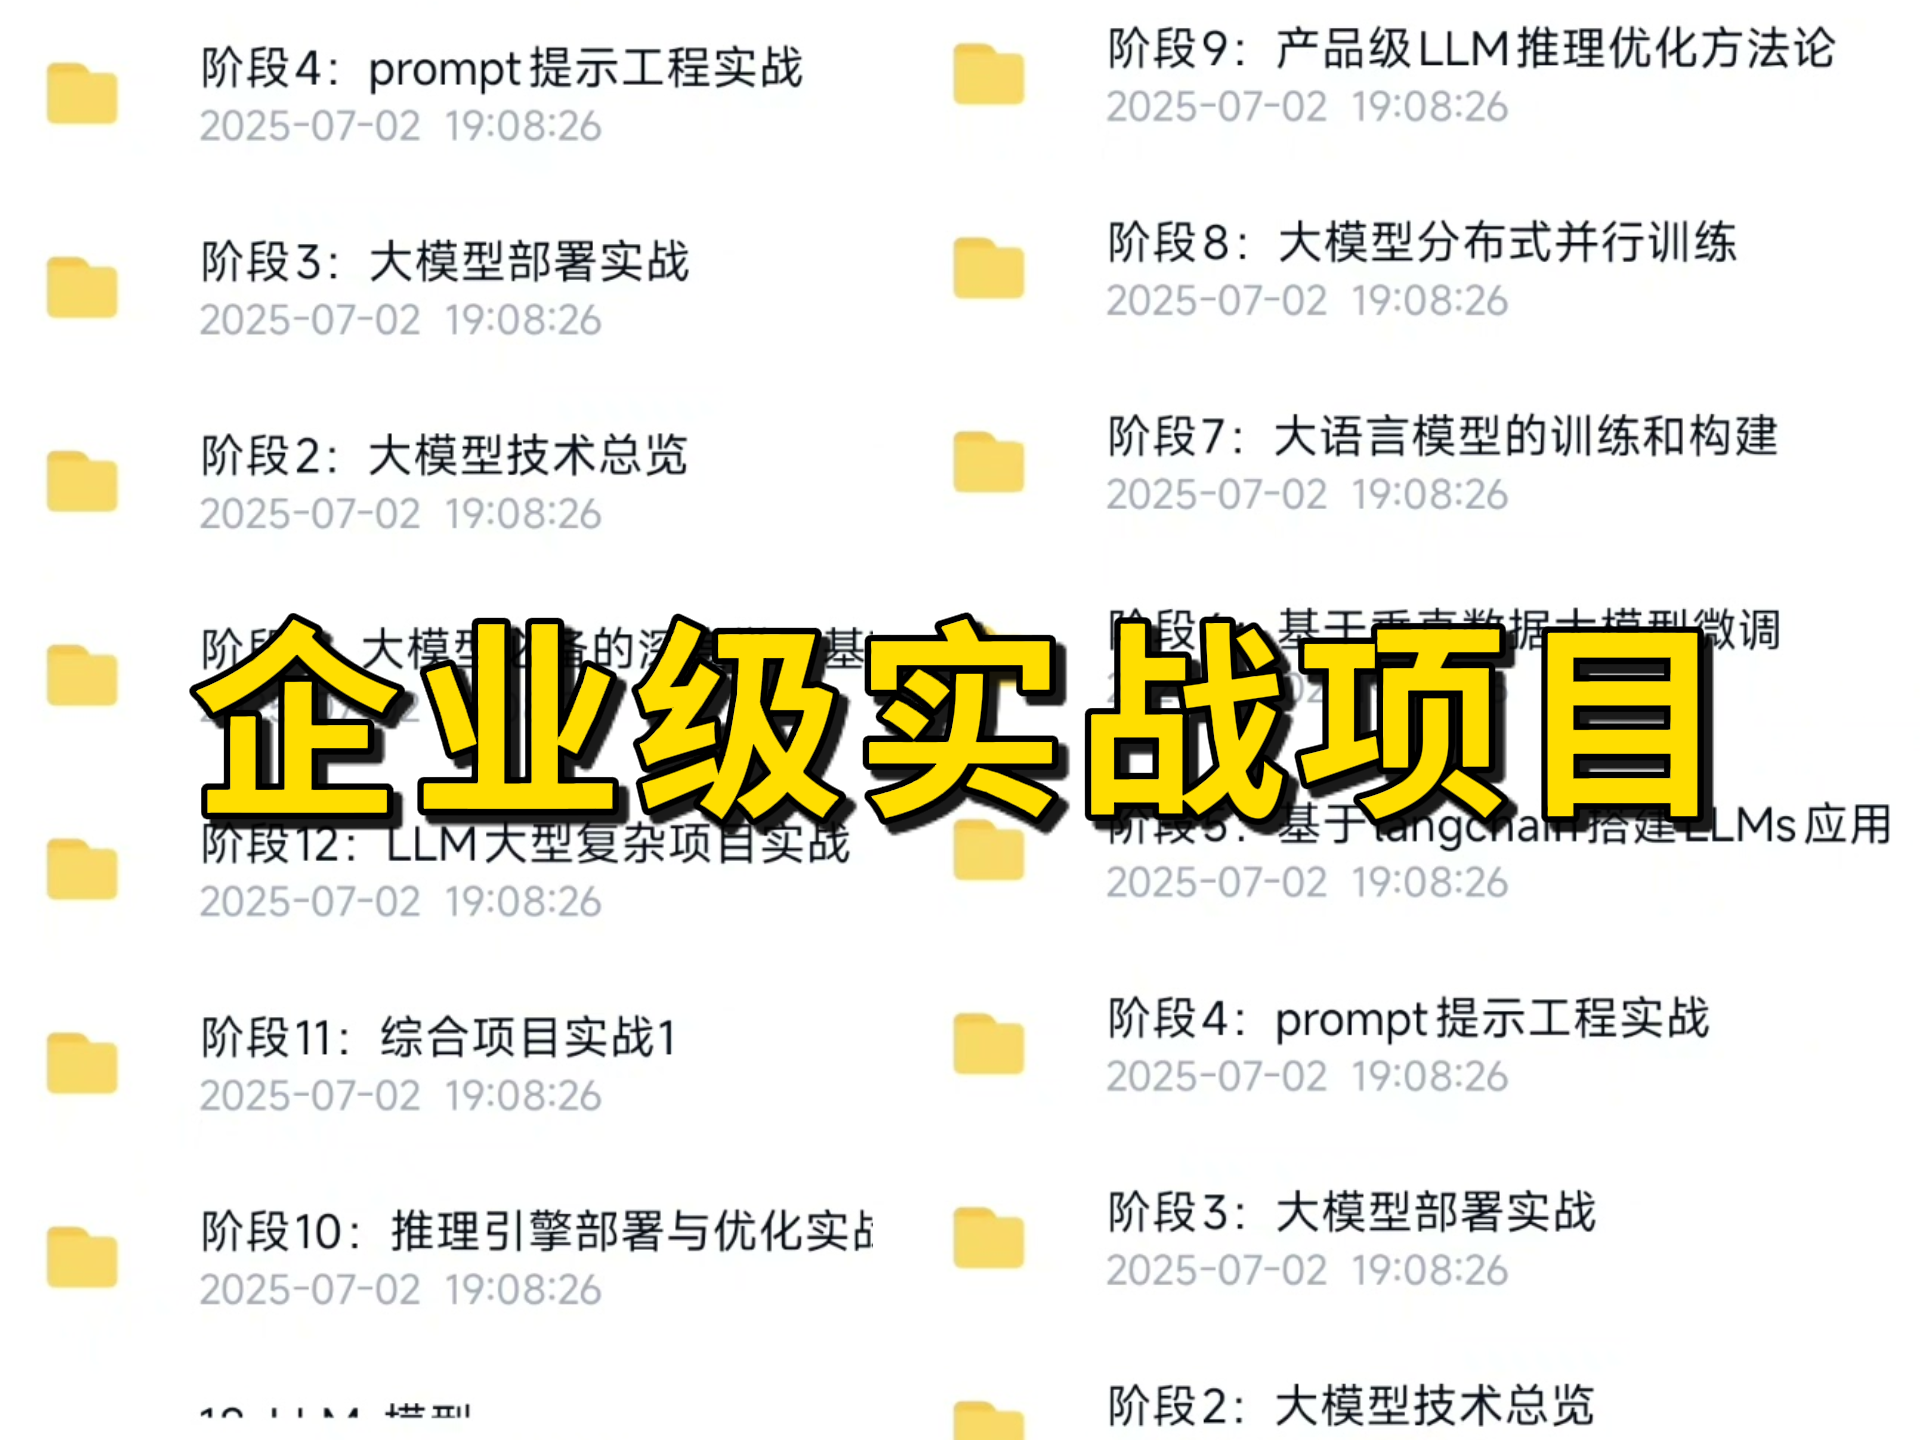
⑤ 大模型项目实战&配套源码
学以致用,在项目实战中检验和巩固你所学到的知识,同时为你找工作就业和职业发展打下坚实的基础。
⑥ 大模型大厂面试真题
面试不仅是技术的较量,更需要充分的准备。在你已经掌握了大模型技术之后,就需要开始准备面试,我精心整理了一份大模型面试题库,涵盖当前面试中可能遇到的各种技术问题,让你在面试中游刃有余。
以上资料如何领取?
为什么大家都在学大模型?
最近科技巨头英特尔宣布裁员2万人,传统岗位不断缩减,但AI相关技术岗疯狂扩招,有3-5年经验,大厂薪资就能给到50K*20薪!
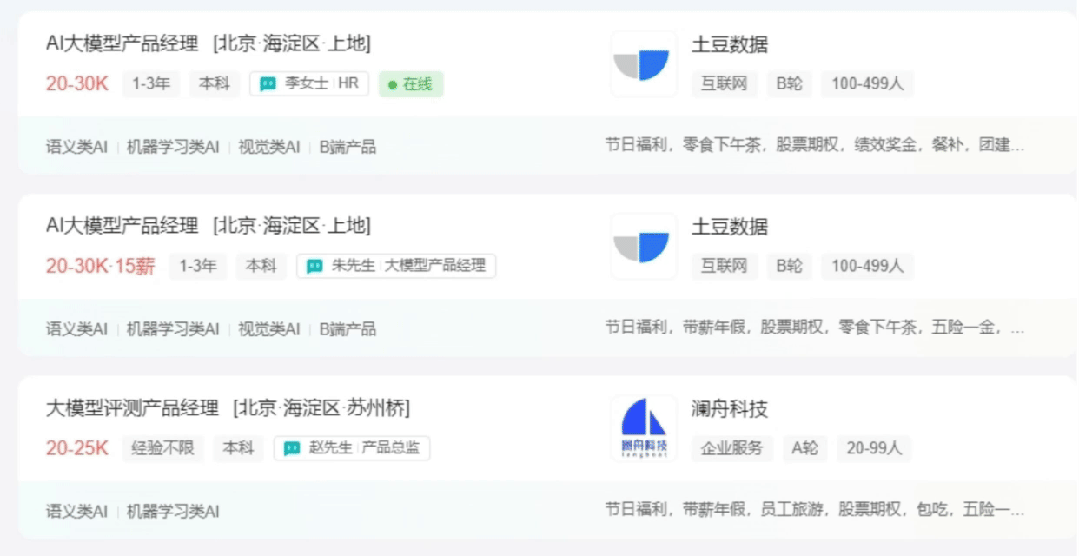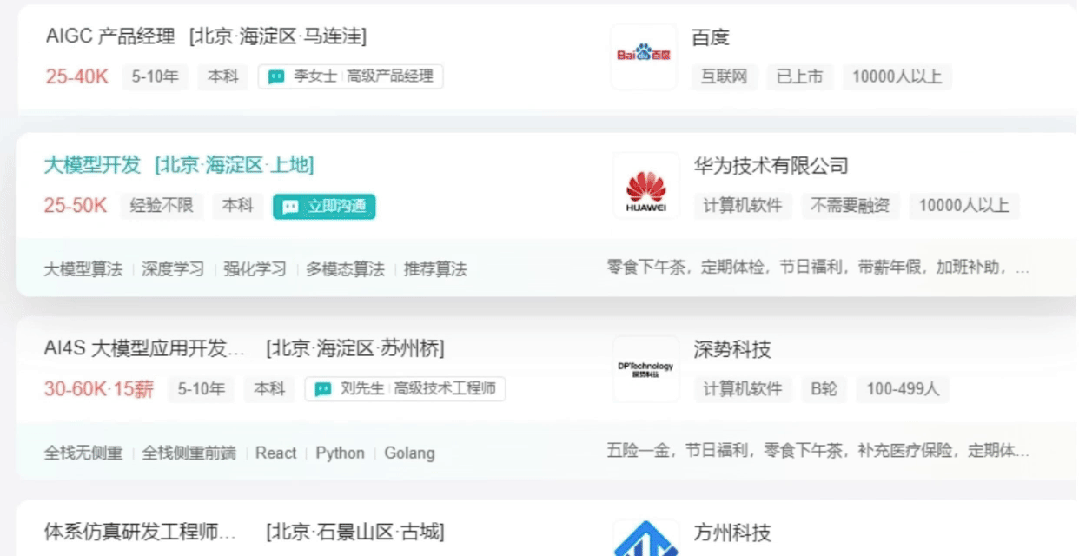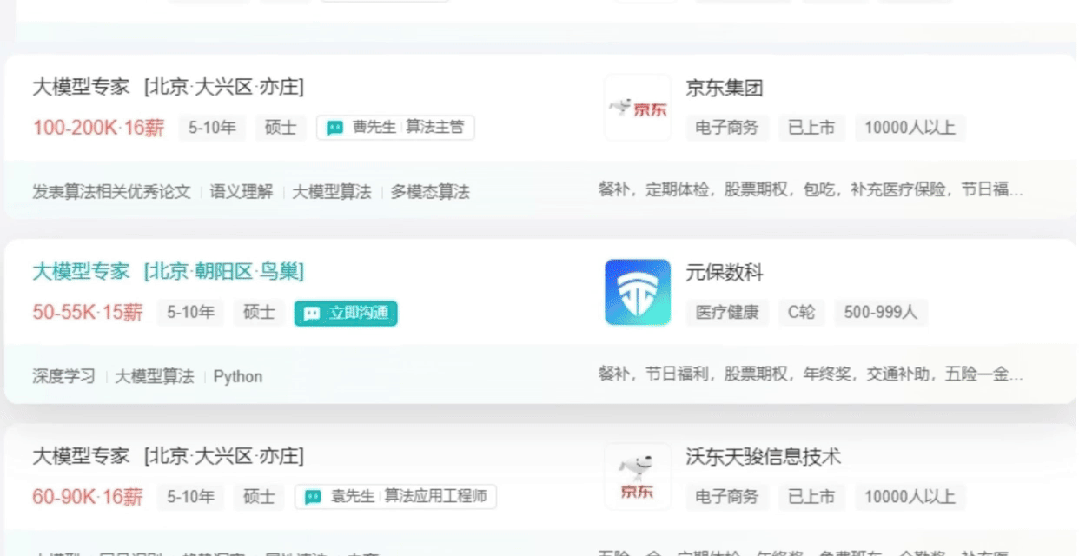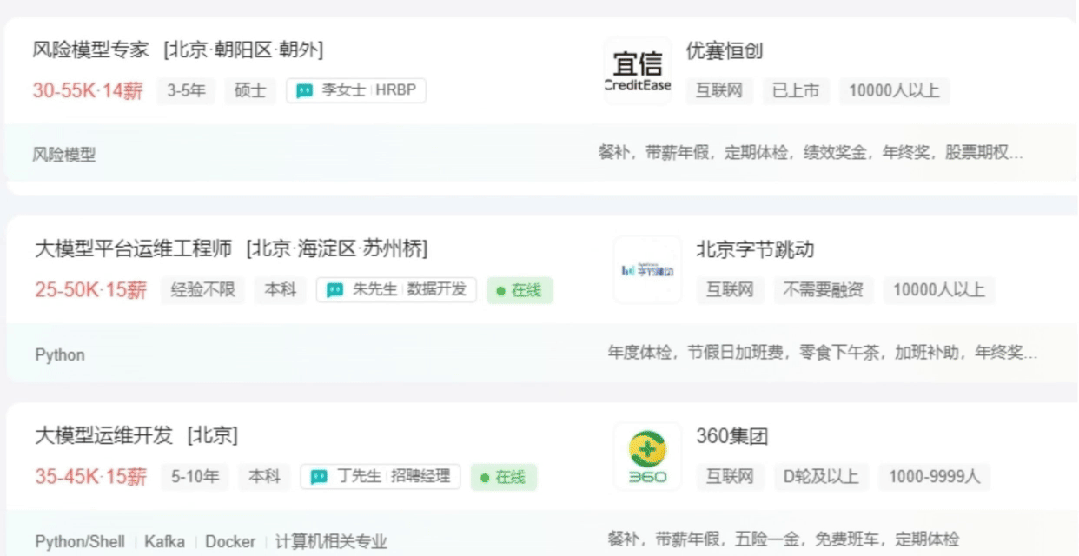
不出1年,“有AI项目经验”将成为投递简历的门槛。
风口之下,与其像“温水煮青蛙”一样坐等被行业淘汰,不如先人一步,掌握AI大模型原理+应用技术+项目实操经验,“顺风”翻盘!
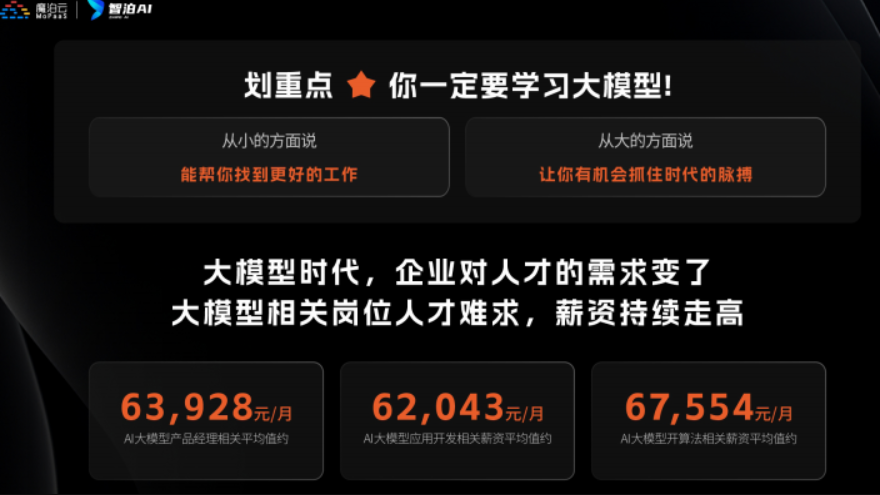
这些资料真的有用吗?
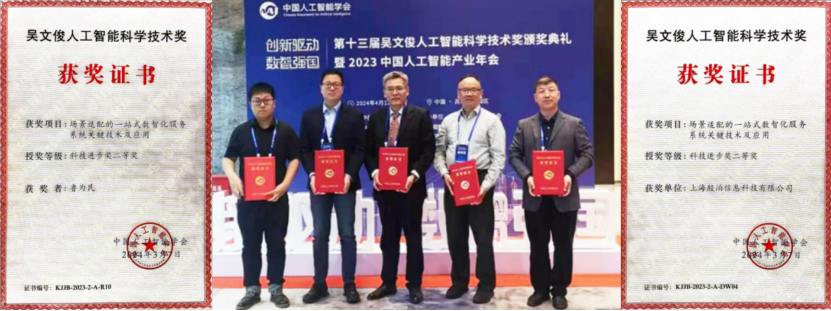
这份资料由我和鲁为民博士(北京清华大学学士和美国加州理工学院博士)共同整理,现任上海殷泊信息科技CEO,其创立的MoPaaS云平台获Forrester全球’强劲表现者’认证,服务航天科工、国家电网等1000+企业,以第一作者在IEEE Transactions发表论文50+篇,获NASA JPL火星探测系统强化学习专利等35项中美专利。本套AI大模型课程由清华大学-加州理工双料博士、吴文俊人工智能奖得主鲁为民教授领衔研发。
资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的技术人员,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。
以上全套大模型资料如何领取?
为武汉地区的开发者提供学习、交流和合作的平台。社区聚集了众多技术爱好者和专业人士,涵盖了多个领域,包括人工智能、大数据、云计算、区块链等。社区定期举办技术分享、培训和活动,为开发者提供更多的学习和交流机会。
更多推荐
 31
 0
- 0


 已为社区贡献14条内容

所有评论(0)