登录社区云,与社区用户共同成长
邀请您加入社区
概述在某些情况下,我们需要对于内核中的流程进行分析,虽然通过 BPF 的技术可以对于函数传入的参数和返回结果进行展示,但是在流程的调试上还是不如直接 GDB 单步调试来的直接。本文采用的编译方式如下,在一台 16 核 CentOS 7.7 的机器上进行内核源码相关的编译(主要是考虑编译效率),调试则是基于 VirtualBox 的 Ubuntu 20.04 系统中,采用 Qemu + GDB 进行
我们都知道在用户空间动态申请内存用的函数是 malloc(),这个函数在各种操作系统上的使用是一致的,对应的用户空间内存释放函数是 free()。注意:动态申请的内存使用完后必须要释放,否则会造成内存泄漏,如果内存泄漏发生在内核空间,则会造成系统崩溃。那么,在内核空间中如何申请内存呢?一般我们会用到 kmalloc()、kzalloc()、vmalloc() 等,下面我们介绍一下这些函数的使用以及
邻接表存储图的广度优先遍历题目答案注意题目答案void BFS ( LGraph Graph, Vertex S, void (*Visit)(Vertex) ){int queue[1000],f=0,r=0;queue[r++]=S;Visited[S]=1;Visit(S);PtrToAdjVNode temp;while(f!=r){temp=Graph->G[queue[f++]]
以邻接表为存储结构,实现连通有向图的深度优先和广度优先遍历两个遍历算法。以输入的第一个结点为起点开始遍历。
javascript中采用深度优先和广度优先遍历DOM树算法
Leetcode刷题c++之934.最短的桥
二叉树(C语言,手撕)
以上述图片为例,比如从G港到Y城,可以是G港->R城->Y城,也可以是G港->P城->Y城等,有很多条路径都可以实现从G港到Y城,但要从中找出G港到Y城距离最短的那一条路径,这就是单源最短路径问题。单源最短路径问题就是只有一个源头,从该源头出发,到达其他任意一个顶点可以走的最短路径。对于单源最短路径的题型,需要掌握BFS算法(可以求无权图的单源最短路径)和Dijkstra算法(可以求带权图和无权图
在图论中,常用的图的存储方式有两种,邻接矩阵和邻接表。邻接矩阵的概念十分简单,即用一个方阵,用方阵的行号和列号表示两个点之间的边的权值(邻接矩阵虽然结构简单,但是空间复杂度过高,在图比较稀疏时(边的数量远远小于顶点的数量)会造成过大的空间浪费,因此不适合使用,本篇主要介绍邻接表。邻接表,即为每一个顶点存储它能到达的点(邻居)。
图(Graph)是由顶点的有穷非空集合V ( G )和顶点之间边的**有穷集合E ( G ) **组成的数据结构,通常表示为:,其中,G表示个图,V 是图G中顶点的集合,E 是图G 中边的集合。若,则用∣ V ∣表示图G中顶点的个数,也称图G 的阶,,用∣ E ∣ 表示图G中边的条数。注意:线性表可以是空表,树可以是空树,但图不可以是空图。就是说,图中不能一个顶点也没有,图的顶点集V一定非空,但边
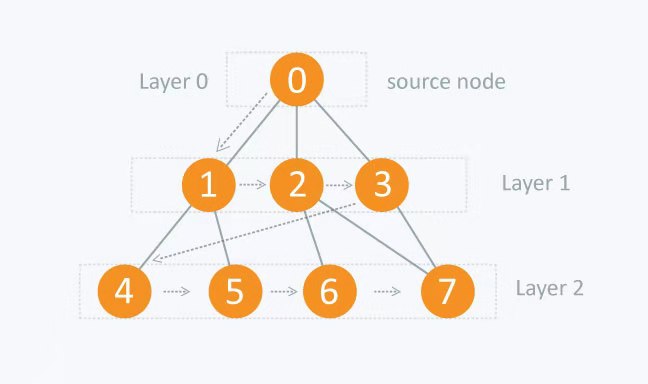
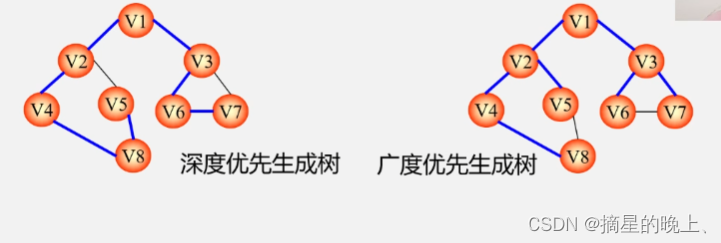
图的遍历是图论中的核心概念,通过不同的遍历方法能够有效地处理多种问题,例如连通性检测、路径查找、图的最小生成树等。本篇我们将重点探讨图的深度优先搜索(DFS)和广度优先搜索(BFS)两种常见的图遍历方法,分析它们的原理、应用场景以及实现方法,并通过实际案例代码分析问题解决方案。
AcWing算法基础课---搜索与图论笔记
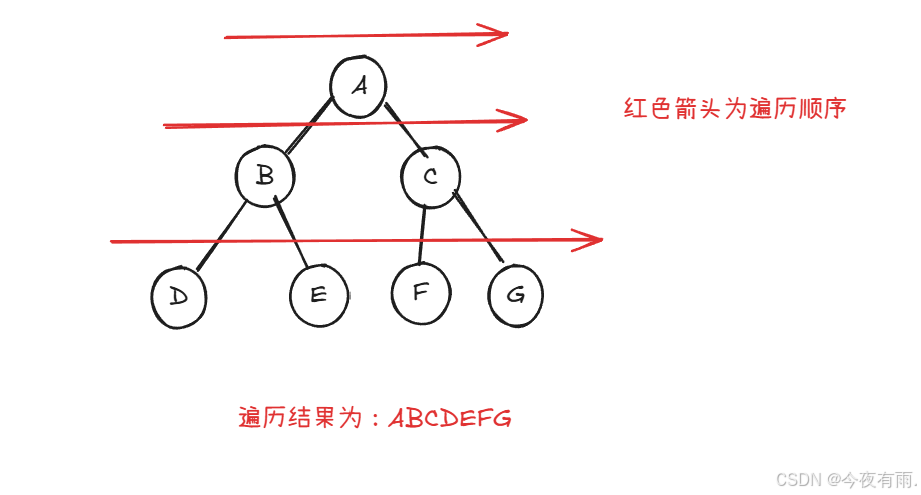
遍历二叉树是掌握二叉树结构的基础。前序遍历:适用于需要在访问节点时立即处理的情况,比如复制树结构。中序遍历:常用于需要按顺序访问节点的场景,比如在二叉搜索树中查找某个范围内的元素。后序遍历:通常用于需要在处理完所有子节点后才处理当前节点的情况,比如删除树。层次遍历:适合按层次处理树节点的问题,比如计算树的层数或查找某一层的所有节点。不同的遍历方式本质上是通过不同的顺序来访问树中的节点,理解这些遍历
数据结构和算法是计算机科学的基础,它们在计算机程序中扮演着至关重要的角色。在本文中,我们将探讨Java中的常用数据结构和算法,并深入了解它们的原理、应用和实现。Java是一种广泛使用的编程语言,它具有强大的功能和易用性,使得许多程序员选择Java作为他们的主要编程语言。Java的数据结构和算法库是其强大功能的基础,它们提供了许多内置的数据结构和算法实现,使得程序员可以更轻松地解决问题。背景介绍核心
前一篇文章我们详细讲了BFS的原理及实现,在使用BFS遍历图的过程中,我们可以对每个顶点进行标记,标记当前顶点距离源头顶点的距离。这个距离我们用int d[i]来存储,由于BFS的性质,d[i]中存放的就是源头顶点v到顶点i的最短路径。
【代码】【数据结构—图】邻接表与邻接矩阵的广度优先BFS遍历。
拓扑排序(topological sorting)介绍及Python实现,介绍了拓扑排序基本算法原理,并给出基于深度优先搜索和基于广度优先搜索的Python实现。
经典迷宫问题AC代码#include <iostream>#include <cstring>#include <algorithm>#include <queue>using namespace std;const int N = 110;int n, m;int g[N][N], d[N][N];typedef pair<int, int&
几道题目
【本节目标】1.树概念及结构2.二叉树概念及结构3.二叉树顺序结构及实现4.二叉树链式结构及实现
二叉树前序、中序、后序、层序遍历。(递归、非递归、morris遍历) C++语言实现
希望本文章可以帮助到刚学习到二叉树的同学。路漫漫,学习之路还很长远。
图的基本概念、图的存储结构、图的遍历、最小生成树、最短路径
题目链接:637. 二叉树的层平均值题目:给定一个非空二叉树的根节点 root , 以数组的形式返回每一层节点的平均值。与实际答案相差 10-5 以内的答案可以被接受。示例 1:输入:root = [3,9,20,null,null,15,7]输出:[3.00000,14.50000,11.00000]解释:第 0 层的平均值为 3,第 1 层的平均值为 14.5,第 2 层的平均值为 11 。因
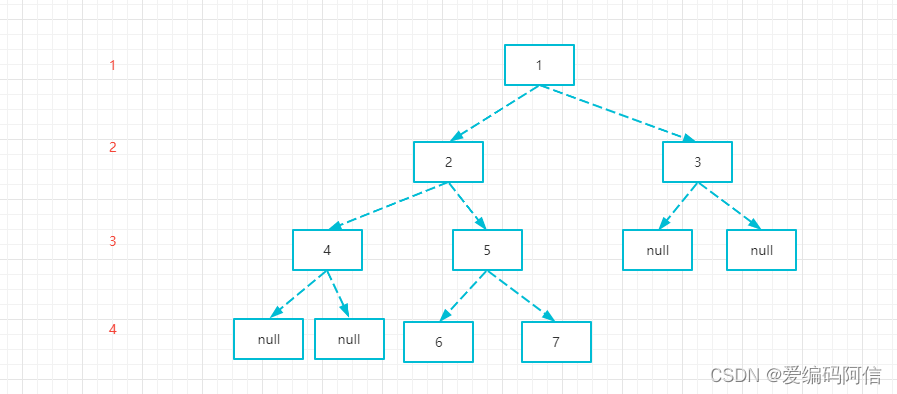
我们知道树/图的深度优先搜索使用递归可以很简单的实现,但树的广度优先搜索是依赖于队列先见先出的特性来实现的,不方便使用递归实现。今天我们来看看树的层序遍历方法,掌握了这个方法,广度优先搜索的大部分题都可以轻松解决了。1. 二叉树的层序遍历剑指 Offer 32 - I. 从上到下打印二叉树先看这个最简单的层序遍历,只需要按广度优先的顺序一个一个地输出节点值就可以了要点:头结点入队队列不为空时不断出
/原始字符串已经被访问过。
图论这一块非常抽象,难以理解,当然代码不一定都是最优解的代码,我只是大致模拟实现了一下
深度优先搜索(Depth-First Search,简称DFS)是一种用于遍历或搜索树或图的算法。DFS 算法的核心思想是尽可能深地搜索树或图的分支。当它从某个起始节点开始访问后,会沿着一条路径一直深入下去,直到无法继续(到达叶子节点或者所有相邻节点都已被访问),然后回溯到上一个节点,再尝试访问其他未被访问的分支,如此反复,直到所有可达节点都被访问。
本篇主要介绍图的存储结构之邻接表,邻接表比较特殊,要同时用到链表和数组
树和二叉树、堆(顺序结构)、二叉树链式结构
官解chatgpt这段代码实现了一个名为的方法,用于计算给定炸弹数组中,最多能够引爆的炸弹数量。该方法使用广度优先搜索(BFS)来遍历炸弹的引爆关系图,找出从每个炸弹出发能够引爆的最大炸弹数量。
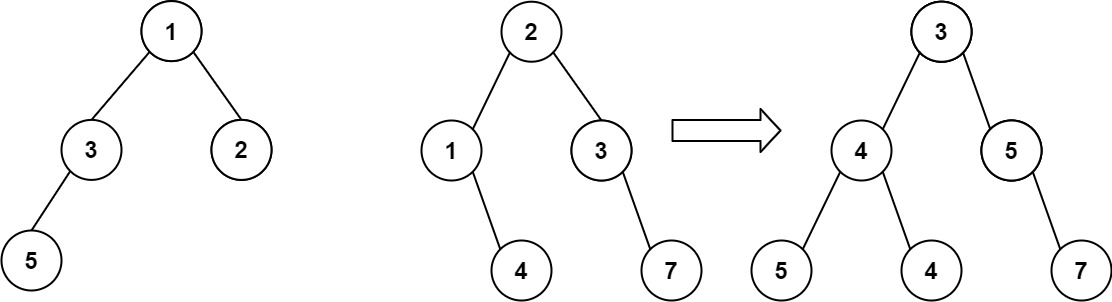
给你两棵二叉树: root1 和 root2 。想象一下,当你将其中一棵覆盖到另一棵之上时,两棵树上的一些节点将会重叠(而另一些不会)。你需要将这两棵树合并成一棵新二叉树。合并的规则是:如果两个节点重叠,那么将这两个节点的值相加作为合并后节点的新值;否则,不为 null 的节点将直接作为新二叉树的节点。返回合并后的二叉树。注意: 合并过程必须从两个树的根节点开始。
文章目录【 1. DFS 深度优先搜索 】1.1 基本原理1.2 C 实现【 2. BFS 广度优先搜索 】2.1 基本原理2.2 C 实现对存储的图中的顶点进行遍历搜索,常用的遍历方式有两种:深度优先搜索和广度优先搜索。【 1. DFS 深度优先搜索 】1.1 基本原理深度优先搜索的过程 类似于树的先序遍历,首先从例子中体会深度优先搜索。例如下图是一个无向图,采用深度优先算法遍历这个图的过程为:
(4)到这里我们看出所谓的S型遍历其实就变成了入栈顺序的变化 ,也就是没换一层,左右子节点的入栈顺序就变一次,所以我们固定1号栈就是逆序(右左)入栈,2号栈顺序(左右)入栈就实现了该题。(3)那怎么将第三行再顺序遍历呢?那就是按照7654入栈对吧,那按照第二层出栈顺序32,7654其实就是按照出栈元素的右左顺序入栈。(2)将1号中元素从栈中取出以后,再将子节点放入2号栈中,怎么使第二层的节点逆序遍
数据结构基础
最小生成树生成树的概念无向图的生成树最小代价生成树最小生成树的典型用途构造最小生成树算法MST概念普里姆算法(Prim)克鲁斯卡尔算法(Kruskal)两种算法比较最短路径问题第一类:求两点间的最短路径第二类:某源点到其他各点的最短路径最短路径算法单源点最短路径:迪杰斯特拉算法(Dijistra)所有顶点间最短路径:弗洛伊德算法(Floyd)有向无环图应用AOV网特点拓扑排序概念拓扑排序的方法拓扑
图论,拓扑排序,广度优先搜索
另一个bfs用来排除子岛屿,方法是从每个岛屿起始点的上方一个海水点开始遍历,注意有8个方向!2.边界是0~m-1和0~n-1,不是0~m和0~n。语句通常用于跳过当前迭代的剩余部分,直接进入下一次迭代。有时候,可能需要在嵌套循环中使用。这道题需要用两个bfs解决,一个bfs用来搜索有多少个岛屿(包括子岛屿)。一些需要注意的点:1.输入是一行连在一起的,所以要用字符串读入后拆分。语句,这时可以使用标
但是分治算法是寻找远小于原问题的子问题(因为对于计算机来说计算小数据的问题还是很快的),同时分治算法的效率并不一定好,而动态规划的效率取决于子问题的个数的多少,子问题的个数远小于子问题的总数的情况下(也就是重复子问题多),算法才会很高效。分治策略是:对于一个规模为n的问题,若该问题可以容易地解决(比如说规模n较小)则直接解决,否则将其分解为k个规模较小的子问题,这些子问题互相独立且与原问题形式相同
数据量较大的多重背包的优化问题
866数据结构、湖南大学考研、图
数据结构深度搜索+广度搜素
二叉树遍历、层序遍历:从上往下,从左到右。使用广度优先搜索算法
以C语言为基础实现一些经典的数据结构和算法,主要体会优秀的编程思想,细节实现有不足之处。
集合的子集求解
今天是拓扑排序算法~拓扑序列:设G = (V, E)是一个具有n个顶点的有向图,V中的顶点序列V1、V2、V3…Vn满足若从顶点Vi->Vj有一条路径,则在顶点序列中顶点Vi必在Vj之前。我们称其为拓扑序列拓扑排序:对DAG图构造拓扑序列的过程只有无环图才能产生拓扑序列。
定义:一个图GVEG = (V, E)GVE顶点集VVV(非空有限集)边集EEEVVV中元素的无序对或多重集)基本类型无向图:边没有方向,uv(u,v)uv和vu(v,u)vu表示同一条边有向图:边有方向,uv(u,v)uv表示从uuu到vvv的弧简单图:无自环(顶点到自身的边)且无平行边多重图:允许平行边加权图:边带有权重(距离、成本等)图论提供了一种统一的语言来描述离散结构中的关系。
本文系统介绍了图的两种核心遍历算法:深度优先搜索(DFS)和广度优先搜索(BFS)。DFS采用"一条路走到黑"的策略,适合深度探索场景如迷宫路径、拓扑排序等,可通过递归或栈实现;BFS采用"水波扩散"的层次遍历方式,天然适合解决无权图最短路径问题,通过队列实现。文章详细分析了两种算法的生活化理解、正式定义、代码实现(C++)、优缺点及适用场景,并提供了邻接表和链式前向星两种存储结构的实现示例。最后
广度优先
——广度优先
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 openEuler 社区


 乐奇 Rokid 开放社区




















 天工造物局