登录社区云,与社区用户共同成长
邀请您加入社区
另一个方面是自己缺乏练习,很多人学课程,看书,从来不自己操作,老想寻找一些面试题、某企业级数据集拿来分析一下,看看自己的水平,要对胃口的数据集其实很少的,即使有,也是美化版的,很多综合性的演练你还是学不到的,还不如随便爬一些数据,越乱越好(对练习工具操作有巨大好处),然后在现有数据的基础上看看可以分析出什么?从大数据培训学校的角度来说,学大数据的学员一般都是专科及以上,具有统计学之类的知识,有一定
pandas--DataFrame--数据切片/筛选/取值
如何搭建一套完整的数据指标体系?你在工作中是不是这样的经常听到这样的对话:老板:这次宣传活动总共带来了多少流量?你:大概有一万多人吧......老板:这次活动反响怎么样?你:有很多顾客都不满意......老板:最近生意怎么样?你:感觉我们门店都没什么顾客了......当老板问到相关问题时,大多数人都是这样随口一说。这种说法在日常生活中是没有任何问题的,毕竟谁也不会揪着非要问出个123。但是放在企业
第三章. Pandas入门—数据的增加,修改和删除
对pyecharts热力图生成的图标颜色进行控制。
SPSS问卷调查分析:以“生物医学工程(中外合作办学)对人才培养调查结果分析”为例
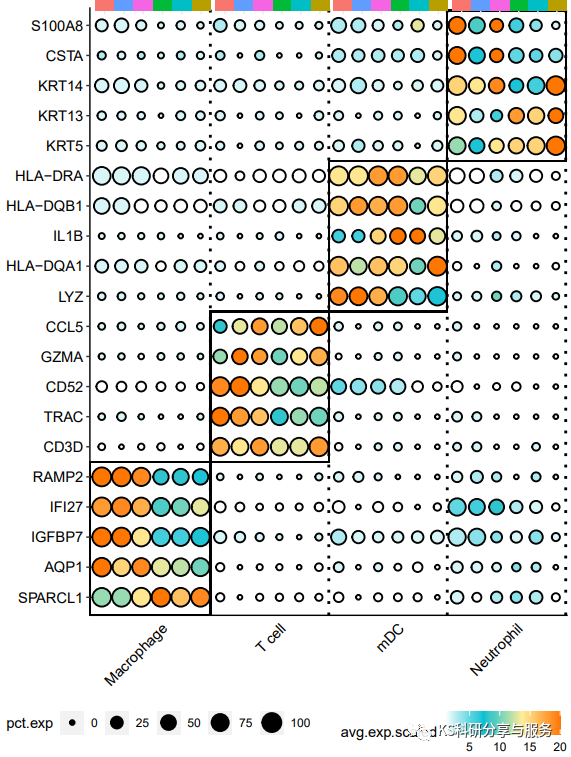
今天我们来复现一下一篇《cell》文章中的图标,图如下:(Liver Immune Profiling Reveals Pathogenesis and Therapeutics for Biliary Atresia)我们重点复现左边部分,右侧的作图在单细胞系列提到过:跟着Cell学单细胞转录组分析(十一):单细胞基因评分|AUCell评分,这里的复现不仅适用于单细胞,其他的数据也是可以做这样的
可以使用Python的第三方库"pandas"来打开Excel文件。首先需要安装pandas,在命令行或者终端输入以下命令进行安装:pipinstall pandas安装完成后,可以在Python程序中使用以下代码打开Excel文件:import pandas as pddf = pd.read_excel("file_name.xlsx")其中"file_name.xlsx"是要...
pandas追加写入excel行追加写入同一个excel下的同一个sheet主要参数:startrowwriter = pd.ExcelWriter(filepath)data = pd.read_excel(writer, index_col=None, header=None)data.to_excel(writer, startrow=0, index=None, header=None,
首先附上可以正常输出中文的完整代码。汉字乱码输出的解决方法是pd.read_csv函数要多携带一个参数encoding='gbk',指明编码方式。import pandas as pdimport osimport jieba.analysepinglun = " "# 全部评论内容组合__all__ = []for filename in os.listdir(os.path.dirname(_
python机器学习——聚类评估方法 & K-Means聚类 & 神经网络模型基础
结构方程模型是被广泛认可的研究可观测变量与潜在变量,以及潜在变量之间关系的重要工具。结构方程模型包括两个基本模型,分别为测量模型和结构模型,测量模型由潜在变量、观测变量以及测量误差项组成,主要分析潜在变量与观测变量的共变效果。路径分析在于研究模型影响关系,用于对模型假设进行验证。比如下图的模型框架:希望研究工作条件,人际关系对于公司满意度的影响;同时还希望研究公司满意度和机会感知对于离职倾向的影响
对于数据分析而言,数据大部分来源于外部数据,如常用的CSV文件、Excel文件和数据库文件等。Pandas库将外部数据转换为DataFrame数据格式,处理完成后再存储到相应的外部文件中。NumPy常用的导入格式:import pandas as pd相关案例与解析文件以及文件数据的导入与分析1.文本文件读取文本文件是一种由若干行字符构成的计算机文件,它是一种典型的顺序文件。txt文件:是Wind
个人主页:欢迎关注个人感悟: “失败乃成功之母”,这是不变的道理,在失败中总结,在失败中成长,才能成为IT界的一代宗师。
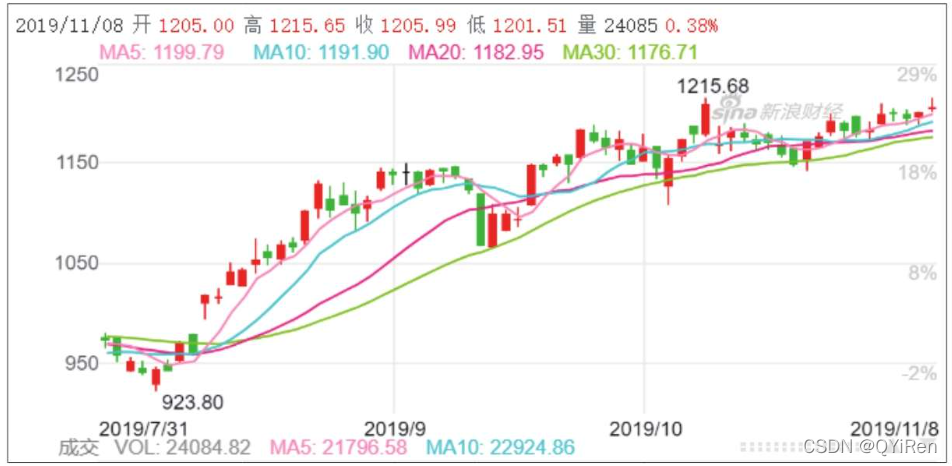
目录1 股票K线图知识了解2用Python绘制股票K线图2.1安装绘制K线图的mpl_finance库2.2引入相关库2.3用Tushare库获取股票基本数据2.4日期格式调整及表格转换2.5绘制K线图2.6添加均线图2.7添加每日成交量柱形图1 股票K线图知识了解下图所示为“贵州茅台”股票的日线级别的K线图:K线图中的柱形通常称为“K线”,因为形似蜡烛,所以也称为蜡烛图。K线是根据股票的4个价格
根据数据拟合曲线,并求曲线上某点的斜率、切线方程。
定义主成分分析是一种降维算法,它能将多个指标转换为少数几个主成分,这些主成分是原始变量的线性组合,且彼此之间互不相关,其能反映出原始数据的大部分信息。一般来说,当研究的问题涉及到多变量且变量之间存在很强的相关性时,我们可考虑使用主成分分析的方法来对数据进行简化。数据降维的作用降维是将高维度的数据(指标太多)保留下最重要的一些特征,去除噪声和不重要的特征,从而实现提升数据处理速度的目的。在实际的生产
bp神经网络原理详解(附python代码)
比如有下面一张excel表,我们需要得到“张思德”所在的行和列import pandasimport pandas as pdimport numpy as npdef get_coordinates(data: pandas.DataFrame, target: str):"""根据要查找的目标,返回其在excel中的位置data: excel数据,...
Doris的基本介绍和基本使用
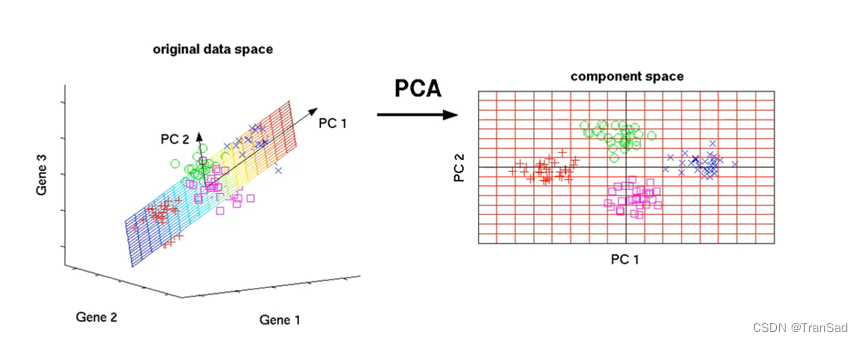
PCA全称是Principal Component Analysis,即主成分分析。它主要是以“提取出特征的主要成分”这一方式来实现降维的。介绍PCA的大体思想,先抛开一些原理公式,如上图所示,原来是三维的数据,通过分析找出两个主成分PC1和PC2,那么直接在这两个主成分的方向上就可以形成一个平面,这样就可以把我们三位的样本点投射到这一个平面上(如右图)。那么此时的PC1和PC2都不单单是我们的其
为了找到更符合数据的分析方法。每个方法有自己的假设,如果违背了结果会不精准。Sign Test 是一个可以用于任何数据分布情况的pairwise 方法。检查:Sample 数量 < 50,适用 Shapiro-Wilk,Sample 数量 >= 50,适用Kolmogorov-Smirnov。
在国家统计局采集全国各省市2016年运输线路长度数据,并用R语言进行系统聚类分析并画图。
excel的数据分析功能很强大,其中就包含了数据据预处理,数据分析,对数据进行建模等功能。
全面AI时代就在转角,道路已经铺好了“局外人”or“先行者”就在此刻等你决定 ,通过ChatGPT一站式掌握办公自动化/爬虫/数据分析和可视化图表制作,BAT大厂技术专家,实战ChatGPT项目。下单即终身学习,提供全部资料,帮助解决ChatGPT中学习遇到的问题。全面AI时代就在转角,道路已经铺好了“局外人”or“先行者”就在此刻等你决定。1、对ChatGPT感兴趣并希望有人手把手教学的新手。3
Pandas 提供了若干个函数来格式化时间。
【送书福利-第五期】北大出版社-《网络结构数据分析与应用》
例如,我们需要考察学生A和学生B的某门课程成绩。A的考试满分是100分(及格60分),B的考试满分是150分(及格90分)。显然,A和B的100分代表着完全不同的含义。
生信学习之通路富集(一)
Python爬虫框架的优点真是说也说不完,它可以让程序员以更少的代码实现自定义功能,还可以将更多的精力集中在业务逻辑上,更加的轻松便利。因此本文将为大家推荐十款常见且好用的爬虫框架。Scrapy是一个为了爬取网站数据,提取结构性数据而编写的应用框架。可以应用在包括数据挖掘,信息处理或存储历史数据等一系列的程序中。。用这个框架可以轻松爬下来如亚马逊商品信息之类的数据。
初步了解dataframe的数据分析,包括基本统计:describe分组分析:groupby(离散值分组)分布分析:cut+groupby(连续值分组)交叉分析:pivot_table(数据透视表)结构分析:pivot_table+sum+div(查比重)相关分析:corr(一维、二维)
在实际的数据处理中,缺失值是普遍存在的,如何使用 Python 检测和处理缺失值,就是本文要讲的主要内容。检测缺失值我们先创建一个带有缺失值的数据框(DataFrame)。import pandas as pddf = pd.DataFrame({'A': [None, 2, None, 4],'B': [10, None, None, 40],'C': [100, 200, None, 400]