- @weixin_56462041


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
时间复杂度。改进快速排序,如果每次划分取得基准元素都是最大或者最小的元素,那么排序会退化至==O(n^2^)==- 如何改进?1. 避免最坏的情况,使用数组中的一个随机元素作为划分元素,这样出现最坏情况的几率就会相对很小2. 取出数组的左边元素,中间元素和右边元素,然后对这三个元素进行排序,然后以中间的元素作为基准值key
由于动态规划解决的问题多数有重叠子问题这个特点,为减少重复计算,对每个子问题只解一次,将其不同阶段的不同状态保存在一个二维数组中。与分治法最大的区别是:适用于用动态规划法求解的问题,经分解后得到的子问题往往不是互相独立的(即下一个子阶段的求解是建立在上一个子阶段的解的基础上)
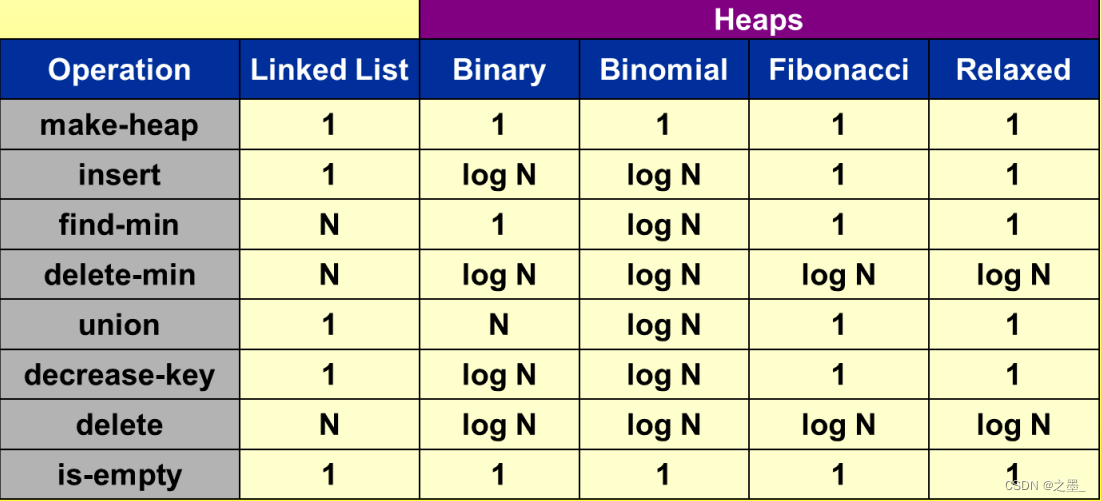
斐波那契堆历史:Fredman和Tarjan(1986)巧妙的数据结构和分析O(m+nlogn)O(m+nlogn)最短路径算法,也导致了更快的MST算法,加权二分匹配仍然领先于它的时代斐波那契堆直觉:类似于二项式堆,但结构不太复杂减少键和联合运行时间O(1)O(1)O(1)(均摊时间复杂度)“懒惰”联合斐波那契堆是以斐波那契堆数命名的,用于运行时间分析。
1在下图所示的各无向图中:(1)找出所有的简单环。 (2)哪些图是连通图?对非连通图给出其连通分量。正确答案:(1)所有的简单环:(同一个环可以任一顶点作为起点) (a)1231 (b)无 ©1231、2342、12341 (d)无(2)连通图: (a)、©、(d)是连通图, (b)不是连通图,因为从1到2没有路径。具体连通分量为: 2(1) 该图是强连通的吗? 若不是
本文详细介绍了如何在本地服务器上部署大模型(如DeepSeek、Llama3、Qwen等),并通过接口实现外部调用。首先,从HuggingFace或魔搭网站下载模型,使用git lfs和screen确保大文件完整下载;接着,使用FastAPI封装模型推理过程,支持多GPU运行并通过CUDA_VISIBLE_DEVICES指定显卡,提供完整的app.py代码实现模型加载和接口响应;然后,通过cond
标量、向量、矩阵和张量是线性代数中的基本数学对象。向量是对标量的泛化,矩阵是对向量的泛数。标量、向量、矩阵和张量分别具有零、一、二和任意数量的轴。通过sum和mean函数,张量可以沿指定轴降低维度。两个矩阵的按元素乘法称为Hadamard积,它与矩阵乘法不同。在深度学习中,常用的范数包括L1范数、L2范数和Frobenius范数。我们可以对标量、向量、矩阵和张量执行各种操作。
sonarqube7.5的压缩包里面有linux和windows的文件,所以你直接下载就可以了,不用分平台。查看你自己服务器的jdk版本,如果是1.8就安装sonarqube7.8及以下,否则后面会报错!如果你的电脑已经有了jdk1.8以及mysql5.7,那么你就可以直接使用如下两个版本了!如果出现错误很肯可能是你的数据库用户权限问题,或者是数据库版本问题,要仔细排查。而我电脑的mysql是8版
标量、向量、矩阵和张量是线性代数中的基本数学对象。向量是对标量的泛化,矩阵是对向量的泛数。标量、向量、矩阵和张量分别具有零、一、二和任意数量的轴。通过sum和mean函数,张量可以沿指定轴降低维度。两个矩阵的按元素乘法称为Hadamard积,它与矩阵乘法不同。在深度学习中,常用的范数包括L1范数、L2范数和Frobenius范数。我们可以对标量、向量、矩阵和张量执行各种操作。
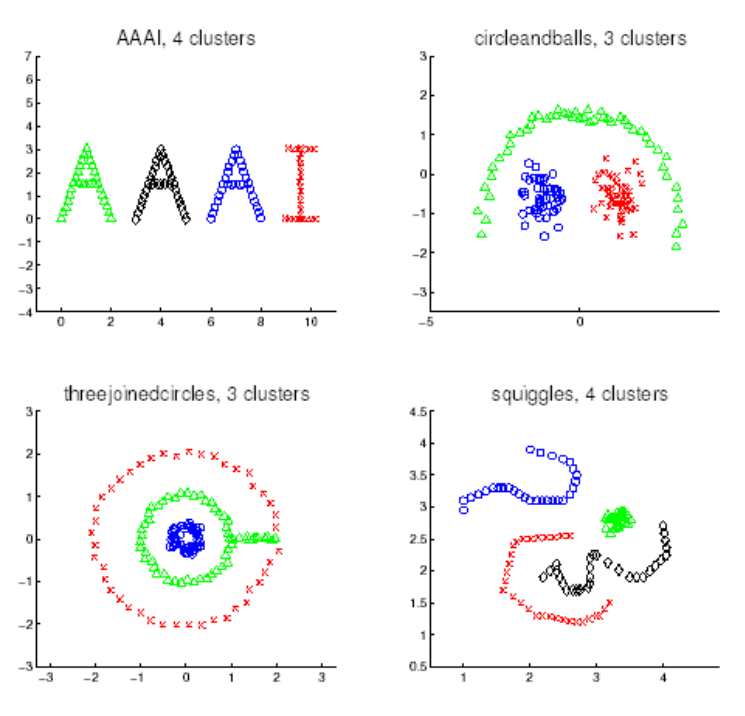
无监督学习是指在没有标签的数据上进行学习,即没有监督信号的指导下进行模型训练。在无监督学习中,我们主要关注从无标签数据中学习出数据的低维结构和隐藏的模式。K-means的目标是最小化所有数据点与其所属簇中心点之间的欧氏距离的平方和。,使得每个簇的样本到簇中心的欧氏距离和最小。步骤1:如果知道聚类中心,可以找到最佳。为将每个点分配到的簇,其中。输出:将每个点分配到一个簇中。表示第 i 个点所属的簇。
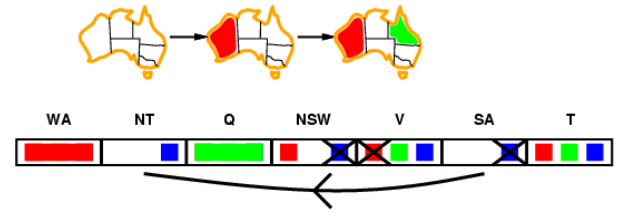
假设每个子问题有n个变量中的c个。最坏情况下的解决方案成本是。弧相容可以作为预处理运行,也可以在每次分配后运行。如果X丢失了一个值,则需要重新检查X的邻居。弧相容比前向检验更早检测到可能失败的情景。与一般CSP相比,最坏情况下的时间是。T和其它地区是独立的子问题,