- @weixin_51711289


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
题目给定一个单链表 L 1→L 2→⋯→L n−1→L n,请编写程序将链表重新排列为 Ln→L 1→L n−1→L 2→⋯。例如:给定L为1→2→3→4→5→6,则输出应该为6→1→5→2→4→3。输入格式:每个输入包含1个测试用例。每个测试用例第1行给出第1个结点的地址和结点总个数,即正整数N (≤10的5次方)。结点的地址是5位非负整数,NULL地址用−1表示。接下来有N行,每行格式为:Ad
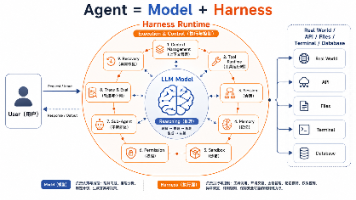
过去一段时间,我对 Agent 的关注点其实发生了明显变化。模型选哪个?Prompt 怎么写?Function Calling 准不准?Planner 怎么设计?Tool 为什么可以被执行?错误参数为什么没有被拦住?任务状态到底存在哪里?程序崩溃以后怎么继续?Tool 执行一半怎么办?上下文爆炸怎么办?子 Agent 的 Context 怎么隔离?模型为什么有权限访问这个文件?这条 Agent 轨
问题简介有限的条件下,最大的收益。例:线性规划问题,我们首先就是需要将文字内容转变为数学表达式,如下图:当得到这一组公式之后,我们也就是得到了一个线性规划模型,然后通过这个模型我们求出最大值或者最小值即可。“线性”意味着所有变量都是一次方。适合的题目:“怎样安排”,“尽量多少”,“最多(少)”,“利润最大”,“最合理”等词。matlab求解Linprog函数有一点需要注意,这个函数只能求的是目标函
机器学习中的数据归一化
定义与插值问题不同,在拟合问题中不需要曲线一定经过给定的点。拟合问题的目标是寻求一个函数,使得该曲线在某种准则下与所有的数据点最为接近,即曲线拟合的最好(最小化损失函数)。插值和拟合的区别插值算法中,得到的多项式f(x)要经过所有样本点。但是如果样本点太多,那么这个多项式次数过高,会造成龙格现象。尽管我们可以选择分段的方法避免这种现象,但是更多时候我们更倾向于得到一个确定的曲线,尽管这条曲线不能经
监督学习给机器的训练数据拥有“标记”或者“答案”。就比如上图的MNIST数据集,我们需要给出每一行所对应的数字,机器才能学习。这里监督的意思就是我们人类给机器的信息已经进行了正确答案的划分。例:银行已经积累了一定的客户信息和他们信用卡的信用情况。监督学习主要处理的是分类和回归问题。算法:k邻近,线性回归和多项式回归,逻辑回归,SVM,决策树和随机森林。在以后的文章中我们都会慢慢介绍。非监督学习给机
基本概念如上图中为著名的鸢尾花数据,下面围绕鸢尾花我门来了解一些定义:数据整体叫做数据集。每一行数据为一个样本。除最后一列为,每一列表达为样本的一个特征。最后一列称为标记。如果我们选取第一列和第二列的数据建立关系,可以得到下面的图,这个图也被称为特征空间。根据这个特征空间我没可以明显的看出鸢尾花被分为两类,一类我们标记为红色,一类标记为蓝色。然后我们可以通过一条直线将他划分为两部分,得到下图:将他
蓝桥天梯常用STL库,vector,set,map,queue,stack