


- @m0_56006701


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
本文主要介绍hive的一个案例实战,以及相关hive语句的书写,案例仅供参考
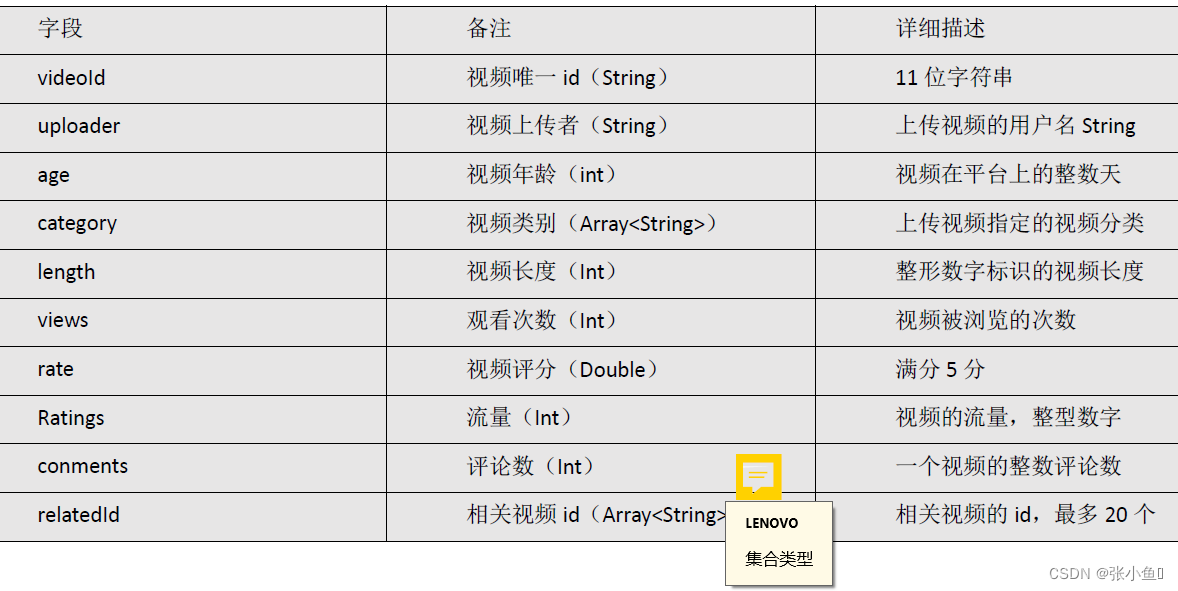
本文主要介绍hive的基本概念以及hive客户端在centos7集群模式下的安装与部分出问题地方的解决方法。1) hive 简介Hive:由Facebook 开源用于解决海量结构化日志的数据统计工具。Hive 是基于Hadoop 的一个数据仓库工具,可以将结构化的数据文件映射为一张表,并提供类SQL 查询功能。2) Hive 本质:将HQL 转化成MapReduce 程序(1)Hive 处理的数据
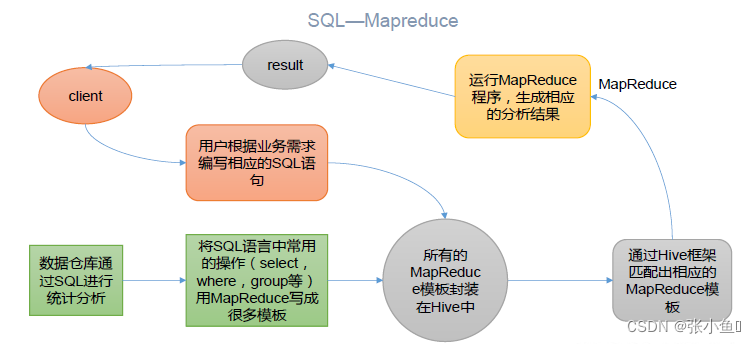
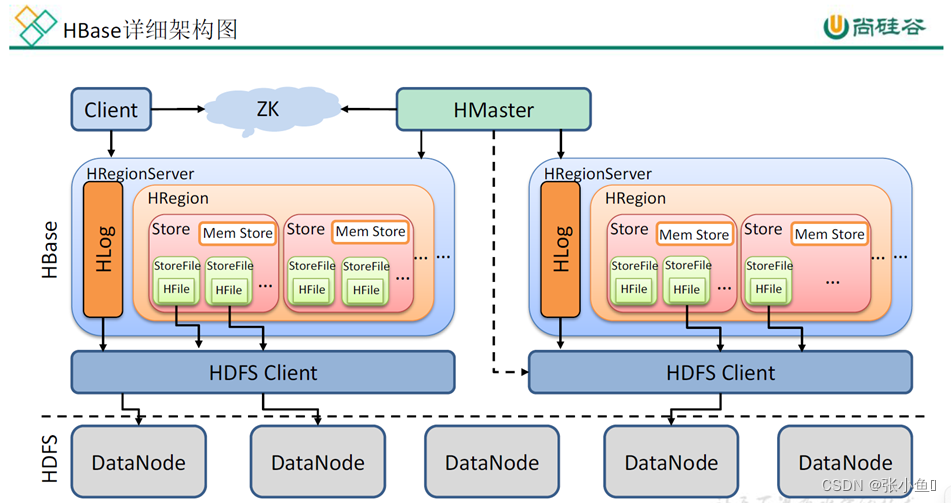
本文主要介绍hbase的写和读流程,以及zookeeper在客户端查看hbase的meta内容。本文案例仅供参考。flash +表即可以将hbase的内容写入,不写入数据还是在内存当中以上就是hbase的进阶内容,如有问题、建议,请您在评论区留言💬哦。
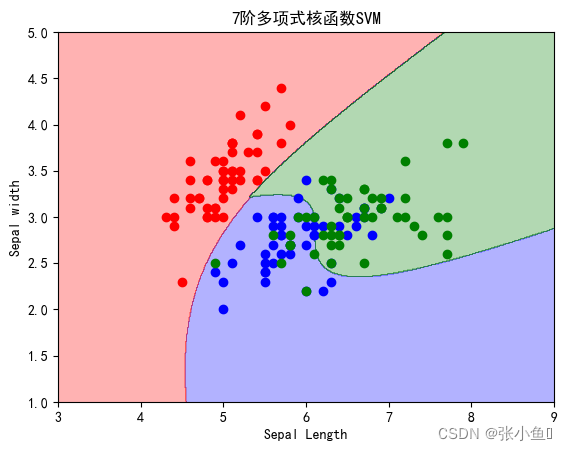
本文简单介绍SVM分类器、以及核函数、SVM分类器的应用。以下案例经供参考SVM是按照监督类学习方式进行运作的。即:数据当中含有目标值。SVM采用监督学习方式,对数据进行二分类(这点跟逻辑回归一样)。但是,SVM和逻辑回归(LR)有有很多不同点。两者的相同点二者都是线性分类器二者都是监督学习算法都属于判别模型(KNN, SVM, LR都属于判别模型),所谓判别模型就是指:通过决策函数,判别各个样本
kd树(k-dimensional树的简称),是一种分割k维数据空间的数据结构,主要应用于多维空间关键数据的近邻查找(Nearest Neighbor)和近似最近邻查找(Approximate Nearest Neighbor)。其实KDTree就是二叉查找树(Binary Search Tree,BST)的变种。二叉查找树的性质如下:1)若它的左子树不为空,则左子树上所有结点的值均小于它的根结点

DT-Decision Tree决策树,GB是Gradient Boosting,是一种学习策略,GBDT的含义就是用Gradient Boosting的策略训练出来的DT模型在前几年深度学习还没有大行其道之前,GBDT在各种竞赛是大放异彩。一是效果确实挺不错。二是即可以用于分类也可以用于回归。三是可以筛选特征

BIRCH(Balanced Iterative Reducing and Clustering using Hierarchies,平衡迭代规约和层次聚类)是一种基于树结构的聚类算法,其主要思想是使用一棵 CF 树(Clustering Feature Tree,聚类特征树)来表示数据集,通过不断对 CF 树进行迭代规约和层次聚类来实现对数据集的聚类。该算法具有高效性和可扩展性,并且可以处理大数

假设有一个数据集包含 $n$ 个点,每个点有 $m$ 个特征,现在需要将这些点分为 $k$ 个簇。其中,$a_i$ 表示数据点 $i$ 到其所属簇中所有其他点的平均距离,$b_i$ 表示数据点 $i$ 到距离它最近的其他簇中所有点的平均距离,轮廓系数的取值范围为 $[-1, 1]$,值越大则表示聚类效果越好。根据轮廓系数的取值范围,可以评估聚类效果的好坏。其中,$n$ 表示数据点总数,$k$ 表示
本文主要介绍关联分析算法简介以及相关的案例举例说明与代码解释关联分析算法是一种用于挖掘大规模数据集中有趣关系的方法。其目标是找出数据集中频繁出现的item集合,以及item之间的关联规则。1. 数据预处理:读取数据集,计算每个item的出现次数,并按照出现次数从高到低排序。2. 生成候选项集:从单个item开始,逐步生成包含多个item的项集。3. 计算项集的支持度:对于每个项集,计算其在数据集中

随机森林也是基于决策树的算法,只不过是利用集成的思想来提升单颗决策树的分类性能。主要特点是由于随机选择样本和特征,所以不容易陷入过拟合。随机森林算法的主要步骤从样本集中用Bootstrap随机选取n个样本,并从所有属性中随机选取K个属性,选择最佳分割属性作为节点建立分类器(CART,SVM等)重复以上m次,即建立了m个分类器,并通过投票表决结果,决定数据属于哪一类。随机森林是一种集成学习算法,它将
