登录社区云,与社区用户共同成长
邀请您加入社区
分享以 skill-ledger 为例,展示覆盖 Skill 引入、变更与使用的安全管理能力,推动安全防护从分发前审核延伸至使用过程中的持续校验与执行约束,让 Skill 在开放复用的同时保持可追溯、可审查、可管控。未来将向全生命周期运行治理延伸:构建上架到执行的纵深防御体系,把 Token 成本转化为可治理资源,实现分层快照与中断恢复,让 Skill 不只可分发,更可约束、可度量、可恢复。
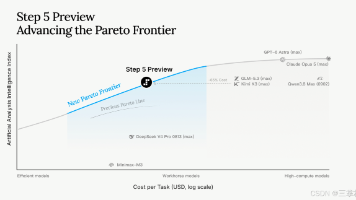
9月20日,阶跃星辰发布了新模型 Step 5 Preview。距离上一次发布 Step 3.7 Flash还不到四个月,版本号就从3.7直接跳到了5。这个跨度不小,至少从命名来看,阶跃星辰对这次升级很有信心,也把大家的期待值拉高了。
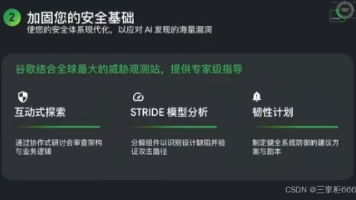
本文基于思捷科技与 Google Cloud 联合发起的技术研讨会内容整理,聚焦 AI 时代云原生安全的攻防不对称、谷歌四阶段漏洞管理方法论、企业级 AI 威胁防御架构,以及 Agent 间接提示词注入的三层防护实践。
<think>我们根据用户要求,生成≤150字的文章摘要。内容围绕Wi-Fi 6核心技术(OFDMA、MU-MIMO、BSS着色、TWT)及其成本影响。需要浓缩要点。用户提供了文章正文,需生成摘要。注意字数限制。用中文。摘要应包括这些技术的作用和成本原因。</think>本文介绍了Wi-Fi 6的四大核心技术:OFDMA提升多设备并行效率,MU-MIMO增强并发吞吐,BSS着色减少邻网干扰,TWT
如今AI编程工具全面普及,Copilot、各类AI代码助手让开发效率大幅提升。从前需要反复打磨、逐行编写的代码,现在几秒就能批量生成。但很多开发者都会发现一个奇怪的现象:写代码的门槛变低了,项目维护的压力却越来越大
在人工智能飞速迭代、全域智能化落地的当下,算法、模型、算力早已成为技术深耕的基础能力,而博弈思维,是贯穿人工智能决策、商业竞争、资源博弈、智能交互的底层核心逻辑,更是高阶技术人才、科研从业者、行业实践者必备的核心素养。
当下,AI 早已不是遥不可及的科技概念,而是各行各业企业升级迭代的核心抓手。几乎所有企业都在谈 AI 转型、数字化升级,不少团队盲目跟风采购智能工具、上线大模型系统、搭建数字化平台,投入大量人力、财力、时间,最终却陷入“装样子、走过场”的尴尬困境:工具堆砌不少,业务效率毫无提升,组织架构依旧僵化,AI 沦为闲置的“摆设”,转型变成一场昂贵的试错。
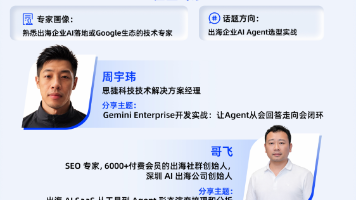
本文整理自思捷科技与 Google Cloud 联合推出的第二期线上研讨会核心内容,本次研讨会聚焦 AI Agent 从 "能回答" 到 "能闭环" 的落地路径,邀请思捷科技技术解决方案经理周宇伟、AI 出海资深从业者哥飞两位跨领域嘉宾,从企业级落地实战与商业化出海视角输出一线经验。
最近拿到一块乐鑫出的开发板,型号是 ESP32-P4X-C5 Function EV Board V2.0。说实话第一眼看到它的时候我是有点惊讶的——这块板子把"多媒体 + AI + 多协议无线 + 有线网口"全部塞进了一块 PCB 里,几乎可以当一台小型 AI 终端来用。今天就把这块板子掰开揉碎讲一遍,从芯片选型到硬件功能,再到能落地的行业方案,一次性说清楚。总的来说,这块 ESP32-P4X-
文章摘要: 本文介绍了如何通过Python调用大模型API,并深入探讨了Tool Calling技术如何让大模型从“会聊天”升级到“会做事”。作者展菲(技术博主、图书作者)以天气查询和计算器为例,解释了大模型如何通过工具调用(Tool Calling)与外部系统交互,完成实时任务。文章详细拆解了Tool Calling的完整工作流程,包括工具定义、参数传递、执行与结果反馈,并提供了代码示例说明如何
本文由资深AI开发者展菲撰写,深入探讨了Python在AI领域的核心地位。文章指出,尽管AI技术日新月异,但Python依然是AI开发的通用语言,原因在于其作为"技术连接器"的关键作用——PyTorch、TensorFlow等主流框架优先支持Python,而底层计算则由CUDA/GPU处理。作者详细解析了Python在数据处理、模型训练、AI推理和Agent开发四大场景的应用优势,并强调其简单易学
《从单体到微服务:Multi-Agent架构如何重塑AI系统》摘要:本文探讨了AI系统从单Agent向Multi-Agent架构的演进过程。作者指出,随着任务复杂度提升,单Agent系统面临Prompt膨胀、上下文爆炸、推理成本攀升等问题,这与早期单体软件架构的困境如出一辙。Multi-Agent架构通过专业分工(如Planner、Data、Report等独立Agent)显著降低系统复杂度,其设计
人工智能早已不再是只存在于科研实验室里的前沿概念,而是渗透进日常办公、衣食出行、工业生产、医疗教育等方方面面的实用技术。不管是日常使用的智能对话工具、一键生成图文视频的创作软件,还是工厂里自动作业的机械臂、出行时辅助驾驶的车辆,背后都离不开 AI 技术的支撑。
大模型技术这几年一路狂飙,算力和模型能力早就不是瓶颈了,但 Gartner 的数据却给行业泼了盆冷水,2026 年预计会有超 60% 的企业 AI 项目烂尾,核心症结其实不在模型,而是数据基础设施彻底跟不上了。
很多人认为,Agent 只是让大模型多了一双"手"。实际上,Agent 更像是让大模型拥有了一套完整的工作流程。相比传统 ChatBot,一次 Agent 任务可能包含几十次模型推理、多个工具调用以及持续增长的上下文。因此,一个 Agent 消耗的算力,往往远超一次普通对话。随着 Agent 应用越来越普及,真正决定 AI 成本的,也不再只是 GPU 的算力,而是整个执行链路的效率。
2026 年的企业 AI 赛道,全面进入“能不能用好 AI”的价值兑现期,Google Cloud 在今年 4 月的 Next 2026 大会上正式提出 Agentic Enterprise(智能体企业) 全新战略,将 Gemini Enterprise Agent Platform 定位为 Vertex AI 的进化核心载体,直指当前企业 AI 落地的普遍痛点。
本文探讨了AI基础设施中带宽(Bandwidth)的重要性日益凸显的现象。随着GPU算力提升,大模型推理性能的瓶颈已从计算能力转向数据传输效率。文章分析了GPU"吃不饱"的原因:Transformer架构需要频繁访问模型参数和KV Cache,使AI推理成为内存和带宽密集型任务。作者指出,现代AI优化已进入"数据流时代",需要关注整个计算链路的数据传输能力,包括HBM、PCIe、NVLink等各个
大模型时代的存储瓶颈:从算力驱动到存力驱动的范式转变 本文探讨了AI基础设施领域正在发生的重大转变:从算力优先(Compute First)转向存力优先(Memory First)。文章指出,随着大模型规模扩大,GPU计算能力提升速度已远超内存供给能力,导致GPU利用率低下而显存频繁爆满。作者详细剖析了AI Memory的复杂构成(包括HBM、KV Cache、激活值等),揭示了GPU因等待数据搬
文章摘要: 本文详细介绍了如何利用高德开放平台创建Web地图应用并完成技能调用的完整流程。首先指导用户注册账号、完成实名认证,创建应用并获取JS API Key。随后演示了网页端调用技能的具体步骤,包括下载Demo项目、配置密钥、浏览器运行和验证调用。接着重点讲解了使用OpenClaw工具完成技能调用的方法,涵盖环境配置、工具安装、初始化设置、网关管理以及通过可视化面板安装技能的完整过程。文章提供
在软件工程快速迭代、技术框架不断更新的时代,很多技术书籍转瞬就会被时代淘汰。但总有少数经典,能够跨越技术周期,成为一代代开发者的底层必修课。Bob大叔(Robert C. Martin)作为软件工程领域的标杆级人物,其著作多年来深刻影响着全球程序员的编码习惯、工程思维与团队研发理念,是无数人入门进阶、搭建专业技术体系的核心参考书。
现在市面上能调用的模型确实越来越多了,各家都有自己的亮点和侧重点,光看宣传文档和跑分数据其实很难判断哪个真正适合自己——尤其是当任务从单轮对话延伸到多步操作的时候,情况就更加复杂了。所以我就想着,不如把几个主流模型都拉出来实际跑一遍,看看它们真实表现到底如何,也好给自己找个手感。
摘要: Agent系统中KV Cache的指数级增长是导致GPU显存爆炸的核心原因。与普通ChatBot的线性KV Cache增长不同,Agent的多轮内部推理循环(如Tool Call、Memory Injection、Multi-Agent交互)会形成树状KV Cache结构,显存消耗随步骤、工具调用和记忆注入叠加而激增。解决方案包括分层管理KV Cache(热/温/冷缓存)、压缩记忆、限制推
《Transformer推理显存黑洞:KV Cache的技术内幕与优化全景》 摘要:KV Cache是Transformer推理过程中鲜为人知却至关重要的显存消耗源。作为自回归生成的历史状态存储器,它逐层缓存Key/Value张量,导致显存占用随token数和用户数线性增长(如70B模型单用户可达4-8GB)。本文揭示了KV Cache导致GPU低利用率的核心矛盾,剖析了vLLM的PagedAtt
当下,AI编程正告别“工具辅助写代码”的初级阶段,迎来历史性范式拐点。过往依托大模型的代码生成、智能补全等能力,仅实现了开发效率的单点提升,始终未能突破“人主导、AI辅助”的传统开发逻辑,无法适配复杂项目、全链路交付、持续迭代的工业化软件工程需求。
最近这段时间,国内外模型更新得很快。如果只看发布会和榜单,大家都会觉得每个模型都很强。参数更大、上下文更长、推理更强、价格更低,听起来都挺猛。但真正用到工作流里,会发现另一件事:模型强不强,不只看它会不会回答问题,还要看它能不能把一个任务完整跑完。