登录社区云,与社区用户共同成长
邀请您加入社区
未来,沐曦股份将持续深化与产业链上下游伙伴的合作,加速GPU产品、软件生态、基础设施与行业应用之间的融合,推动国产算力在真实业务场景中从“可用”走向“好用”,为人工智能产业发展和数字经济建设提供更加坚实的算力底座。中心由沐曦股份与行业前列的算力产业链伙伴共同建设,双方基于曦云C600系列GPU,围绕集群、软硬件一体化能力开展联合创新,进一步推动集群系统级联合调优,面向行业客户提供算力服务与应用开发
过去两年,一句听上去像科幻小说的判断,正从极客论坛走进主流视野:先进人工智能有可能导致人类灭绝。更耐人寻味的是,说出这句话的不是科幻作家,而是站在全球最前沿AI实验室里的工程师与研究者——那些亲手把模型推向更强能力的人。MIT Technology Review 举办的这场圆桌对话,正是围绕这个尖锐问题展开:AI真的可能杀死我们所有人吗?与会者试图把情绪化的争论拆解成若干可讨论的层次——恐惧从哪里
智能体从生成方案到自主执行,关键在于治理能力与信任机制的建立。《人工智能安全治理框架3.0》强调全生命周期管理,推动身份权限、人工控制、审计追溯等机制融入业务流程。通过开源项目ACC与百灵中枢,构建可复用、可验证的能力契约与执行控制层,实现跨系统、跨模型的治理一致性。唯有让组织清晰界定委托边界、保留关键决策权,并确保执行可核对,智能体才能真正融入真实业务,释放自动化价值。可信可控的治理,是智能体深
工行ITBP官。根据工信部「人工智能+软件」专项行动方案,结合ITBP职能特点,从AI思维建立、技术原理深入、业务连接三阶段设计学习路线,包含提示词、智能体、智能编程、采购分析等实战方法,遵照方案六大方向分解学习重点与资源。
9月14日,上海人工智能实验室开源 ATRIA Dawn Preview 模型。同日,凭借自研高性能通用 GPU 与 MXMACA 软件栈一体化协同的产品优势,沐曦股份率先完成对 ATRIA Dawn Preview 模型的 Day 0 适配,实现“上线即适配”
国产MQTT协议栈XXLMQTT可有效替代Mosquitto/EMQX,规避GPL版权传染风险,实现无依赖、无审计压力的商用合规。其纯C自研架构支持MQTT 3.1.1/5.0双协议,具备高并发、多部署形态与多语言动态库集成能力,迁移仅需替换服务端与SDK,标准客户端无缝对接。适用于信创、等保项目,提供永久授权、无年费流量费,助力企业安全可控落地物联网系统。
本文深入探讨了企业在大模型应用落地时,仅依赖向量数据库的局限性,并介绍了AI原生数据库Infinity如何通过融合向量搜索、全文检索和结构化查询能力,提供一站式数据解决方案。Infinity开源项目旨在简化技术栈,解决数据一致性、权限过滤等企业级痛点,助力开发者高效构建RAG等AI应用。
继率先推出首个,上海人工智能实验室(上海AI实验室)于5月15日开源了新一代大模型预览版,进一步拓展“可深度专业化通用模型”的能力边界并大幅降低使用门槛。
场景推荐方案快速体验/演示,5 分钟搞定生产环境二进制部署 + systemd 托管K8s 环境Helm 部署需要边缘告警中心端 Docker Compose + 边缘二进制 n9e-edge。
另外workflows还有多角度探索、对抗性验证、方案投票机制,这也就是为什么它准确率更高的原因,靠规模取胜,同一个问题让5个agents同时去跑,然后再由一个agent汇总起来,确实更准确了,token也花的的飞起。OpenWorkflows的主界面大概分成四块:左侧是 workflows 历史,中央是可视化画布,右侧是节点属性和常用提示词,底部是 AI 输入与返回。右侧节点属性里可以看到选中节
8× H200 节点跑 DeepSeek-V3 671B FP8 原生,单节点 1,500–2,500 tok/s 总吞吐(SGLang / vLLM,batch 64+),参考 SGLang DeepSeek V3 benchmark 与 vLLM benchmark 报告。Qwen3-235B-A22B INT4(~120GB)可以,TP=2 单流 60–80 tok/s,batch 32 稳
无论你是想摆脱 K8s 的学习负担,还是想给公司搭建一套好用的 DevOps 平台,Rainbond 都是一个非常值得尝试的选择。如果你是开发者,并且正巧在被 Kubernetes 的各种 YAML 配置折腾得头大,这个开源项目肯定能让你眼前一亮。:GitHub 上 6.1K+ Star,经过大量企业实践验证,不是那种只能玩玩的 Demo 项目。:通过应用级抽象,把复杂的容器编排变成可视化操作,普
摘要:本文探讨Locust在容器化环境下的性能测试实践,通过Docker和Kubernetes实现百万级并发测试。重点包括:1)环境搭建,如自定义Docker镜像和K8s集群配置;2)测试流程优化,包括脚本编写、参数化和资源监控;3)调优策略,如网络优化和弹性伸缩。结果显示容器化部署显著提升效率,响应时间降低75%,资源利用率提高40%。建议结合CI/CD实现自动化测试,并关注Serverless
上海交通大学的大模型超超超级牛掰的大模型编程实战课公开了,课件+教程,本套实战教程旨在提供大模型相关的入门编程参考。
继1月27日开源高精度空间感知模型 LingBot-Depth后,蚂蚁集团旗下灵波科技1月28日宣布全面开源具身大模型 LingBot-VLA。作为一款面向真实机器人操作场景的“智能基座”,LingBot-VLA 实现了跨本体、跨任务泛化能力,并大幅降低后训练成本,推动“一脑多机”走向工程化落地。
大语言模型(LLM)是基于自监督学习预训练的深度学习模型,训练数据量庞大、训练时间长,并且包含大量的参数。LLM在过去两年中彻底改变了自然语言处理领域,展现了在理解和生成类人文本方面的卓越能力。
还有人没看过这本书嘛?从基础的自然语言处理技术走向大模型的深度学习与实际应用,全网爆火,449页!
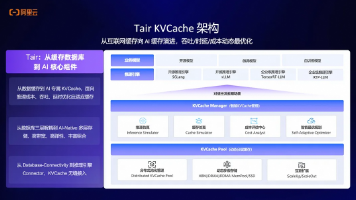
立春之际,阿里云瑶池发布 Tair KVCache——面向大模型推理的缓存加速方案,开源 KVCache Manager 与 HiSim 仿真工具,推出企业级云服务。联合 NVIDIA、SGLang 等共建“计算-存储-调度”一体化AI基础设施,突破显存瓶颈,降低90%+显存占用,助力高效低成本 AI 推理。
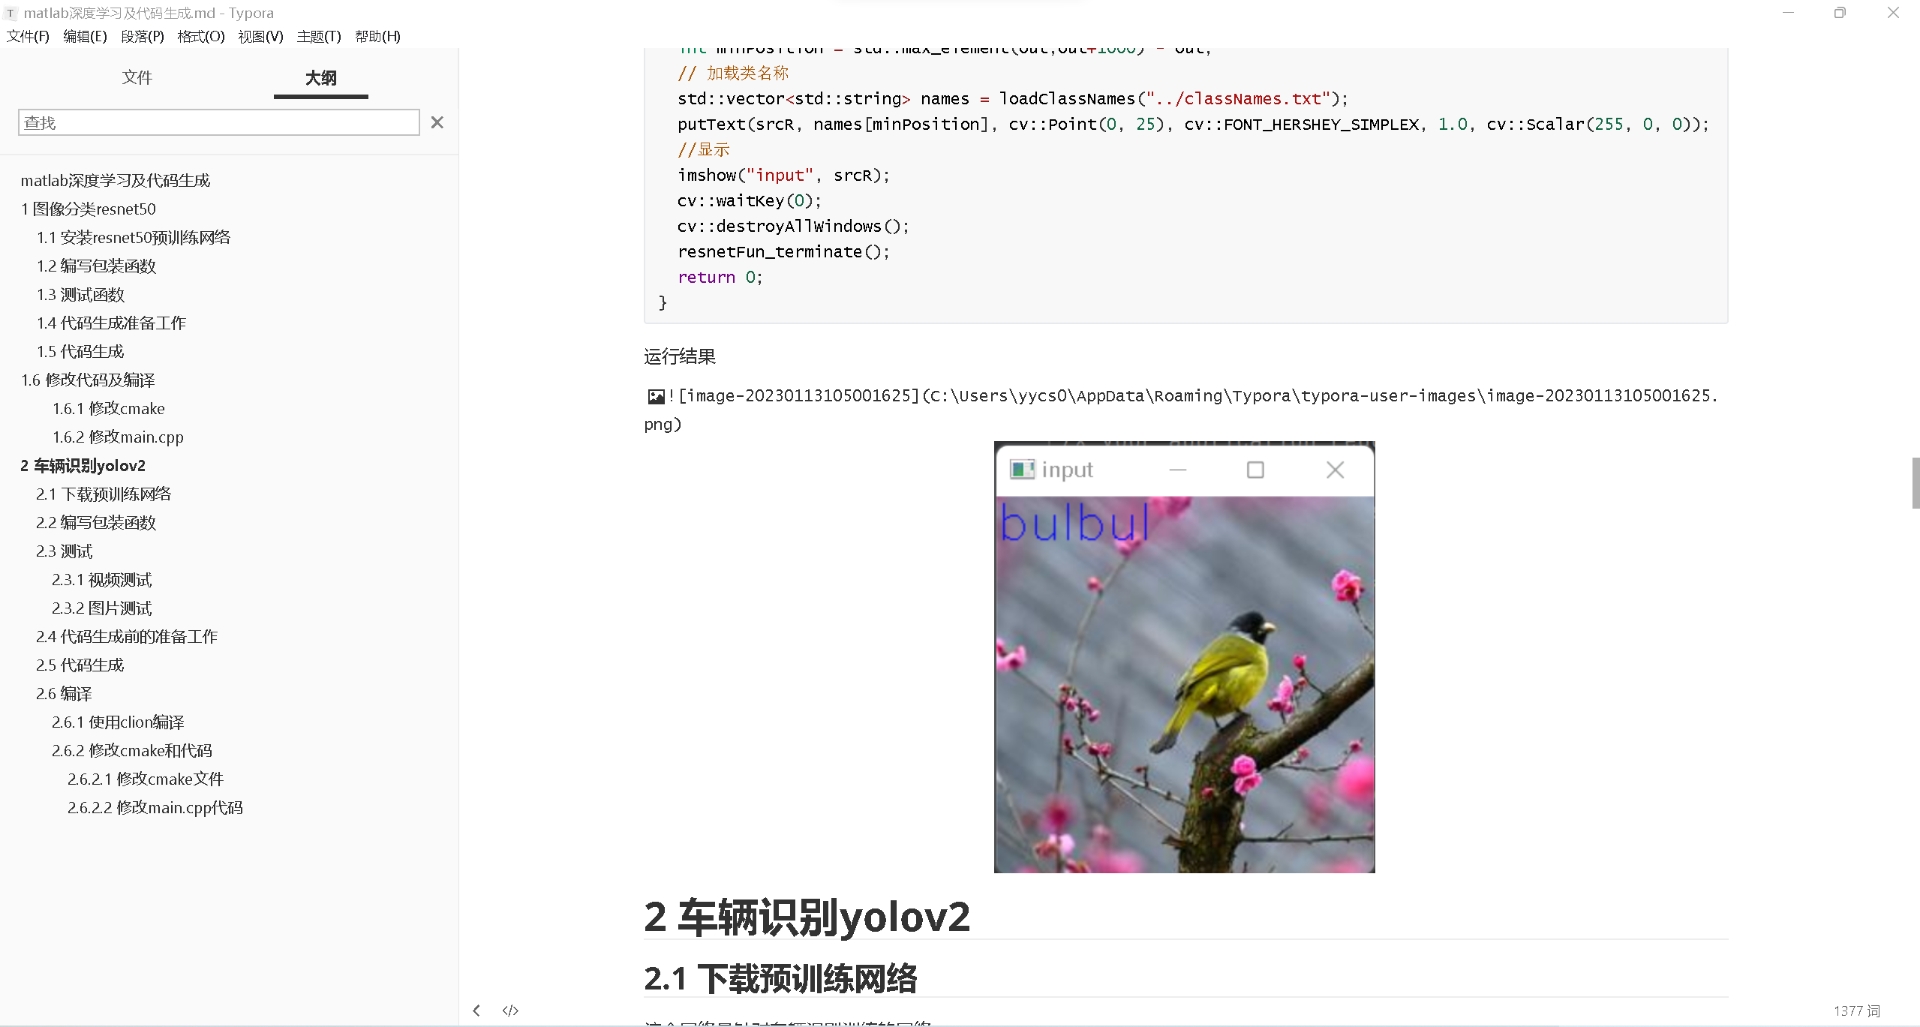
生成的C++代码里有个yoloFilter层实现特别巧妙——用查表法优化了sigmoid计算,实测在Jetson Nano上能跑到25FPS。不过要注意输出是双分支结构,一个是二值掩码,另一个是颜色嵌入向量,需要自己写后处理合并结果。建议用MATLAB Coder生成接口类,再继承实现业务逻辑,这样既保留生成代码的效率,又能灵活扩展功能。最后吐槽下文档,案例里的编译选项都是理想情况,真实项目里遇到
Admin.NET.Common放基础工具类Admin.NET.Core放框架核心类库。