
【论文阅读】Agent 记忆机制(18):MemCon——将记忆访问变成可在线学习的控制过程
文章目录
前言
前面阅读 Agent 记忆论文时,我们更多关注的是两个问题:
应该保存什么?
应该如何组织已经保存的记忆?
例如:
- Mem0 关注事实记忆的新增、修改、删除和忽略;
- A-MEM 关注记忆之间如何建立动态关联;
- G-Memory 使用图结构组织任务经验和推理规则;
- Voyager 将成功轨迹抽象成可以复用的技能;
- MemoryBank 通过遗忘机制控制记忆的生命周期。
这些方法都在改进记忆本身,但在实际 Agent 系统中,还有一个容易被忽视的问题:
即使记忆库中已经保存了正确经验,Agent 也不一定会在正确的时间,以正确的方式使用它。
许多记忆系统采用固定的访问流程:
每一步都检索;
固定召回 Top-K 条记忆;
固定使用一种查询语句;
固定执行一跳或多跳搜索;
按照固定周期整理记忆。
这种方式实现简单,但没有考虑 Agent 当前所处的状态。
例如,在任务刚开始运行、记忆库几乎为空时,大量检索不仅没有帮助,还会增加上下文长度;当 Agent 已经陷入重复动作时,再次返回同一批相似记忆也很难解决问题;如果当前任务与过去的成功任务高度相似,直接复用一份成功计划,可能比重新检索原始轨迹更加有效。
因此,Agent 的记忆管理不仅要回答:
记忆库中有什么?
还需要回答:
现在是否需要访问记忆?
应该执行哪一种记忆操作?
应该召回多少内容?
当前检索无效时,是否需要更换查询方式?
什么时候应该复用计划、压缩记忆或遗忘内容?
本文提出的 MemCon(Memory as a Controlled Process),正是从这个角度重新理解 Agent 记忆。
MemCon 不再把记忆访问视为一个固定的检索管线,而是将其建模为一个可以在线学习的控制过程。系统根据当前任务进度、Agent 是否卡住、记忆库大小以及是否存在可复用计划,动态选择检索、计划注入、重新检索、整理、遗忘或者不使用记忆。
它的核心贡献不是重新设计一个记忆数据库,而是在已有记忆后端之上增加一个轻量级控制层:
记忆后端负责“保存什么”;
MemCon 负责“什么时候、以什么方式使用”。
零、论文基本信息
- 论文名称:Memory as a Controlled Process: Learned Adaptive Memory Management for LLM Agents
- 发表平台:arXiv,2026
- 代码仓库:ericjiang18/MemCon
- 作者信息:Eric Hanchen Jiang、Zhi Zhang、Yuchen Wu、Levina Li、Dong Liu、Xiao Liang、Rui Sun、Yubei Li、Edward Sun、Haozheng Luo、Zhaolu Kang、Aylin Caliskan、Kai-Wei Chang、Ying Nian Wu;作者主要来自加州大学洛杉矶分校、华盛顿大学和西北大学
一、背景与问题
1. 固定记忆访问策略的问题
当前多数 Agent 记忆系统可以抽象为下面的流程:
当前任务状态
    ↓
构造查询
    ↓
从记忆库检索固定数量的内容
    ↓
将检索结果放入上下文
    ↓
LLM 生成下一步动作
其中,检索数量、查询方式、搜索深度和整理周期通常由开发者提前配置。
例如:
top_k = 3
graph_hop = 2
insight_k = 5
每一步执行一次检索
每 10 个任务整理一次记忆
问题在于,最合适的记忆行为与任务状态密切相关。
场景一:记忆库仍然很小
Agent 刚开始运行时,记忆库中只有少量经验。此时频繁检索很可能返回不相关内容。
这种检索不仅无法帮助决策,还会:
- 增加输入 Token;
- 稀释当前任务信息;
- 让模型错误套用不相关经验。
场景二:出现重复任务
如果当前任务与以前成功完成的任务属于同一类型,Agent 可能不需要阅读多条原始轨迹,而是应该直接复用一份经过抽象的成功计划。
例如,过去完成过:
拿起苹果
→ 前往水槽
→ 清洗苹果
→ 将苹果放入冰箱
当新任务变成“清洗番茄并放入冰箱”时,更有价值的记忆可能是:
找到目标物体
→ 拿起目标物体
→ 前往水槽
→ 执行清洗
→ 前往冰箱
→ 放入目标物体
这是一份对象无关的计划模板,而不是某条原始轨迹。
场景三:Agent 已经卡住
假设 Agent 连续两次执行同一个动作,并且没有取得进展。
如果系统仍使用相同查询召回相同的 Top-K 记忆,那么重新检索没有实际意义。此时更合理的做法是改变查询意图,例如:
不要继续提供当前方案;
查找解决该任务的替代方法;
重点召回过去从相似失败中恢复的经验。
场景四:记忆持续增长
随着任务数量增加,记忆库会不断积累:
- 重复轨迹;
- 已经过时的规则;
- 相互冲突的经验;
- 低价值的失败记录。
如果系统只存储和检索,却不执行整理与遗忘,那么记忆规模越大,召回质量未必越高。
因此,论文认为固定记忆管线的核心问题是:
不存在一种适用于所有任务阶段、所有记忆规模和所有 Agent 状态的固定检索策略。
2. MemCon 的基本定位
面对上述问题,MemCon 没有重新设计一种记忆表示,而是引入一个记忆控制器。
整体关系可以表示为:
任务状态 + Agent 执行状态 + 记忆状态
                    ↓
              MemCon 控制器
                    ↓
选择记忆操作及其参数
                    ↓
            调用已有记忆后端
                    ↓
        将结果交给行动 Agent
MemCon 主要决定三类问题:
When:
什么时候访问记忆?

What:
执行检索、计划注入、重新检索、整理、遗忘,
还是暂时不访问记忆?

How much:
召回多少轨迹、多少规则,搜索多少跳?
这使得记忆从被动数据库变成了 Agent 控制循环中的一个可学习组件。
二、相关工作
1. 强化学习与记忆控制
强化学习擅长解决序列决策问题:智能体观察状态、选择动作,并根据环境奖励逐步优化策略。
因此,一些研究尝试使用强化学习学习:
- 工具选择策略;
- 通信策略;
- 任务规划策略;
- 记忆写入和召回策略。
但是,完整的深度强化学习通常需要大量训练样本、GPU 资源以及稳定的奖励信号。对于一个在部署过程中不断接收新任务的 Agent 来说,这种训练成本可能过高。
MemCon 选择了一条更轻量的路线:
不训练神经网络策略;
不增加额外的策略 LLM;
使用离散状态和表格化 Q 值;
通过 UCB 在部署过程中在线学习。
严格来说,论文虽然使用 Memory MDP 描述问题,但实现上更接近带有回合级反馈的上下文多臂老虎机。
2. 多 Agent 系统
AutoGen、CAMEL、MetaGPT、ChatDev、AgentVerse 等系统通过角色分工,让不同 Agent 分别承担规划、执行、检查和总结任务。
但无论系统中有一个 Agent 还是多个 Agent,跨任务经验通常仍由外部记忆模块负责保存。很多多 Agent 框架只是把固定的记忆模块接入执行流程,并没有学习如何动态访问记忆。
MemCon 与具体的 Agent 编排方式相对独立。
论文将它接入三种不同架构:
- Lobster:轻量级单 Agent 执行器;
- LangGraph:图结构工作流;
- Microsoft Agent-Framework:流水线式多 Agent 框架。
因此,多 Agent 并不是 MemCon 的核心创新。这里真正重要的是:
无论上层 Agent 如何组织,都可以在记忆模块和 Agent 之间增加同一个控制层。
3. Agent 记忆系统
现有 Agent 记忆方法大致可以分为几条路线。
基于向量检索的记忆
这类方法保存历史轨迹或摘要,并根据当前查询的向量相似度进行召回。
代表方法包括:
- MetaGPT;
- MemoryBank;
- Generative Agents。
优点是实现简单、适用于非结构化文本;局限是通常使用固定 Top-K,而且语义相似并不一定代表当前决策真正需要这条记忆。
基于技能和过程的记忆
这类方法将成功经验抽象为可以复用的程序、工作流或者技能。
代表方法包括:
- Voyager;
- Agent Workflow Memory;
- MemSkill;
- LatentMem。
这类方法更适合重复任务,但仍需要解决一个问题:什么时候应该调用技能,而不是继续检索普通轨迹?
基于反思和规则的记忆
Reflexion、ExpeL、OAgents 等方法从成功或失败轨迹中提炼自然语言规则,帮助 Agent 避免重复错误。
这类方法提高了经验密度,但如果每一步都注入大量规则,也可能导致上下文膨胀和规则冲突。
图结构记忆
G-Memory 等方法将任务、轨迹和规则组织为图,通过多跳搜索建立跨经验关联。
图结构提高了记忆的组织能力,但搜索跳数、召回规模和整理周期通常仍然是固定配置。
LLM 作为记忆控制器
MemGPT 让 LLM 自己决定何时翻页、查询和召回记忆,使访问过程具有适应性。
这种方式的优势是决策灵活,缺点是每次记忆操作可能需要额外的 LLM 推理,带来成本和延迟。
MemCon 位于两者之间:
| 方法路线 | 记忆控制方式 | 主要特点 |
|---|---|---|
| 固定检索管线 | 人工设置 Top-K、查询和整理周期 | 成本低,但缺少状态适应性 |
| LLM 记忆控制器 | 由另一个 LLM 判断如何访问记忆 | 灵活,但推理成本较高 |
| MemCon | 轻量级在线策略控制 | 能够学习,同时不增加额外 LLM 调用 |
三、方法总览
为了理解 MemCon,可以先看论文 Figure 1。
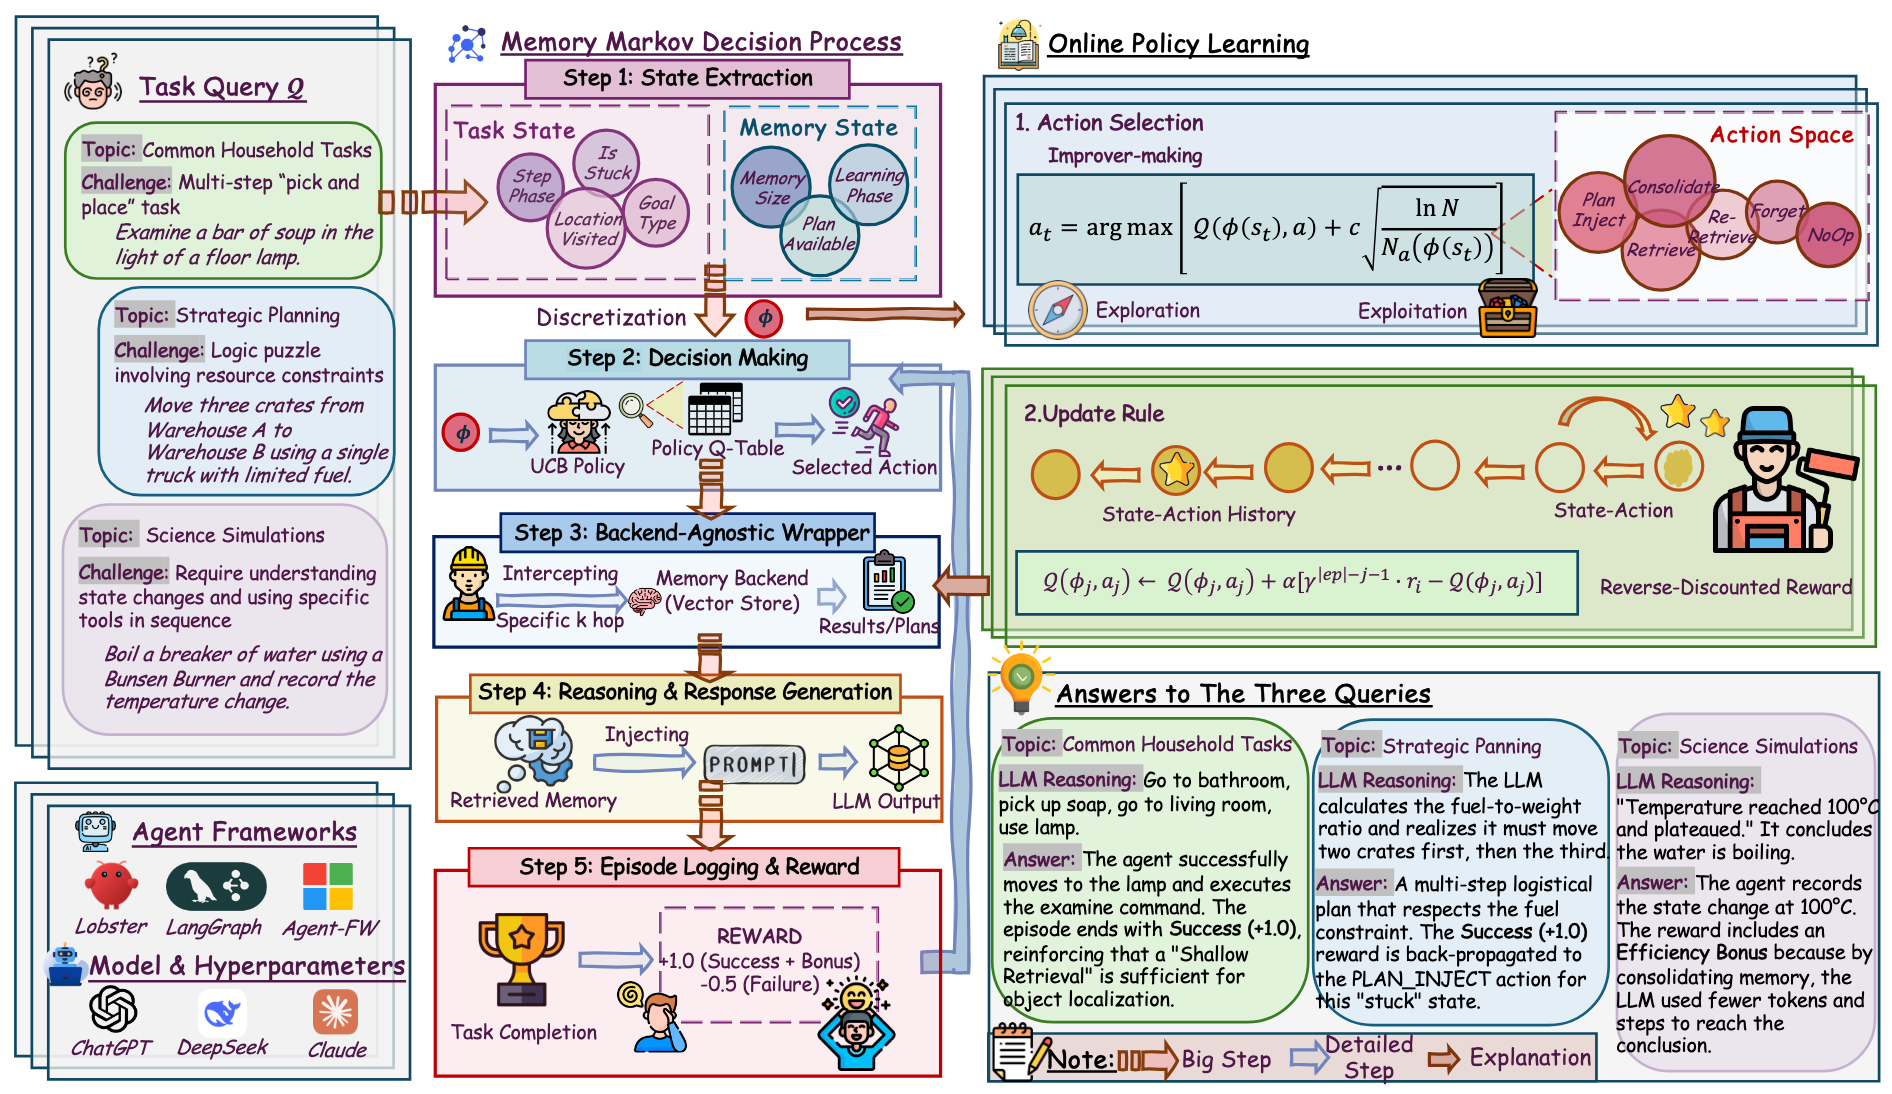
图源:论文 Figure 1。
左侧是不同任务、Agent 框架和语言模型;中间是 Memory MDP 的状态提取、动作选择、后端调用和结果注入;右侧是基于任务结果进行的在线策略更新。
MemCon 的完整执行流程可以概括为:
Agent 接收当前任务
        ↓
提取任务状态与记忆状态
        ↓
离散化为 Memory MDP 状态
        ↓
通过 UCB 策略选择记忆动作
        ↓
调用底层记忆后端
        ↓
将检索结果或计划注入 Agent 上下文
        ↓
Agent 继续执行任务
        ↓
任务结束后获得成功、失败和效率奖励
        ↓
反向更新本回合使用过的记忆动作
        ↓
将 Q 表持久化,供后续任务使用
从工程结构上看,MemCon 包含三个核心部分:
- Memory MDP:定义状态、动作和奖励;
- 在线策略学习:学习不同状态下应该采用哪种记忆操作;
- 后端无关的包装器:将策略决定转化为对实际记忆系统的调用。
除此之外,论文还加入了两个增强操作:
- 通用计划注入;
- 复合目标分解。
四、核心模块详解
1. Memory MDP:把记忆访问变成决策问题
1.1 设计动机
传统记忆系统通常直接规定:
每一步执行 retrieve(query, top_k=3)
MemCon 则认为,记忆访问本身也应该被视为一次动作选择。
因此,论文将记忆控制过程建模为:
M m e m = ( S , A , T , R , γ ) \mathcal{M}_{mem}=(\mathcal{S},\mathcal{A},\mathcal{T},\mathcal{R},\gamma) Mmem=(S,A,T,R,γ)
其中:
- S \mathcal{S} S 表示记忆控制器观察到的状态;
- A \mathcal{A} A 表示可以执行的记忆操作;
- T \mathcal{T} T 表示执行动作后系统状态的变化;
- R \mathcal{R} R 表示任务结束后获得的奖励;
- γ \gamma γ 表示对早期记忆决策进行信用衰减的折扣因子。
需要注意的是,MemCon 并不直接控制 Agent 在环境中的动作。它控制的是:
行动 Agent 在做下一步决策之前,
应该怎样使用记忆。
2. 状态:同时观察任务与记忆
2.1 设计动机
同一个检索动作在不同状态下,价值可能完全不同。
例如:
- 任务早期可能只需要浅层检索;
- Agent 卡住时可能需要替代方案;
- 已经存在成功计划时可以直接注入计划;
- 记忆库过大时可能需要整理或遗忘。
因此,MemCon 的状态由任务状态和记忆状态共同组成:
s = ( s t a s k , s m e m ) s=(s_{task},s_{mem}) s=(stask,smem)
任务状态为:
s t a s k = ( g o a l t y p e , s t e p p h a s e , i s s t u c k , o b j e c t s h e l d , l o c a t i o n s ) s_{task}=(goal\ type,step\ phase,is\ stuck,objects\ held,locations) stask=(goal type,step phase,is stuck,objects held,locations)
其中:
goal type:当前任务的目标类型;step phase:当前处于任务早期、中期还是晚期;is stuck:Agent 是否陷入重复动作;objects held:当前持有的对象数量;locations:已经访问过的位置数量。
记忆状态为:
s m e m = ( m e m s i z e , p l a n a v a i l a b l e , l e a r n i n g p h a s e ) s_{mem}=(mem\ size,plan\ available,learning\ phase) smem=(mem size,plan available,learning phase)
其中:
mem size:当前记忆库规模;plan available:当前任务类型是否已经存在成功计划;learning phase:控制器处于冷启动阶段还是稳定学习阶段。
2.2 状态离散化
为了使用表格化策略,MemCon 不直接保存完整自然语言状态,而是将状态压缩为可哈希的离散键:
ϕ ( s ) = ⟨ g o a l t y p e , s t e p p h a s e , i s s t u c k , m i n ( h o l d , 2 ) , m i n ( ⌊ v i s i t e d / 3 ⌋ , 4 ) , m i n ( ⌊ m e m s i z e / 10 ⌋ , 5 ) , p l a n a v a i l a b l e , l e a r n i n g p h a s e ⟩ \phi(s)=\langle goal\ type,step\ phase,is\ stuck,min(hold,2),min(\lfloor visited/3\rfloor,4),min(\lfloor mem\ size/10\rfloor,5),plan\ available,learning\ phase\rangle ϕ(s)=⟨goal type,step phase,is stuck,min(hold,2),min(⌊visited/3⌋,4),min(⌊mem size/10⌋,5),plan available,learning phase⟩
具体来说:
- 任务步数小于 8:early;
- 任务步数为 8~17:mid;
- 任务步数大于等于 18:late;
- 前 15 个任务:cold;
- 第 16 个任务开始:warm;
- 连续两次执行相同物理动作:
is_stuck=True; - 记忆数量按照每 10 条划分区间,最多保留到第 5 档。
这种粗粒度离散化将状态空间控制在每个基准几百个状态左右,使策略可以在几十个任务内开始收敛。
2.3 举例说明
假设一个家务 Agent 正在执行:
清洗两个杯子,并将它们放到橱柜中。
当前状态为:
目标类型:clean_and_place
任务阶段:mid
是否卡住:True
持有物体:1
访问位置:6
记忆数量:24
是否存在成功计划:True
学习阶段:warm
对应的离散状态可能是:
(clean_and_place, mid, True, 1, 2, 2, True, warm)
MemCon 不需要理解整段自然语言轨迹,只需要使用这组紧凑状态查询 Q 表。
3. 动作:控制记忆如何进入决策过程
每个记忆动作由操作类型和参数组成:
a = ( o p , θ ) a=(op,\theta) a=(op,θ)
其中:
o p ∈ { R e t r i e v e , P l a n I n j e c t , R e R e t r i e v e , C o n s o l i d a t e , F o r g e t , N o O p } op\in\{Retrieve,PlanInject,ReRetrieve,Consolidate,Forget,NoOp\} op∈{Retrieve,PlanInject,ReRetrieve,Consolidate,Forget,NoOp}
参数为:
θ = ( t o p _ k , i n s i g h t _ k , h o p ) \theta=(top\_k,insight\_k,hop) θ=(top_k,insight_k,hop)
3.1 Retrieve:普通检索
从底层记忆后端检索历史经验。
论文设置了多种检索深度:
| 检索类型 | Top-K | 规则数量 | 图搜索跳数 |
|---|---|---|---|
| 浅层检索 | 1 | 3 | 1 |
| 中等检索 | 2 | 5 | 1 |
| 深层检索 | 3 | 8 | 2 |
| 规则优先检索 | 1 | 2 | 0 |
控制器可以根据状态选择不同检索规模,而不是始终使用同一个 Top-K。
3.2 PlanInject:计划注入
如果系统已经保存了当前目标类型的成功计划,控制器可以直接将计划模板注入上下文。
输入:
当前目标类型;
历史成功任务;
对象无关的计划模板。
处理:
找到同类任务的成功轨迹;
将具体对象编号替换为通用占位符;
将计划放到记忆检索结果之前。
输出:
一份可以直接指导当前任务的行动计划。
例如,历史计划为:
前往 shelf 3
→ 拿起 cellphone 1
→ 前往 desk 1
→ 放下 cellphone 1
系统可以将其抽象为:
前往 [source]
→ 拿起 [object]
→ 前往 [target]
→ 放下 [object]
当新任务具有相同目标类型时,不再从头搜索原始轨迹,而是优先复用计划结构。
3.3 ReRetrieve:使用替代查询重新检索
当 Agent 出现重复动作时,MemCon 可以改变检索查询。
例如,第一次查询为:
如何找到任务目标物体?
如果检索结果没有帮助,重新检索时可以加入替代方案要求:
查找解决当前任务的替代方法;
不要重复已经失败的路径;
优先返回过去从相似失败中恢复的经验。
这与简单地再次调用相同检索器不同。它改变了检索意图,用于帮助 Agent 跳出局部循环。
3.4 Consolidate:整理记忆
当底层后端支持维护接口时,MemCon 可以触发:
- 合并重复规则;
- 压缩相似经验;
- 整理图结构;
- 更新记忆索引。
3.5 Forget:遗忘记忆
当记忆持续增长或噪声过多时,控制器可以调用后端的清理能力,删除低价值或重复内容。
需要注意的是,MemCon 本身并没有规定所有后端必须使用同一种遗忘算法。它只负责决定何时触发遗忘,具体删除策略由后端实现。
3.6 NoOp:不访问记忆
NoOp 表示当前步骤跳过记忆访问。
这个动作看似简单,却非常重要。它使控制器能够学习:
并非每一步决策都需要记忆。
当任务很简单、记忆为空或当前上下文已经足够时,跳过检索可以同时减少 Token 消耗和无关信息干扰。
4. 奖励:同时考虑成功与效率
4.1 设计动机
如果奖励只考虑任务是否成功,控制器可能通过不断扩大检索规模提高成功概率,却带来更高的 Token 成本。
因此,MemCon 的奖励同时包含:
- 成功奖励;
- 执行效率奖励;
- 失败惩罚。
论文定义:
r ( τ i ) = r s u c c I [ s u c c e s s ] + λ max ( 0 , 1 − T i / T m a x ) − r f a i l I [ f a i l u r e ] r(\tau_i)=r_{succ}\mathbb{I}[success]+\lambda\max(0,1-T_i/T_{max})-r_{fail}\mathbb{I}[failure] r(τi)=rsuccI[success]+λmax(0,1−Ti/Tmax)−rfailI[failure]
其中:
- r s u c c r_{succ} rsucc:任务成功奖励,实验中为 1.0;
- r f a i l r_{fail} rfail:任务失败惩罚,实验中为 0.5;
- λ \lambda λ:效率奖励权重,实验中为 0.3;
- T i T_i Ti:当前任务使用的步骤数;
- T m a x T_{max} Tmax:最大步骤数,交互任务中为 30;
- I [ ⋅ ] \mathbb{I}[\cdot] I[⋅]:指示函数,条件成立时为 1。
假设 Agent 在 5 步内成功完成任务,则:
r ( τ i ) = 1.0 + 0.3 × ( 1 − 5 / 30 ) = 1.25 r(\tau_i)=1.0+0.3\times(1-5/30)=1.25 r(τi)=1.0+0.3×(1−5/30)=1.25
如果 Agent 成功但用了 25 步,虽然仍然获得成功奖励,但效率奖励会明显降低。
这会鼓励控制器学习:
不仅要找到能成功的记忆策略,
还要避免无效检索和过长上下文。
5. 在线策略学习
5.1 为什么不使用另一个 LLM?
一种直接方案是让额外的 LLM 阅读当前状态,并判断应该执行哪种记忆操作。
但这会带来:
- 额外模型调用;
- 更高推理延迟;
- 更高 Token 成本;
- 控制决策本身的不稳定性。
MemCon 使用表格化 Q 值完成动作选择。一次控制决策只是查询和更新一张表,不需要再次调用 LLM。
5.2 使用 UCB 平衡探索与利用
在每个记忆决策点,MemCon 使用 UCB 选择动作:
a t = arg max a ∈ A [ Q ( ϕ ( s t ) , a ) + c ln N ( ϕ ( s t ) ) N a ( ϕ ( s t ) ) ] a_t=\arg\max_{a\in\mathcal{A}}\left[Q(\phi(s_t),a)+c\sqrt{\frac{\ln N(\phi(s_t))}{N_a(\phi(s_t))}}\right] at=arga∈Amax[Q(ϕ(st),a)+cNa(ϕ(st))lnN(ϕ(st))]
其中:
- Q ( ϕ ( s t ) , a ) Q(\phi(s_t),a) Q(ϕ(st),a):在当前状态下选择动作 a a a 的历史价值;
- N ( ϕ ( s t ) ) N(\phi(s_t)) N(ϕ(st)):当前状态被访问的总次数;
- N a ( ϕ ( s t ) ) N_a(\phi(s_t)) Na(ϕ(st)):当前状态下动作 a a a 被选择的次数;
- c c c:探索系数。
第一部分代表利用:
优先选择历史上表现较好的动作。
第二部分代表探索:
给尝试次数较少的动作更高奖励。
当某个动作从未被选择时,它会获得非常大的探索奖励,从而保证控制器不会永远只执行初始化时看起来最好的动作。
5.3 使用先验值缓解冷启动
在没有任何任务反馈时,Q 表还没有学到有效策略。
因此,论文为不同操作设置了可以解释的初始值:
| 动作 | 初始 Q 值 | 含义 |
|---|---|---|
| Retrieve | 0.5 | 普通检索通常有一定帮助 |
| PlanInject | 0.3 | 有成功计划时值得尝试 |
| ReRetrieve | 0.1 | 主要在卡住时有用 |
| Consolidate | 0.0 | 保持中性 |
| Forget | -0.1 | 遗忘存在一定风险 |
| NoOp | -0.2 | 冷启动阶段不鼓励完全忽略记忆 |
这些先验不是最终规则,只是帮助系统在最初几个任务中获得更合理的探索顺序。随着真实奖励不断到来,Q 值会被逐步覆盖。
5.4 反向折扣的信用分配
任务奖励只在整个任务结束后获得,但一次任务中可能执行过多个记忆操作。
例如:
第 1 步:浅层检索;
第 6 步:深层检索;
第 10 步:Agent 卡住;
第 11 步:更换查询重新检索;
第 14 步:任务成功。
最后成功并不代表前面所有记忆动作同样有效。因此,MemCon 使用反向折扣,让靠近任务结果的决策获得更强信用:
Q ( ϕ j , a j ) ← Q ( ϕ j , a j ) + α [ γ ∣ e p ∣ − j − 1 r i − Q ( ϕ j , a j ) ] Q(\phi_j,a_j)\leftarrow Q(\phi_j,a_j)+\alpha\left[\gamma^{|ep|-j-1}r_i-Q(\phi_j,a_j)\right] Q(ϕj,aj)←Q(ϕj,aj)+α[γ∣ep∣−j−1ri−Q(ϕj,aj)]
其中:
- α \alpha α:学习率;
- γ \gamma γ:回合内折扣因子;
- ∣ e p ∣ |ep| ∣ep∣:本回合记忆决策总数;
- j j j:当前被更新动作在回合中的位置;
- r i r_i ri:任务最终奖励。
越靠近任务结束的动作,其折扣次数越少。
在上面的例子中,帮助 Agent 脱困的 ReRetrieve 会获得比最开始浅层检索更强的成功信用。
这是一种轻量级近似。它无法完全恢复复杂的因果关系,但比“所有动作获得完全相同奖励”更加合理。
6. 后端无关的记忆包装器
6.1 设计动机
论文不希望 MemCon 只能与某一种记忆库配合使用,因此把底层记忆系统抽象成两个基础接口:
retrieve(query, parameters)
store(trajectory, success)
可选接口为:
maintain(operation)
MemCon 的包装器位于 Agent 和记忆后端之间:
Agent 请求记忆
      ↓
MemCon 截获请求
      ↓
提取当前状态
      ↓
策略选择操作和参数
      ↓
调用后端 retrieve 或 maintain
      ↓
可选地加入通用计划
      ↓
返回给 Agent
任务完成后:
记录成功或失败
      ↓
计算奖励
      ↓
更新本回合 Q 值
      ↓
保存新的成功计划
      ↓
调用后端 store
由于控制器不直接修改后端内部数据结构,因此理论上可以接入:
- 向量数据库;
- 技能库;
- 轨迹摘要记忆;
- 图结构记忆;
- 潜在 Token 记忆。
不过,实验中的 MemCon 统一使用 G-Memory 作为内部后端。因此,“可以兼容任意后端”主要来自接口设计,尚未通过所有类型后端的组合实验充分验证。
7. 两个增强操作
除了学习型控制器,论文还加入了两个面向长任务的增强机制。
7.1 通用计划注入
当任务成功后,系统提取动作序列,并通过规则替换具体对象编号:
shelf 3 → [shelf]
cellphone 1 → [cellphone]
desk 2 → [desk]
随后按照目标类型将计划保存到一个轻量级 JSON 索引。
未来遇到同类型任务时,PlanInject 可以直接调用这份计划。
7.2 复合目标分解
对于需要对多个对象重复执行同一过程的任务,例如:
把两部手机都放到桌子上。
系统会注入一条确定性提示:
先完成对象 1 的全部步骤,
再对对象 2 重复同样的过程。
如果记忆中存在单对象任务的成功模板,系统还会同时召回该模板。
需要注意的是,目标分解不是由 Memory MDP 学习出来的动作,而是一条确定性启发式规则。真正由策略学习控制的是 PlanInject 等记忆操作。
五、实验设置
1. 数据集
论文使用了六个基准,覆盖交互任务和问答工具任务。
交互式决策任务
| 数据集 | 数量 | 任务特点 |
|---|---|---|
| ALFWorld | 134 | 家庭环境中的拿取、清洗、加热、冷却和放置任务 |
| PDDL Planning | 100 | Blocksworld、Barman、Gripper、Tyreworld 等经典规划问题 |
| ScienceWorld | 100 | 烧水、融冰和根据属性寻找物体等科学实验任务 |
问答与工具使用任务
| 数据集 | 数量 | 任务特点 |
|---|---|---|
| TriviaQA | 200 | 开放域短答案问答 |
| WebWalkerQA | 200 | 需要网站导航和信息抽取的多跳问题 |
| GAIA | 165 | 综合工具调用、网页搜索和文档阅读 |
2. Agent 框架
实验使用了三种不同的 Agent 执行框架:
- Lobster;
- LangGraph;
- Microsoft Agent-Framework。
所有框架使用相同的任务加载器、工具和评价协议,以尽量保证比较集中在记忆系统本身。
3. 模型
论文使用了三种语言模型:
- GPT-4.1-mini;
- Claude Sonnet-4;
- DeepSeek-V3.2。
这三个模型覆盖了较轻量的闭源模型、能力更强的闭源模型以及开源模型。
4. 对比方法
除了不使用记忆的 Empty,论文比较了九种记忆系统:
| 方法 | 主要机制 |
|---|---|
| MetaGPT | 基于向量相似度检索原始轨迹 |
| Voyager | 对轨迹进行摘要后检索 |
| Generative | 使用 LLM 对候选记忆重新排序 |
| ChatDev | 按执行阶段周期性总结 |
| MemoryBank | 加入时间衰减和遗忘 |
| OAgents | 从成功和失败中提炼规则 |
| ExperienceBank | 对经验进行生成式相关性排序 |
| LatentMem | 将经验蒸馏为潜在 Token |
| G-Memory | 图结构轨迹、规则和多跳检索 |
论文报告的 MemCon 使用 G-Memory 作为内部记忆后端。
因此,MemCon 与 G-Memory 的对比尤其重要:
G-Memory:
固定策略访问图记忆。

MemCon:
使用同类后端,
但由在线策略决定怎样访问记忆。
这样能够更直接地观察记忆控制器本身的价值。
5. 评价指标
论文主要报告:
- 任务成功率或回答准确率,统一记为 S/A;
- 每个任务的平均输入 Token 数量;
- 不同超参数和组件的消融结果。
需要注意的是,每个配置只运行了一次真实在线任务流,没有进行多随机种子平均。
六、实验结果与分析
1. GPT-4.1-mini 主实验
论文 Table 1 给出了 GPT-4.1-mini 下的完整结果。为了突出控制器带来的变化,下面只保留 Empty、内部后端 G-Memory 和 MemCon 的平均结果。
| Agent 框架 | Empty | G-Memory | MemCon |
|---|---|---|---|
| Lobster | 35.4 | 38.7 | 42.6 |
| LangGraph | 34.3 | 40.8 | 43.4 |
| Agent-FW | 33.5 | 39.5 | 43.6 |
三个框架中,MemCon 的平均成绩都高于不使用记忆和固定访问方式的 G-Memory。
一些具体结果包括:
- Lobster + ALFWorld:MemCon 达到 67.9%,G-Memory 为 59.7%;
- LangGraph + PDDL:MemCon 达到 40.0%,G-Memory 为 28.3%;
- Agent-FW + GAIA:MemCon 达到 23.0%,G-Memory为 20.0%。
这说明控制记忆访问方式的收益并不只出现在某一种 Agent 编排框架中。
但也不能简单理解为 MemCon 在每个单独数据集上都绝对领先。GPT-4.1-mini 的 18 个“框架 × 数据集”组合中,MemCon 在 9 个组合中取得最高成绩,其他组合中通常处于第一或第二梯队。
2. 不同模型下的结果
使用 Claude Sonnet-4 时,MemCon 在 18 个组合中的 15 个取得最高结果。
例如,在 Agent-FW 下:
| 方法 | ALFWorld | PDDL | ScienceWorld | 平均值 |
|---|---|---|---|---|
| Empty | 12.7 | 21.0 | 17.0 | 28.8 |
| MemCon | 60.6 | 70.7 | 67.1 | 54.8 |
在 DeepSeek-V3.2 下,MemCon 在全部 9 个交互式任务组合中取得最高成绩,并在全部 18 个组合中的 15 个取得最高成绩。
论文据此认为,当基础模型已经具备较强的计划执行能力时,系统瓶颈会逐渐从“模型能否执行计划”转移到:
系统能否在正确时间,
把正确经验提供给模型。
我的理解是,这一结论需要谨慎看待,但它揭示了一个很重要的工程现象:
模型越强,错误可能越少来自基本推理能力,越多来自上下文中缺少正确经验或者出现了无关记忆。
3. Token 成本
为了判断 MemCon 的提升是否只是因为召回了更多内容,论文在 Figure 3 中同时比较了任务表现和 Token 成本。
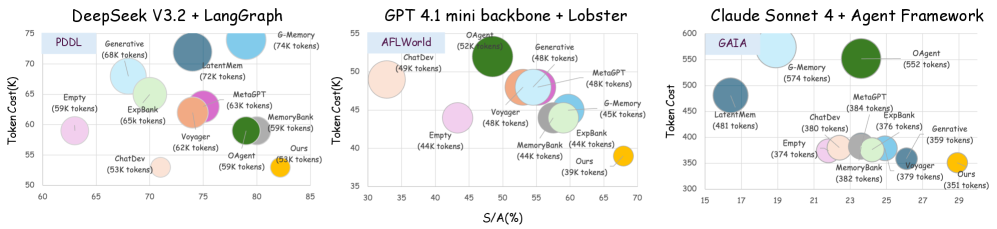
图源:论文 Figure 3。
横轴表示成功率或回答准确率,纵轴表示平均 Token 成本。MemCon 在三个示例设置中都位于相对靠右且靠下的位置,即在提高任务表现的同时降低输入成本。
以 GPT-4.1-mini 为例:
| 设置 | G-Memory Token | MemCon Token | 变化 |
|---|---|---|---|
| Lobster + ALFWorld | 45K | 39K | 约降低 13% |
| LangGraph + ALFWorld | 42K | 41K | 约降低 2% |
| Agent-FW + ALFWorld | 43K | 37K | 约降低 14% |
在 Lobster + ALFWorld 中,MemCon 不仅将成功率从 59.7% 提高到 67.9%,还将平均输入 Token 从 45K 降至 39K。
这说明 MemCon 的提升并不是简单地“召回更多记忆”,而是学习到了更有选择性的访问方式,例如:
- 记忆较少时跳过无意义检索;
- 简单任务使用浅层检索;
- 已有成功模板时直接注入计划;
- Agent 卡住时才使用更深或替代查询;
- 避免每一步都重复注入同一批内容。
不过,从论文 Table 5 也可以看到,MemCon 并非在所有 QA 数据集上都使用最少 Token。例如部分 GAIA 和 WebWalkerQA 设置中,它的 Token 数量高于某些简单基线。
因此,更准确的结论是:
MemCon 在整体上改善了准确率与成本之间的权衡,而不是在每一个单独任务上都实现最低 Token 消耗。
4. 组件消融实验
论文 Table 2 对 MemCon 的核心组件进行了逐步叠加。
| 组件配置 | ALFWorld | GAIA |
|---|---|---|
| 静态 G-Memory 后端 | 59.7 | 21.2 |
| + 学习型 UCB 控制器 | 64.9 | 22.4 |
| + 通用计划注入 | 66.4 | 22.4 |
| + 目标分解 | 67.2 | 22.4 |
| 完整 MemCon | 67.9 | 22.4 |
最重要的结果是:
静态后端 → 加入 UCB 控制器:
ALFWorld 提升 5.2 个百分点。

继续加入计划注入和目标分解:
带来额外但更小的提升。
这说明 MemCon 的主要收益确实来自学习型记忆控制,而不是额外增加的启发式规则。
GAIA 中只有控制器带来了 1.2 个百分点的提升,计划注入和目标分解没有继续提高准确率。原因是 GAIA 不包含大量论文所针对的多对象复合操作任务,这两个增强机制没有足够的触发机会。
这项结果也说明:
计划注入和目标分解并不是普遍有效的通用组件,它们的价值与任务结构有关。
5. 超参数敏感性
论文 Figure 4 和 Figure 5 分别测试了:
- 学习率 α \alpha α;
- UCB 探索系数 c c c;
- 折扣因子 γ \gamma γ;
- 失败惩罚;
- 效率奖励权重 λ \lambda λ;
- 不同动作集合。
在 GPT-4.1-mini + Lobster 的实验中,默认参数为:
| 参数 | 默认值 |
|---|---|
| 学习率 α \alpha α | 0.15 |
| 折扣因子 γ \gamma γ | 0.9 |
| UCB 系数 c c c | 1.4 |
| 失败惩罚 r f a i l r_{fail} rfail | 0.5 |
| 效率权重 λ \lambda λ | 0.3 |
论文报告,GAIA 在扫描范围内的表现与峰值相差不超过约 2.5 个百分点,说明策略对单个参数具有一定容错性。
效率权重也不能过高或过低:
- λ = 0 \lambda=0 λ=0:控制器不关心执行效率;
- λ \lambda λ 过大:控制器可能为了减少步骤而牺牲必要检索;
- 默认 λ = 0.3 \lambda=0.3 λ=0.3:在实验中取得较好平衡。
七、局限性与未来方向
论文没有单独设置局限性章节,下面主要结合方法和实验进行分析。
1. 表格化状态的扩展能力有限
MemCon 能够快速学习的重要原因,是将状态压缩为几百个离散键。
但在更复杂的 Agent 系统中,状态可能包含:
- 多个并行子任务;
- 更复杂的工具依赖;
- 多 Agent 的通信状态;
- 不确定的任务进度;
- 更细粒度的记忆质量信号。
如果直接增加这些字段,状态组合数量可能快速增长,导致表格化 Q 学习出现状态稀疏问题。
未来可以考虑:
- 使用特征共享的线性上下文老虎机;
- 使用小型策略网络;
- 使用状态嵌入进行相似状态泛化;
- 在保持低成本的前提下引入分层策略。
2. 奖励主要来自任务结束后的二元反馈
MemCon 主要根据成功或失败更新记忆动作。
这种奖励容易获取,但信用分配比较粗糙。
例如,任务最终失败可能是因为:
- 检索了错误记忆;
- 行动 Agent 没有遵循正确记忆;
- 工具执行失败;
- 环境返回异常;
- 任务本身超过模型能力。
如果将失败全部归因于记忆策略,可能错误降低某个实际有效动作的 Q 值。
未来可以增加中间信号,例如:
- 检索内容是否被模型引用;
- 检索后是否产生了新动作;
- Agent 是否退出重复循环;
- 子目标是否完成;
- 记忆是否与最终成功步骤存在直接关联。
3. 后端无关性还需要更多组合实验
MemCon 在接口设计上能够包装不同记忆后端,但论文的主要结果统一使用 G-Memory 作为内部后端。
因此,还需要进一步验证:
MemCon + 纯向量记忆;
MemCon + Mem0 式事实记忆;
MemCon + 技能库;
MemCon + 摘要记忆;
MemCon + 多模态记忆。
只有在多种存储机制上都能稳定提升,才能更充分证明控制策略真正具有后端无关性。
4. 部分增强机制依赖任务结构
通用计划注入使用正则规则替换对象名称,目标分解则主要面向“对多个对象重复相同操作”的任务。
在开放世界任务中,成功计划未必只是替换对象就能复用。例如:
- 不同工具具有不同前置条件;
- 环境规则发生变化;
- 同类任务存在不同约束;
- 计划中的动作顺序需要动态调整。
未来可以研究带有参数、前置条件和失败恢复分支的结构化技能,而不仅是文本动作模板。
5. 实验缺少多随机种子统计
论文每个配置只执行一次在线任务流,没有报告多次运行的均值和方差。
由于 UCB 的探索顺序、早期任务分布和初始成功经验都可能影响后续策略,单次任务流不足以完全说明稳定性。
未来实验可以进一步报告:
- 多个任务顺序;
- 多个随机种子;
- 不同冷启动先验;
- 策略收敛速度;
- 学习过程中性能随任务数量的变化。
八、我的理解和启发
1. 记忆不只是数据系统,也是控制系统
过去设计 Agent 记忆时,很容易把重点放在数据库层面:
使用什么向量数据库?
Embedding 模型怎么选择?
Top-K 设置为多少?
记忆应该保存成文本还是图?
MemCon 提醒我们,记忆系统实际上包含两层:
数据层:
存储轨迹、事实、规则、技能和关系。

控制层:
判断什么时候读、读什么、读多少,
以及什么时候更新、整理和遗忘。
即使数据层保存了高质量记忆,如果控制层始终采用固定策略,Agent 仍然可能:
- 在不需要时召回大量内容;
- 在真正卡住时只获得相同结果;
- 错过已经存在的成功计划;
- 让低价值记忆持续污染上下文。
因此,我对这篇论文最核心的理解是:
Agent 记忆优化的下一步,不只是设计更好的记忆表示,而是学习记忆如何参与决策。
2. 不一定需要用 LLM 管理所有记忆决策
现在很多 Agent 架构倾向于增加一个 Memory Agent,让它通过 LLM 判断:
- 是否保存记忆;
- 是否召回记忆;
- 应该召回什么;
- 是否修改或删除记忆。
这种方式足够灵活,但如果每一步都需要额外模型调用,长时任务的成本会非常高。
MemCon 给出了一个值得借鉴的折中方案:
复杂语义工作交给 LLM:
提取计划、生成规则、理解任务。

高频控制工作交给轻量策略:
是否检索、检索多少、是否重新检索。
也就是说,并不是 Agent 系统中的每一个决策都必须由 LLM 完成。
当动作空间较小、状态可以离散化、奖励可以观测时,传统在线学习算法可能更稳定、更便宜。
3. 可以如何应用到自己的 Agent 项目
如果要在一个代码 Agent 或工具 Agent 中借鉴 MemCon,我会先实现一个简化版本。
第一步:定义轻量状态
任务类型;
当前执行阶段;
连续失败次数;
是否重复调用同一个工具;
记忆库规模;
是否存在相同错误的成功修复;
最近一次检索是否被使用。
第二步:定义有限动作
不检索;
检索 1 条相似案例;
检索 3 条相关规则;
召回成功修复计划;
使用错误信息重新检索;
压缩重复记忆;
删除低价值记忆。
第三步:记录结果
任务是否成功;
是否减少了工具调用;
是否退出错误循环;
召回内容是否被最终方案采用;
本次任务消耗了多少 Token。
第四步:在线更新策略
开始时甚至不一定需要完整强化学习,可以先使用:
- 规则与统计计数;
- 多臂老虎机;
- UCB;
- Thompson Sampling。
等到任务状态和动作空间足够复杂,再考虑训练小型策略网络。
4. 与其他记忆方法的联系
| 方法 | 主要解决的问题 |
|---|---|
| Mem0 | 事实记忆如何新增、修改和删除 |
| A-MEM | 记忆如何动态建立关联 |
| MemoryBank | 记忆如何随时间衰减 |
| Voyager | 如何从成功轨迹中形成技能 |
| G-Memory | 如何用图组织轨迹和规则 |
| MemCon | 如何动态决定何时、以何种方式使用记忆 |
这些方法并不是相互替代的。
一个更完整的 Agent 记忆架构可能是:
Mem0 式生命周期管理
        ↓
A-MEM / G-Memory 式结构化组织
        ↓
Voyager 式计划与技能抽象
        ↓
MemCon 式访问控制
        ↓
行动 Agent
从这个角度看,MemCon 更像记忆系统的策略层,而不是另一种彼此竞争的记忆数据库。
九、总结
本文提出了 MemCon,将 Agent 记忆管理从固定检索管线改造成一个可在线学习的控制过程。
它的核心思路可以概括为:
观察任务状态和记忆状态;
将记忆操作建模为动作;
使用 UCB 在线选择记忆动作;
根据任务成功、失败和效率更新策略;
通过包装器接入已有记忆后端。
MemCon 可以选择:
- 普通检索;
- 注入成功计划;
- 使用替代查询重新检索;
- 整理记忆;
- 遗忘记忆;
- 跳过记忆访问。
实验覆盖六个基准、三个 Agent 框架和三个语言模型。结果表明,MemCon 通常能够提高任务成功率,并改善准确率与 Token 成本之间的权衡。消融实验进一步说明,主要收益来自学习型 UCB 控制器,而不是额外的计划注入和目标分解规则。
这篇论文带来的核心启发是:
长期记忆的价值不仅取决于保存了多少信息,也取决于系统能否在正确的状态下选择正确的记忆操作。
对于实际 Agent 开发来说,记忆库只是基础设施。真正决定记忆是否有效的,是记忆如何进入 Agent 的控制循环。
参考资料
- Eric Hanchen Jiang, Zhi Zhang, Yuchen Wu, et al. Memory as a Controlled Process: Learned Adaptive Memory Management for LLM Agents. arXiv, 2026.
- MemCon 代码仓库
更多推荐



 5
 0
- 0


 已为社区贡献8条内容

所有评论(0)