- @weixin_45642847


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
EvoLife提出一种统一的具身导航框架,将混合动作空间、主动交互与持久空间记忆纳入同一决策闭环。它不依赖复杂模型训练,而是通过接口整合,使Agent在导航中自主选择行动粒度、主动提问,并将对话答案绑定至位置形成可复用的记忆。该系统突破了传统导航中动作单一、交互短暂、记忆不可持续的局限,实现了从“一次性任务执行”到“长期经验积累”的跃迁,为具身智能的持续学习提供了系统级解决方案。

EvoLife提出一种统一的具身导航框架,将混合动作空间、主动交互与持久空间记忆纳入同一决策闭环。它不依赖复杂模型训练,而是通过接口整合,使Agent在导航中自主选择行动粒度、主动提问,并将对话答案绑定至位置形成可复用的记忆。该系统突破了传统导航中动作单一、交互短暂、记忆不可持续的局限,实现了从“一次性任务执行”到“长期经验积累”的跃迁,为具身智能的持续学习提供了系统级解决方案。
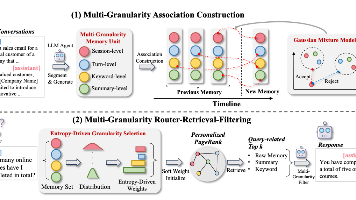
长期对话 Agent 的难点,已经不只是“记忆能不能存下来”,而是:当答案散落在不同日期、不同话题的对话里,系统能不能把它们重新找齐。此前 Agent Memory 系列讨论过把交互写成可检索记忆、建立记忆之间的联系、在需要时回看历史。一段对话究竟应该按多大颗粒度被记住与检索?假设用户先说“我在 Coursera 完成了三门课”,一周后又说“我在 edX 完成了两门课”,随后问“我总共完成了几门在
前面已经阅读了 A-MEM、MemoryOS、Nemori、MAGMA、HiAgent、Agentic Plan Caching、3DLLM-Mem、Mem²Evolve、Chain-of-Memory、ReMemR1 等不同方向的 Agent Memory 工作。↓长期记忆应该怎样增删改、怎样建立关联?↓长期记忆应该怎样分层、什么时候形成 Episode?MAGMA↓语义 / 时间 / 因果 /
前面阅读的 Agent 记忆工作,大多在回答一个问题:Agent 应该怎样保存、组织和召回过去的信息?Mem0 关注记忆的新增、更新和删除;A-MEM 关注记忆之间如何动态建立关联;MAGMA将长期经历组织成语义、时间、因果和实体多图,并根据查询意图选择关系;3DLLM-Mem 将长期记忆扩展到具身环境,用 Working Memory 查询并融合历史Agentic Plan Caching 则进

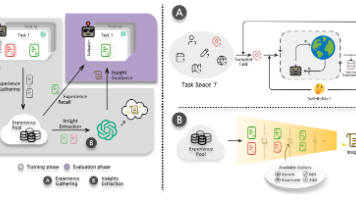
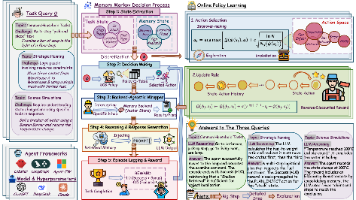
在复杂交互任务中,大模型 Agent 经常会重复犯同样的错误。例如,在网页问答任务中,Agent 可能已经发现直接搜索完整问题得不到答案,但遇到下一个问题时,仍然继续使用相同的搜索方式。在家庭环境中,Agent 可能已经通过多次尝试发现平底锅通常位于炉灶附近,但执行新任务时,仍然优先搜索抽屉和橱柜。这些现象说明,大模型拥有大量世界知识,并不代表 Agent 能够自动从自己的任务经历中学习。一种直接
应该保存什么?应该如何组织已经保存的记忆?Mem0 关注事实记忆的新增、修改、删除和忽略;A-MEM 关注记忆之间如何建立动态关联;G-Memory 使用图结构组织任务经验和推理规则;Voyager 将成功轨迹抽象成可以复用的技能;MemoryBank 通过遗忘机制控制记忆的生命周期。这些方法都在改进记忆本身,但在实际 Agent 系统中,还有一个容易被忽视的问题:即使记忆库中已经保存了正确经验,
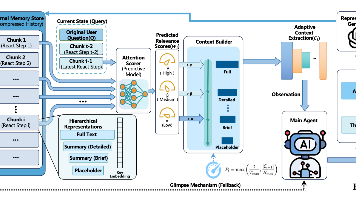
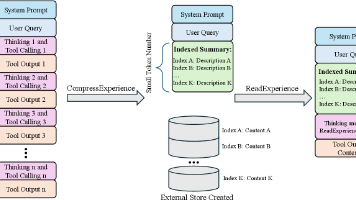
长程 Agent 往往需要连续执行几十甚至上百次工具调用。阅读项目结构↓搜索相关代码↓运行测试↓分析错误日志↓修改代码↓再次运行测试↓对比修改前后的结果中间推理;工具调用;文件内容;命令输出;错误日志;已经失败的尝试;当前任务进度。最直接的做法是将所有历史全部保留在上下文中,但上下文窗口始终有限。即使模型支持很长的输入,也会出现成本增长、注意力稀释和关键信息难以定位等问题。完整历史↓压缩为一段任务
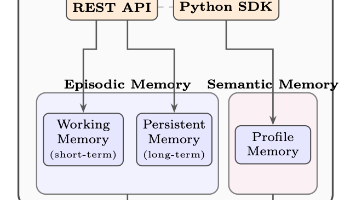
用户有哪些稳定偏好;过去发生过什么;用户曾经做过哪些决定;某个偏好是什么时候改变的;当前问题与哪些历史对话有关。接收一轮对话↓调用 LLM 提取事实↓判断新增、更新或删除↓只保存提取后的记忆我以前喜欢靠窗座位,但最近因为要经常活动,现在更喜欢过道座位。用户喜欢过道座位。对于一般的个性化推荐,这条记忆可能已经足够。我以前喜欢什么座位?为什么后来改变了?原始偏好是什么;新偏好是什么;偏好什么时候发生变
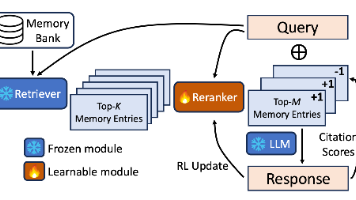
Mem0 关注如何提取事实,并对记忆执行新增、更新、删除和忽略;Zep 使用时序知识图谱保存实体、关系及其历史变化;GAM 通过层级图和语义边界控制记忆固化;MemRL 根据环境奖励学习哪些任务经验真正有用。这些方法让我逐渐意识到,Agent 记忆系统并不只是一个“把历史信息保存下来”的数据库。写入阶段:历史对话应该以什么粒度保存?召回阶段:面对当前问题,应该检索哪些记忆?反馈阶段:系统能否根据实