


- @weixin_55064320


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
围绕这一体系,摩尔线程向上依托夸娥智算集群与整合物理、渲染、AI三大引擎的MT Lambda仿真平台,向下协同端侧SoC芯片与开发者套件,形成云边端全栈布局,跑通从合成数据、训练到真机部署的工业闭环,并在四足机器狗与双足人形机器人上完成Sim2Real实测验证。模型落地后,真正的硬仗在真机控制端。未来,摩尔线程将持续携手RLinf框架与产业生态伙伴,以软硬协同推动国产算力与具身智能的深度融合,与开
目前,摩尔线程、天思智慧与塔视智能联合打造的具身智能边端应用方案已落地近70个场景,在电力物资仓储等场景中基于摩尔线程MTT E300 AI模组已跑通超过25种AI算法,帮助客户建立“端-边-云”协同的统一算法调度体系。近日,摩尔线程携手合作伙伴天思智慧、塔视智能共同亮相Ultralytics YOLO Vision 2026(YV26)大会,联合展示了搭载摩尔线程MTT E300 AI模组的天思
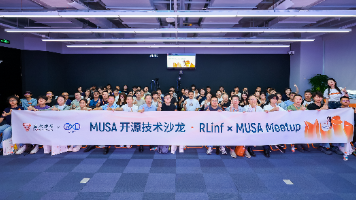
无论你是算法工程师、机器人研发团队,还是关注国产算力生态的技术探索者,都期待与你现场交流——用一个下午,看清VLA模型走向产线的完整闭环,并与框架、算力、模型、生态四方代表面对面深度复盘,共同接入MUSA开源共建网络。这一次,我们希望与开发者、研究者及产业伙伴一起,探索并打通国产原生技术栈下的具身智能落地路径。分享MTT S5000集群上的工程实践,展示国产算力纯RL大规模训练的真实性能与扩展性。
摩尔线程宣布完成腾讯混元Hy3preview模型的Day-0极速适配,通过自研MUSA架构实现软硬件协同优化,在MTTS5000智算卡上高效运行295B参数的Hy3preview模型。该适配展现了摩尔线程对前沿AI模型的快速响应能力,简化了开发者部署流程,为国产算力支持大模型落地提供新范例,将持续优化技术架构助力AI产业发展。
这一开源举措将有助于提升MUSA在AI开发者社区的可见度,推动MUSA Kernel、编译工具链及运行时生态建设,吸引社区围绕MUSA进行算子优化、KernelBench适配和代码生成模型微调等工作,全面展示摩尔线程在国产GPU、大模型训练、执行反馈强化学习和AI编程工具链方向的综合能力。随着大模型代码生成能力不断提升,行业对代码模型的评估重心正在发生变化:从过去关注“语法是否正确”“能否写出完整

依靠WorkBuddy、元宝、微信、AI游戏助手等真实业务场景的历练,产品稳定性与用户体验显著提升,腾讯丰富的真实业务场景与混元模型能力迭代形成了相互赋能的良性循环。摩尔线程基于此前对DeepSeek-V4、MiniMax M3.0、Kimi2.6、GLM-5.2等多款国产旗舰模型的Day-0适配经验,已形成一套高效、系统化的复杂推理任务优化方法论。摩尔线程将继续依托MUSA软件栈的生态兼容性,保
性能方面,MTVSR通过MUSA内核调用GPU实现硬件推理加速,目前,用户使用摩尔线程MTT S80/S70系列显卡,并安装最新官方驱动(v340.150或后续版本),即可在VLC nightly build版本中抢先体验MTVSR超分功能,该技术也将随VLC 3.0.24稳定版正式发布,覆盖更广泛的用户群体。与传统播放器常用的双三次插值或Lanczos算法不同,MTVSR采用基于深度学习的实时智
摩尔线程宣布其TileLang-MUSA成为TileLang官方主线版本,实现对DeepSeek-V4最新TileLang算子库TileKernels的"Day-0"支持,为国产GPU上的大模型算子迁移和优化奠定基础。TileLang-MUSA已开源,测试覆盖率超95%,显著提升国产GPU开发效率。这一进展标志着国产AI大模型与GPU深度融合,摩尔线程将持续投入开源生态建设,推

DeepSeek-V4预览版发布当天,摩尔线程通过智能算子迁移系统KernelSwift,在MTTS5000智算卡上实现了80%以上核心算子的Day-0适配。KernelSwift将适配周期从数月缩短至小时级,支持多元国产芯片的"开箱即用"。MTTS5000凭借原生FP8精度支持,为模型提供高效算力底座。经协同优化,21个核心算子均获加速,自动生成算子正确率达100%,展现了国

摩尔线程宣布其TileLang-MUSA成为TileLang官方主线版本,实现对DeepSeek-V4最新TileLang算子库TileKernels的"Day-0"支持,为国产GPU上的大模型算子迁移和优化奠定基础。TileLang-MUSA已开源,测试覆盖率超95%,显著提升国产GPU开发效率。这一进展标志着国产AI大模型与GPU深度融合,摩尔线程将持续投入开源生态建设,推