- @weixin_72169639


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
近日,沐曦股份正式完成面向具身智能大规模强化学习框架 RLinf 的全栈适配,适配方案已正式合入 RLinf 官方主线,RLinf 官方同步宣布支持沐曦 GPU。沐曦股份 GPU 与 RLinf 的官方主线合入,并完成千卡规模全流程高质量验证,为具身智能开发者提供了“国产算力 + 主流开源框架”的开箱即用选择,持续推进国产算力与具身智能生态的深度融合。具身智能对算力的需求是复合的,既包括训练模型的

物理AI是人工智能发展的新阶段,强调机器对摩擦、惯性等物理概念的理解与真实世界中的行动能力。机器人作为其核心载体,面临数据稀缺难题,仿真成为关键解决方案。NVIDIA、Google DeepMind与Disney Research联合开发的开源GPU物理仿真框架Newton,基于Warp和USD标准,集成多种物理求解器与逆运动学模块,支持刚体、柔体、布料、颗粒等多类型仿真,并通过代理耦合与ADMM

未来,沐曦股份将持续深化与产业链上下游伙伴的合作,加速GPU产品、软件生态、基础设施与行业应用之间的融合,推动国产算力在真实业务场景中从“可用”走向“好用”,为人工智能产业发展和数字经济建设提供更加坚实的算力底座。中心由沐曦股份与行业前列的算力产业链伙伴共同建设,双方基于曦云C600系列GPU,围绕集群、软硬件一体化能力开展联合创新,进一步推动集群系统级联合调优,面向行业客户提供算力服务与应用开发
9月14日,上海人工智能实验室开源 ATRIA Dawn Preview 模型。同日,凭借自研高性能通用 GPU 与 MXMACA 软件栈一体化协同的产品优势,沐曦股份率先完成对 ATRIA Dawn Preview 模型的 Day 0 适配,实现“上线即适配”
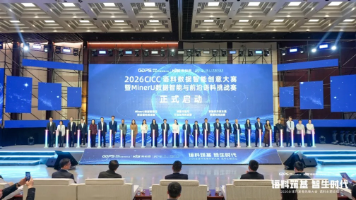
3 月 28 日,2026 全球开发者先锋大会 “语料筑基、智生时代” 主题论坛在上海盛大启幕。沐曦股份作为本次MinerU 实战营战略伙伴,携全栈自研国产 GPU 算力方案深度参与,以硬核算力为语料数据智能创新筑牢底座,与行业共探 “语料 + 算力 + 模型 + 场景” 的协同发展新路径。
你有没有想过,AI 不再只是待在屏幕里回答问题、写代码,而是真真正正地走进现实世界,像人一样感知、决策、行动?
今日,智谱AI正式上线并开源全新一代大模型 GLM-5,沐曦股份实现 Day 0 深度适配。 GLM-5目前可于曦云 C 系列(C500/C550/C588)上稳定高效运行。
为了让大模型的训练过程更顺畅、更高效,沐曦MXMACA软件平台(简称 MXMACA)具有无缝兼容CUDA的能力,科学兼容Megatron-LM的绝大多数特性。此外,MXMACA进行多方面的优化,帮助科研人员和工程师能够快速在沐曦硬件环境中完成各类前沿模型的训练。下面,我们将从几个关键角度介绍MXMACA在大模型训练方面的改进思路和优化效果,让更多的读者轻松了解“大模型训练背后的那些事”。
中国科学院自动化研究所李国齐、徐波团队在发表原创内生复杂性理论系列论文的工作基础上,与沐曦MetaX合作,打造了类脑脉冲大模型“瞬悉1.0”(SpikingBrain-1.0),在国产千卡GPU算力平台上完成全流程训练和推理,实现了大模型在超长序列推理上数量级的效率和速度提升,展示了构建国产自主可控的新型非Transformer大模型架构生态的可行性。
4月12日,MiniMax新一代Agent旗舰大模型M2.7开源。沐曦股份曦云C系列GPU已完成对 M2.7的Day 0深度适配,将为M2.7提供澎湃算力支持。