


- @SuaniCommunity


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
清华大学自然语言处理实验室(THUNLP)、中国人民大学、面壁智能(ModelBest)与OpenBMB开源社区联合发布并开源了端侧智能体模型AgentCPM-Explore。该模型仅凭4B参数规模便在深度探索类任务上取得了同尺寸模型的SOTA(State Of The Art)表现,甚至越级赶超了8B级模型,在部分指标上比肩30B级乃至闭源大模型。大模型的长程任务处理能力真正有望走出数据中心,部
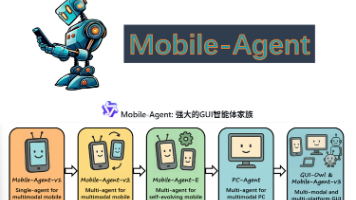
从数据可以看出,GUI-Owl与Mobile-Agent-v3在多项指标上实现了显著提升:AndroidWorld得分达到73.3,OSWorld得分达到37.7,在多模态理解能力方面甚至超越了GPT-4o与Claude 3.7等闭源竞品。其核心目标非常明确:通过多模态大模型与智能体框架的结合,打破传统GUI自动化的技术瓶颈,实现真正通用、鲁棒、跨平台的智能操作能力。从单设备自动化到全平台智能生态
2025年的科技圈,要说谁是顶流,深度学习绝对算一个。它不再是实验室里高冷的学术名词,而是像空气和水一样,正以惊人的速度渗透到我们生活的方方面面,改变着全球各行各业的玩法。这股浪潮由更强的算力、更聪明的算法和海量的数据共同掀起,已经从一个小众研究领域,成长为商业、科学乃至娱乐的基石。从手机相册里的人脸识别,到实时语言翻译,甚至让AI (人工智能) 自己写代码,这种技术的弹性和延展性,让它成了各行各

一群来自清华姚班、前旷视科技的核心人物,决定为具身智能领域建立一套通用准则,叫Dexbotic。Dexbotic是基于PyTorch的视觉语言动作(Vision-Language-Action,VLA)模型工具箱。目的是为具身智能领域的专业人士提供一站式VLA研究服务,由一家叫原力灵机(Dexmal)的具身智能公司开发。

小米汽车与小米具身智能团队联合发布MiMo-Embodied,这是首个成功打通自动驾驶与具身智能双领域的开源多模态基础模型。该模型通过一套统一的架构和渐进式的四阶段训练策略,有效解决了室内机器人与室外自动驾驶车辆之间长期存在的域间隙问题。在涵盖感知、规划、推理等维度的29个权威基准测试中,MiMo-Embodied不仅实现了对现有开源和闭源模型的全面超越,更证明了跨域学习能够实现能力的相互增强而非
去年9月,DeepSeek-R1的研究成果,作为封面文章登上了国际顶尖科学期刊《Nature》。花30万美元训练出来的国产AI模型,曾一度引发美股震荡。DeepSeek-R1用纯强化学习(pure reinforcement learning, RL) 激发了大语言模型的推理能力,无需依赖人类标注的思维路径,让AI自己学会推理,开启了2025推理模型新时代。就在刚刚,又一国产大模型登上Nature
麻省理工学院 (MIT)、英伟达、密歇根大学、加州大学伯克利分校和斯坦福大学刚刚推出了FoundationMotion(又称Wolf V2)。FoundationMotion让AI读懂物理世界的运动逻辑,用自动化工厂重塑视频理解与推理,告别昂贵人工标注。心理学家Barbara Tversky在《行动塑造思维》一书中提出了一个震耳欲聋的观点:空间思维并非思维的附属品,它是思维的基石。这句话精准道出了
一种简单得令人惊讶的方法,只需将现有的短视频素材重组,就能在不增加计算成本的前提下显著提升AI对长视频的理解能力。斯坦福大学、微软研究院和威斯康辛大学团队,提出了VideoWeave数据中心化方法。不需要发明新的复杂架构,也不需要耗资巨大的新标注,仅仅通过改变喂给模型的数据组织形式,就能让AI变得更聪明。训练视频语言模型一直是个烧钱的苦差事。相比于静态图像,视频多了一个时间维度,处理一秒钟的视频往
曾经的开源图像模型王者 Black Forest Labs(黑森林实验室)刚刚发布了 FLUX 3。FLUX 3不再是图像模型,已经进化成把视频、音频、动作预测全塞进了同一个模型里的多模态模型。它将多模态流模型作为视觉智能的基石,开始同时用眼睛、耳朵和触觉去理解世界。Black Forest Labs 成立于2024年,核心创始人是三位曾在Stability AI共同开发了知名开源图像生成模型 S
大家每天滑手机和看网页,常会看到流畅的动画,其中很多是矢量动画。现在,输入几句大白话或一张图,机器就能直接生成这种轻巧的动画。复旦大学,阶跃星辰,香港大学多模态实验室与昆士兰大学的联合团队推出了OmniLottie框架。OmniLottie利用创新的分词技术,把视频、图文指令直接变成了高质量的矢量动画。团队设计了专门的代码压缩方法,整理了200万规模的数据集,让系统能听懂文字,看懂图像、视频频,直