- @qq_35160742


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
在向银行、能源央企或军工单位交付企业级 AI 平台与微服务集群时,等保测评机构的专家通常会在现场直接搬出一台专用的“等保三级合规基线扫描器”,插入网线对承载业务的全部 Linux 宿主机执行深度穿透扫描。半小时后,一份红彤彤的合规检测报告打印出来,很多交付负责人当场傻眼:auditd测评专家直接在《安全整改备忘录》上盖下“限期整改,验收暂缓”的印章。如果交付团队逐台机器、逐个文件去手动修改几十个配

在所有进入大型政企、军工或金融客户物理断网机房实施私有化交付的工程师心中,最恐怖的梦魇绝不是容器镜像拉不下来,而是系统在安装底层 Kubernetes、GPU 显卡驱动或安全组件时,遭遇了令人崩溃的**“操作系统底层依赖地狱(Dependency Hell)”**。在有外网的环境下,缺少依赖只需要敲一行,包管理器会自动从公共镜像源递归下载所有的关联依赖,十秒钟搞定。然而,在客户彻底物理断网的数据中

在等保 2.0(三级)的常态化安全合规考核中,“安全运维管理——漏洞和风险管理”是让无数安全运维工程师最头疼的“扣分重灾区”。测评专家手持最新的国家信息安全漏洞库(CNNVD/CNVD)与国际通用漏洞列表(CVE),对企业的生产资产发起全面扫描。报告一出来,往往赫然列着好几条“严重(Critical)”级别的高危漏洞:某个底层基础镜像使用的 OpenSSL 版本存在缓冲区溢出漏洞;Linux 操作

当企业级自主智能体(Agent)被赋予调用财务退款、修改合同条款或执行生产系统调度的核心权限时,很多企业法务与安全合规部门都会抛出一个最致命的法律合规质问:在传统的 Web 系统中,审计日志通常只是简单地用logrus或zap打印一行 JSON,然后异步推入 Elasticsearch。这种常规日志在法律层面是极其脆弱的——任何拥有操作系统 Root 权限的系统管理员,都可以随意登录日志服务器修改

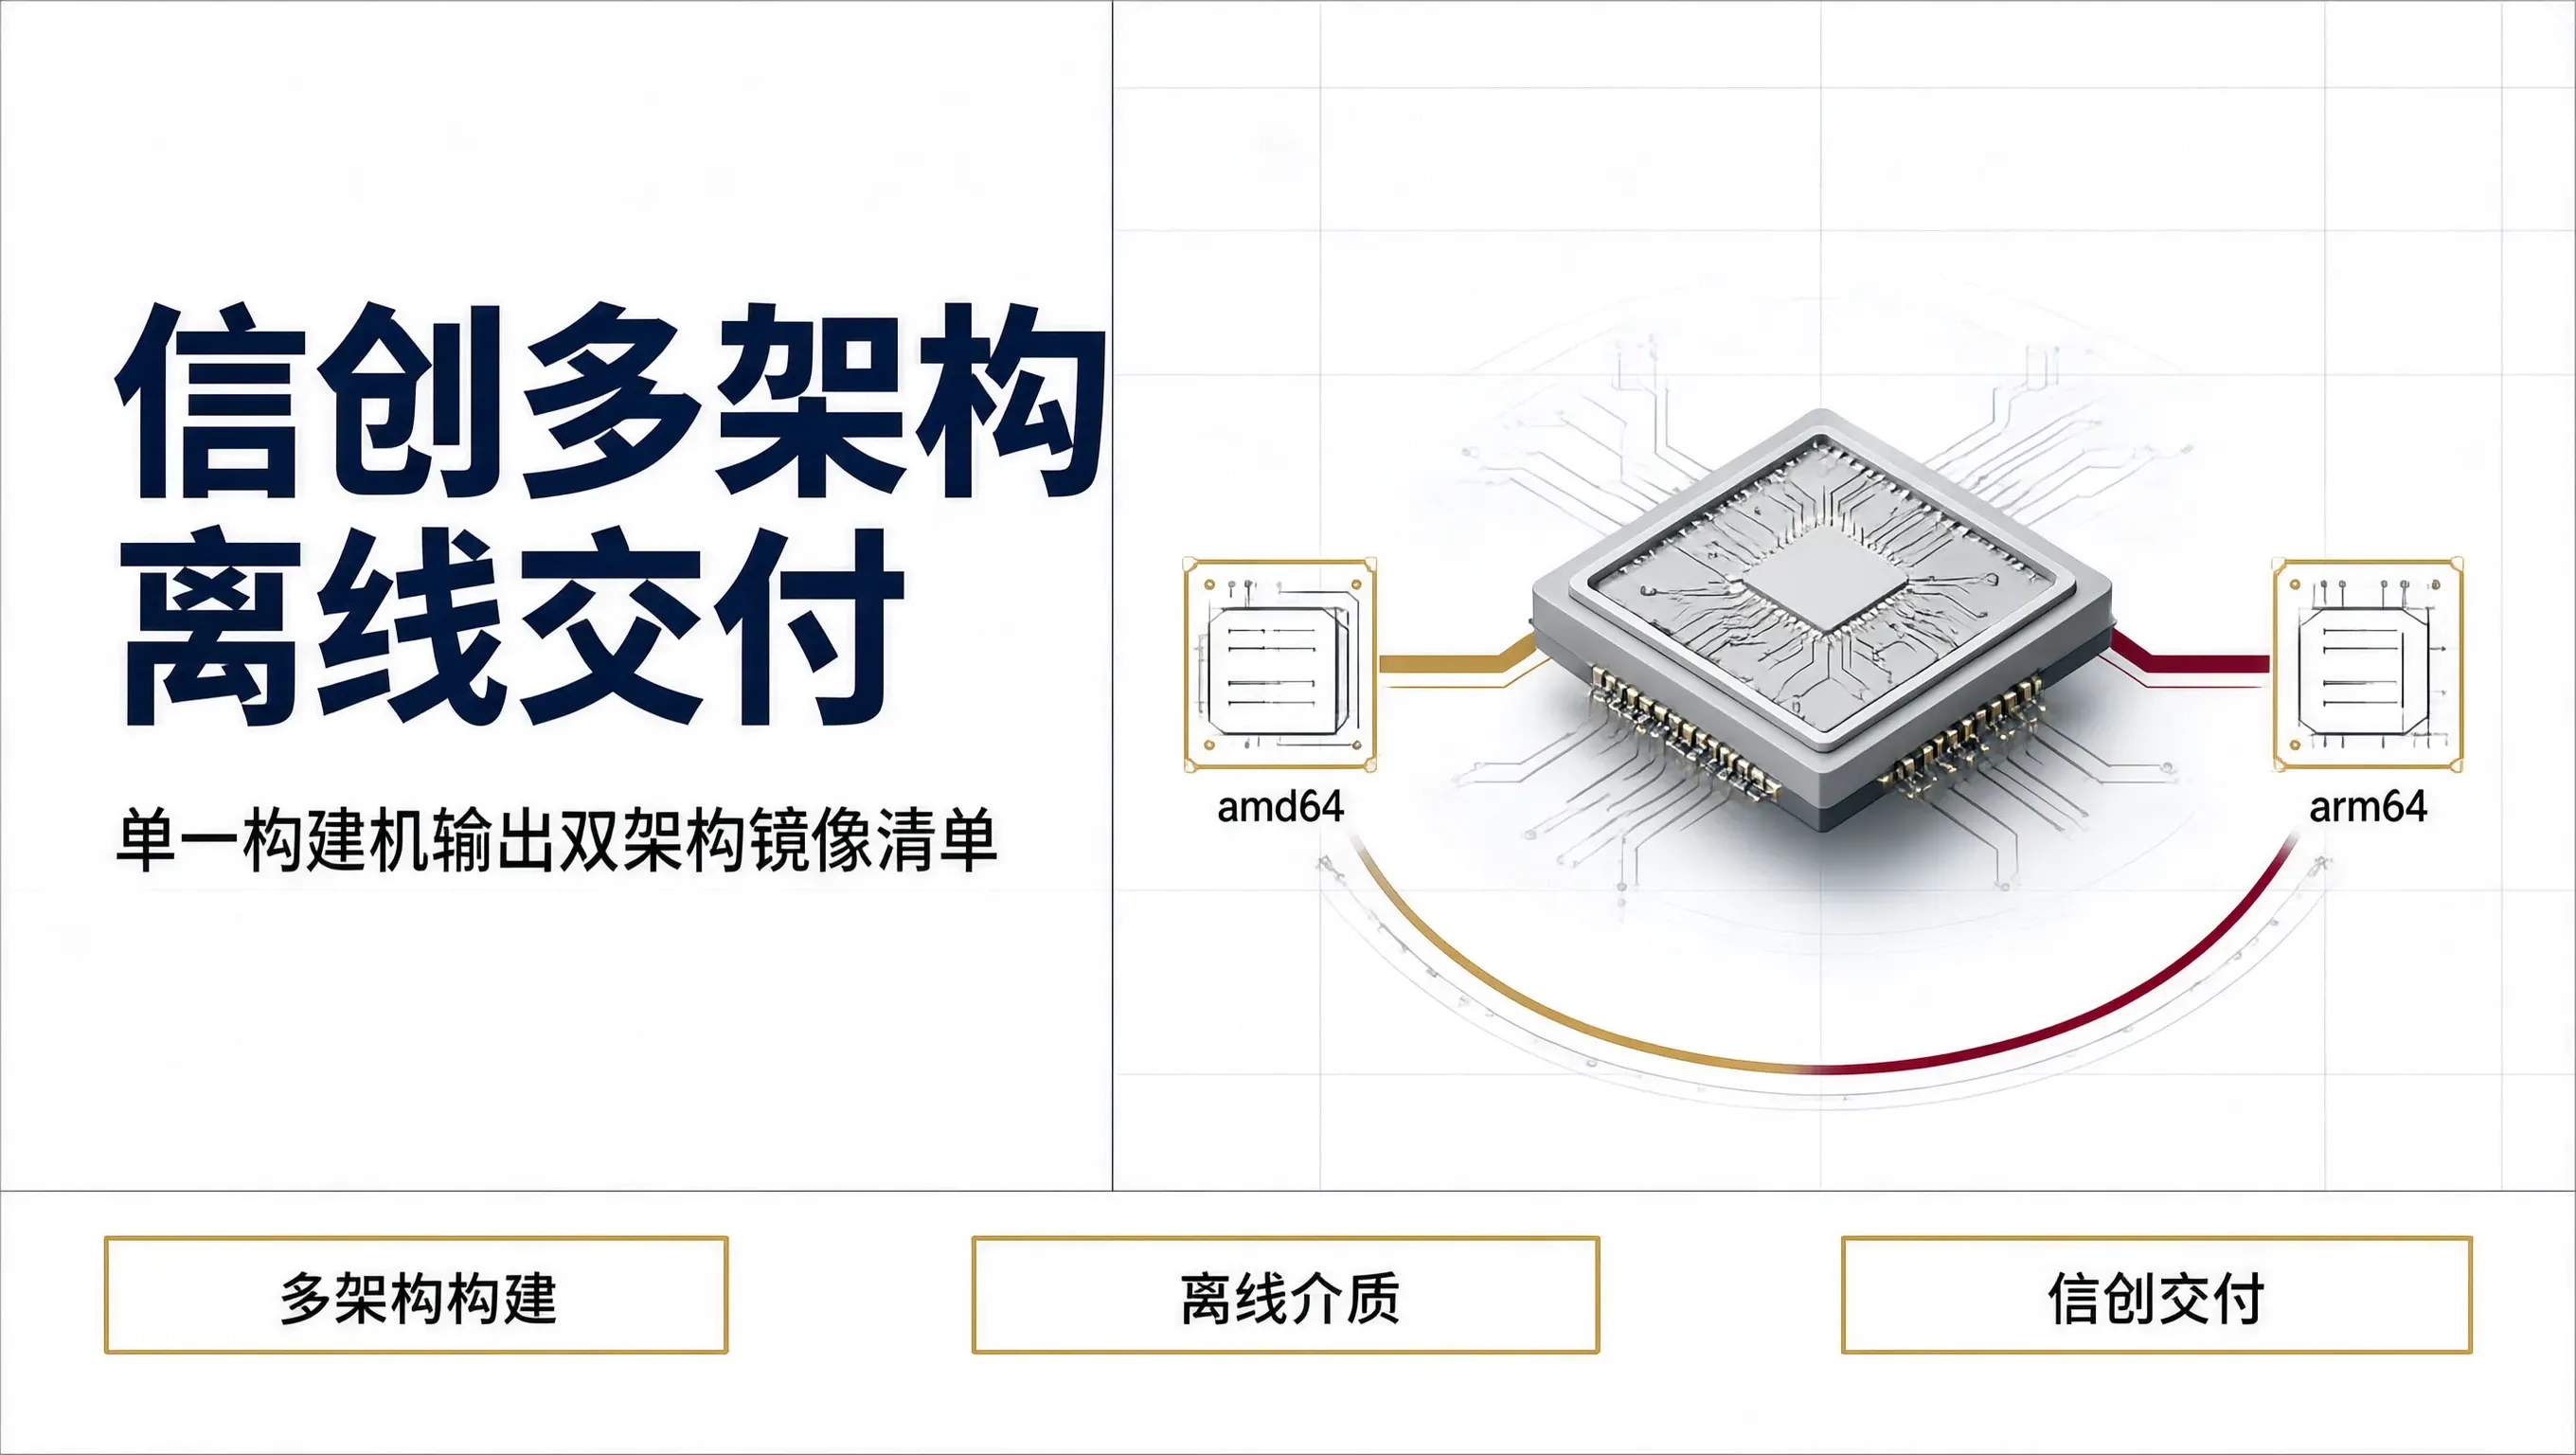
过去,团队的开发机是 Intel/AMD 芯片,编译出来的 Docker 镜像自然都是架构。然而一旦把介质包送进国有大行、电网、电信运营商或政府政务云机房,现场的物理服务器清一色是基于国产 ARM64 架构的芯片(如华为鲲鹏 920、飞腾腾云 S2500)。如果交付团队没有在出厂阶段做好多架构交叉编译,到了现场一执行docker run。
在多租户智能体平台走向大型集团企业、生态合作伙伴与第三方 ISV(独立软件开发商)深度集成的过程中,是将单一产品跃升为行业级工业操作系统的必由之路。为了打造兼具“”的开发者开放平台,YueJoy 构建了基于**“HMAC-SHA256 签名鉴权 + OAuth 2.0 / API Key 双通道 + 声明式 OpenAPI 3.0 标准驱动”**的开放网关架构。

在人工智能、大模型与云原生技术爆发式增长的今天,GitHub 上每天都会冒出成百上千个宣称“颠覆行业、颠覆上一代框架”的开源项目。
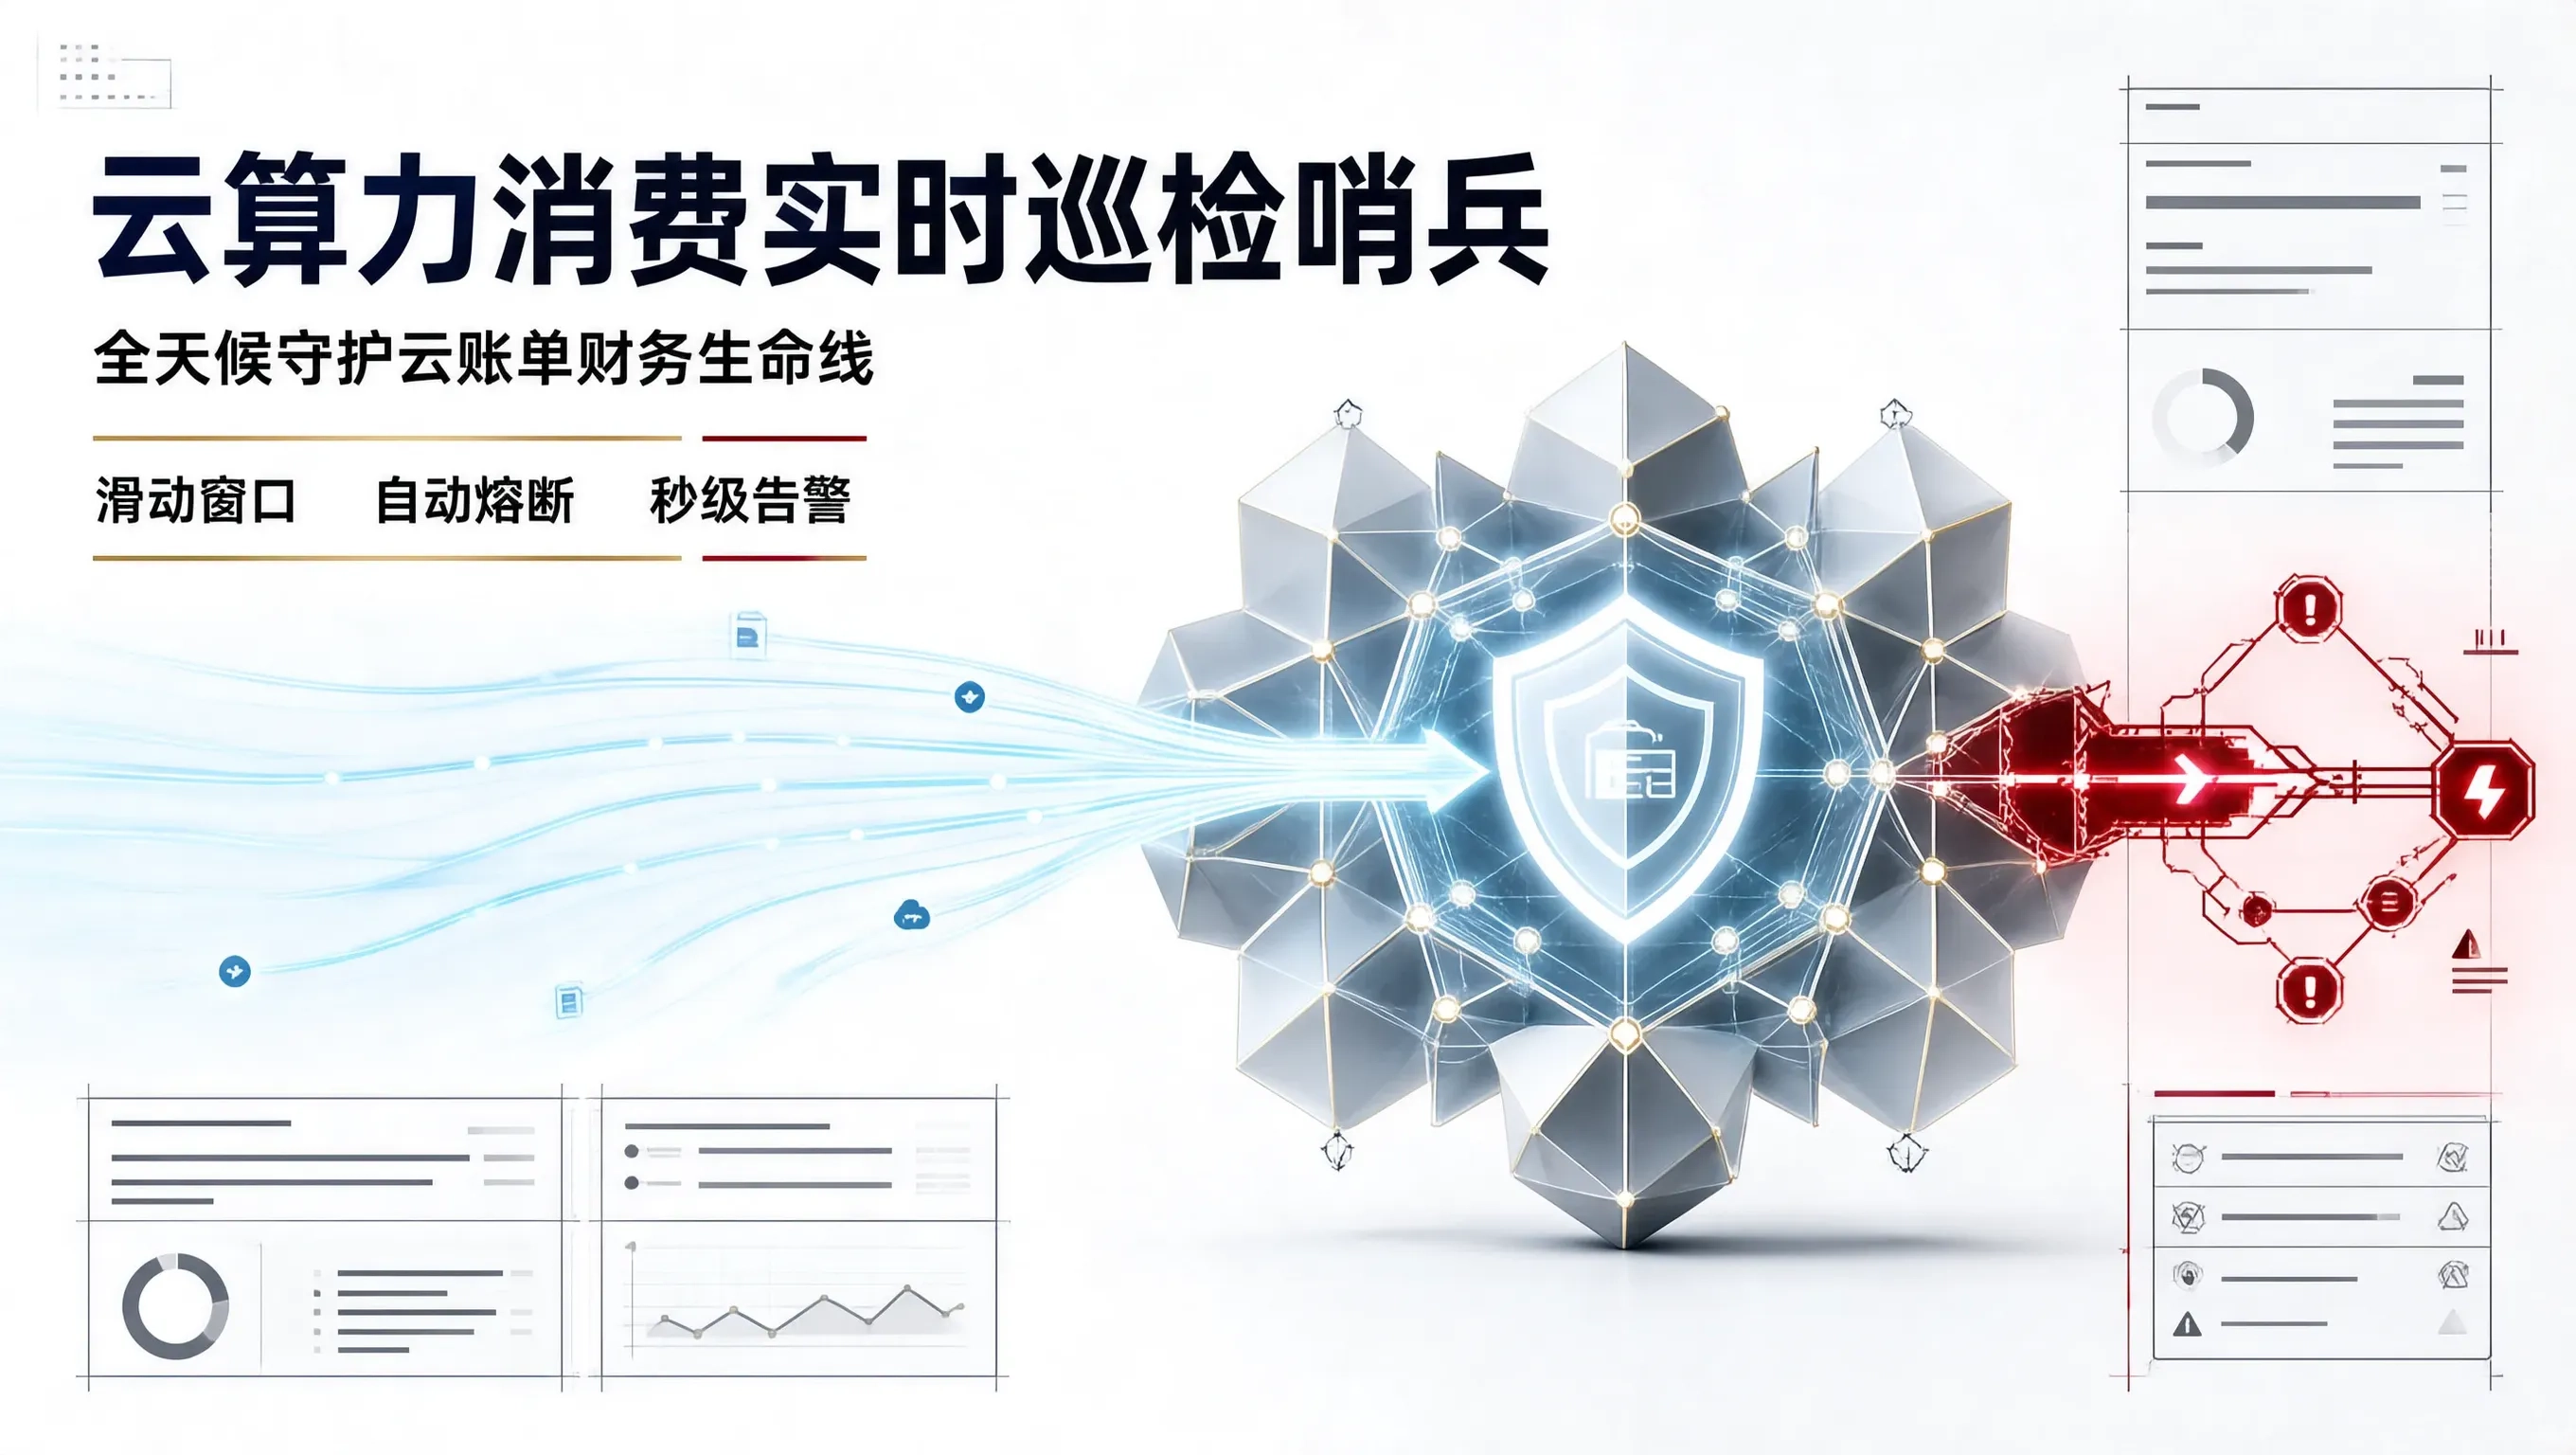
在云计算与大模型 API 的日常使用中,“”是每一个技术团队最深沉的梦魇。如果团队仅仅依靠“月末看一眼云厂商月结账单”或者“依赖云厂商默认延迟长达 24 小时的账单预警”,灾难发生时公司现金流早已被洗劫一空。构建一套,基于滑动窗口(Sliding Window)每 5 分钟探测消费速率,
在过去三周连载的 19 篇深度技术拆解中,我们对 YueJoy 自研的进行了从底层调度到上层交互的全景源码级剖析。这套系统在设计之初就摒弃了传统 BPMN 繁复冗余的 XML 规范和大厂庞大沉重的重量级框架,完全从多租户高并发、大模型长交互与云原生架构的第一性原理出发,构建了一套高可靠、微秒级响应、强安全的现代工作流中枢。本文作为周末特刊,将连载一至十九篇的核心架构精粹进行系统性的全景串联。
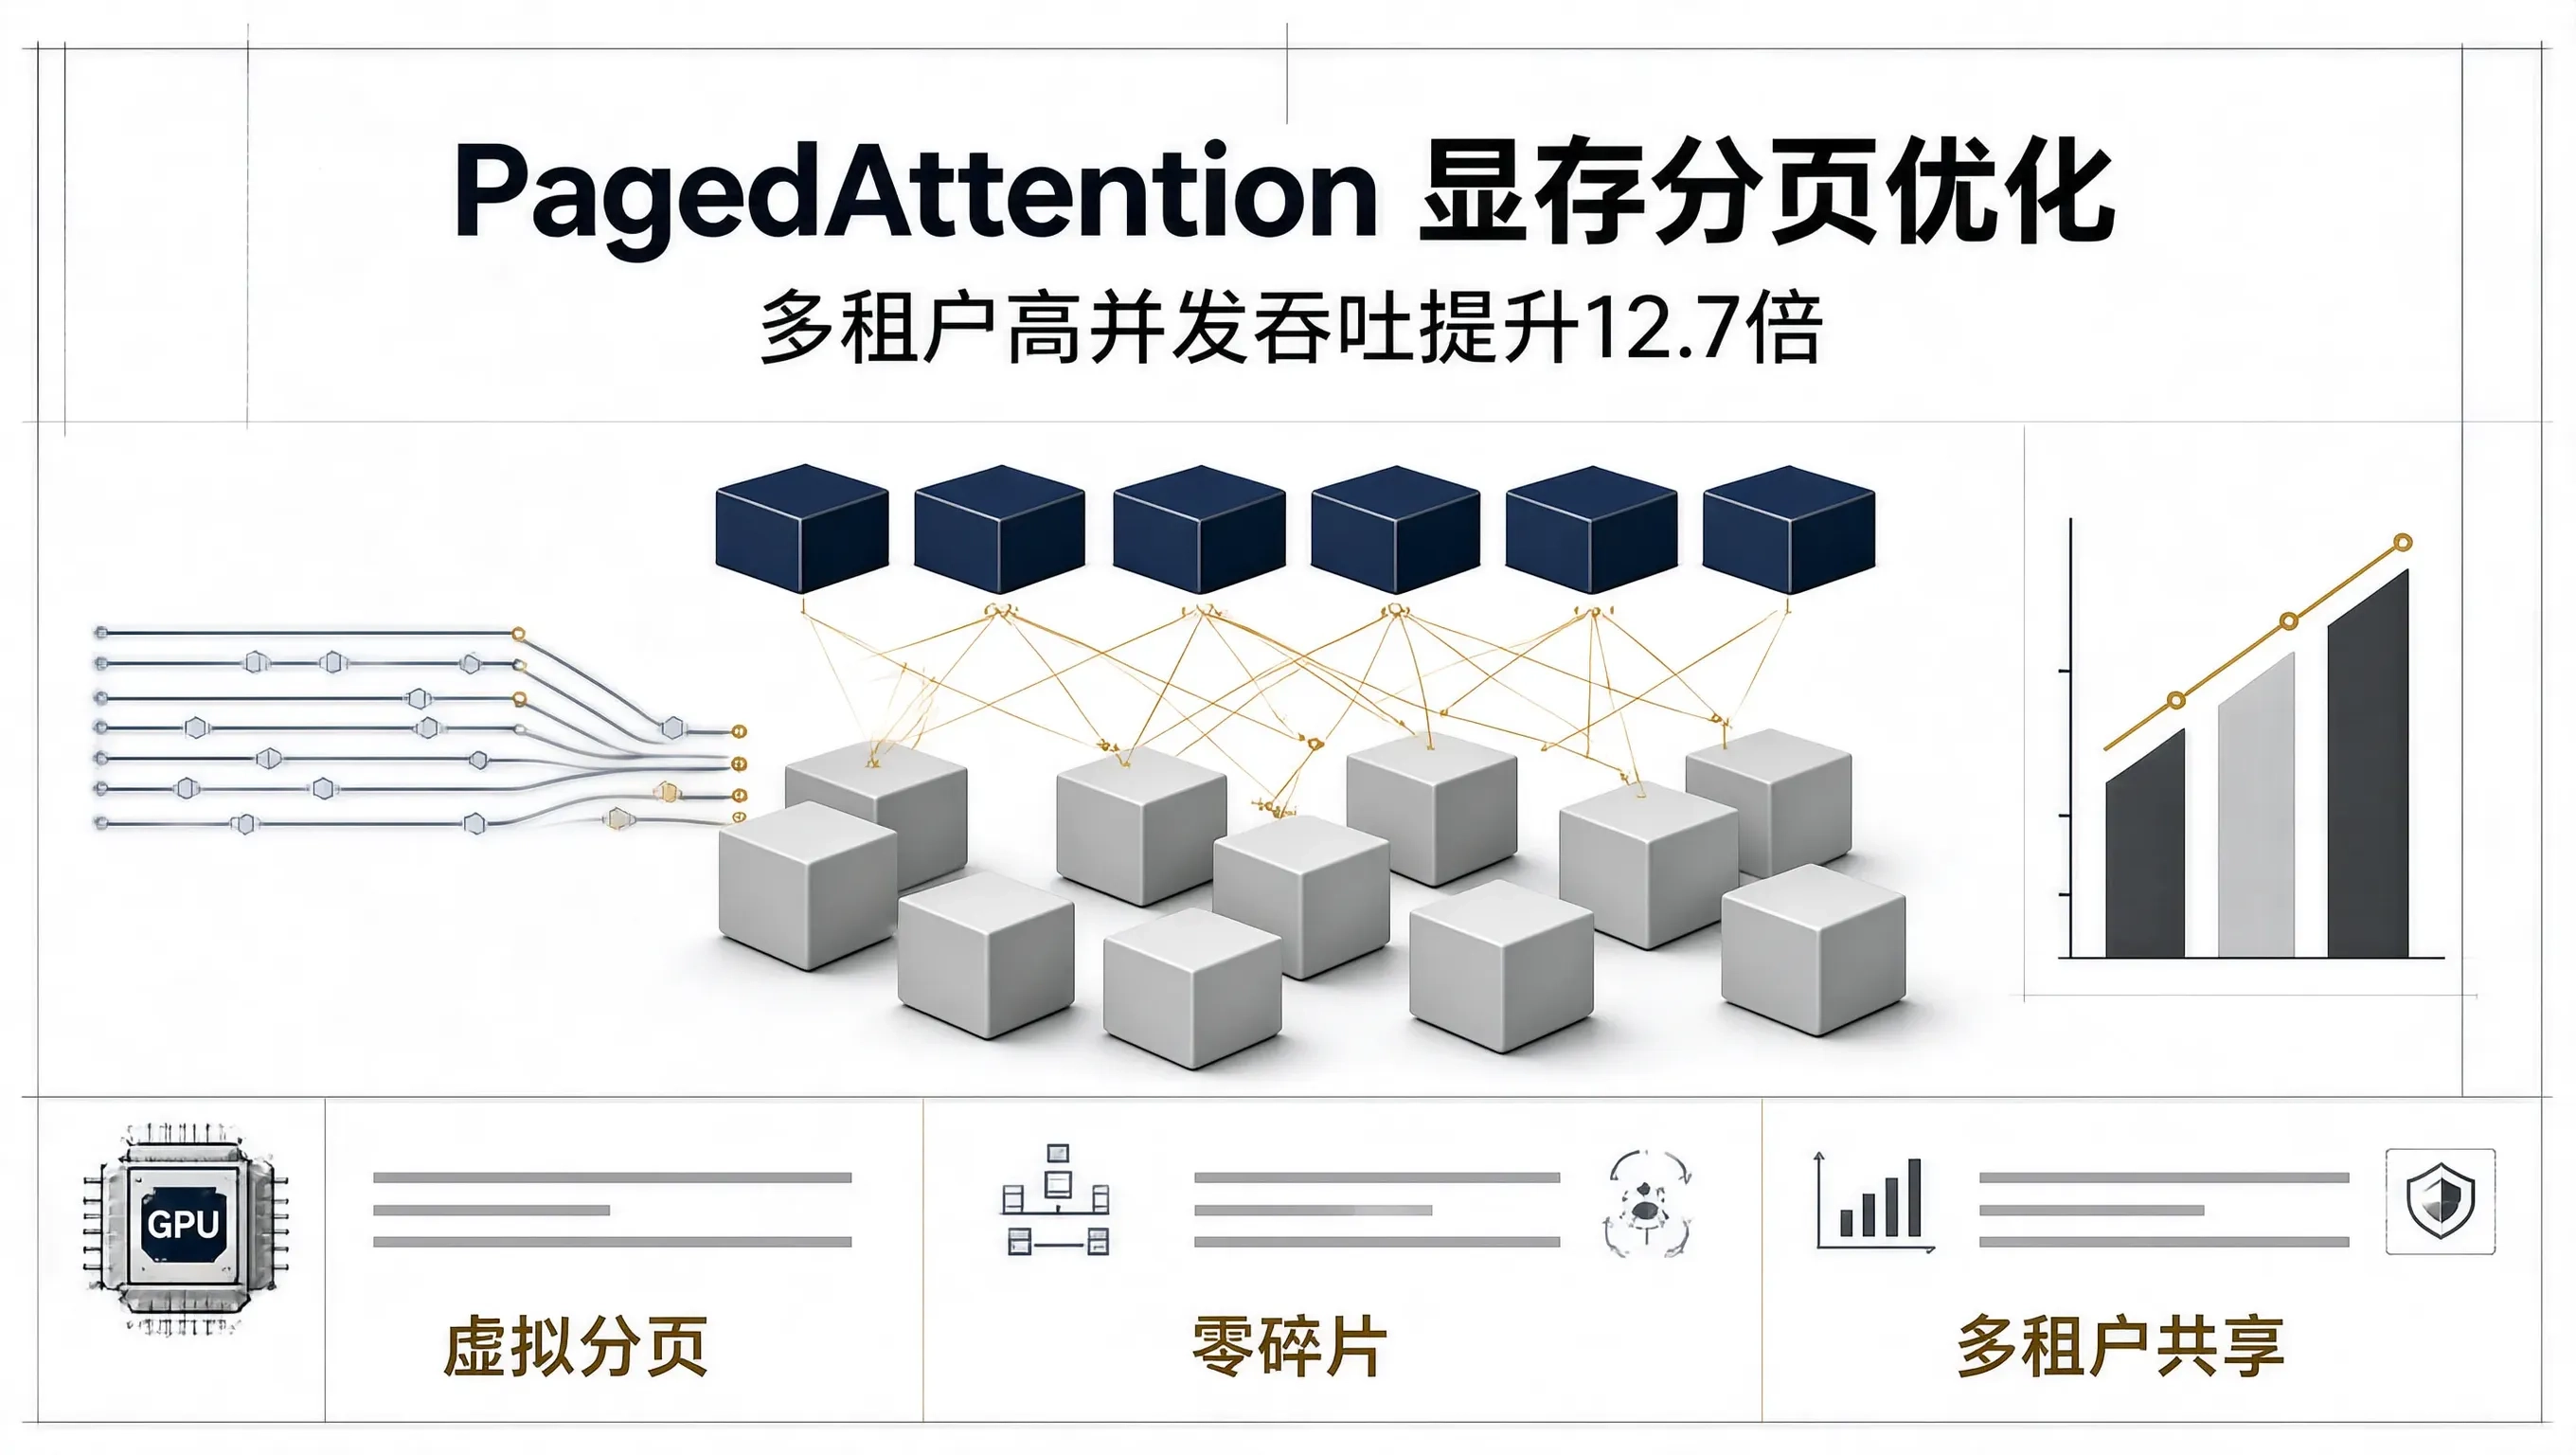
在多租户企业级大模型推理服务中,“”是直接决定系统能否以极低硬件成本承载海量并发的核心战役。在传统的推理框架中,显存是按照请求预设的“最大长度(Max Context Length,如 8,192)”进行静态连续内存预分配的。UC 伯克利团队发表在 SOSP 顶级系统会议上的经典论文《Efficient Memory Management for Large Language Model Serv