- @2401_85575345


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
上周例行巡检数仓计算集群时,一条监控指标异常刺眼:一个平时只要跑两分钟的日级汇总任务,昨天突然跑了近一个半小时,Spark UI 上一个原本平平无奇的 Stage 堆满了上百次 Shuffle Spill(Disk)。点进执行日志一看,某个业务线新增了按“用户客户端设备指纹(device_fingerprint)”进行分组聚合的逻辑。原本业务只按“省份 + 年龄段 + 操作系统”聚合,总分组数(基
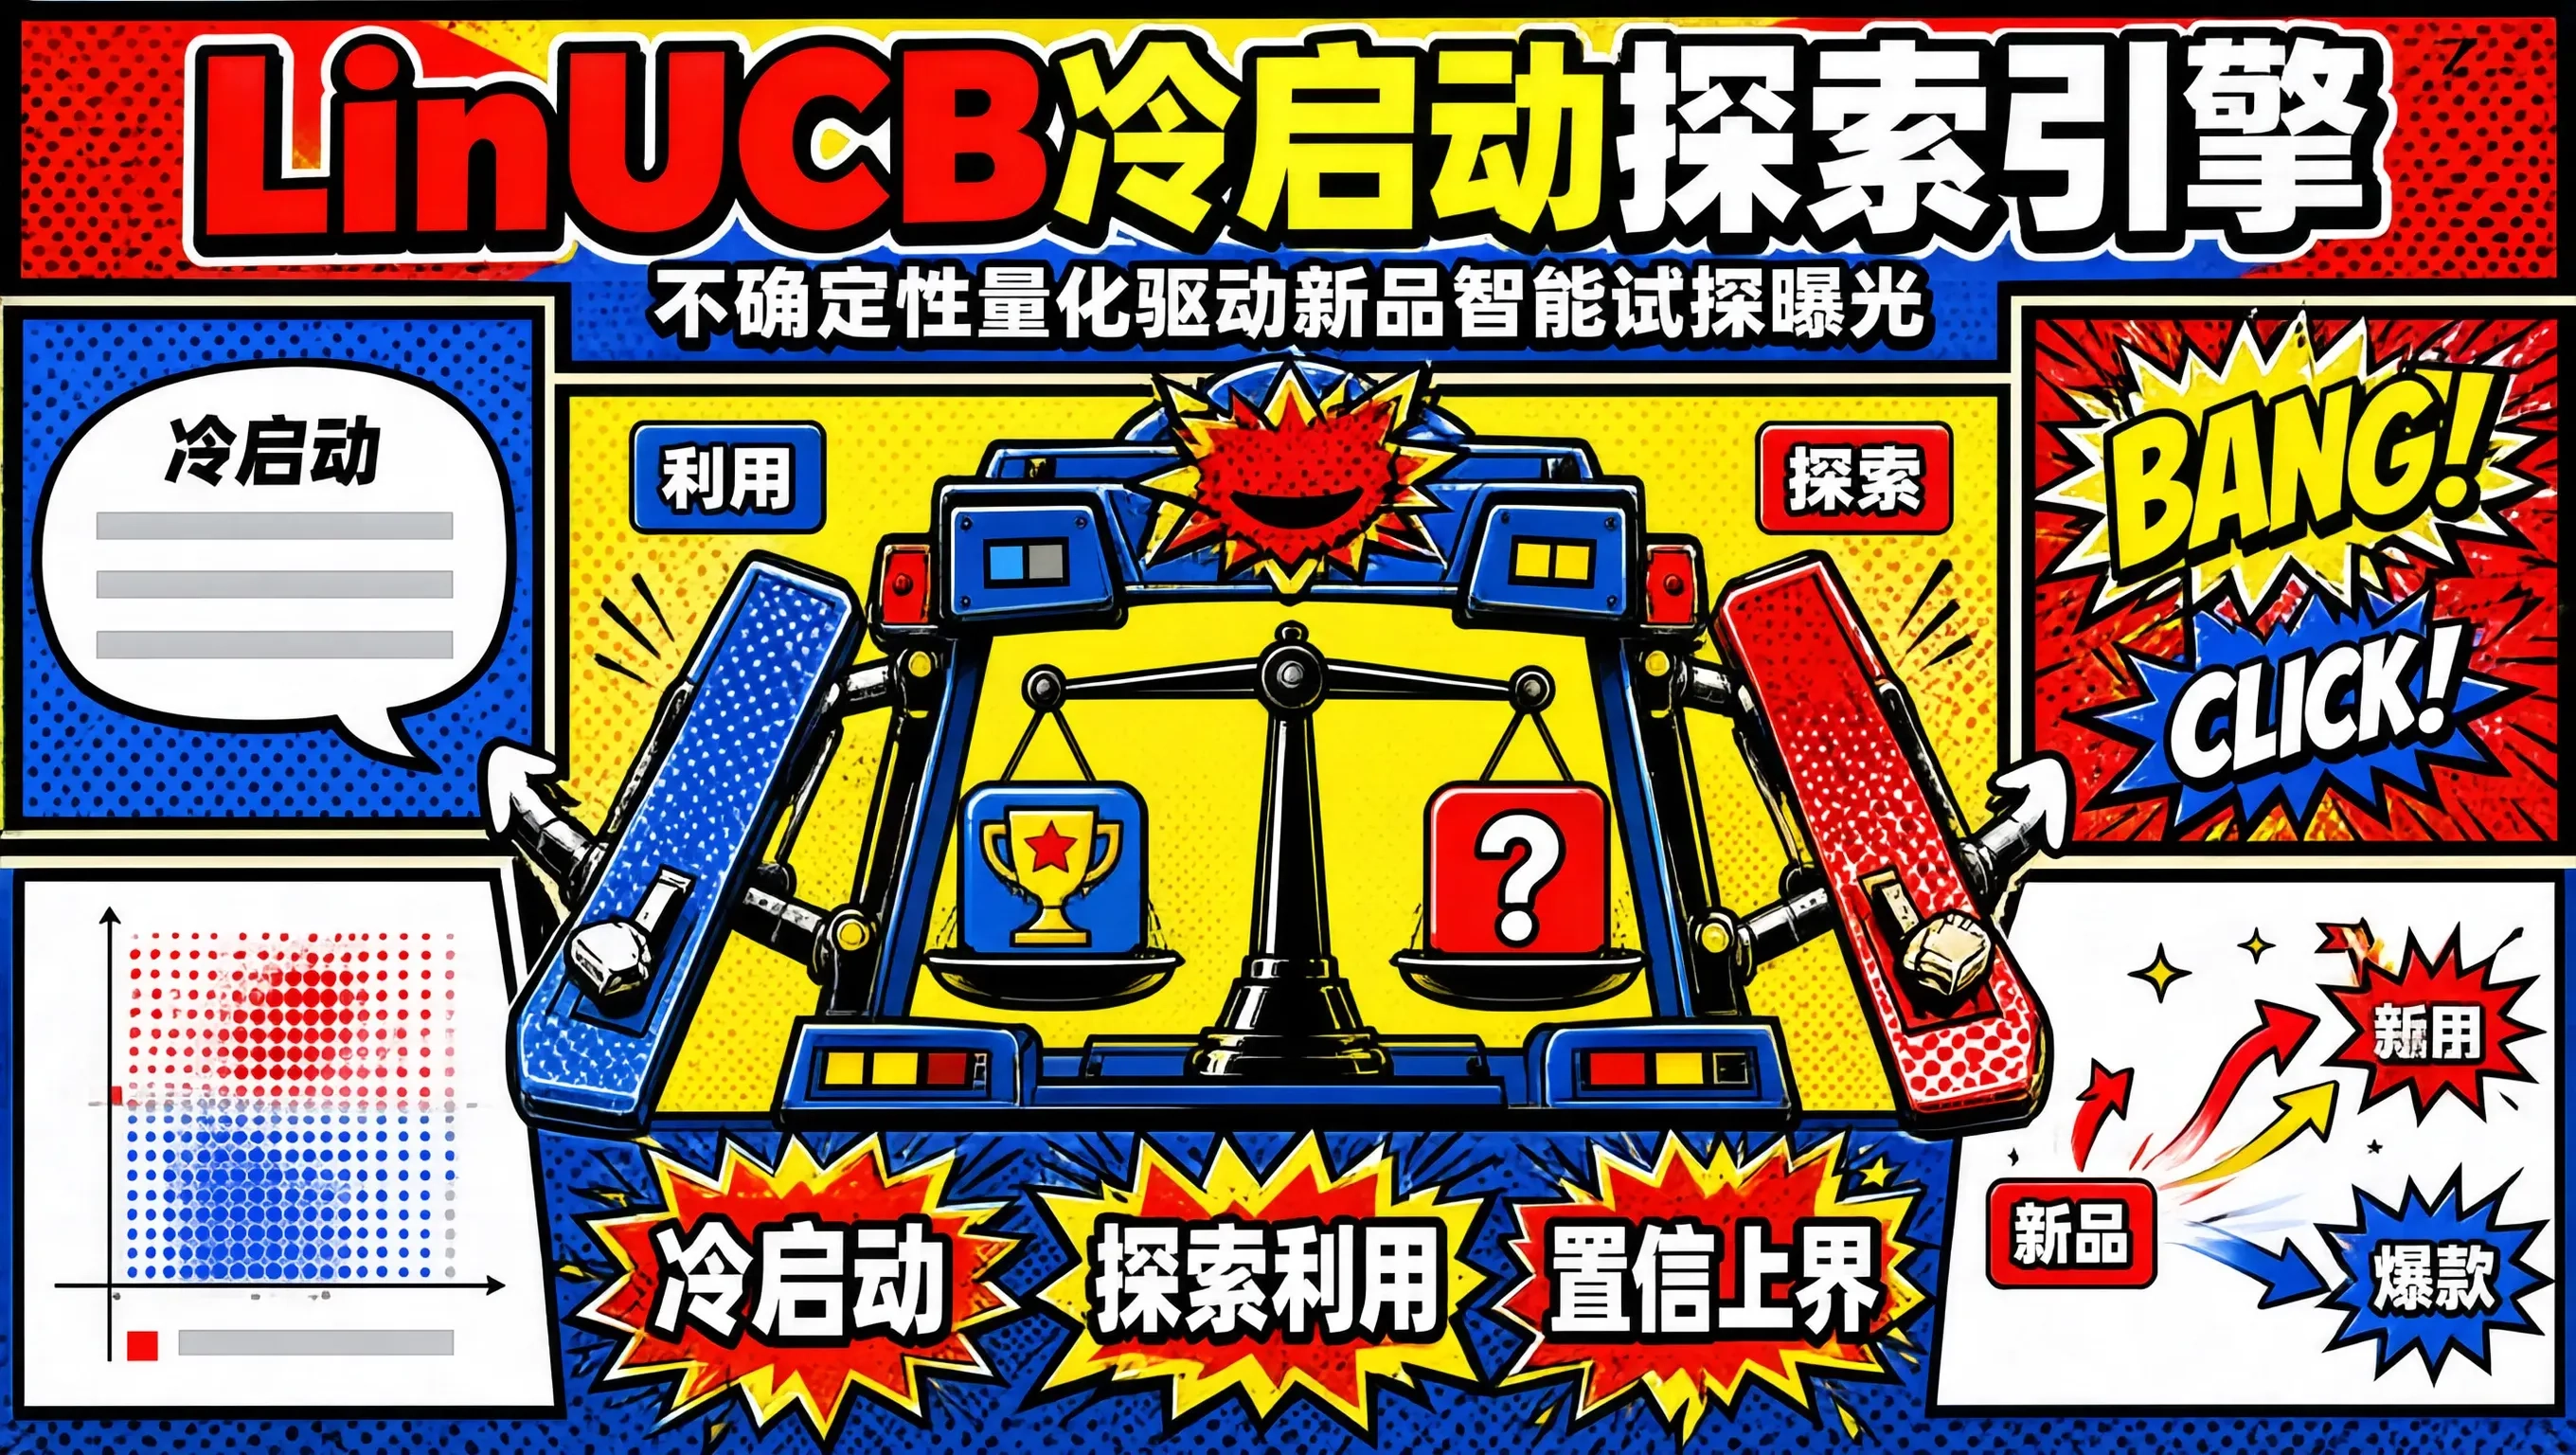
在个性化推荐系统、电商新品曝光冷启动、以及广告点击率预估(CTR)中,算法团队永远面临一个最核心的经典博弈难题——单纯依靠随机给新品分流(Random Exploration)会严重伤害用户的真实体验与 GMV。强化学习与运筹学领域的给出了最优雅的数学解法:通过将,在估计期望收益的同时,,实现了“对高价值新品的动态智能试探曝光”!今天我们系统拆解 LinUCB 推荐冷启动算法的数学底层推导与 Py
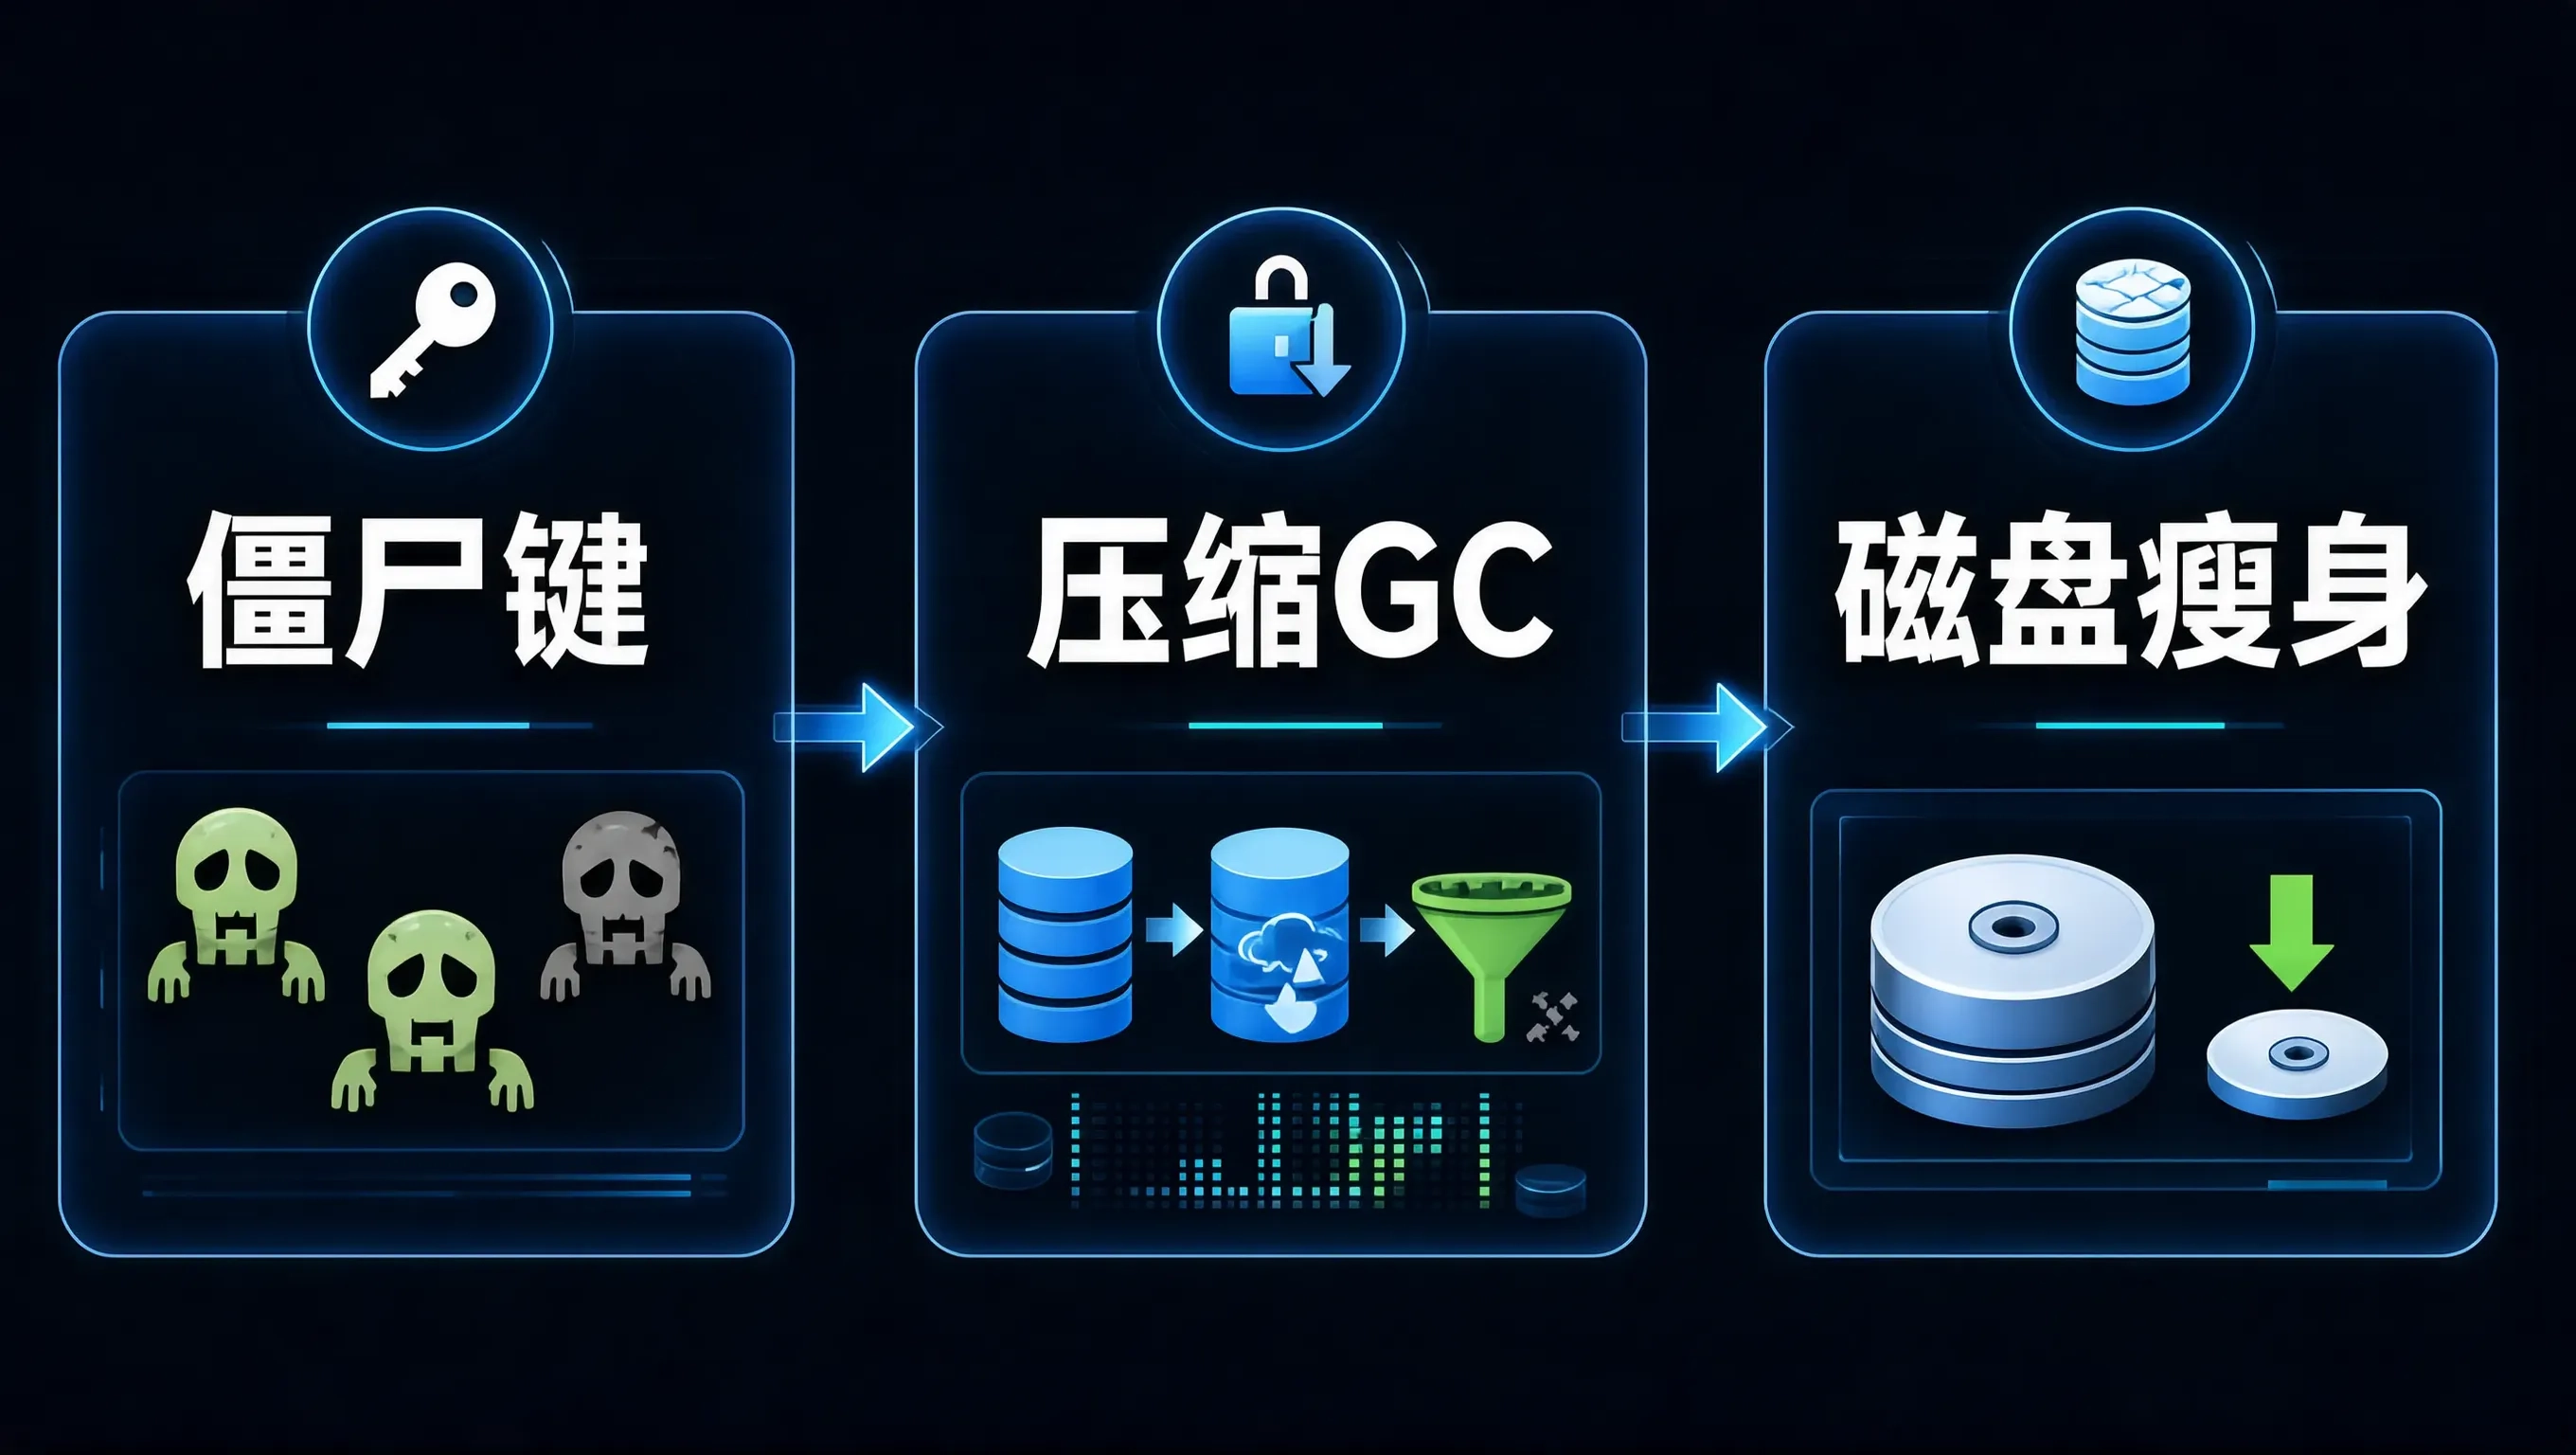
在 Apache Flink 构建 7x24 小时不间断运行的企业级实时数仓宽表与用户画像标签任务中,流计算工程师面临的一项最隐蔽、也是最具破坏性的“慢死故障”,莫过于**“无界流状态无限膨胀导致的物理磁盘打爆(State Unbounded Expansion & Disk Full Crash)”**。KeyedState为了从物理上根治状态无限膨胀,Flink 引入了革命性的。通过配合,可以
在零售电商、自营供应链以及收益管理(Revenue Management)领域,定价团队在面临重大促销改价决策时,往往处于高度的如果只用静态的确定性公式计算,我们只能得到一个单点的“理论数字”;但在真实的商业战场中,外部环境充满着随机扰动与市场博弈。为了在改价前夕全面评估收益的期望值与尾部下行风险(Tail Risk / VaR),现代商业分析广泛采用**“计量经济学价格弹性需求函数 + 蒙特卡洛
在跨国跨境电商进出口贸易(Cross-Border E-commerce)、全球海运航空干线物流调度、以及全球网络流量 CDN 节点流向监控中,业务分析人员需要审视利用 Python 的scattergeo,数据工程师可以一行代码渲染出。
看板设计的核心不是图表多炫酷,而是信息架构是否清晰、交互逻辑是否符合决策者的思维路径。起步阶段:先用 Plotly Dash 搭建内部看板,验证指标体系和交互逻辑进阶阶段:将高频访问的看板迁移到 ECharts,优化渲染性能和视觉体验成熟阶段:构建看板组件库,实现指标配置化、布局模板化、部署自动化每多一次点击才能找到答案,就多一分决策延迟。
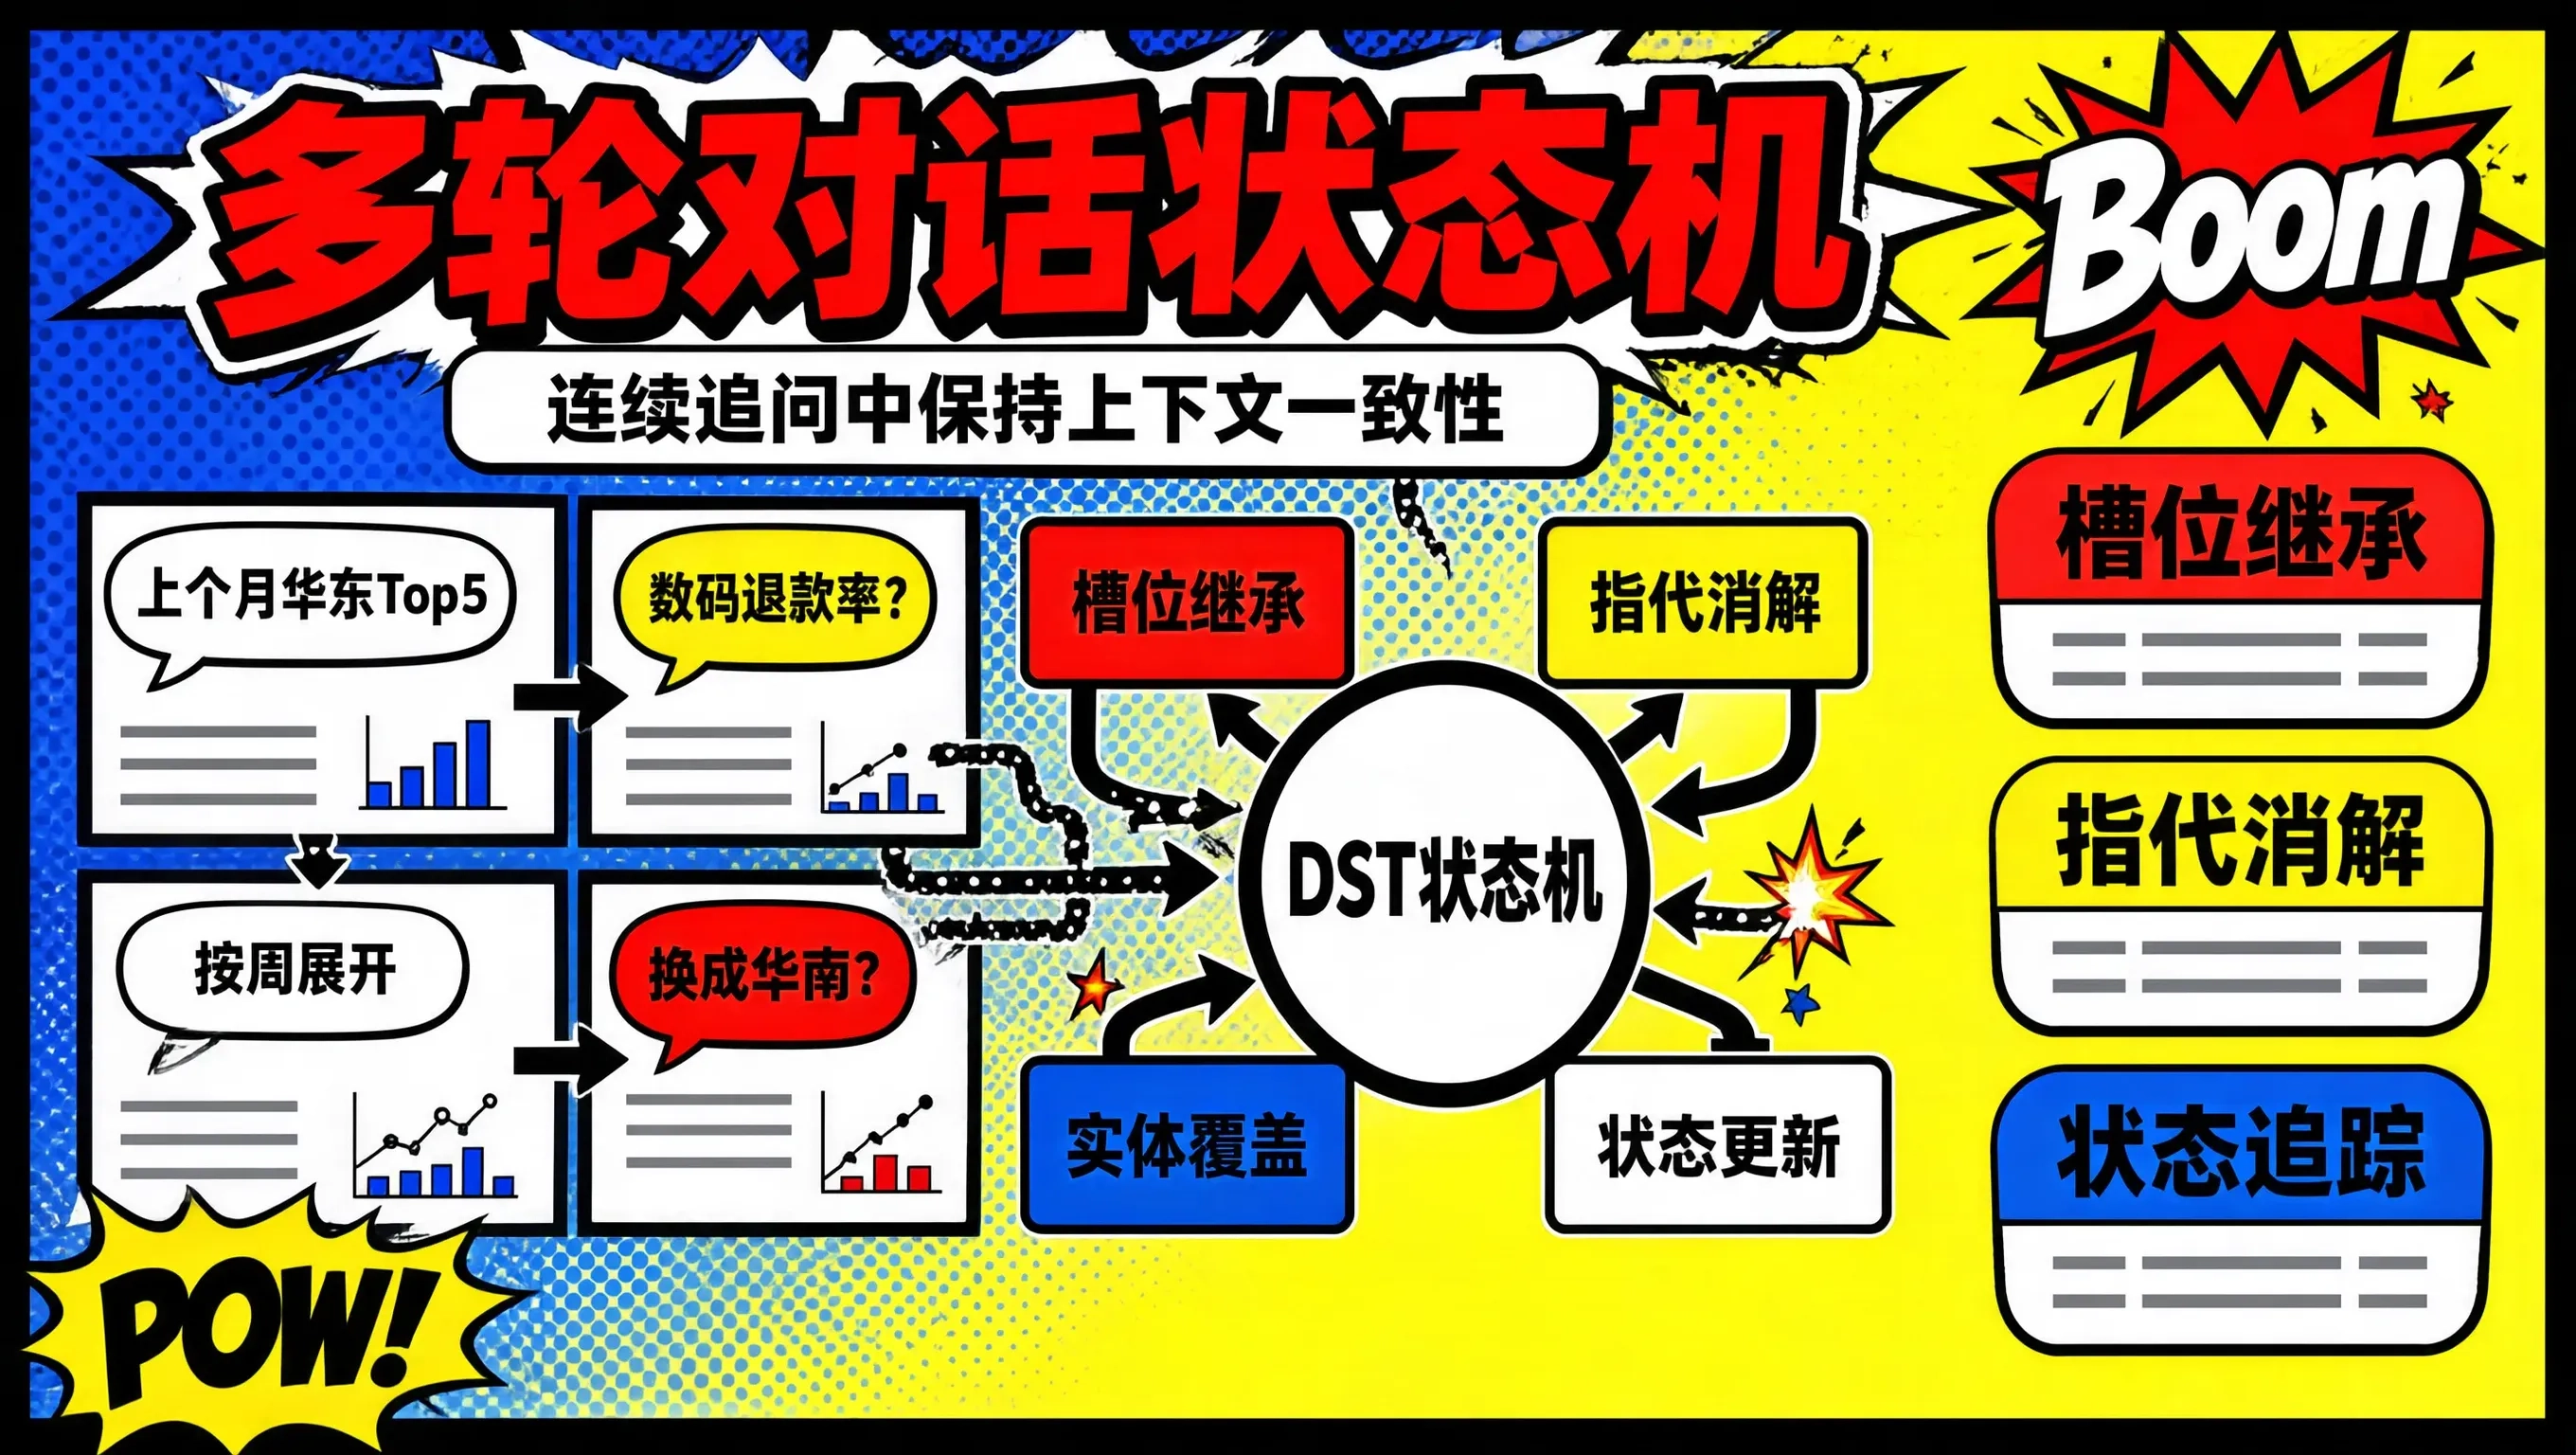
在企业级对话式数据分析(ChatBI)的真实交互场景中,业务分析人员很少会在单次提问中就把所有查询条件表达完整。人类在探索数据时,天然习惯进行隐式继承了:上个月、华东大区、以及上一轮查出的 5 家具体门店 ID!实体替换操作:保持其他所有过滤条件不变,仅将大区从华东替换为华南!如果底层系统是一个无状态的“单轮问答机器人”,在第 2 轮时它会因为找不到主语而生成错误的全局退款率,在第 4 轮时会彻底
"会用 AI"和"会系统化地用 AI"是两件完全不同的事情。知道什么任务适合 AI、什么任务不适合给 AI 的输入有结构、有约束、有校验给 AI 的输出有多层过滤每次使用后都做复盘,优化下一次的 Prompt 或流程AI 不会替代数据分析师,但会用 AI 的数据分析师会替代不会用的。这行发展到今天,技术工具在快速变化,但"理解业务、定义问题、判断质量"这些核心能力,不但没有被削弱,反而因为 AI
AI 智能问答的 FAQ 知识库自动构建,本质上是在解决"知识管理的规模化"问题。人工维护知识库的瓶颈在于:人能写的FAQ数量有限、人能检查的更新频率有限、人能评估的质量范围有限。AI 把这三个"有限"变成了"可自动化"。但我必须诚实地说:AI 并没有完全替代人工。我们最终的方案是"AI 负责 80% 的构建和维护,人工负责 20% 的复核和兜底"。这 20% 是关键——它们处理的是置信度低的问题
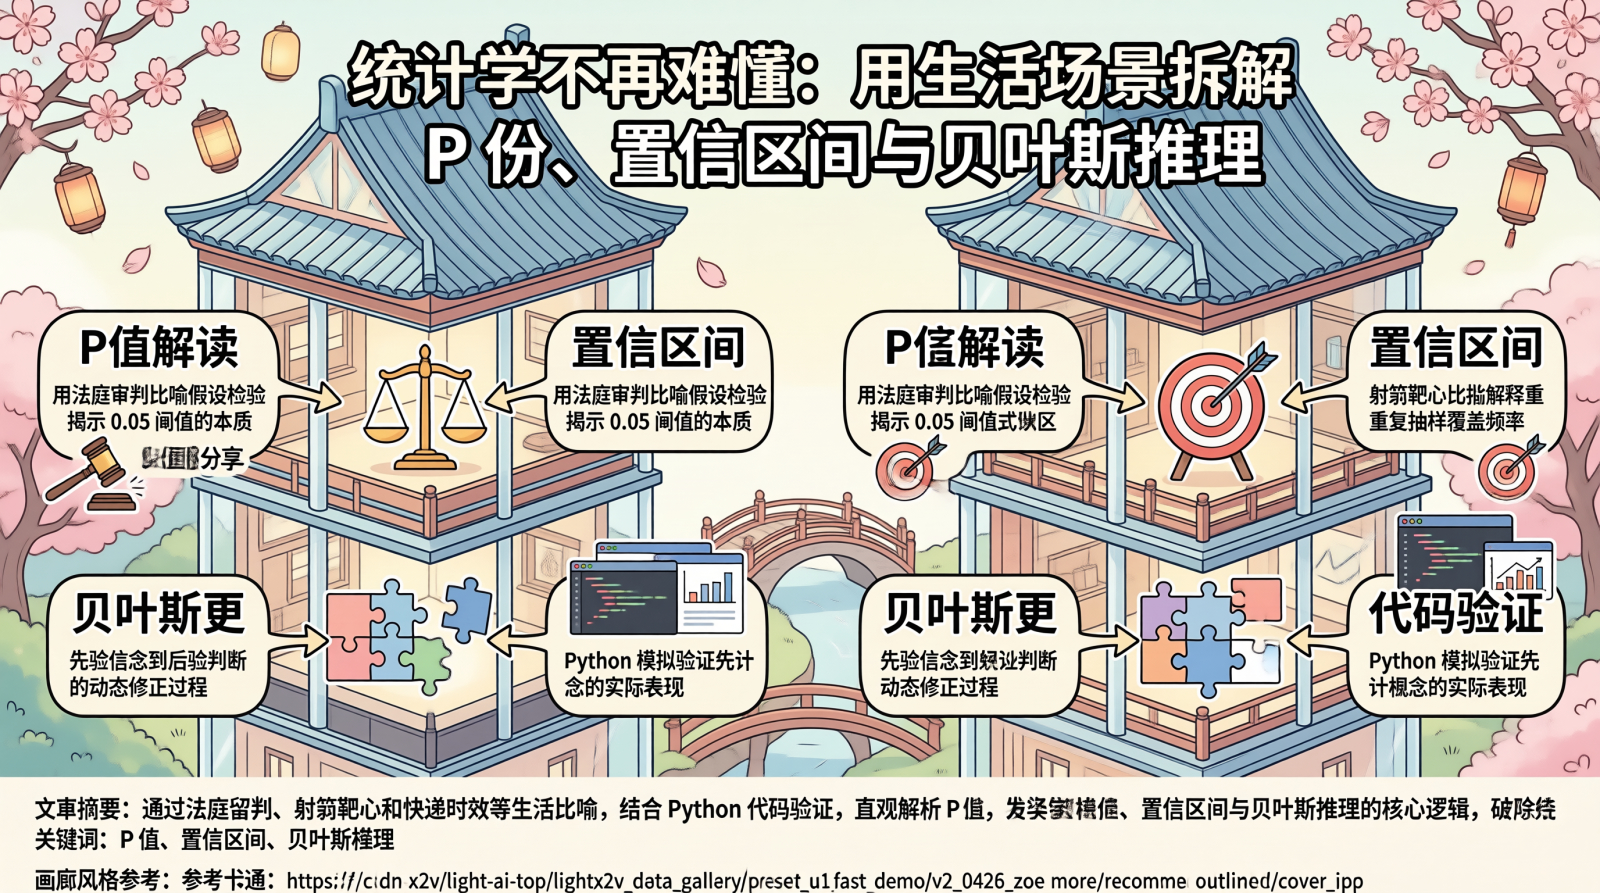
统计概念科普的核心挑战不是"把公式翻译成白话",而是"找到日常经验中与统计逻辑同构的场景,建立直觉映射"。落地路线建议:第一步,用法庭比喻讲 P 值,用快递比喻讲置信区间,用"先入为主再修正"讲贝叶斯。比喻只是脚手架,理解概念后必须拆除——在比喻之后补充严格的数学定义和边界说明。第二步,用模拟代码验证直觉。P 值的均匀分布、置信区间的覆盖频率、贝叶斯的基础概率忽视——这些反直觉的结论,跑一遍模拟代