登录社区云,与社区用户共同成长
邀请您加入社区
在浏览器客户端直接运行轻量化深度学习模型,不仅完全可行,而且在成本、隐私与响应速度上展现出了对传统云端架构的降维打击优势。通过将经过精细化剪枝的 MobileNetV3 骨干网络与 Web Worker、OffscreenCanvas 以及严密的显存治理机制有机结合,我们不仅为用户构建了一套毫秒级响应、100% 离线隐私安全的 1024 维高维视觉搜索工具,更为扩展开发者彻底甩掉了昂贵的云端算力包
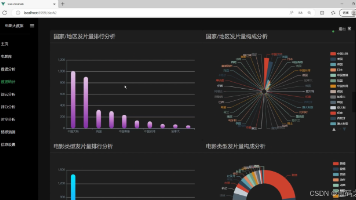
本文介绍了一个基于Python技术的豆瓣电影数据分析与推荐系统。系统采用Vue+Flask框架,整合Scrapy爬虫、LSTM情感分析、双协同过滤推荐算法和Echarts可视化技术,实现了从数据采集到智能推荐的全流程解决方案。核心功能包括:通过Scrapy爬取豆瓣电影数据并存储至MySQL;使用LSTM深度学习模型分析影评情感倾向;结合基于用户和物品的双协同过滤算法实现个性化推荐;利用Echart
本文详细解析了RAG(检索增强生成)技术,解释了它如何解决大模型的三大短板:幻觉、知识滞后和缺乏私有知识。文章拆解了RAG的四个工作流程步骤(数据准备、检索、增强、生成)和四大核心组件(Langchain文本分割、向量数据库、Embedding模型、LLM)。RAG通过"外部知识检索+大模型逻辑推理"的组合模式,使大模型从聊天机器人进化为专业助手,是企业知识库和AI搜索的底层技术。
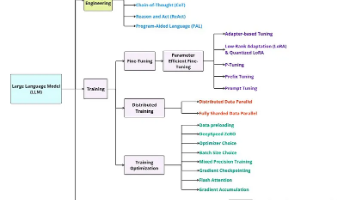
文章全面介绍了大语言模型(LLM)的基础知识、架构设计和训练方法,重点讲解了参数高效微调(PEFT)技术如适配器、LoRA和QLoRA,以及提示工程、模型压缩方法(如剪枝和量化)。同时详细讨论了各种量化技术(GPTQ、NF4、GGML)和蒸馏、剪枝等减小模型大小的技术,为开发者提供了完整的大模型应用与优化指南。
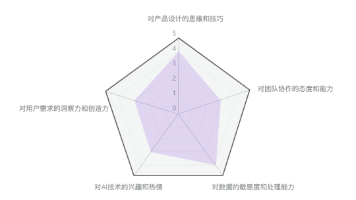
但是,你是否了解什么是大模型?大模型又有什么特点和优势?为什么大模型会成为AI领域的一个重要趋势?如果你想转行做大模型,你需要具备哪些基本素质和技能?你又该如何评估自己是否适合这个领域?
本文汇总了Transformer模型的面试问题,涵盖基础原理、训练优化和应用场景。基础部分包括多头注意力机制、位置编码、LayerNorm等核心概念解析;训练优化部分探讨Embedding层复杂度、BPE分词、参数缩减等技术细节。还提供了大模型学习资料包获取方式,适合准备AI面试的开发者参考。全文系统梳理了Transformer的关键知识点,从数学原理到工程实践均有涉及。
本系统是一套面向大型风电场的短期功率预测解决方案,核心设计理念是结合数据分布特征与深度学习优势,通过“聚类分组-代表性选择-模型预测-结果验证”的全流程架构,实现高精度、高效能的功率预测。系统创新性地采用高斯混合模型(GMM)对风电场机组进行智能聚类,再通过深度学习模型(CNN-BiLSTM及其注意力机制增强版本)完成分簇预测,最终通过多维度指标验证预测效果。该系统支持灵活的参数配置与模型选择,适
我们会尽快通知你结果。
文章介绍了RAG(检索增强生成)技术,解决大模型时效性低、知识深度不足和幻觉问题。RAG通过检索相关文档增强提示词,再让大模型生成答案,类似开卷考试。基本流程包括索引化(文档分块、向量化、存储)、检索和增强生成三步。Naive RAG是基础形态,后续发展出检索重排序、模块化和智能体等优化方案,能有效提升大模型生成答案的质量和准确性。
机器学习:基于python热门旅游景点推荐系统 旅游数据分析+可视化 Django框架 scrapy爬虫 vue前端框架 源码+文档✅
应聘者:是的,我们使用Kafka来处理异步任务,比如订单状态更新和通知发送。在当前的互联网大厂中,微服务架构已成为主流。通过Spring Cloud和Eureka,我们可以实现服务的动态注册与发现,避免硬编码的服务地址。使用OpenFeign简化了服务间的通信逻辑,提高了系统的可维护性和扩展性。作为一名全栈工程师,掌握前后端技术并能灵活运用是关键。从微服务到前端框架,再到安全机制和构建工具,每一个
TL;DR:本文推导出在稀疏奖励的情况下, 标准 SFT 的训练目标其实是 RL 目标的一个(松的)下界,为了收紧这个下界同时保持训练稳定,作者引入了一个桥梁分布 来进行调节。最终在形式上得到了一个重要性加权版本的 SFT 目标。
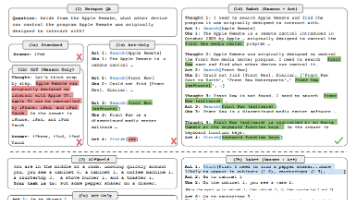
在问答、事实核查、交互式决策等多种任务上,ReAct 均展现出超越单一推理或行动基线的性能,且仅需少量示例即可学习。ReAct 生成的轨迹清晰地展示了模型的“心路历程”,使得人类可以轻松审查其决策依据,判断其结论是源于内部知识还是外部事实,从而大大提高了模型的可信度和可诊断性。通过与外部知识库的互动,ReAct 有效地缓解了 CoT 方法中普遍存在的知识幻觉问题,使其在知识密集型任务中更加可靠。
大模型技术正重塑AI行业,催生高薪就业机遇。ChatGPT带来自然语言处理革命,大模型发展需掌握"细活儿":训练策略巧思、模型结构优化和训推框架效率提升。行业不看资历只看能力,有"拔尖"技术者将获丰厚回报。从易到难,框架优化人才最为稀缺,掌握这些技能可在当前大模型热潮中抢占先机。
通过本指南,您已了解如何利用 JFrog 自动化工具链实战破解 DevOps 瓶颈。记住,关键是持续迭代:从识别问题到实施自动化,再到监控优化。这不仅提升效率,还增强软件可靠性和安全性。现在就开始行动吧——配置您的 JFrog 实例,运行第一个流水线,并分享您的成功故事!如果您有具体场景或问题,欢迎提供更多细节,我会进一步协助。
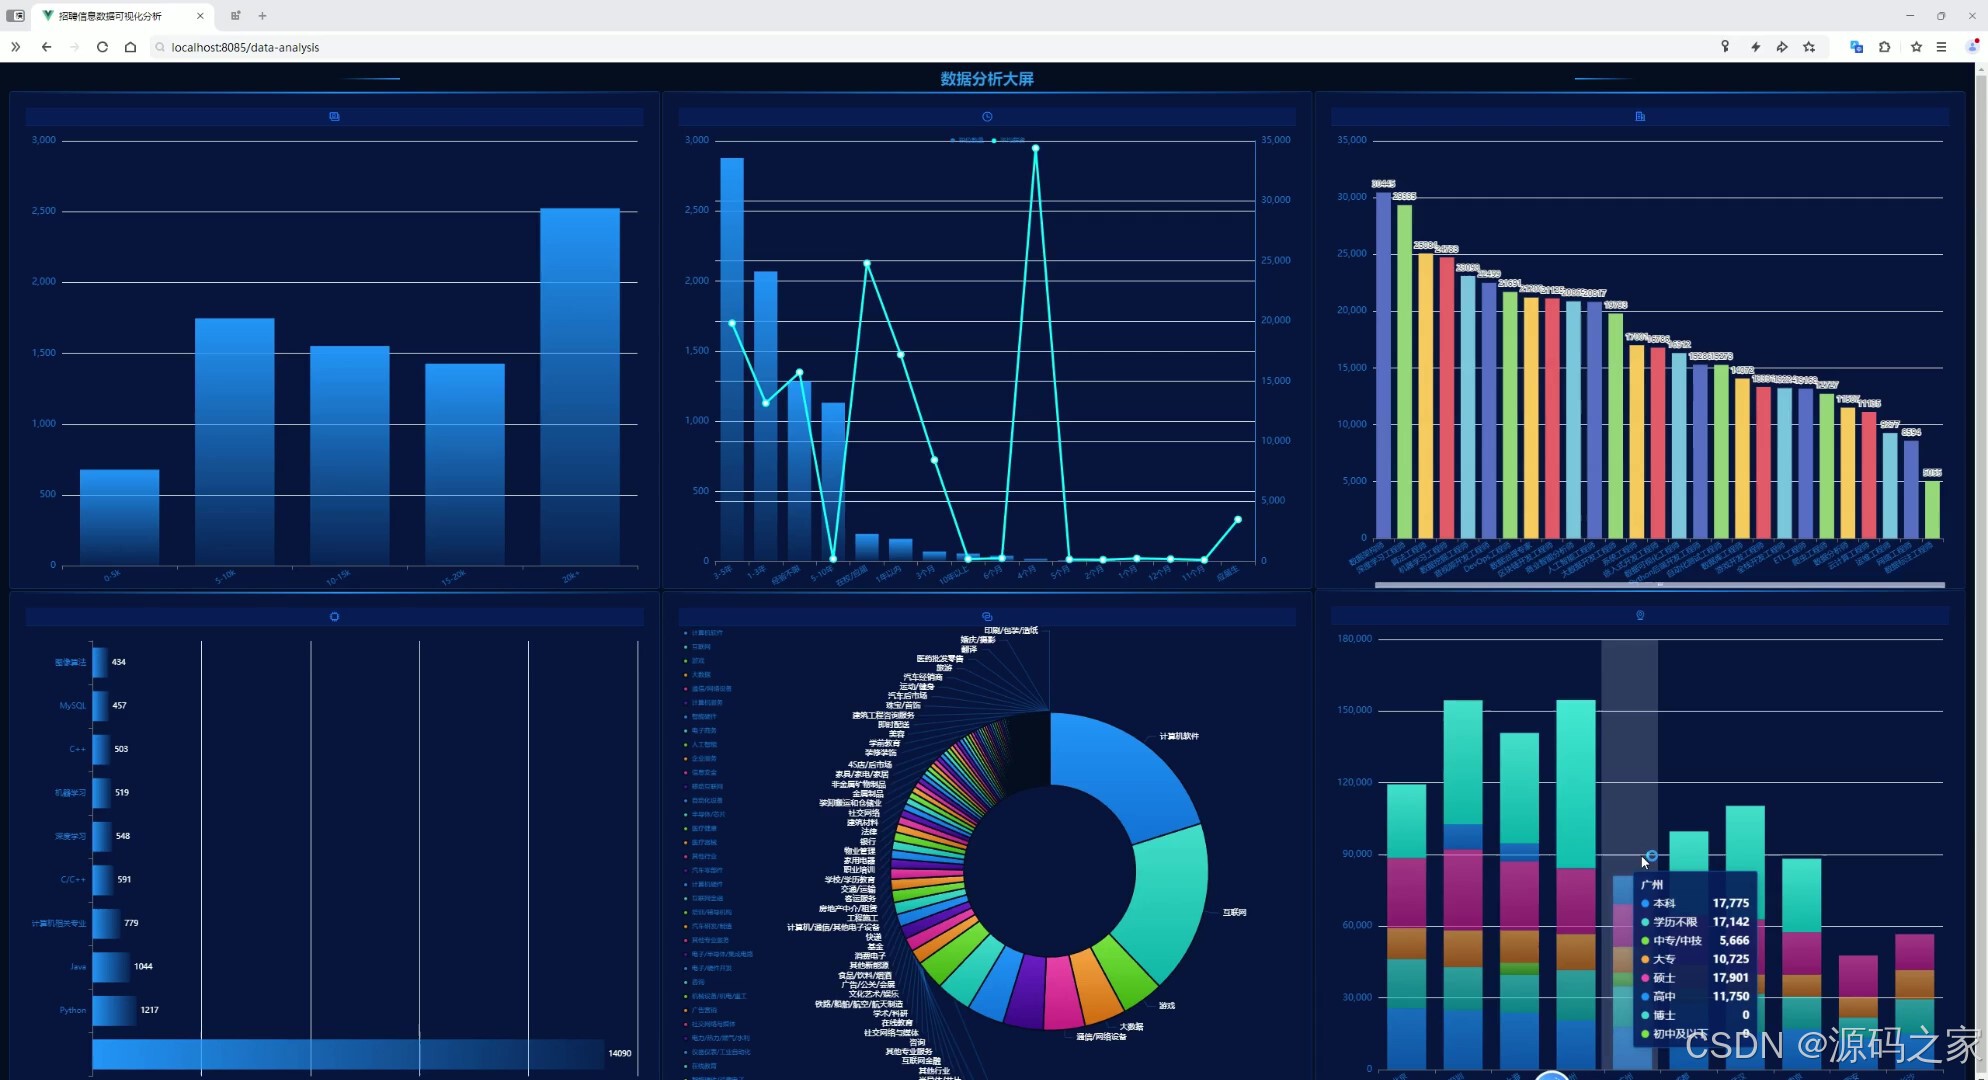
本文介绍了一个基于Python+Django+Vue技术栈的薪资预测系统。系统包含七大功能模块:1)Echarts可视化大屏展示数据分析结果;2)数据中心提供数据管理功能;3)核心的薪资预测模块采用随机森林算法构建预测模型;4)用户管理系统;5)注册登录功能;6)用户登录界面;7)后台数据管理。项目采用前后端分离架构,前端使用Vue+Echarts实现交互可视化,后端通过Django框架实现业务逻
本文系统对比了长上下文模型与RAG技术在百万token时代的表现。研究发现,长上下文在单文档理解中表现优异,而RAG在多文档检索、实时数据更新场景下优势显著。实验显示,对于复杂查询,RAG准确率比纯长上下文高15-25%,成本降低60%。文章提供了基于场景的技术选型指南:单文档分析用长上下文,多文档检索用RAG+中等上下文组合,实时数据必须使用RAG,并提供了完整的工程实现和优化方案。
文章对比分析了Kimi-Linear与Kimi K2的技术差异。Kimi-Linear创新性地重构了注意力机制,采用3层KDA线性注意力+1层MLA全注意力的混合引擎,配合通道级门控功能。相比K2,其处理速度提升6倍,内存减少75%,同时精度更高,特别擅长处理长文档。支持1M上下文,可通过vllm快速部署OpenAI兼容API,为大模型开发提供新思路。
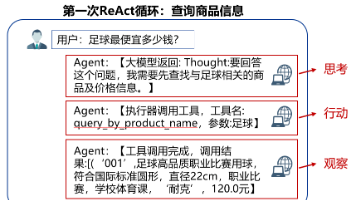
ReAct机制是实现智能体真正“自主决策”和“智能执行”的核心机制。很多同学看到ReAct的第一反应是将其拆成“Re”和“Act”,直接翻译为“再次行动”,这是错误的理解。ReAct其实是“Reason+Act”,即“推理+行动”。ReAct机制赋予了Agent智能体“先思考,再行动”能力的决策逻辑,让它能够模拟人类在面对复杂任务时的行为流程。想象一下,你交代给员工一项工作任务“调出上个月的销售数
本文介绍了大模型推理引擎与框架的区别,以及10+主流大模型推理工具/引擎/框架,包括LM Studio、llama.cpp、Ollama、vLLM、SGLang等。根据用户类型和使用场景将工具分为三类:普通用户、个人开发者和企业用户,详细分析了各类工具的特点、技术优势及适用场景,帮助读者根据自身需求选择合适的推理框架,实现大模型的高效部署与应用。